 AIREITER
O Google lançou o Gemini 3.7 Flash em 13 de agosto de 2026 como seu modelo Flash mais avançado até agora para agentes de programação e uso de ferramentas em várias etapas. O principal destaque é a pontuação de 65,3% no DeepSWE v1.1, contra 49,0% do 3.6 Flash, combinada a um preço introdutório de US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de tokens de saída. É exatamente metade do que o 3.6 Flash cobra nas tarifas padrão. O detalhe importante: esses valores devem dobrar para US$ 1,50/US$ 7,50 em janeiro de 2027, deixando cerca de quatro meses para testar o modelo na faixa promocional.
Preços da API: US$ 0,75/US$ 3,75 no lançamento, com alta após dezembro de 2026
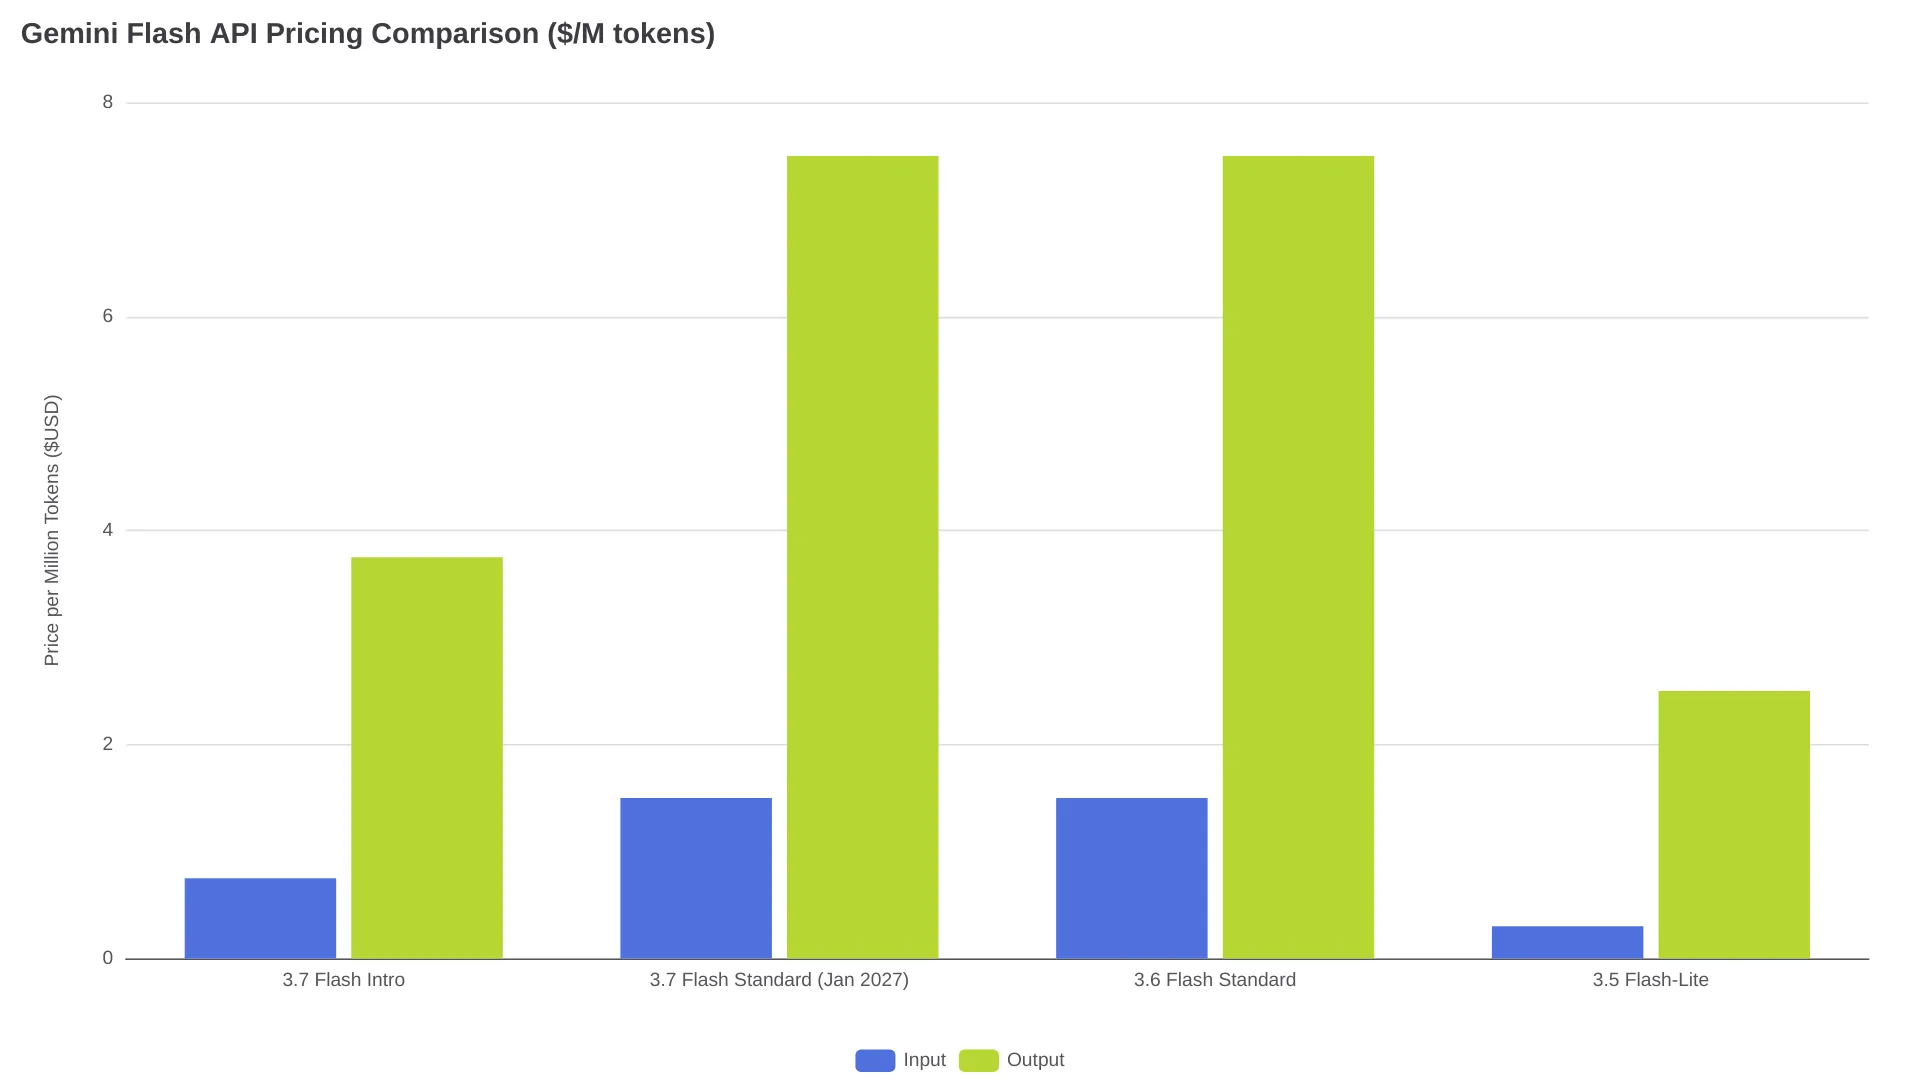
O Gemini 3.7 Flash chegou custando US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de tokens de saída, segundo o anúncio de lançamento do Google DeepMind, confirmado por relatos da comunidade e resultados de busca indexados. Para comparação, o preço padrão do Gemini 3.6 Flash é de US$ 1,50/M para entrada e US$ 7,50/M para saída (AgentPedia). A tarifa introdutória do 3.7 Flash é igual à faixa Batch/Flex do 3.6 Flash, mas vale para o processamento padrão.
Relatos da comunidade chamam atenção para um detalhe importante nas letras miúdas: o preço introdutório vale até 31 de dezembro de 2026. Depois disso, os valores voltam para US$ 1,50/M de entrada e US$ 7,50/M de saída. Um usuário do Reddit observou que "as letras miúdas do preço exibido fazem o valor dobrar depois de quatro meses" (r/GeminiAI).
| Faixa de preço | Entrada (US$/M de tokens) | Saída (US$/M de tokens) | Observações |
|---|---|---|---|
| 3.7 Flash introdutório (ago.–dez. de 2026) | US$ 0,75 | US$ 3,75 | Relatado pela comunidade; dobra em jan. de 2027 |
| 3.7 Flash padrão (a partir de jan. de 2027) | US$ 1,50 | US$ 7,50 | Igual ao preço padrão do 3.6 Flash |
| 3.6 Flash padrão | US$ 1,50 | US$ 7,50 | Preço GA atual |
| 3.6 Flash Batch/Flex | US$ 0,75 | US$ 3,75 | Faixa com menor throughput |
| 3.5 Flash-Lite padrão | US$ 0,30 | US$ 2,50 | Faixa mais barata do Gemini Flash |
Os preços de saída incluem tokens de raciocínio. O cache de contexto acrescenta US$ 0,15/M tokens na faixa padrão, com base nas tarifas publicadas do 3.6 Flash via AgentPedia. O grounding com Google Search e o grounding com Maps têm cobranças separadas. O modelo mantém a janela de contexto de 1 milhão de tokens e o limite máximo de saída de 64 mil tokens do 3.6 Flash, portanto não há mudanças nos limites de contexto que possam quebrar chamadas existentes da API.
Quanto os benchmarks realmente melhoraram?
Os benchmarks divulgados pelo Google mostram avanços concentrados em engenharia de software, programação e processamento de documentos. Os números abaixo vêm do anúncio de lançamento do Google, repercutido em publicações da comunidade em 13 de agosto de 2026.
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Variação |
|---|---|---|---|
| DeepSWE v1.1 | 65,3% | 49,0% | +16,3 pontos |
| FrontierCode 1.1 Main | 43,6% | 34,4% | +9,2 pontos |
| WebDev Arena (Elo) | 1.588 | 1.538 | +50 Elo |
| Processamento de documentos GDP.pdf | 34,0% | 22,0% | +12,0 pontos |
| AutomationBench | 30,4% | ~17% | +13 pontos |
| Recuperação em contexto longo | 97% | — | — |
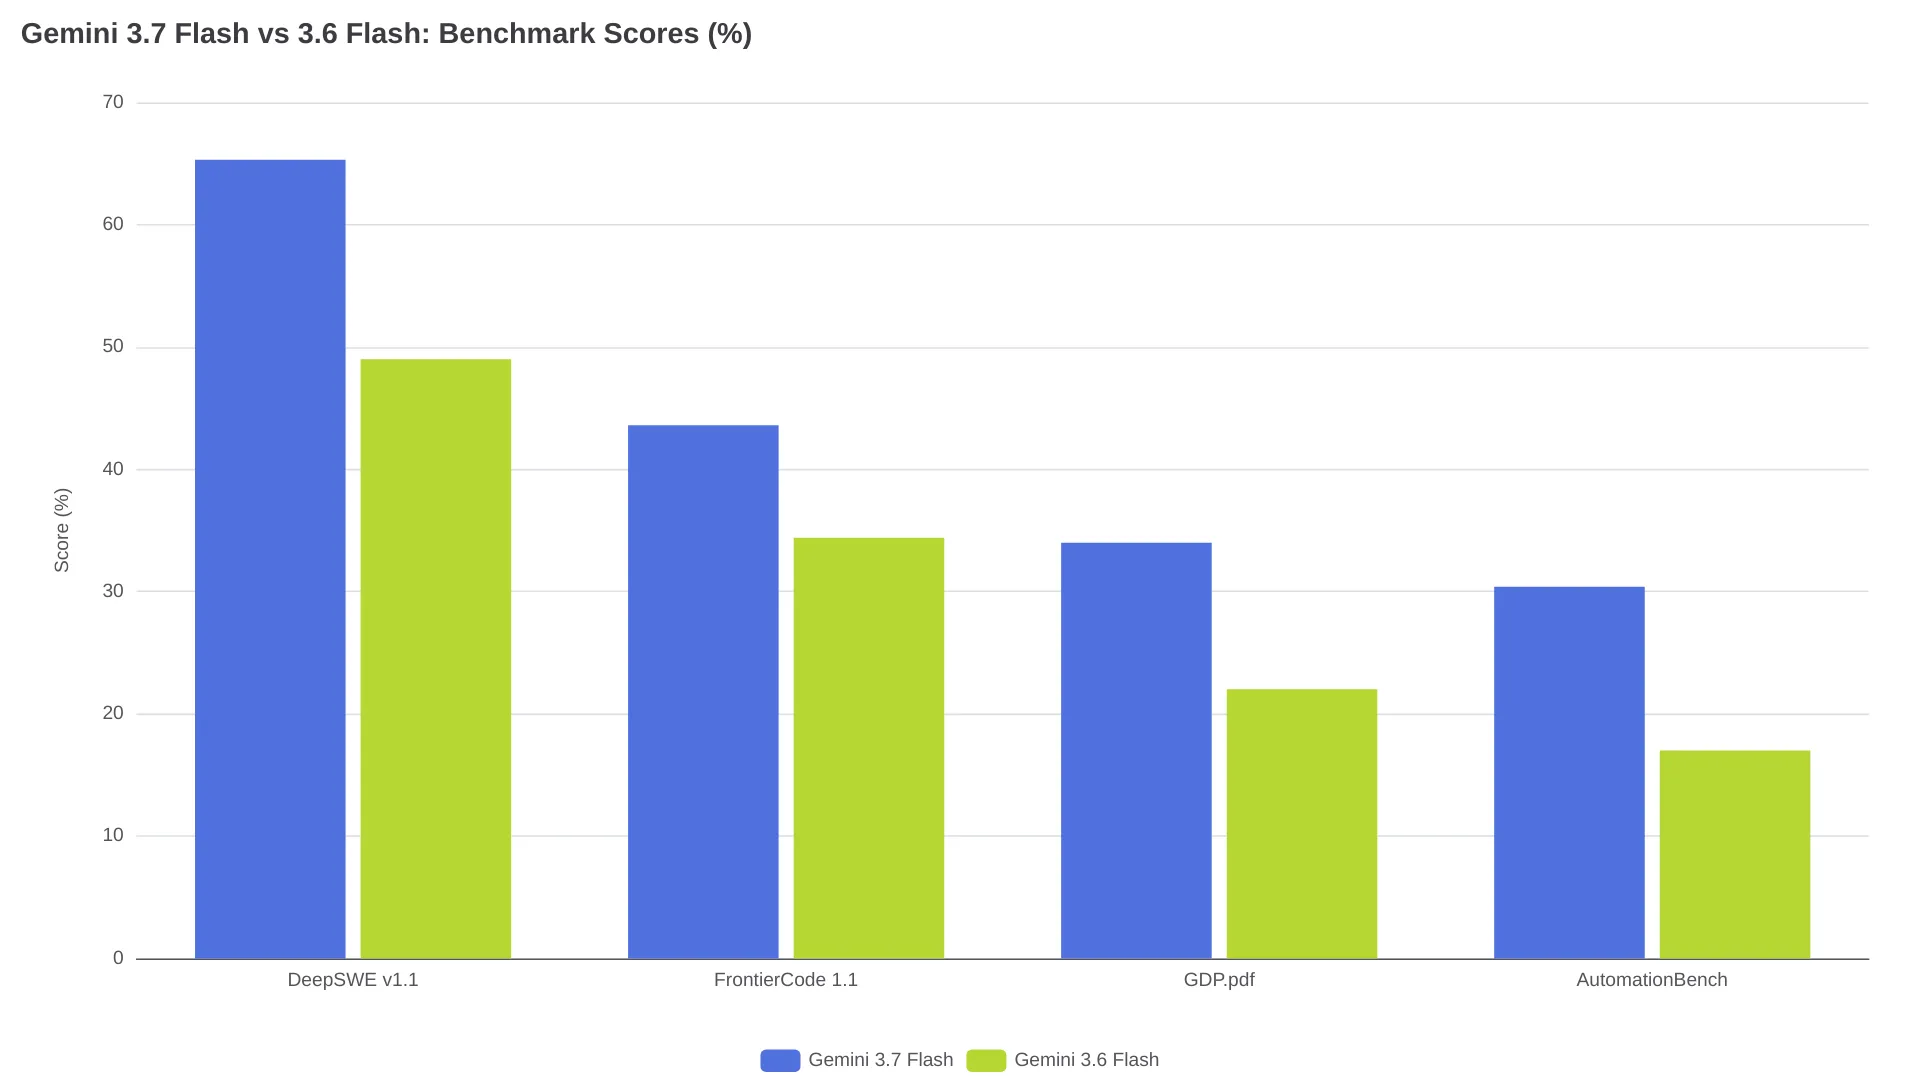
O salto de 49% para 65,3% no DeepSWE, ou 33% em termos relativos, é o resultado que mais chama atenção. O DeepSWE avalia engenharia de software no nível do repositório, incluindo alterações em vários arquivos, execução de testes e navegação pela base de código. Ainda assim, a comunidade do Reddit está dividida sobre a capacidade de esses números se confirmarem em produção. Um usuário escreveu: "Presuma que foi otimizado para benchmark até que se prove o contrário" (r/GeminiAI). Outros observaram que o 3.6 Flash usou o nível de raciocínio high na comparação, enquanto alguns modelos concorrentes usaram medium, o que infla as pontuações. O resultado de 97% na recuperação em contexto longo despertou interesse real para fluxos de programação que precisam localizar código relevante em bases extensas.
Custo em comparação com modelos concorrentes para programação
Os primeiros usuários no Reddit compararam imediatamente a relação entre preço e desempenho do 3.7 Flash com alternativas mais baratas. O cenário é misto: o 3.7 Flash pontua bem, mas custa significativamente mais por tarefa do que modelos econômicos voltados à programação.
Um participante da discussão sobre os benchmarks estimou que o Gemini 3.7 Flash custa aproximadamente 8 vezes mais que o GPT-5.6 Luna na métrica de custo por tarefa da Artificial Analysis, apesar de o Luna ter pontuações quase idênticas nos benchmarks. Outro usuário afirmou que o Gemini 3.7 Flash chegou a ser cerca de 13 vezes mais caro que o DeepSeek V4 Flash, embora o preço do DeepSeek tenha aumentado desde então. O mesmo comentarista resumiu a diferença dizendo que o Gemini 3.7 Flash custa "mais de 300% a mais" que o Luna para entregar resultados "praticamente iguais" (r/GeminiAI).
O contraponto é que, segundo os relatos, o Luna alucina mais e o raciocínio do DeepSeek V4 Flash "comete muitos erros", embora as evidências sejam anedóticas.
Onde o 3.7 Flash recebe elogios é na velocidade. Usuários relatam que a maioria das respostas chega em 3 a 6 segundos, enquanto a resposta mais demorada observada, em um teste de escrita criativa, levou cerca de um minuto. Vários comentaristas o classificaram como "absurdamente rápido".
Especificações, disponibilidade e acesso à API
O Gemini 3.7 Flash mantém os mesmos limites de contexto e o conjunto de recursos do 3.6 Flash, com base nas especificações relatadas em discussões da comunidade e na documentação do 3.6 Flash.
| Especificação | Valor |
|---|---|
| Janela de contexto | 1.048.576 tokens (1M) |
| Saída máxima | 65.536 tokens (64K) |
| Níveis de raciocínio | Low, Medium, High |
| Modalidades | Texto, imagens, vídeo, áudio e PDF (entrada); texto (saída) |
| Data de corte do conhecimento | Março de 2026 (3.6 Flash; data do 3.7 Flash não confirmada) |
| Preço de entrada em cache | US$ 0,15/M tokens (padrão, inferido a partir do 3.6 Flash) |
Onde acessar:
- Gemini API / Google AI Studio — acesso para desenvolvedores
- Aplicativo Gemini — distribuição para consumidores
- Gemini Spark — disponível para assinantes do Google AI Pro e do Google AI Ultra
- Vertex AI — espera-se que siga o padrão de disponibilidade do 3.6 Flash
O ID de modelo esperado para a API é gemini-3.7-flash, seguindo a convenção de nomes usada pelo Google no 3.6 Flash. Confirme a string exata na documentação do Google AI for Developers antes da implantação e fixe esse ID, em vez de depender dos aliases gemini-flash-latest.
Vale migrar do 3.6 Flash?
A decisão depende do tipo de carga de trabalho e do impacto que o aumento de preço de janeiro de 2027 terá no seu orçamento.
Migre se sua aplicação executa agentes de programação, cadeias de uso de ferramentas em várias etapas ou processamento pesado de documentos. O salto do DeepSWE, de 49% para 65,3%, é grande o bastante para mudar a quantidade de ciclos de agente que são concluídos na primeira tentativa, e o preço introdutório pela metade permite fazer a avaliação gastando menos. Equipes que já usam o 3.6 Flash podem trocar o ID do modelo por trás de uma feature flag sem reescrever as premissas relacionadas à janela de contexto.
Espere se sua carga envolve classificação, roteamento ou extração em alto volume e o Flash-Lite já dá conta por US$ 0,30/US$ 2,50. O preço introdutório do 3.7 Flash ainda é 2,5 vezes maior na entrada, e a duplicação de janeiro aumenta ainda mais essa diferença.
Planeje a mudança de preço. Reserve no orçamento US$ 1,50/US$ 7,50 a partir de janeiro de 2027, e não a tarifa promocional atual. Se a economia por unidade só fecha com US$ 0,75/US$ 3,75, o modelo ficará 2 vezes mais caro em quatro meses.
Perguntas frequentes
O preço de US$ 0,75/US$ 3,75 do Gemini 3.7 Flash é permanente?
Não. Relatos da comunidade indicam que essa é uma tarifa introdutória, válida até 31 de dezembro de 2026. A partir de janeiro de 2027, os preços devem dobrar para US$ 1,50/M de entrada e US$ 7,50/M de saída, igualando as tarifas padrão do 3.6 Flash.
O Gemini 3.7 Flash está disponível no Vertex AI?
A disponibilidade no Vertex AI não foi confirmada de forma independente no lançamento. O Gemini 3.6 Flash estava disponível no Vertex AI quando alcançou a disponibilidade geral, portanto espera-se que o 3.7 Flash siga o mesmo caminho. Consulte o console do Google Cloud para ver a lista atual de modelos.
Como o 3.7 Flash se compara ao Gemini 3.1 Pro?
Usuários do Reddit relatam que o 3.7 Flash é competitivo ou superior aos modelos da categoria Pro em benchmarks específicos de agentes e programação, especialmente na análise agentiva de documentos. Para ciclos de agentes de programação pelo preço introdutório, o 3.7 Flash oferece melhor relação entre custo e desempenho; em raciocínio e planejamento complexos, o Pro continua sendo a opção mais forte.
Os tokens de raciocínio são cobrados separadamente?
Não. Os tokens de raciocínio são cobrados como tokens de saída, pela tarifa padrão de saída, de US$ 3,75/M durante o período introdutório. Usar o nível de raciocínio high aumenta proporcionalmente o custo da saída; por isso, prefira medium ou low em cargas de alto volume quando o raciocínio adicional não for necessário.