 AIREITER
Em 29 de julho de 2026, submetemos Claude Opus 5, GPT-5.6 Sol, Terra e Luna às mesmas quatro tarefas. Foram 16 respostas no total — e as 16 estavam corretas. Nesses quatro testes curtos, portanto, a precisão não ajuda a decidir.
As diferenças apareceram justamente em dois pontos que pesam na conta: o Opus 5 faturou 1.642 tokens de saída, contra 480 do Sol, e as requisições ao GPT-5.6 entram em uma tabela de preços mais alta acima de 272.000 tokens de entrada. Já o Claude Opus 5 mantém a cobrança da janela completa de 1M de tokens. Em uma requisição com 200K tokens de entrada e 20K de saída, os dois modelos topo de linha ficam separados por menos de 7% no preço de tabela. Com mais saída ou depois da faixa de 272K, a distância aumenta — e a escolha passa a depender do formato da requisição e do comportamento de cada modelo.
Os quatro modelos enfrentaram as mesmas tarefas
Todos receberam exatamente o mesmo prompt de usuário em quatro verificações com respostas passíveis de validação mecânica: corrigir uma função Python median com bug, contar ocorrências de letras em uma string fixa, calcular o ângulo de 7,5 graus formado por um relógio às 3h15 e refatorar uma função JavaScript deliberadamente desorganizada sem alterar seu comportamento. As respostas de código foram executadas contra casos de borda; não nos limitamos a avaliá-las visualmente.
Todos passaram em todos os testes. As correções em Python trataram corretamente listas de tamanho par, os quatro responderam 9 e 7,5 quando essas eram as respostas, e as quatro refatorações sobreviveram a uma comparação de comportamento que incluía campos falsy e filtros de categoria null.
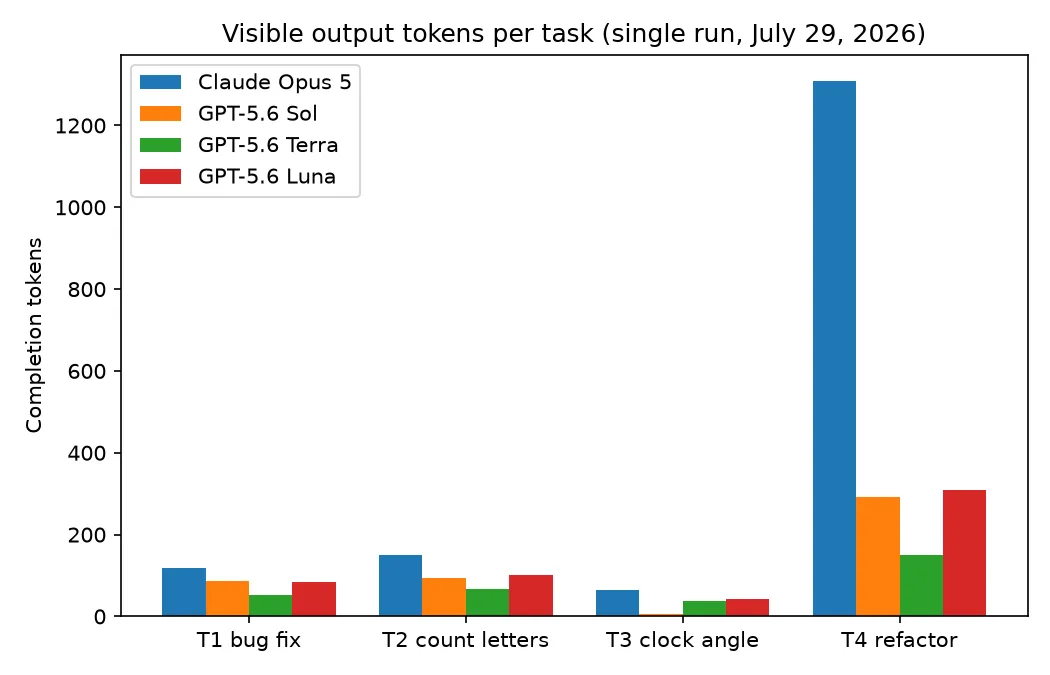
Três ressalvas antes de tomar esses números como referência. Houve uma única execução por modelo e por tarefa: trata-se de um teste de fumaça, não de um benchmark. As chamadas passaram por um gateway que injeta seu próprio prompt de sistema, fazendo os tokens de entrada variarem entre 35 e 4.415 por requisição; por isso, nós os descartamos completamente. Além disso, ambos os fornecedores cobram tokens ocultos de raciocínio como saída. Assim, "tokens de saída" aqui são os tokens cobrados, não apenas aqueles que você lê.
Mesmo com o empate, houve uma diferença qualitativa: o Opus 5 entregou a melhor refatoração entre os quatro. Ele transformou os dois loops originais em uma única passagem, extraiu o multiplicador de 1,2 para uma constante nomeada e deixou um comentário explicando que a igualdade frouxa foi mantida de propósito para preservar o comportamento. Sol, Terra e Luna também acertaram, mas retornaram traduções mais literais, ainda com dois loops.
O que muda é consumo de tokens e tempo, não acerto
Como a correção foi idêntica nas 16 execuções, a comparação prática é o custo de cada resposta. O Opus 5 concluiu as quatro tarefas em 32,4 segundos e faturou 1.642 tokens de completion. O Sol levou 19,7 segundos e 480 tokens; o Terra, 11,7 segundos e 308; o Luna, 15,3 segundos e 537.
| Execução única, 29 de julho de 2026 | Corretas | Tokens de saída | Tempo total | Custo só de saída |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1.642 | 32,4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19,7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11,7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15,3s | $0.0032 |
A diferença está no volume de raciocínio, não no tamanho da resposta final. Na refatoração, o Opus 5 faturou 1.308 tokens para uma resposta final de 492 bytes; para responder "7.5", gastou 64 tokens, enquanto o Sol gastou 7. A documentação da Anthropic informa que o Opus 5 usa alto esforço por padrão na API. Parte dessa diferença, portanto, vem da configuração padrão, e não de uma característica imutável: medimos o comportamento padrão, não um limite mínimo.
Dados da comunidade mostram o mesmo padrão. Um gráfico publicado no r/Anthropic, primeiro resultado do Google para esta busca quando verificamos em 29 de julho, coloca os dois quase empatados em pontuações de programação, mas mostra o Opus levando mais tempo e consumindo significativamente mais tokens. Um usuário do r/ClaudeCode resumiu a conclusão de forma menos diplomática:
O GPT 5.6 Sol simplesmente faz o que você pediu. O Opus 5 escreve "Guerra e Paz" em 12 volumes e depois faz o que você pediu.
As configurações de esforço podem inverter essa equação econômica. Um comentário no Hacker News, baseado em dados da Artificial Analysis, observou que o Opus 5 em alto esforço ficou em aproximadamente $1.06 por execução do índice de inteligência, contra $1.04 do Sol no máximo — quase um empate quando ambos raciocinam em intensidade alta.
GPT-5.6 não é um modelo só: Sol, Terra e Luna
GPT-5.6 não representa um único modelo. A OpenAI oferece três SKUs, e a string simples gpt-5.6 é documentada como um alias de gpt-5.6-sol, o mais caro dos três. Uma configuração que use gpt-5.6 será cobrada pela tarifa mais alta da família — um detalhe importante antes de comparar custos.
Na referência de modelos da OpenAI, o Sol aparece como seu "modelo de fronteira para trabalho profissional complexo"; o Terra é a opção que "equilibra inteligência e custo"; e o Luna é "otimizado para cargas de trabalho sensíveis a custo". Os três compartilham janela de contexto de 1,05M de tokens, saída máxima de 128K, corte de conhecimento em 16 de fevereiro de 2026 e seis níveis selecionáveis de esforço de raciocínio, de none a max.
| Especificação, verificada em 29 de julho de 2026 | Claude Opus 5 | GPT-5.6 (os três) |
|---|---|---|
| Janela de contexto | 1M tokens | 1,05M tokens |
| Saída máxima | 128K (300K via Batch API beta) | 128K |
| Corte confiável de conhecimento | Maio de 2026 | 16 de fevereiro de 2026 |
| Controle de raciocínio | Raciocínio adaptativo, effort padrão em high | none / low / medium / high / xhigh / max |
| ID da API | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Duas dessas linhas realmente influenciam a decisão. O corte de conhecimento do Opus 5, em maio de 2026, é três meses mais recente que o de toda a família GPT-5.6 — algo relevante para conteúdos que mencionam lançamentos da primavera de 2026. Os controles de raciocínio também diferem em natureza, não apenas em quantidade: no GPT-5.6, você pode desligar totalmente o raciocínio com none; o Opus 5 gerencia o próprio orçamento de pensamento de forma adaptativa e ainda expõe níveis de esforço.
Preços: janela plana de 1M contra o degrau dos 272K
Os dois fornecedores publicam tarifas claras por token e, abaixo de 272K tokens de entrada, os modelos topo de linha estão próximos: $5 por milhão de tokens de entrada em ambos, $25 por milhão de saída no Opus 5 contra $30 no Sol, a mesma tarifa de $0.50 para entrada em cache e desconto de 50% em Batch dos dois lados. Nessas tarifas, uma requisição de 200K tokens de entrada e 20K de saída custa $1.50 no Opus 5 e $1.60 no Sol.
| Por 1M de tokens, preço de tabela em 29 de julho de 2026 | Entrada | Entrada em cache | Saída | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
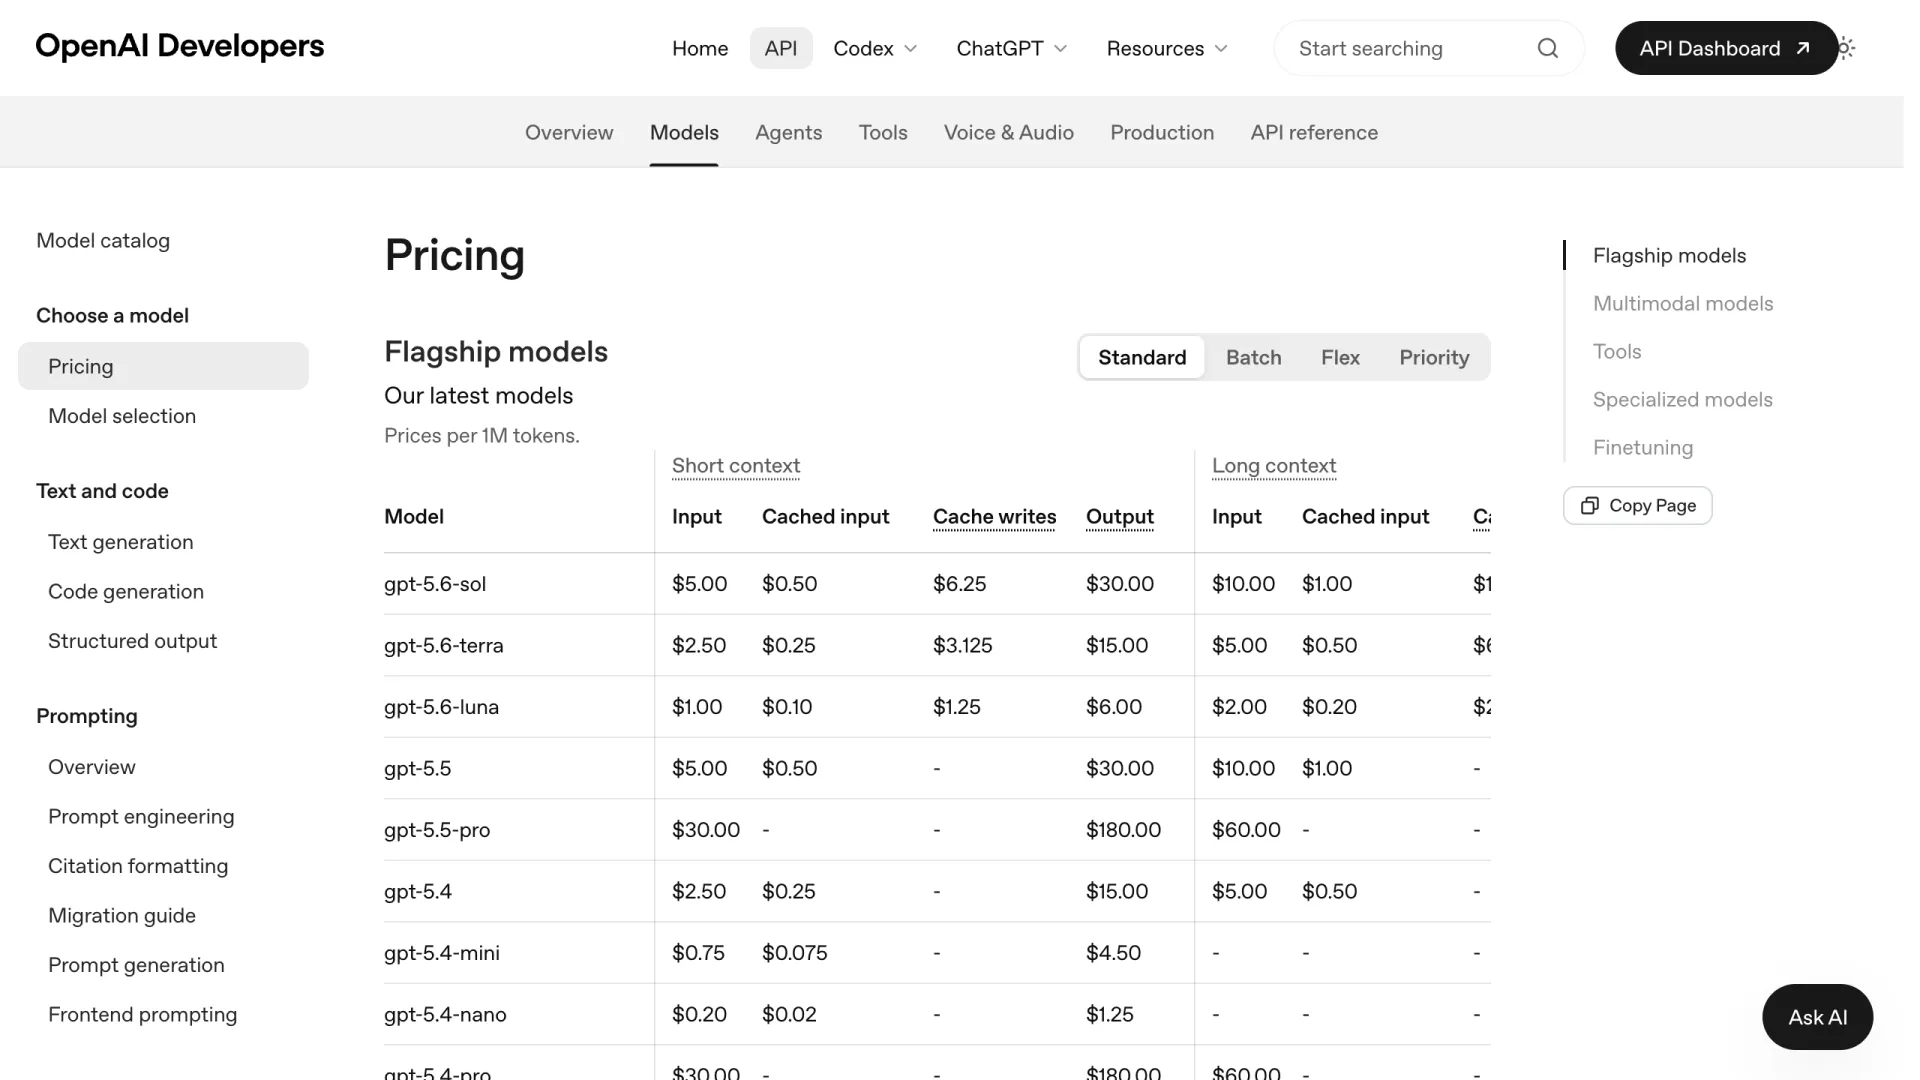
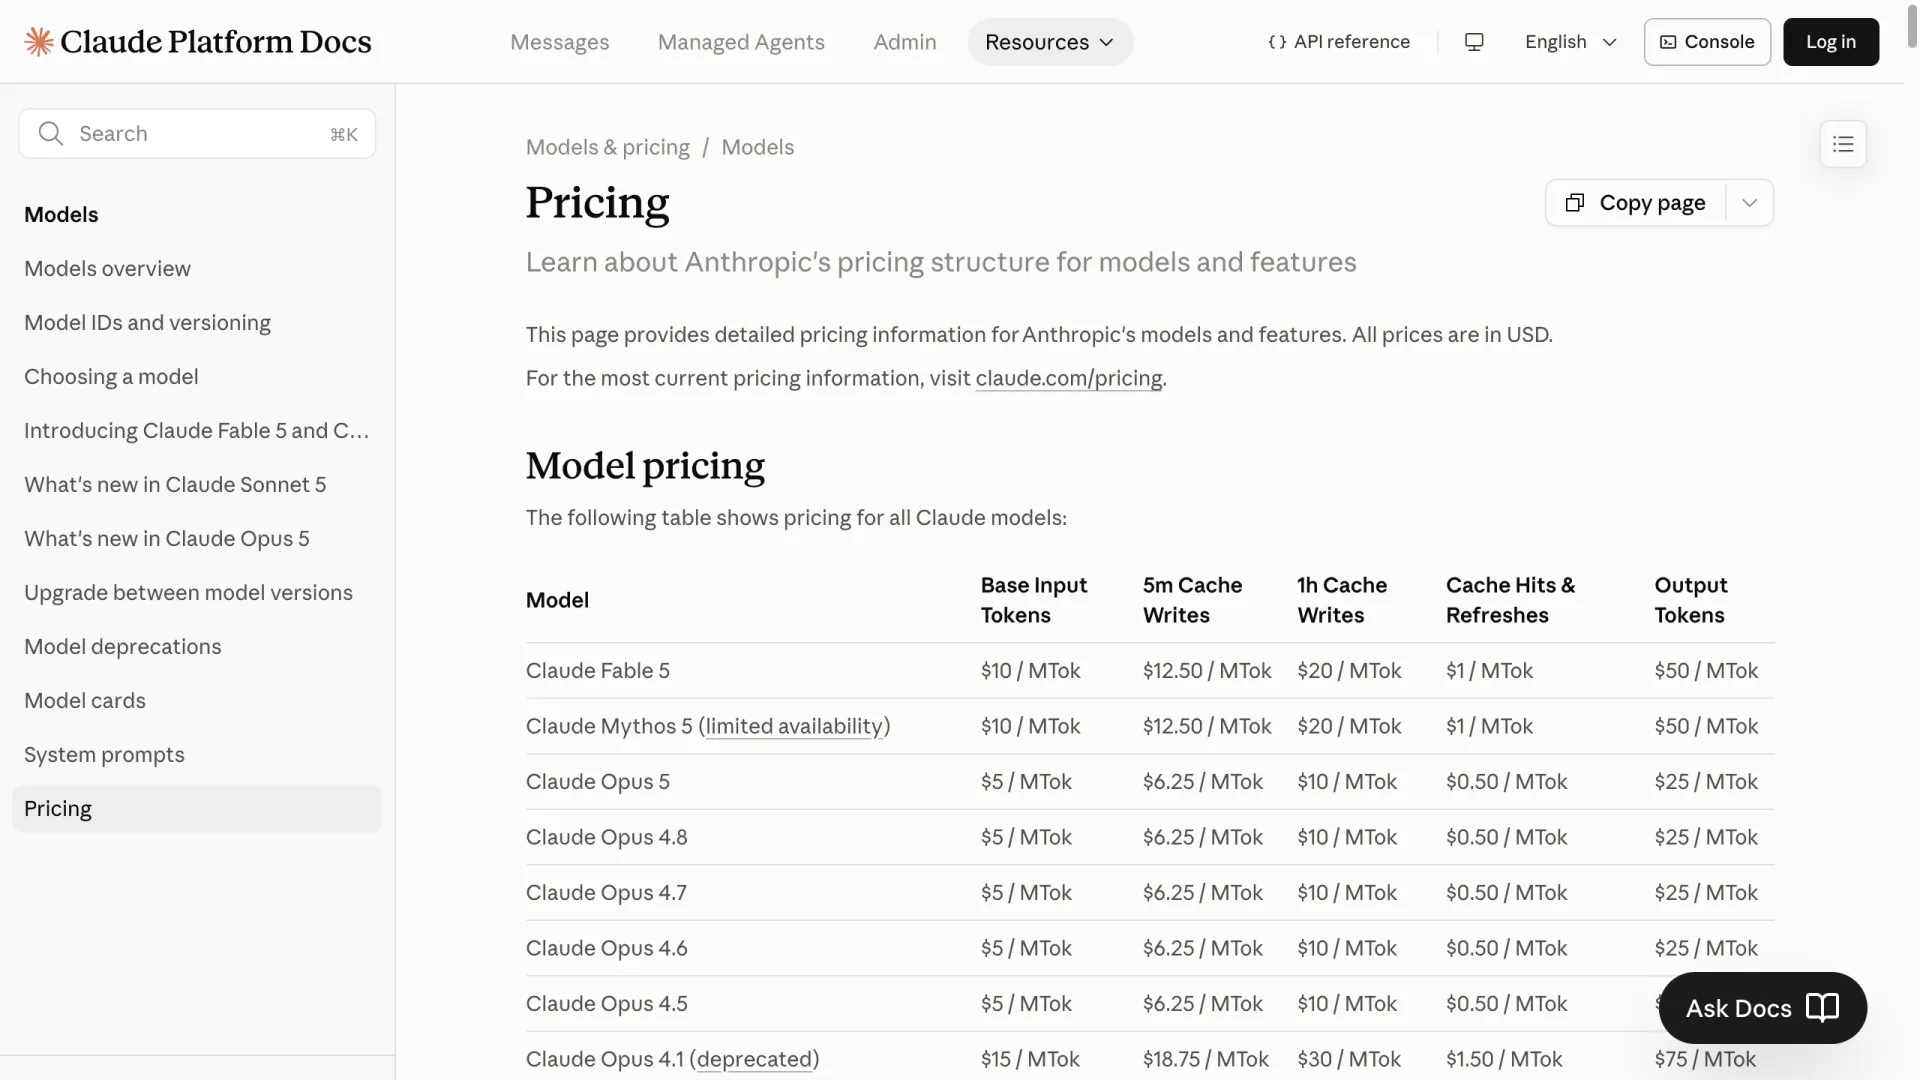
A diferença estrutural começa nos 272K tokens de entrada. A página de preços da OpenAI divide as tarifas de todos os GPT-5.6 entre contexto curto e longo: após 272K tokens de entrada, a entrada custa 2x e a saída, 1,5x, elevando o Sol a $10 e $45. A documentação de preços da Anthropic descreve o modelo oposto em uma frase: "Uma requisição de 900 mil tokens é cobrada à mesma tarifa por token que uma requisição de 9 mil tokens."
Em valores absolutos, mantendo 20K tokens de saída: uma requisição com 300K tokens de entrada custa $2.00 no Opus 5 e $3.90 no Sol. Com 500K, são $3.00 contra $5.90; com 900K, $5.00 contra $9.90. Depois desse degrau, o Opus 5 custa aproximadamente metade do Sol para o mesmo formato de requisição.
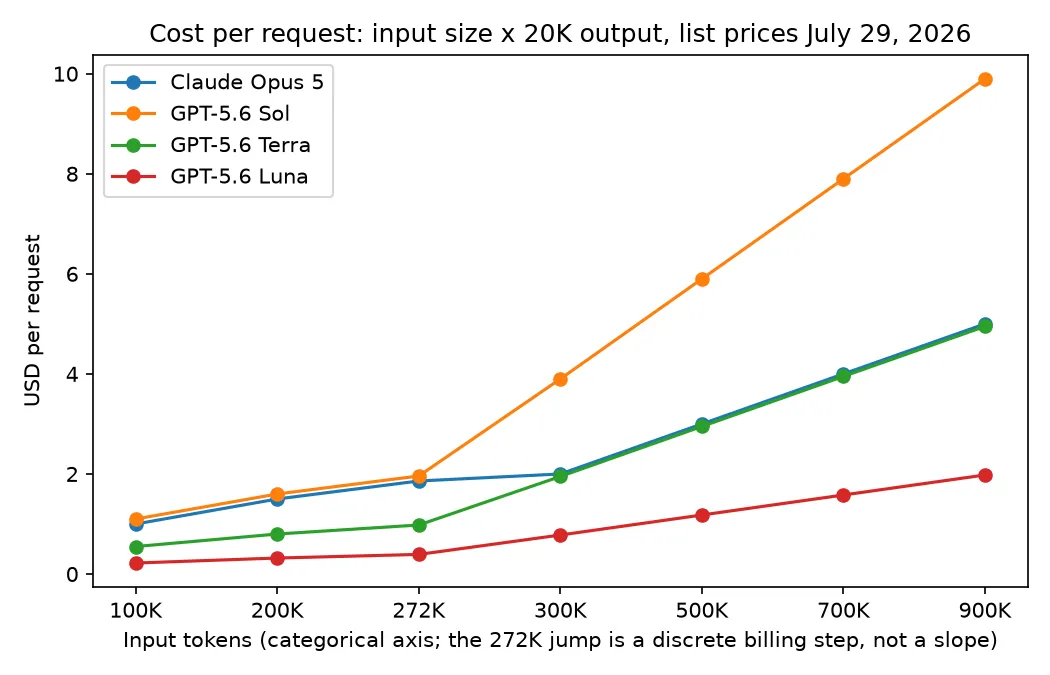
O gráfico traz uma surpresa que impede uma vitória simples da Anthropic. Acima de 272K, a tarifa dobrada de entrada do Terra é $5, a mesma do Opus 5, e sua tarifa de saída para contexto longo, de $22.50, fica abaixo dos $25 do Opus 5. Com 20K tokens de saída, isso deixa o Terra cinco centavos mais barato por requisição em 300K, 500K, 700K e 900K. Esses cinco centavos aumentam conforme o volume de saída, não o tamanho da entrada: a diferença é de $2.50 por milhão de tokens de saída.
Três observações para o planejamento de orçamento. A Anthropic oferece um modo rápido para o Opus 5, em research preview, por $10 de entrada e $50 de saída; a OpenAI vende uma camada prioritária por 2x as tarifas padrão, apenas para contexto curto. A residência de dados na região dos EUA acrescenta cerca de 10% nos dois fornecedores. E, segundo nota da própria Anthropic, o tokenizador atual do Claude gera aproximadamente 30% mais tokens que os modelos anteriores ao 4.7 para o mesmo texto. Por isso, a checagem final honesta é passar um prompt representativo pelos dois tokenizadores antes de multiplicar as tarifas.
Qual modelo usar em cada tipo de carga
Com empate em correção, o roteamento depende do formato da requisição e do estilo de trabalho. Desenvolvedores no r/ClaudeCode usam o Sol em alto esforço como revisor e agente de QA por sua profundidade e desempenho com navegador; outros, no r/codex, direcionam a maior parte do trabalho para as camadas GPT mais baratas, com raciocínio médio, e relatam a melhor relação custo-benefício nessa faixa.
| Formato da requisição | Modelo indicado | Motivo |
|---|---|---|
| Abaixo de 272K de entrada, loops de agentes com muita saída | Claude Opus 5 | $25 contra $30 na saída; melhor julgamento de refatoração no nosso teste |
| Abaixo de 272K, sensível a latência ou alto volume | GPT-5.6 Terra | Foi o modelo aprovado mais rápido e barato que testamos |
| Acima de 272K de entrada | Claude Opus 5 ou Terra | As tarifas de contexto longo do Sol dobram; o Terra fica cinco centavos abaixo do Opus 5 |
| Revisão, QA e verificações guiadas por navegador | GPT-5.6 Sol | Seis níveis de esforço para ajustar a profundidade da revisão; valide no seu próprio conjunto de QA |
| Classificação e extração descartáveis | GPT-5.6 Luna | $1/$6 e aprovação nas quatro verificações |
Nem todos concordam que o Sol merece a cadeira de QA: uma thread no r/codex classifica o Sol como uma regressão em relação ao GPT-5.5, enquanto atribui ao Opus 5 a conclusão de mais tarefas por plano. Testar os padrões é barato: os quatro modelos estão no catálogo do AIReiter (Opus 5, Sol), então você pode reproduzir suas próprias tarefas lado a lado.
Se houver um número para guardar desta comparação, é 272.000 tokens de entrada. Abaixo disso, decida pelo comportamento, pela latência e pela diferença de $5 na tarifa de saída. Acima desse limite, o argumento de preço favorece a Anthropic contra o Sol, com o Terra cinco centavos abaixo do Opus 5 e o Luna muito abaixo dos dois.
Perguntas frequentes
gpt-5.6 é o mesmo modelo que GPT-5.6 Sol?
Sim. A referência de modelos da OpenAI lista a string simples gpt-5.6 como um alias resolvido para gpt-5.6-sol; portanto, ela é cobrada pelas tarifas do Sol: $5 de entrada e $30 de saída por milhão de tokens abaixo de 272K tokens de entrada, e $10 e $45 acima disso.
Claude Opus 5 cobra mais por requisições com contexto longo?
Não. A Anthropic cobra a janela completa de 1M com as tarifas padrão na API regular e afirma que uma requisição de 900K tokens custa o mesmo por token que uma de 9K. Apenas o modo rápido opcional tem preço premium: $10 de entrada e $50 de saída.
Qual é mais barato: Claude Opus 5 ou GPT-5.6?
Depende da camada. Abaixo de 272K tokens de entrada, o Opus 5 é $5 mais barato por milhão de tokens de saída que o Sol, e os modelos têm tarifas idênticas nos demais pontos; Terra e Luna são muito mais baratos que ambos. Acima de 272K, o Opus 5 custa aproximadamente metade do Sol por requisição, enquanto o Terra segue marginalmente mais barato que o Opus 5.
Claude Opus 5 é melhor que GPT-5.6 para programação?
Os dois corrigiram, contaram e refatoraram corretamente no nosso teste de 29 de julho, e o gráfico no r/Anthropic que liderava os resultados do Google para esta busca nesse dia os mostra quase empatados em pontuações de programação. O Opus 5 demonstrou o melhor julgamento de refatoração, mas faturou 3,4x os tokens de saída do Sol nas configurações padrão. Para programação, a decisão é principalmente econômica e de preferência por verbosidade.
Quais são os cortes de conhecimento do Opus 5 e do GPT-5.6?
A Anthropic informa maio de 2026 como corte confiável de conhecimento do Claude Opus 5. Os três modelos GPT-5.6 compartilham o corte de 16 de fevereiro de 2026, cerca de três meses antes.