 AIREITER
클라우드 비용 한 푼 들이지 않고 Mac mini에서 38.5초 분량의 오디오를 2.81초 만에 생성했다는 결과가 나왔다. 주인공은 Zyphra의 ZONOS3-Mini다. 2026년 11월 9일 공개된 이 텍스트 음성 변환(TTS) 모델은 전체 8억 개 파라미터를 갖췄지만, 매 단계 실제로 활성화되는 파라미터는 약 1억 개에 불과한 Mixture-of-Experts 구조다. 다만 초기 테스터들이 공통으로 지적했듯, 해당 데모는 고성능 하드웨어에서 영어로 실행됐다. 실제 결과는 입력 텍스트와 언어, GPU에 따라 크게 달라질 수 있다.
ZONOS3-Mini의 정체와 실행 방법 총정리
ZONOS3-Mini는 Zyphra가 만든 제로샷 음성 복제 TTS 모델이다. 텍스트와 짧은 참조 음성을 넣으면 해당 목소리로 읽어주고, 27개의 기본 제공 음성 중 하나를 골라 나이, 억양, 음색을 조정할 수도 있다. 가중치는 Apache 2.0, 런타임 코드는 MIT 라이선스이므로 로컬 및 상업적 재사용이 가능하다. 단, 복제하는 목소리는 반드시 본인이 소유했거나 사용 허가를 받은 것이어야 한다.
내부적으로는 64개 전문가와 top-2 라우팅을 사용하는 희소 MoE 구조이며, 11개 레이어가 Gated DeltaNet과 글로벌 어텐션을 3:1 비율로 구성한다. 또 ZONOS2에서 사용하던 86Hz DAC 대신 초당 15프레임으로 동작하는 Zyphra Audio Codec 1(ZAC-1)을 적용했다. Zyphra에 따르면 이 변경으로 음성 토큰이 초당 774개에서 150개로 줄었고, 동일한 데이터 조건에서는 DAC보다 단어 오류율이 대략 10배 낮아졌다.
주요 사양은 44.1kHz 출력, 최대 10분 길이 생성, 최대 60초의 원본 음성 참조, 최대 120초의 임베딩 음성 참조다. 학습에는 NVIDIA H100 GPU 112개를 2.5일 동안 사용했다.
실행 방법은 다섯 가지다.
- 설치 없이 사용하는 브라우저 WebGPU 플레이그라운드
- CPU, CUDA, Metal, Vulkan을 지원하는 네이티브 C++/ggml
- Apple MLX 서버
- NVIDIA 서버에서 실행하는 SGLang 또는 vLLM
- Zyphra 호스팅 API의
zyphra/zonos3-mini모델. OpenAI 호환/v1/audio/speech엔드포인트를 사용한다.
제조사가 제시한 지연 시간은 Pixel 9 브라우저에서 첫 오디오까지 570ms 미만, M3 MacBook Air에서 150ms 미만이다. SGLang을 사용한 H100 한 대에서는 중앙값 57~80ms, 최대 처리량은 초당 오디오 457초에 달한다. 다만 스마트폰과 노트북 수치는 최상의 조건에서 나온 결과로 봐야 한다. Zyphra의 출시 스레드에는 같은 기기에 대해 더 보수적인 수치인 800ms 미만, 450ms 미만이 제시됐다. 실제 서비스에 적용하기 전에는 반드시 직접 테스트하는 편이 안전하다.
출시 자료만으로는 두 가지가 여전히 불분명하다. 기술 문서는 전체 파라미터를 8억 개라고 설명하지만 모델 페이지에는 8억 8,600만 개라고 적혀 있다. 또한 업로드한 참조 음성에 대한 워터마킹, 악용 방지책, 데이터 보존 정책도 공개되지 않았다.
설치하기 전에 브라우저에서 먼저 테스트하자
브라우저 플레이그라운드는 서버나 설치 과정 없이 WebGPU를 통해 사용자 GPU에서 직접 추론을 실행한다. 다만 첫 방문 때는 이야기가 다르다. 한 초기 테스터에 따르면 생성이 시작되기 전에 모델과 코덱 파일 약 920MB를 내려받으며, 이후에는 브라우저에 캐시된다.
우선 무료 플레이그라운드에서 음성 복제와 구간 단위 제어를 시험해보자. 특히 실제 배포 대상 중 가장 성능이 낮은 기기에서 지연 시간을 비교해야 한다. WebGPU 성능은 브라우저와 드라이버, GPU에 따라 달라지기 때문이다.
"작은 모델이 브라우저에서 돌아갈 때마다 '클라우드 TTS는 끝났다'고 환호하지는 마세요! 브라우저와 드라이버 전반의 WebGPU 호환성에는 함정이 많습니다. 영어 데모가 훌륭해 보여도 실제 운영 환경의 텍스트가 제대로 처리될지는 전혀 알 수 없습니다!" — @GKev1n, 데모만 보고 호스팅 TTS를 대체하지 말라고 경고한 실제 사용자
사용자가 오래된 스마트폰이나 내장 그래픽, Chromium 계열이 아닌 브라우저를 쓴다면 테스트 없이 Pixel 9의 수치를 그대로 적용해서는 안 된다.
제공 기능: 전사 없는 음성 복제와 단어 단위 제어
- 제로샷 음성 복제: 전사 없이 최대 60초의 참조 음성을 사용할 수 있다. 가장 자연스러운 결과를 내는 원본 클립 모드와, 나중에 재사용하며 조정할 수 있는 화자 임베딩 모드를 제공한다.
- 음성 디자인: 나이, 남성적·여성적 표현, 미국식·영국식·호주식 억양을 조절할 수 있다. 부드러움, 거친 느낌, 밝음, 낮음 같은 음색 설정을 함께 적용하는 것도 가능하다.
- 말투 제어: 속도, 감정, 발성, 생동감, 각성도, 속삭임을 단어 구간 단위로 조정한다. 예를 들어 "I didn't say"만 속삭이게 하고 문장의 나머지는 중립적으로 유지할 수 있다.
- 생성 후 편집: VoiceCraft 스타일의 모델이 음성과 설정을 유지한 채 생성된 문장의 단어를 바꾼다. 이름 하나를 잘못 읽었다고 전체 음성을 다시 생성할 필요가 없다.
다만 Zyphra도 감정과 전달 방식 설정은 보장이 아니라 목표값이라고 명시한다. 속도 조절은 음량과 피치에도 영향을 줄 수 있고, 생동감 조절은 피치와 길이를 바꿀 수 있다.
공개 하드웨어 테스트: 속도와 VRAM, 그리고 Windows의 두 가지 함정
| 구성 | 측정 결과 | 출처 |
|---|---|---|
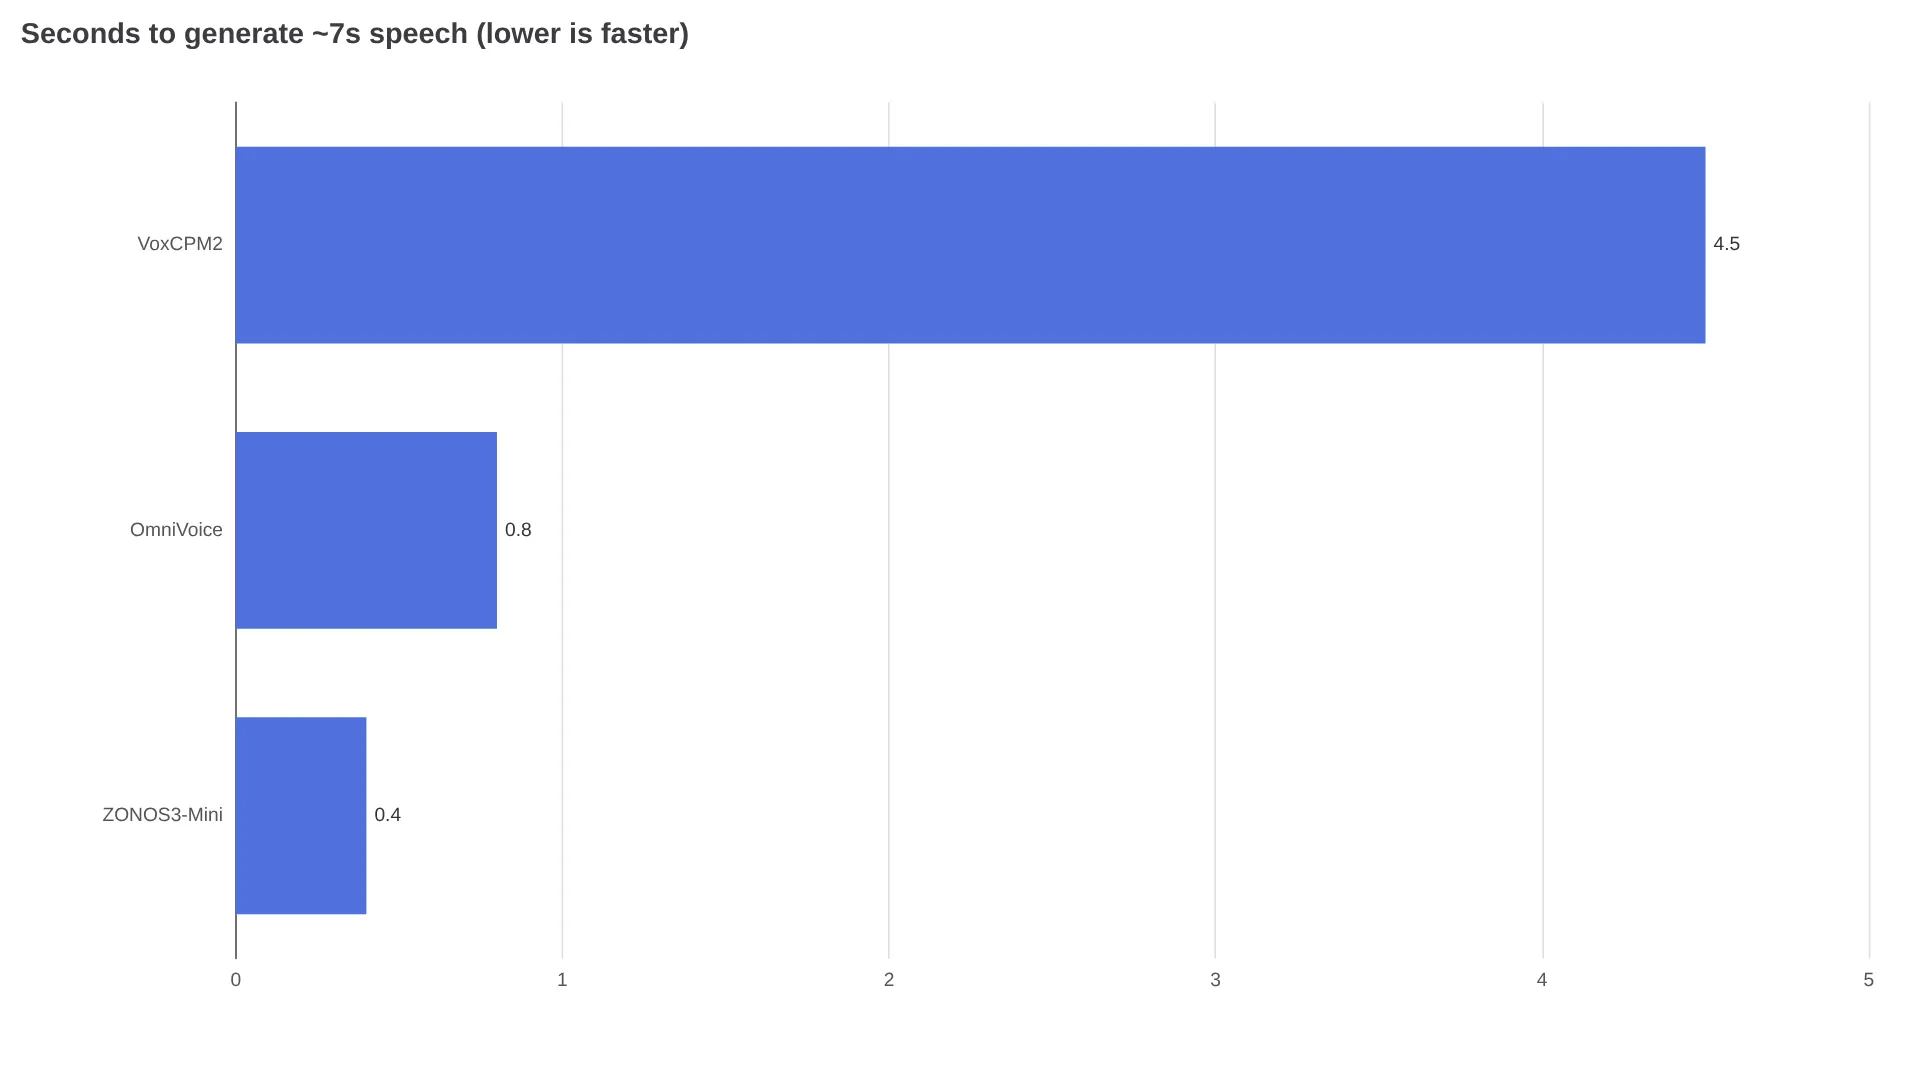
| RTX 5080, 양자화 ggml(백본 0.66GB + 디코더 0.45GB) | 약 7.1초 분량의 일본어 음성을 0.40초에 생성, 총 VRAM 2.4GB — 실시간 대비 0.056배, 실시간보다 약 18배 빠름 | VRAM16 벤치마크 |
| 동일 시스템: 31초 분량, CPU 전용 7.2초 클립 | GPU에서 2.5GB 사용 시 1.50초, CPU는 연산 1.45초(실행부터 완료까지 2.38초) | VRAM16 벤치마크 |
| 64GB M5 Pro Mac mini, MLX 서버 | 38.5초 오디오를 2.81초에 생성, 첫 오디오까지 75~100ms, 최초 복제 시 최대 약 16GB 사용 | @pratikg |
GPU 결과는 같은 벤치마크에서 이전에 측정한 OmniVoice보다 약 2배 빨랐고, VoxCPM2의 0.63배 실시간 속도보다도 훨씬 앞섰다.
전체 2.2GB 디코더를 사용하면 메모리 사용량이 4.2GB까지 늘었지만, 테스터가 확인할 수 있는 청취 품질상의 차이는 없었다. Whisper large-v3로 전사한 결과는 의도한 일본어와 영어 텍스트와 일치했다. 다만 이는 음성이 알아들을 만하다는 뜻이지, 자연스럽거나 참조 음성과 유사하다는 뜻은 아니다.
현재까지 가장 빠른 로컬 결과는 64GB M5 Pro Mac mini에서 MLX 서버를 사용한 Apple Silicon 테스터의 기록이다.
"벤치마크 결과: ... 실시간보다 최대 13.7배 빠르게 실행됩니다. 64GB M5 Pro Mac mini에서 MLX 서버를 완전히 로컬로 사용한 결과입니다. 기본 음성 기준 첫 오디오까지 약 75~100ms가 걸렸고, 38.5초 오디오 클립을 2.81초에 생성했습니다. 11~13초 음성 클립으로 새 목소리를 복제한 뒤 약 1.3초 후 말하게 할 수 있었습니다. ... WER은 0~4%였습니다. 메모리는 몇 GB만 사용했고, 최초 음성 복제 때 최대 약 16GB를 사용했습니다." — @pratikg, 데이터셋과 측정 기록을 공개한 실제 사용자
여기서 놓치기 쉬운 조건이 있다. 최초 복제 과정에서는 메모리 사용량이 약 16GB까지 치솟았지만, 캐시된 음성은 기본 음성만큼 빠르게 실행됐다. 여러 화자를 일괄 복제할 계획이라면 안정 상태가 아니라 이 순간의 메모리 급증을 기준으로 예산을 잡아야 한다.
Windows에서 소스 빌드를 진행할 때는 VRAM16 테스터가 패치로 기록한 두 가지 문제가 있다. Microsoft 컴파일러는 GCC와 Clang에서는 허용되는, head라는 멤버를 가진 구조체를 거부했다. 따라서 제공된 이름 변경 패치를 적용해 zonos3-cli, zonos3-server, spk-encoder-cli만 빌드해야 한다. 또 일본어 Windows에서는 CLI 텍스트가 UTF-8이 아닌 CP932로 전달돼 깨진 음성이 생성된다. 프로그램이 GetCommandLineW를 통해 명령줄을 다시 읽도록 수정하면 해결된다. zonos3-server에 보내는 JSON 요청은 원래 UTF-8이어야 하지만, 실제 검증은 이뤄지지 않았다.
실용적인 설치 팁은 간단하다. C:\zonos3처럼 공백이나 비ASCII 문자가 없는 경로를 사용하고, C++ 도구가 포함된 Visual Studio 2022와 Git, FFmpeg를 설치하자. CUDA를 처음부터 설정하는 데는 약 5분이 걸리며, 기본 가중치 약 1.2GB와 로컬 CUDA 약 2GB가 필요하다(설치 안내).
호스팅 API 비용 계산: UTF-8 바이트 100만 개당 $10의 의미
호스팅 방식은 https://api.zyphracloud.com/api/v1/audio/speech의 OpenAI 호환 음성 엔드포인트를 사용한다. 모델은 zyphra/zonos3-mini, 인증에는 bearer 토큰인 ZYPHRA_API_KEY가 필요하다. 아래 예시는 클라우드 API와 같은 요청 형식으로 로컬 SGLang-Omni 서버(SGLang 쿡북)를 실행한다. 핵심은 요청 형식이 같다는 점이다. 로컬호스트에서 프로토타입을 만든 뒤 기본 URL만 Zyphra Cloud로 바꾸면 된다.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
요금은 문자 수나 오디오 재생 시간이 아니라 바이트 단위로 계산된다. UTF-8 100만 바이트당 $10.00이며, 동시 요청 1개, 하루 생성 100회, 입력 문자 수 무제한, 앞서 설명한 60초·120초 음성 복제 제한이 적용된다. 영어는 대략 문자당 1바이트이고, 1분에 800~900자 정도를 말한다고 가정하면 $10으로 약 1,100~1,250분을 생성할 수 있다. 분당 1센트도 되지 않는 수준이다. 반면 CJK 텍스트는 문자당 약 3바이트를 사용하므로 문자 기준 비용이 대략 3배가 된다. 중국어, 일본어, 한국어 입력의 분당 비용은 직접 스크립트를 돌려 계산하는 편이 정확하다.
로컬이나 브라우저 추론은 하드웨어를 마련한 뒤 추가 사용 비용이 거의 없다. 호스팅 요금제는 프로토타입과 일시적인 작업량에는 적합하지만, 동시 요청 1개와 하루 100회 생성 제한으로는 프로덕션 규모를 감당하기 어렵다. 처리량이 필요한 팀이라면 $10 기준을 그대로 확대해석하기보다 SGLang 또는 vLLM 자체 배포 비용을 계산해야 한다.
ElevenLabs, Fish, Qwen과 비교하면? 그리고 #1 배지의 의미
Zyphra는 세 가지 대본을 이용해 ZONOS3-Mini를 Fish Audio, Qwen, Cartesia, ElevenLabs, OmniVoice와 비교한다. 극적인 트레일러 독백, 일관성을 시험하는 긴 코미디 대사인 "straight to jail" 구간, 대화형 팟캐스트 스타일 구간이다. 지연 시간과 처리량을 비교한 파레토 차트도 있다. 샘플은 직접 들어보는 것이 좋다. 페이지에는 재생 기능은 있지만, 글로 정리한 승자, 경쟁 모델 버전, 시드, 동일 설정을 사용했다는 설명은 없다.
수치 순위도 같은 방식으로 받아들여야 한다. Zyphra의 ZTTS2-Eval은 깨끗한 35개 언어와 실제 환경의 20개 언어를 대상으로, 데이터셋·지표·언어 조합 420개 항목을 평가한다. Capability Index에서는 오픈 모델 가운데 ZONOS3-Mini가 Fish S2 Pro와 MOSS TTS v1.5를 제치고 1위를 차지했다. 하지만 이는 Zyphra가 직접 설계한 새로운 테스트로 자사 모델을 평가한 결과다. 방법론은 공개됐지만, 이 리뷰가 작성될 당시 독립적인 재현 결과는 확인하지 못했다. 폐쇄형 모델과의 비교도 오디오 샘플만 제공될 뿐 동일한 점수는 없다.
Zyphra가 언어별 점수나 독립적인 청취 평가 결과를 제공하지 않기 때문에 중국어 성조 정확도, 일본어 피치 악센트, 다독음 한자, 긴 문장에서의 감정 표현은 아직 검증되지 않았다. 도입을 결정하기 전 직접 시험해야 한다. 현재로서는 ZONOS3-Mini가 효율성과 배포 유연성에서는 앞서지만, 음질의 절대적 우위는 입증되지 않았다고 보는 것이 정확하다.
지금 전환을 고려해볼 팀
| 팀 | 판정 | 이유 |
|---|---|---|
| 오프라인·온디바이스·개인정보 보호가 중요한 서비스(게임, 리더기, 키오스크) | 지금 테스트 | Apache 2.0, 기본 다운로드 1.2GB, VRAM 2.4GB, CPU 실행 가능, 분당 과금 없음 |
| 다양한 목소리가 필요한 오디오북·NPC 파이프라인 | 파일럿 운영 | 단어 단위 제어와 생성 후 편집으로 재생성 비용을 줄일 수 있지만, 화자별 복제 유사도는 확인해야 함 |
| 중국어를 포함한 비영어권 프로덕션 | 자체 평가 후 결정 | 언어별 제조사 점수가 없으며, 다독음과 성조를 직접 테스트하기 전까지 단어 오류율과 운율 관련 주장은 영어 중심으로 봐야 함 |
| 높은 동시성이 필요한 호스팅 TTS | 자체 구축 또는 기존 서비스 유지 | 클라우드 요금제는 동시 요청 1개와 하루 100회 생성으로 제한되며, 실제 프로덕션 경로는 SGLang/vLLM임 |
| 워터마킹이나 감사 추적이 필요한 팀 | 보류 | 출시 자료에 참조 음성의 워터마킹이나 보존 정책이 설명되어 있지 않음 |
테스트 순서는 브라우저 플레이그라운드, 성능이 가장 낮은 대상 기기의 로컬 빌드, 호스팅 API 순서가 좋다. 하드웨어가 VRAM 2.4GB와 WebGPU 조건을 충족하고, 사용하는 언어가 블라인드 청취 평가를 통과할 때만 전환하자. 그렇지 않다면 기존 폐쇄형 API를 유지하고 독립적인 다국어 벤치마크가 나올 때 다시 검토하는 편이 낫다.
FAQ
ZONOS3-Mini에는 VRAM이 얼마나 필요한가?
테스트한 RTX 5080 시스템에서는 총 약 2.4~2.5GB가 필요했다. 전체 디코더를 사용하면 4.2GB, Mac에서 최초 음성 복제를 진행할 때는 약 16GB까지 올라갔다.
브라우저나 CPU에서도 실행할 수 있나?
가능하다. WebGPU는 첫 방문 때 약 920MB를 내려받으며, 공개된 한 테스트에서 CPU 전용 합성은 실행 시작부터 완료까지 포함해 실시간의 약 3분의 1 속도로 처리됐다.
음성 복제 품질은 어느 정도인가?
전사 없이 최대 60초 참조 음성으로 제로샷 복제를 할 수 있다. 한 독립 테스트에서는 단어 오류율 0~4%가 보고됐지만, 화자별 유사도는 직접 들어보고 판단해야 한다.
상업적으로 사용할 수 있나?
가중치는 Apache 2.0, 코드는 MIT 라이선스다. 다만 복제하는 음성에 대해서는 사용 권리나 당사자의 동의를 확보해야 한다.
API 엔드포인트와 비용은 어떻게 되나?
모델 zyphra/zonos3-mini을 사용하는 OpenAI 호환 POST https://api.zyphracloud.com/api/v1/audio/speech 엔드포인트다. 비용은 UTF-8 바이트 100만 개당 $10이며, 동시 요청 1개와 하루 100회 생성 제한이 있다.
관련 글: 최고의 텍스트 음성 변환 API, 최고의 음성 복제 API 2026, Kokoro 82M TTS 로컬 가이드