 AIREITER
Baidu가 배포한 설정 파일에서 max_position_embeddings는 32,768로 제한된다. Unlimited OCR라는 이름이 문자 그대로 통하지 않는 지점도 바로 여기다. 이 모델은 페이지마다 OCR을 반복하던 흐름을 한 번의 포워드 패스로 묶지만, 32K 토큰 예산 안에 들어오는 문서여야 하고 스캔 품질도 어느 정도 깔끔해야 한다. 실제 도입을 검토할 때 가장 먼저 확인할 숫자다.
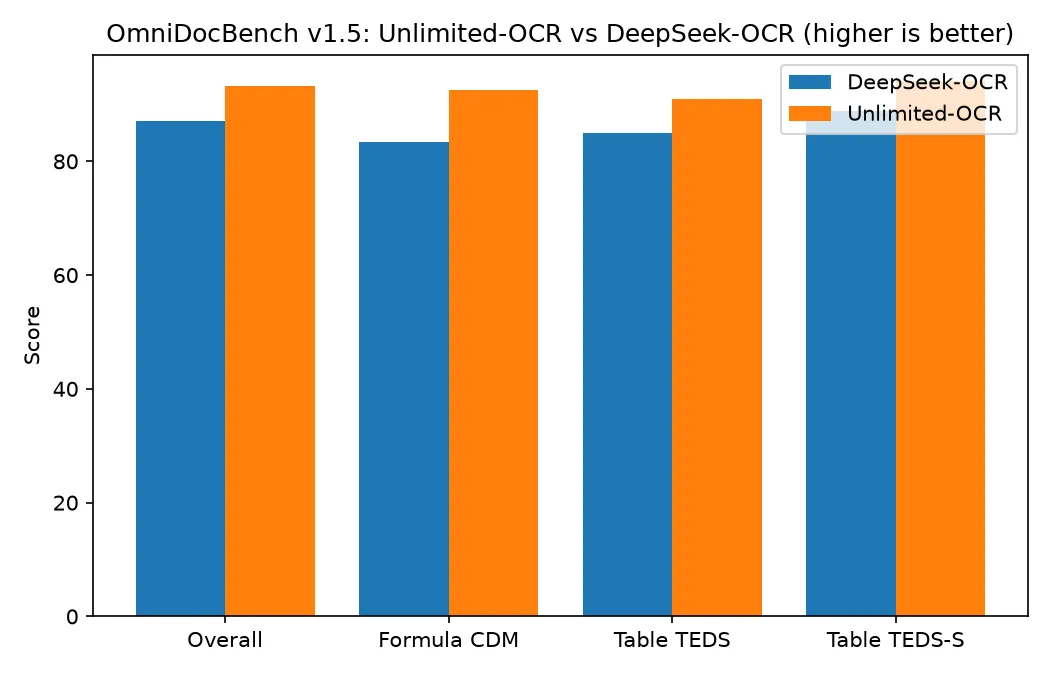
그렇다고 이 제한 하나로 릴리스의 가치를 낮춰 볼 필요는 없다. 가중치는 MIT 라이선스이며, safetensors 메타데이터에는 BF16 기준 3,336,106,240개 파라미터가 기록돼 있다. 기반 모델인 DeepSeek-OCR가 87.01점을 기록한 OmniDocBench v1.5에서 Unlimited OCR는 종합 93.23점을 냈다. Hugging Face 기준으로 2026-07-29 시점 직전 30일 다운로드는 2,694,935회, 좋아요는 3,389개였다.
‘무제한’이 아닌 이유: 32K 컨텍스트의 페이지 예산
멀티페이지 처리에서는 각 페이지를 1024×1024로 인코딩한 뒤 16배 압축해 약 256개의 비주얼 토큰으로 만든다. 따라서 코드를 작성하기 전에도 한 요청에 넣을 수 있는 페이지 수를 대략 계산할 수 있다.
| 한 번에 처리하는 페이지 | 비주얼 토큰(프리필) | 출력에 남는 토큰 | 페이지당 출력 예산 |
|---|---|---|---|
| 10 | ~2,560 | ~30,200 | ~3,020 |
| 20 | ~5,120 | ~27,600 | ~1,380 |
| 40 | ~10,240 | ~22,500 | ~560 |
슬라이드 자료나 텍스트가 성긴 계약서라면 40페이지도 무리 없이 들어간다. 반면 빽빽한 2단 구성의 신문 지면은 한 페이지만으로도 560 마크다운 토큰을 넘길 수 있어, 이런 입력에서는 실질적인 한계가 40페이지보다 훨씬 낮아진다. 논문도 이 점을 명시한다. 컨텍스트 길이가 유한한 이상 프리필은 페이지 수와 함께 늘어나므로 파싱이 진정으로 무제한일 수는 없다는 것이다. Baidu는 128K 컨텍스트 버전과 필요할 때 페이지 청크를 가져오는 ‘prefill pool’을 로드맵으로 제시했다. 여기서 말하는 무제한은 페이지 수가 아니라 캐시 크기 대비 디코딩 길이에 관한 표현이다.
R-SWA가 바꾼 것, 그대로 남은 것
DeepSeek-OCR에서 달라진 핵심은 두 가지다. SAM-ViT-B와 CLIP-L 캐스케이드로 구성된 DeepEncoder 비전 스택은 그대로 유지됐고, 학습 중에도 동결됐다. 대신 디코더의 모든 어텐션 레이어를 Reference Sliding Window Attention으로 교체했다. 생성되는 각 토큰은 모든 레퍼런스 토큰, 즉 비주얼 토큰과 프롬프트를 참조하되 이전 출력 토큰은 최근 128개만 본다. config.json에도 sliding_window_size: 128, 디코더 12개 레이어, 라우팅 전문가 64개 중 토큰당 6개 활성화로 확인된다.
개선은 특정 항목 하나에 국한되지 않고, 긴 생성에서 성능 차이가 잘 드러나는 페이지 요소 전반에서 나타난다. OmniDocBench v1.5에서 수식 CDM은 83.37에서 92.61로, 표 TEDS는 84.97에서 90.93으로 올랐다. 읽기 순서 편집 거리는 0.086에서 0.045로 절반 가까이 줄었다. 인코더를 재학습하지 않았으므로 이 차이는 더 강한 비전 스택이 아니라 디코더 변경에서 나온 결과다.
반대로 인코더가 원래 잘 읽지 못하던 것은 새 모델도 마찬가지다. 출력 길이가 길어진다고 흐릿한 팩스의 문자 인식까지 좋아지지는 않는다.
속도 차이는 긴 출력에서만 벌어진다
출력 256토큰에서는 두 모델의 처리량이 사실상 같다. 각각 초당 7,229.52토큰과 7,229.32토큰이다. 차이는 생성이 길어질수록 커진다. 출력이 6,144토큰에 이르면 베이스라인은 초당 5,822.87토큰까지 떨어지는 반면 Unlimited OCR는 7,847.71토큰을 유지해 약 35% 빠르다.
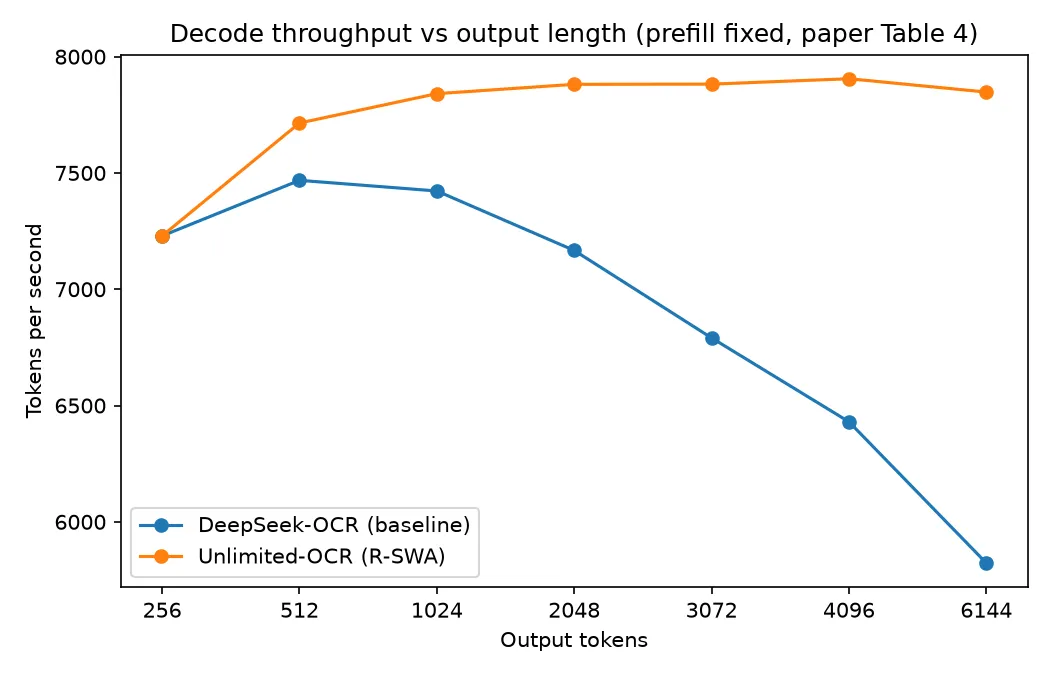
다만 512 동시성의 base 모드로 OmniDocBench 전체를 돌리면 격차는 12.7%로 줄어든다. 초당 5,580토큰 대 4,951토큰이다. 배치 처리가 이미 스텝별 어텐션 비용 상당 부분을 감추기 때문이다. 동시성이 높은 환경에서 단일 페이지 인보이스를 처리할 때는 R-SWA로 얻는 이점이 거의 없다.
40페이지까지는 버티지만, 정확도는 서서히 꺾인다
논문은 한 번에 처리한 페이지 수에 따른 편집 거리를 공개했는데, 그래프가 평평하지는 않다.
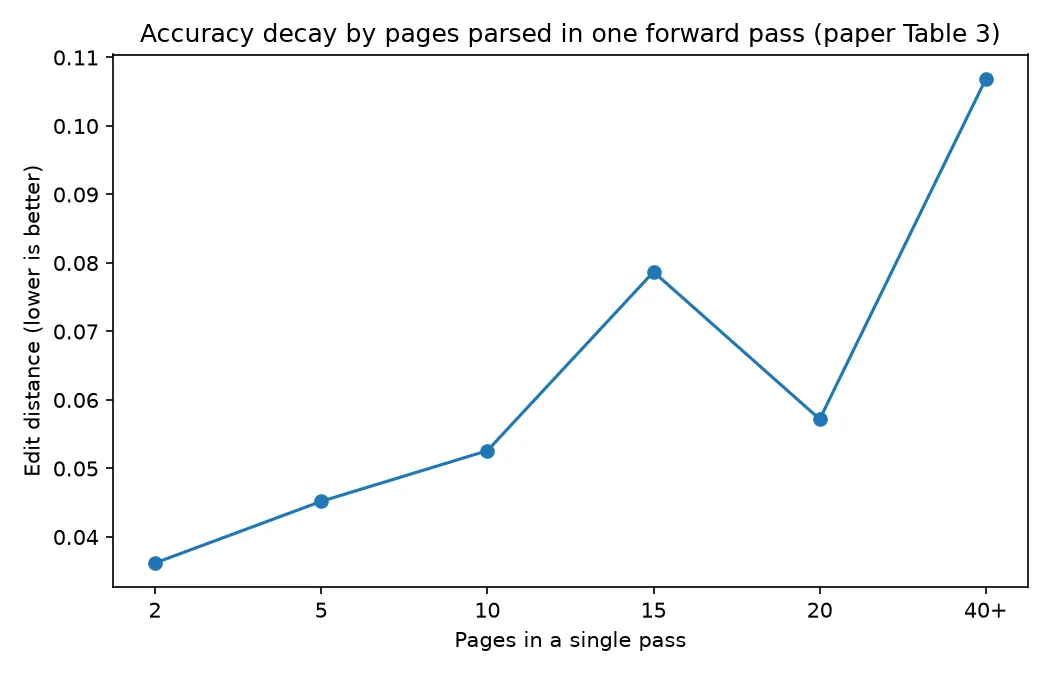
2페이지에서는 0.0362, 10페이지에서는 0.0526이다. 40페이지 이상에서는 0.1069까지 올라간다. Distinct-35도 약 99.9%에서 96.90%로 떨어져 출력에 반복 n-gram이 나타나기 시작한다는 뜻이다. 15페이지 측정값 0.0787이 20페이지의 0.0572보다 나쁘므로, 이 곡선은 페이지별 보장치가 아니라 추세로 봐야 한다. Baidu는 반복 실패의 주된 원인을 어텐션 드리프트보다 1024×1024 기본 해상도에서의 작은 글자로 설명한다. 멀티페이지 및 PDF 입력에는 단일 이미지에 제공되는 고해상도 크롭 모드를 쓸 수 없다는 점을 고려하면 자연스러운 트레이드오프다.
“8GB면 충분하다”는 말 뒤의 VRAM 계산
vLLM 레시피는 BF16 추론에 8GB 이상 단일 GPU면 충분하다고 적고 있다. 하지만 커뮤니티 보고는 이와 다르며, 모델 설정을 보면 그 차이가 이해된다.
단일 safetensors 파일 크기만 6.673GB다. 캐시 용량은 config.json의 네 항목, 즉 num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128 그리고 use_mla: false에서 계산할 수 있다. 쿼리 헤드와 키/밸류 헤드 수가 같다는 것은 일반 MHA를 쓴다는 의미다. GQA나 MQA처럼 공유로 나눠지는 구조도 없다. 따라서 토큰당 캐시는 2(K와 V) × 12 레이어 × 10 헤드 × 128 차원 × 2바이트 = 61,440바이트, 즉 60KiB다. 여기서 세 가지 수치가 나온다.
- 전체 32K 프리필: 32,768 × 60 KiB = 1.875 GiB 캐시
sliding_window_size: 128로 제한되는 R-SWA 디코딩 측: 일정한 7.5 MiB- R-SWA 없이 6,144 출력 토큰을 생성하는 동일 디코더: 선형 증가하는 360 MiB
이는 이론적인 캐시 크기이지 최대 할당량은 아니다. 비전 인코더 활성화, 할당기 단편화, 엔진이 미리 잡아두는 캐시 블록이 추가로 필요하다. 그래서 가중치와 긴 프리필이 합쳐지면 8GB 카드가 빠듯해진다. 16GB RTX 4070 Ti Super에서 실행한 한 로컬 SGLang 사례는 약 12GB 사용량을 보고했는데, 이 계산과 일치할 뿐 이를 증명하는 수치는 아니다. 8GB는 40페이지 처리 사양이 아니라 짧은 단일 페이지 처리의 최저선으로 이해하는 편이 맞다.
이 수치는 R-SWA가 제공하는 이점의 규모도 보여준다. 이 모델 크기에서 디코딩 캐시 상한으로 아끼는 것은 기가바이트가 아니라 수백 메가바이트다. 실제 체감 성능은 스텝별 어텐션 비용이 더 이상 늘지 않는 데서 나오며, 처리량 그래프가 바로 그 효과를 측정한다.
공식 API 없이 실제로 구동하는 방법
Hugging Face 모델 페이지에는 “This model isn't deployed by any Inference Provider.”라고 표시된다. Baidu가 제공하는 공식 엔드포인트나 호스팅 가격 페이지는 없다. 직접 서빙하려면 trust_remote_code를 사용하는 Transformers, SGLang, 또는 vLLM 레시피 중 하나를 택해야 한다. 아키텍처가 아직 안정적인 pip 휠에 포함되지 않았기 때문에 vLLM 경로는 전용 vllm/vllm-openai:unlimited-ocr 컨테이너의 vLLM 0.25.0 이상이 필요하다.
출력을 제대로 받으려면 다음 네 가지 설정이 중요하다.
- n-gram logits processor(
NGramPerReqLogitsProcessor)를 등록한다. 없으면 긴 문서에서<|det|>좌표 토큰을 반복한다. - 단일 이미지는
ngram_size: 35,window_size: 128으로 설정하고, 멀티페이지 또는 PDF 입력에는window_size: 1024를 쓴다. - 텍스트 콘텐츠는 반드시 리터럴
<image>토큰으로 시작해야 한다. 예를 들면<image>Multi page parsing.처럼 쓴다. 모델에는 채팅 템플릿이 포함돼 있지 않다. skip_special_tokens: False를 넘긴다. 기본값을 그대로 두면 빈 문자열이 반환된다.
원본 생성 결과에는 grounding 마크업이 포함된다. 깔끔한 마크다운을 얻으려면 <|ref|> 안의 텍스트는 유지하고 <|det|> 바운딩 박스는 제거하면 된다. 페이지 경계도 기본 출력으로 제공되지 않으므로, 감사 추적용으로 필요하다면 프롬프트에서 페이지 라벨을 요청해야 한다.
레시피에서 검증된 서버와 요청 예시는 다음과 같다.
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Hopper 카드에서는 unlimited-ocr-cu129 이미지 태그를 사용한다. 또한 요청 하나에 이미지를 여러 장 넣으면 비크롭 기본 모드로 전환되며, 이 경우에는 window_size: 1024가 필요하다.
1,000페이지당 비용: 자체 호스팅과 관리형 API 비교
오픈 웨이트는 무료지만 실행 비용까지 무료인 것은 아니다. 공개된 실사용 처리량 사례 중 하나로, Hacker News 스레드의 한 실무자는 RTX 4090에서 Transformers로 일본어 문법 PDF를 시간당 약 200페이지 변환했다고 밝혔다. 이를 RunPod Community 요금의 4090 시간당 $0.34와 비교해 볼 수 있다.
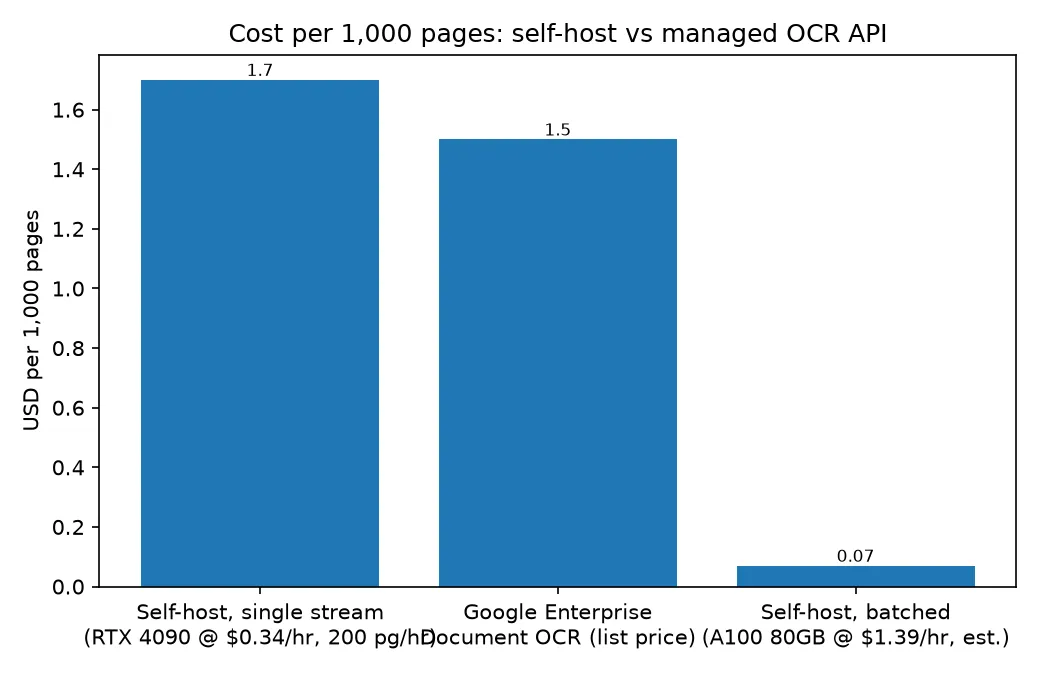
| 선택지 | 1,000페이지당 비용 |
|---|---|
| 자체 호스팅, 단일 스트림(4090 시간당 $0.34, 시간당 200페이지) | ~$1.70 |
| Google Enterprise Document OCR, 월 1K~5M 페이지 | $1.50(정가) |
| Google Layout Parser, 같은 페이지 수 | $10.00(정가) |
| 자체 호스팅, 포화 배치 하한(A100 80GB 시간당 $1.39, 모델링) | ~$0.07 |
가격은 2026-07-29 기준 정가다. Google은 월 첫 1,000페이지를 무료로 제공하며 500만 페이지 초과 구간에서는 $0.60까지 내려간다. 마지막 행은 실측이 아니라 모델링한 하한이며 출력 길이에 따라 달라진다. 논문에서 512 동시성으로 측정한 초당 5,580토큰 기준으로 페이지당 출력이 700토큰이면 시간당 약 28,700페이지, 1,000페이지당 $0.05다. 1,000토큰이면 시간당 약 20,000페이지, $0.07이고, 텍스트가 빽빽한 2,000토큰 페이지라면 시간당 약 10,000페이지, $0.14다. 이 처리량은 임대한 A100이 아니라 Baidu 자체 평가 클러스터에서 측정됐으므로, 해당 행은 벤치마크 처리량과 임대 가격을 조합한 수치다. 유휴 용량, 실패 페이지 재시도, 전처리, 스토리지를 더하면 실제 운영 비용은 세 수치 모두보다 높아진다.
소비자용 카드의 단일 스트림 배포 비용은 Google 관리형 OCR과 비슷하다. 자체 호스팅의 장점은 라이선스 비용이 아니라 동시성과 데이터 레지던시에 있다. 또 파싱은 작업의 절반일 뿐이다. 마크다운을 필드로 추출하려면 결국 롱 컨텍스트 텍스트 모델을 한 번 더 호출해야 하며, 자체 스택에서 돌리든 GPT-5.6 API 같은 서비스를 쓰든 페이지당 과금이 아닌 토큰당 과금으로 돌아간다.
실제 실패하는 입력
사용자들이 보고한 실패 패턴은 동결된 인코더의 특성과 맞아떨어진다. 같은 4070 Ti Super 실행 사례에서는 깔끔한 인쇄 문서는 통과했지만 영수증, 손글씨, 복잡한 스캔에서 출력이 깨지고 영역을 놓치며 구조가 흔들렸다. Hacker News 스레드의 실무자들은 컴플라이언스 업무에서 특히 문제가 되는 VLM-OCR 오류도 언급한다. 외국어 단어가 조용히 영어로 번역되거나, 손글씨 이름이 더 그럴듯한 철자로 ‘교정’되는 식이다. 둘 다 단일 사례이므로 측정된 오류율로 볼 수는 없고, 도입 전 반드시 테스트해야 할 항목으로 받아들이는 편이 좋다.
포지셔닝도 중요하다. Unlimited OCR는 정확도 순위표의 최상위 모델이 아니다. 집계된 OmniDocBench 목록에서는 PaddleOCR-VL-1.6이 96.33점(벤더 자체 보고)을 기록했고, Unlimited OCR는 v1.6에서 93.92점이다. olmOCR-Bench에는 아직 이 모델의 결과가 없다. 이 모델이 경쟁하는 축은 페이지당 정확도가 아니다.
직접 돌릴 만한 모델인가?
현재 파이프라인이 페이지를 하나씩 처리한 뒤 텍스트를 다시 이어 붙이고 있고, 입력 문서가 디지털 원본이거나 깨끗하게 스캔됐으며, 페이지 경계에서 끊기는 표처럼 페이지를 가로지르는 구조가 기존 출력 품질을 망치고 있다면 잘 맞는다.
반대로 하루 수천 건의 단일 페이지 인보이스를 처리한다면 적합하지 않다. 페이지별 파이프라인이 배치 효율도 좋고 비용도 더 낮다. 손글씨나 촬영한 영수증이 입력에서 의미 있는 비중을 차지하는 경우, 혹은 지금 당장 GPU와 컨테이너 태그가 아니라 SLA와 감사 추적이 필요한 경우도 마찬가지다.
어느 쪽이든 도입 전 테스트는 필수다. 최소한 자체 코퍼스에서 문서 50개를 뽑아 길이별(1~5페이지, 6~20페이지, 20페이지 이상), 입력 품질별(디지털 원본, 깨끗한 스캔, 촬영본)로 나눈다. 이 중 10개는 사람이 직접 정답을 입력하고, 평균 하나로 뭉치지 말고 문자 오류율, 읽기 순서 편집 거리, 표 TEDS를 각각 측정한다. 실제 임대할 GPU에서 페이지당 실측 시간도 기록해야 한다. 같은 50개 파일로 현재 사용 중인 시스템과 비교하고, 후속 단계가 실제로 실패하는 지점에 기준을 맞춘다. 필드 추출에서는 보통 원시 CER보다 표 구조가 더 중요하다. 튜닝으로 수치가 얼마나 달라질 수 있는지 참고할 사례로는, 엔터프라이즈 규모 PDF 물량을 처리하는 한 팀이 추론 레이어를 Rust로 다시 작성한 뒤 문자 오류율 0.94%를 보고한 바 있다.
FAQ
Unlimited OCR는 무료인가?
가중치는 MIT 라이선스이며 상업적 사용을 포함해 Hugging Face 또는 GitHub에서 무료로 내려받을 수 있다. 하지만 추론은 무료가 아니다. 배치 효율에 따라 1,000페이지당 약 $0.07~$1.70와 엔지니어링 시간을 예산에 반영해야 한다.
공식 Unlimited OCR API가 있나?
없다. 모델 페이지에 Inference Provider 배포가 없다고 표시되므로, 발견되는 엔드포인트는 모두 오픈 웨이트를 서빙하는 서드파티다. 가격과 속도 제한 역시 Baidu가 아닌 해당 공급업체 정책을 따른다.
Unlimited OCR가 현재 최고의 OCR 모델인가?
정확도 순위표 기준으로는 아니다. PaddleOCR-VL-1.6은 OmniDocBench에서 96.33점을 보고했으며 Baidu의 v1.6 점수는 93.92점이다. 또한 이 모델은 아직 olmOCR-Bench 결과가 없어 벤치마크 간 일관성도 검증되지 않았다. 측정으로 확인된 강점은 편집 거리 0.1069로 40페이지를 한 번에 처리하는 능력이다.
Ollama에서 Unlimited OCR를 실행할 수 있나?
공식 모델 카드는 Transformers, vLLM, SGLang만 안내하며 커스텀 아키텍처에는 trust_remote_code가 필요하다. Hugging Face에는 커뮤니티 양자화 모델이 존재하지만, Ollama 빌드는 자체 파일에서 레퍼런스 경로와 출력을 비교하기 전까지 검증되지 않은 것으로 보는 편이 안전하다.