 AIREITER
SWE-2 Flash는 Devin에서 반복적으로 처리하는 일반적인 작업의 기본 모델로 적합해 보입니다. 초당 200토큰을 생성하면서 SWE-2 비용의 5분의 1만 들기 때문입니다. 다만 Terminal-Bench 4.0처럼 난도가 높은 작업에서는 이야기가 달라집니다. SWE-2 Flash의 점수는 20.0%로, SWE-2의 27.3%와 선두 모델들의 40% 이상에 미치지 못합니다.
결론: 반복 작업은 Flash, 어려운 10%는 SWE-2
Devin 안에서 대량으로 처리하는, 요구사항이 명확한 엔지니어링 작업이라면 SWE-2 Flash를 기본값으로 삼을 만합니다. 특정 벤치마크에서의 품질 저하를 감수하는 대신 생성 속도는 3배 빠르고 작업당 비용도 크게 낮습니다.
| 작업 유형 | 배정할 모델 | 이유 |
|---|---|---|
| 자동화, 코드 리뷰, 소규모 기능, 문서 수정 | SWE-2 Flash | Cognition은 SWE-2 Flash를 일상적인 작업용으로 포지셔닝합니다. 깊은 계획보다 속도가 중요한 영역입니다. |
| 대규모 리팩터링, 처음 다루는 저장소, Terminal-Bench-4.0과 유사한 터미널 작업 | SWE-2 | Terminal-Bench 4.0에서 SWE-2가 SWE-2 Flash를 27.3% 대 20.0%로 앞서고, DeepSWE 1.1에서도 73.0% 대 60.1%로 우세합니다. |
| 보안 민감 작업 또는 온프레미스 작업 | 대기 | SWE-2 Flash의 가중치는 공개되지 않았고, 현재 약속된 것은 향후 보안 공유 프로그램뿐입니다. |
2026년 11월 30일까지 Devin Desktop과 CLI에서 무료로 사용할 수 있으므로 테스트 비용은 낮습니다. 우선 새로운 일반 작업 큐를 SWE-2 Flash로 처리하고, 실제 재작업 비율을 측정한 뒤 전환 여부를 결정하세요.
SWE-2 Flash의 정체: Inkling-Small에 미드 트레이닝을 더한 모델
SWE-2 Flash는 Cognition이 Thinking Machines의 Inkling-Small을 기반으로 만든 고속 코딩 모델입니다. 총 276B, 활성 12B 파라미터의 혼합 전문가 모델을 기반으로 하며, 강화학습에 들어가기 전에 Cognition의 새로운 미드 트레이닝 단계를 거칩니다.
미드 트레이닝에서는 토큰 효율성 그래프를 활용해 데이터 조합을 선정한 뒤, 가장 희소한 데이터를 마지막에 배치하는 3단계 학습을 수조 개 토큰 규모로 진행했습니다. 홀드아웃 손실은 안정적인 로그 선형 비율로 감소했고, 감사된 작업으로 이어서 진행한 강화학습을 통해 Terminal-Bench 4.0 점수는 0.9%에서 20.0%로, FrontierCode 2.0 점수는 3.2%에서 24.0%로 올랐다고 Cognition은 2026년 11월 4일 게시물에서 밝혔습니다. 또한 SWE-2 Flash의 처리 속도는 초당 200토큰으로, SWE-2의 초당 60토큰보다 빠르다고 설명합니다.
"Cognition 최신 모델이 나왔습니다. SWE-2 Flash! 총 276B, 활성 12B 파라미터의 플래시 모델입니다. SWE-2용 플래시 모델이 나올 줄은 몰랐는데, 놀랍고 반갑네요. 벤치마크 결과도 좋아 보입니다. 2.8T SWE-2 모델과 차이가 그리 크지 않아요." — 실제 사용자의 첫 반응, @ItsmeAjayKV
벤치마크 결과가 엇갈리는 이유: 테스트별로 봐야 한다
SWE-2 Flash의 벤치마크 결과는 테스트 종류에 따라 뚜렷하게 갈립니다. 정형화된 소프트웨어 작업에서는 강한 모습을 보이지만, 열린 형태의 터미널 작업에서는 성능이 크게 떨어집니다. 따라서 전체 평균 하나만으로 판단하면 실제 사용성을 놓치기 쉽습니다.
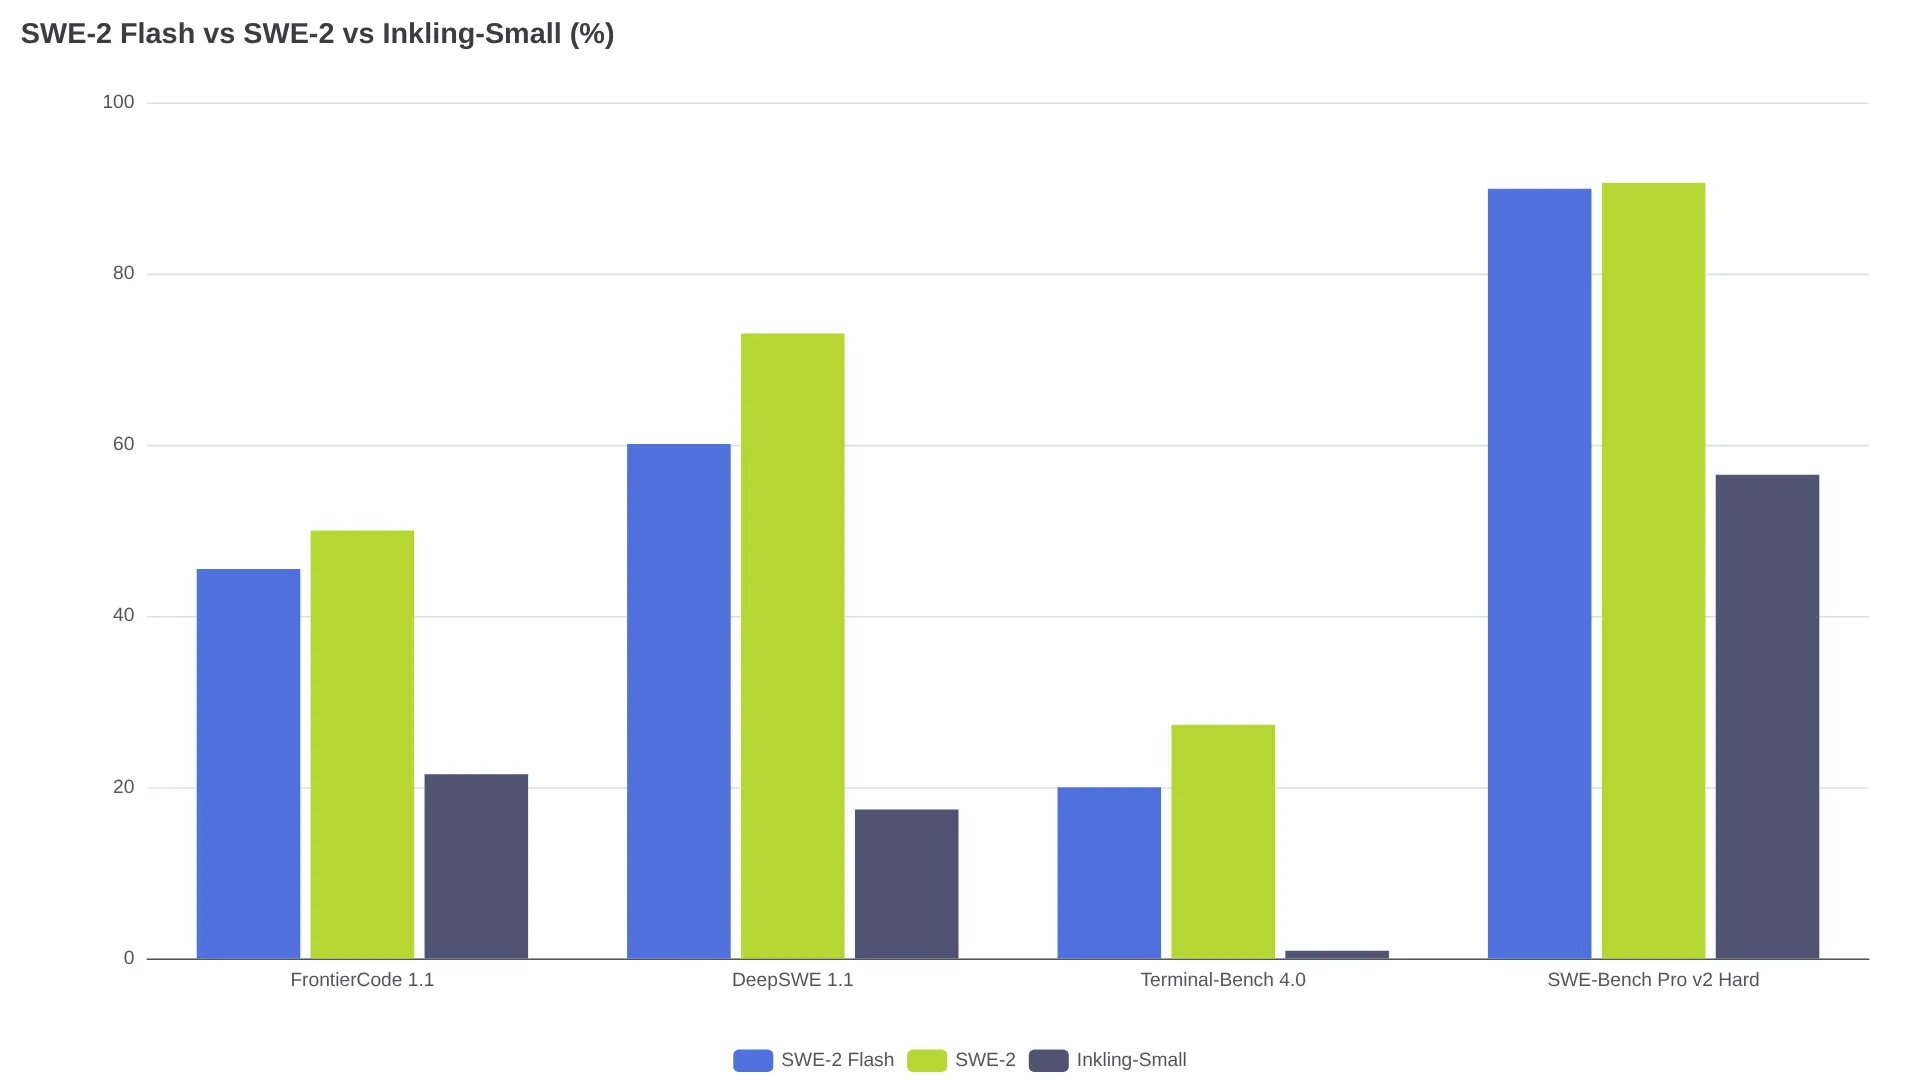
| 벤치마크 | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Cognition 표의 최고 점수 |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45.5% | 50.0% | 21.5% | 50.0% SWE-2 |
| FrontierCode 2.0 | 24.0% | 23.8% | 3.2% | 27.7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60.1% | 73.0% | 17.4% | 77.0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89.2% | 92.8% | 64.7% | 94.4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20.0% | 27.3% | 0.9% | 42.3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89.9% | 90.6% | 56.5% | 90.6% SWE-2 |
| SWE-Atlas QA | 50.0% | 56.3% | 27.4% | 71.0% DeepSeek V4.1 Flash |
| ExploitBench | 34.8% | 36.1% | 11.3% | 44.7% GPT-6 Luna |
성능 향상에는 한계가 있다. SWE-2 Flash는 FrontierCode 1.1 Main에서 Inkling-Small의 21.5%를 45.5%로 끌어올려 두 배 이상 개선했습니다. SWE-Bench Pro v2 Hard에서도 56.5%에서 89.9%로 뛰어, 90.6%인 SWE-2와 사실상 비슷한 수준에 도달했습니다.
SWE-2의 약점을 모두 해결한 것은 아니다. SWE-Bench Pro에서 좋은 결과가 나왔다고 해서 긴 터미널 세션에서도 같은 성능을 기대해서는 안 됩니다. 같은 표에서 GLM 5.3 Flash는 Terminal-Bench 4.0에서 41.8%를 기록했습니다.
오픈 웨이트라는 표현은 맥락을 봐야 한다. SWE-2 Flash는 대부분의 항목에서 Muse Spark Open을 앞섭니다. DeepSWE 1.1에서는 60.1% 대 60.0%, FrontierCode 2.0에서는 24.0% 대 6.2%입니다. 하지만 Terminal-Bench 4.0, SWE-Atlas QA, DeepSWE 1.1에서는 DeepSeek V4.1 Flash와 GLM 5.3 Flash가 SWE-2 Flash를 앞섭니다. 모든 수치는 각 모델의 최선 설정을 기준으로 한 벤더 발표 자료이며, 벤더마다 하네스도 다릅니다.
가격표가 없는데 ‘5분의 1’은 무슨 뜻인가
독립 실행형 엔드포인트가 없기 때문에 토큰당 요금도 공개되지 않았습니다. 현재 확인할 수 있는 유일한 가격 정보는 Cognition이 제시한 작업 비용 비율입니다. 모델, 하네스, 서빙 스택을 모두 포함한 롤아웃당 비용이 SWE-2의 5분의 1이라는 의미입니다.
다만 이 비율만으로는 충분하지 않습니다. Cognition은 SWE-2의 작업당 비용도 공개한 적이 없습니다. OrcaRouter의 SWE-2 분석 역시 비교 기준으로 Fable 5.1의 FrontierCode 작업당 비용만 인용했는데, 중간 수준의 추론에서는 $3.28, 최대 설정에서는 $12.83이었습니다. 해당 글에 정리된 Devin 요금제는 Free $0, Pro 월 $20, Max 월 $200, Teams 기본 $80에 좌석당 $40이었습니다. 이는 토큰 사용량에 따른 과금이 아니라 구독 요금입니다. 따라서 작업 비용이 5분의 1이라고 해서 Devin 청구서가 자동으로 그만큼 줄어드는 것은 아닙니다.
현실적으로는 이렇게 보면 됩니다. 2026년 11월 30일까지 Devin Desktop과 CLI에서 제공되는 무료 사용 기간은 Pro, Max, Teams 사용자가 실제 소비량을 측정할 수 있는 가장 저렴한 기회입니다. 토큰 수보다 주간 완료 작업 수와 재작업 비율을 추적하세요. SWE-2 Flash가 초당 200토큰으로 일반 티켓을 한 번에 끝낸다면 5분의 1이라는 수치보다 실제 절감 폭이 클 수 있습니다. 반대로 SWE-2로 계속 에스컬레이션해야 한다면 절감 효과는 사라집니다.
누가 사용할 수 있나: Devin 전용 접근과 아직 오픈 웨이트가 아닌 가중치 프로그램
현재 SWE-2 Flash의 접근 범위는 좁습니다. Cognition이 안내하는 현재 지원 환경은 Devin Desktop과 Devin CLI입니다.
공개 API 식별자도, Hugging Face 가중치도, 직접 호스팅할 방법도 없습니다. Cognition은 사이버 위험 관리를 제한 이유로 들고 있습니다. SWE-2 Flash의 학습은 사이버보안 작업을 의도적으로 겨냥했고, 그 결과 ExploitBench 점수가 11.3%에서 34.8%로 올랐습니다. 같은 능력이 공격자에게도 악용될 수 있다는 설명입니다. Cognition이 제시한 해법은 신뢰할 수 있는 업계 파트너와 연구소에 가중치를 안전하게 공유하는 프로그램이며, 세부 내용은 몇 주 안에 공개하겠다고 했습니다. 따라서 이를 오픈 웨이트 약속이 아니라 통제된 접근 프로그램으로 봐야 합니다.
현재 Devin 외부에서는 SWE-2 Flash를 직접 평가할 수 없습니다. 공개 엔드포인트도, 직접 호스팅할 방법도 없기 때문입니다.
Flash와 SWE-2 중 무엇을 실행할까? 작업별 라우팅 기준
작업량이 많으면 SWE-2 Flash로, 모호성이 크면 SWE-2로 보내세요.
자동화, 의존성 업데이트, 테스트 추가, 리뷰 피드백 반영, 완료 조건이 명확한 소규모 기능, 문서 수정에는 먼저 SWE-2 Flash를 사용하면 됩니다. 이런 작업은 FrontierCode 2.0에서 24.0% 대 23.8%, SWE-Bench Pro v2 Hard에서 89.9% 대 90.6%로 SWE-2 Flash가 SWE-2에 몇 점 차이로 근접한 영역과 맞닿아 있습니다.
여러 파일에 걸친 계획 수립, 긴 터미널 명령 시퀀스, 익스플로잇과 가까운 추론이 필요한 작업은 SWE-2로 올리세요. DeepSWE 1.1에서는 12.9%포인트, SWE-Atlas QA에서는 6.3%포인트, Terminal-Bench 4.0에서는 7.3%포인트의 차이가 납니다. HamiRev의 SWE-2 리뷰는 SWE-2가 SWE-1.7보다 적은 단계와 빠른 초기 편집을 지향하도록 조정됐다고 설명합니다. SWE-2 Flash는 이런 짧은 작업 중심의 성향을 한층 더 밀어붙인 모델이라고 볼 수 있습니다.
모든 티켓을 우선 SWE-2 Flash로 시작하고, 두 번의 루프 안에 진전이 없으면 SWE-2로 올리는 방식이 현실적입니다. 11월 무료 기간이 끝난 뒤 실제 Devin 지출이 5분의 1이라는 비율을 대체하게 되면 다시 판단하세요. 아직 남은 핵심 변수는 투명성입니다. 보안 가중치 공유 프로그램이 비공개 배포의 길을 열 수도 있지만, 구체적인 조건이 공개되기 전까지 규제 산업의 팀이 SWE-2 Flash를 기준으로 계획을 세우기는 어렵습니다.
SWE-2 Flash FAQ
SWE-2 Flash를 API로 사용할 수 있나요?
독립 실행형 SWE-2 Flash API는 없습니다. Devin Desktop과 Devin CLI를 통해서만 사용할 수 있으며, Pro·Max·Teams 사용자는 2026년 11월 30일까지 무료로 이용할 수 있습니다.
SWE-2 Flash는 오픈 웨이트인가요?
아닙니다. Cognition은 사이버 위험을 이유로 들고 있으며, 일부 파트너와 연구소를 대상으로 한 향후 보안 공유 프로그램만 약속했습니다.
SWE-2 Flash는 SWE-2와 비교해 어떤가요?
SWE-2 Flash는 SWE-2의 초당 60토큰보다 빠른 초당 200토큰으로 실행되며, Cognition의 작업 비용 계산 기준으로 비용은 5분의 1입니다. 하지만 DeepSWE 1.1에서는 SWE-2가 73.0% 대 60.1%, Terminal-Bench 4.0에서는 27.3% 대 20.0%로 여전히 앞섭니다.
SWE-2 Flash의 컨텍스트 윈도우는 얼마인가요?
Cognition은 SWE-2 Flash의 컨텍스트 윈도우, 최대 출력 길이, 모달리티 사양을 공개하지 않았습니다. Inkling-Small의 제한을 그대로 물려받았다고 가정해서는 안 됩니다.
11월 30일 무료 기간이 끝나면 어떻게 되나요?
Cognition은 프로모션 이후 SWE-2 Flash의 과금 방식을 밝히지 않았습니다. 별도의 토큰 요금이 아니라 Devin 구독 사용량에 포함되는 방식을 예상하는 편이 타당합니다.