 AIREITER
2026년 8월 25일, Alibaba의 ModelScope에 Qwen3.8-Flash-Next 카운트다운 페이지가 올라왔습니다. 아직 정식 제품군인 Qwen4가 나오기도 전에, 그 기반이 될 새 아키텍처를 먼저 공개하는 모델입니다. 이 글을 쓰는 시점에는 가중치가 8월 26일 23:00 UTC+8에 공개될 예정이었습니다. 목표는 분명합니다. Qwen4가 출시되기 전에 오픈소스 추론 생태계가 커널, 양자화, 서빙 지원을 미리 준비할 시간을 확보하는 것입니다.
Qwen3.8-Flash-Next의 정체, 그리고 Qwen4가 아닌 이유
Qwen3.8-Flash-Next는 차기 Qwen4 제품군을 위해 설계된 아키텍처를 적용한 멀티모달 Mixture-of-Experts(MoE) 모델입니다. 다만 Qwen4 자체는 아닙니다. 새로운 어텐션 메커니즘과 레이어 구성, 희소성 패턴을 실제 동작하는 모델로 먼저 공개해 추론 프레임워크가 Qwen4 정식 출시 전에 지원을 추가할 수 있도록 하는 기술 시연 모델에 가깝습니다.
Qwen 팀의 Hugging Face 페이지에는 이 모델이 "Upcoming release", 즉 출시 예정 모델이자 "A Preview of the Qwen4 Architecture"로 소개돼 있습니다. ModelScope 카운트다운 페이지에는 "Onward to the Next-Gen — Lightning-Fast."라는 문구가 붙었습니다. 모두 공식 Qwen 채널이므로 출시 자체는 확인된 상태입니다. 다만 이 글을 작성할 당시에는 공개 절차가 아직 끝나지 않았습니다.
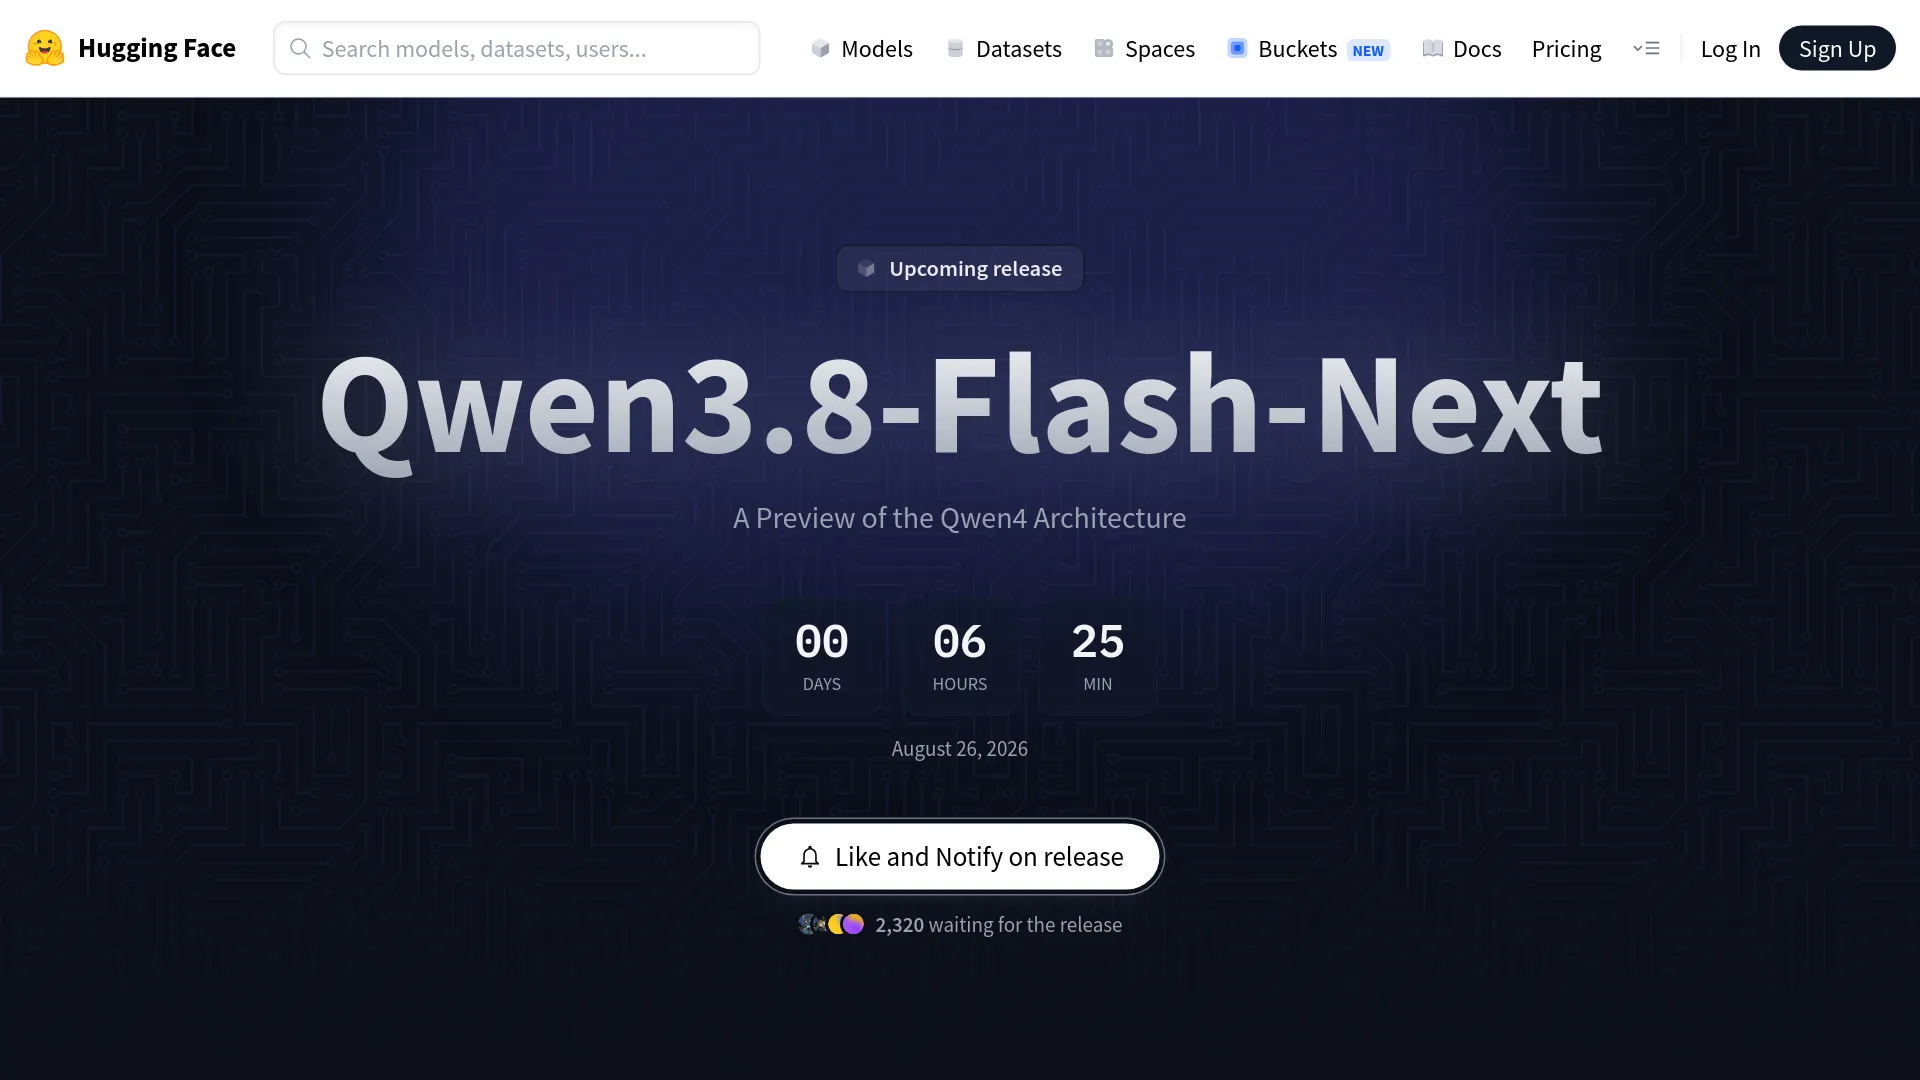
현재 공식 채널을 통해 확인된 내용과 커뮤니티 추측을 나누면 다음과 같습니다.
| 공식 채널을 통해 확인된 내용 | 아직 확인되지 않은 내용 |
|---|---|
| ModelScope와 Hugging Face를 통한 오픈 웨이트 공개 | 최종 파라미터 수(125B/6B/51B) |
| 멀티모달(비전 + 텍스트) | 라이선스(기존 사례를 보면 Apache 2.0일 가능성이 높음) |
| GDN 하이브리드 아키텍처와 Qwen Sparse Attention | 어떤 종류의 벤치마크 점수든 아직 없음 |
FP8 변형 모델(Qwen/Qwen3.8-Flash-Next-FP8) | API 가격 또는 제공 여부 |
| Qwen4를 위한 아키텍처 프리뷰 | 컨텍스트 길이(기본 256K, 최대 1M까지 확장 가능하다는 추측) |
많은 사람이 인용하는 수치인 총 125B, 토큰당 활성 6B, n-gram 임베딩 51B는 ModelScope 카드에 잠시 노출됐다가 Qwen 팀에 의해 수정된 내용을 바탕으로 합니다. 여러 독립적인 관찰자가 같은 수치를 확인했고 기술적으로도 충분히 그럴듯하지만, 지속적으로 유지되는 공식 문서로 보기는 어렵습니다. SaaSCity 창업자 ghosty는 다음과 같이 지적했습니다.
"오늘 이 모델의 벤치마크 차트를 올리는 사람은 지어낸 겁니다."
추론 프레임워크의 설계까지 바꾸는 아키텍처
Qwen3.8-Flash-Next가 현재 Qwen 라인업과 본질적으로 다른 이유는 세 가지 아키텍처 요소에 있습니다. 단순히 설정 파일을 바꾸는 수준이 아니라, 각각 새로운 커널 코드 지원이 필요한 변화입니다.
GDN 레이어: 고정 크기 순환 상태로 장문 컨텍스트 메모리를 줄인다
Gated Delta Network(GDN)은 대부분의 레이어에서 기존 어텐션을 대신합니다. 일반적인 트랜스포머 어텐션은 시퀀스가 길어질수록 KV 캐시도 함께 커지지만, GDN은 고정 크기의 순환 상태를 사용합니다. 따라서 GDN 레이어에서는 컨텍스트 길이가 늘어나도 메모리 사용량이 일정하게 유지되고, 연산량도 제곱이 아닌 선형으로 증가합니다. 반면 하이브리드 아키텍처에 포함된 풀 어텐션 레이어는 정밀한 검색을 위해 여전히 KV 캐시를 사용합니다.
실제 사용 환경에서 가장 큰 변화는 긴 컨텍스트 작업의 비용입니다. 100K 토큰에 걸친 대화라도 100K 토큰 분량의 KV 캐시 메모리를 그대로 확보할 필요가 없습니다. 커뮤니티가 잠시 노출된 ModelScope 카드의 내용을 분석한 결과, Qwen3.8 아키텍처의 레이어 구성은 GDN 69개와 풀 어텐션 23개로 알려졌습니다. 대략 3:1 비율입니다. 풀 어텐션 레이어가 전체 검색 품질을 유지하고, GDN 레이어가 대부분의 시퀀스 처리를 맡는 구조입니다.
Qwen에 완전히 새로운 개념은 아닙니다. 2025년 9월 공개된 Qwen3-Next는 총 80B, 활성 3B 규모에서 Gated DeltaNet을 처음 도입했고, Qwen3.5/3.6/3.7 제품군도 비슷한 하이브리드 구성을 유지한 것으로 알려졌습니다. Flash-Next에서 달라진 점은 이 구조를 총 125B 규모로 확장했다는 것, 그리고 다음 두 요소를 추가했다는 데 있습니다.
QSA: 희소 어텐션이라는 이름만 공개된 상태
Qwen Sparse Attention(QSA)은 모델 카드에 이름만 등장했을 뿐, 구체적인 작동 방식은 설명되지 않았습니다. 현재 커뮤니티에서는 모든 토큰이 전체 시퀀스를 참조하는 대신 일부 토큰만 선택해 바라보는 희소 패턴으로 이해하고 있습니다. 하지만 학습된 희소성인지, 블록 희소성인지, 슬라이딩 윈도우 방식인지, 혹은 여러 방식을 조합했는지는 아직 알 수 없습니다. 기술 보고서가 공개되면 QSA가 기존 어텐션을 조금 개선한 수준인지, 완전히 새로운 어텐션 기본 연산인지 판단할 수 있을 것입니다.
51B n-gram 테이블: 별도 드래프트 모델 없는 추측 디코딩
가장 이례적인 요소는 51B 파라미터 규모의 n-gram 임베딩 테이블입니다. 커뮤니티의 현재 가설에 따르면 이 테이블은 빠른 토큰 조회 장치로 작동하며, 사실상 추측 디코딩을 위한 내장형 드래프트 모델 역할을 합니다. 일반적인 방식처럼 작은 모델을 별도로 실행해 다음 몇 개 토큰을 예측한 뒤 메인 모델로 검증하는 대신, n-gram 테이블이 저렴하게 다음 토큰 후보를 직접 제공하는 방식입니다.
아직 중요한 질문이 남아 있습니다. 이 테이블을 VRAM에 상주시켜야 하는지, 메모리 매핑으로 처리할 수 있는지 알 수 없습니다. 양자화했을 때의 동작도 확인되지 않았고, 125B 수치에 포함되는지 별도인지도 불분명합니다. 기술 보고서나 첫 커뮤니티 벤치마크가 나오기 전까지는 51B라는 수치를 확정된 비용이 아니라 배포 계획을 세울 때 고려할 변수로 보는 편이 안전합니다.
Qwen 제품군에서 Flash-Next가 차지하는 위치
Flash-Next는 선형적인 세대교체의 다음 단계라기보다, 별도의 병렬 트랙에 가깝습니다.
| 모델 | 출시 시기 | 총 파라미터 | 활성 파라미터 | 역할 |
|---|---|---|---|---|
| Qwen3-Next | 2025년 9월 | 80B | 3B | 첫 GDN 아키텍처 테스트 |
| Qwen3.8-27B | 2026년 8월 | 27B(밀집형) | 27B | 중급형 밀집 모델 |
| Qwen3.8-Max | 2026년 8월 | ~2.4T | ~95B | 플래그십 오픈 웨이트 모델 |
| Qwen3.8-Flash-Next | 2026년 8월 26일 | ~125B | ~6B | Qwen4를 위한 아키텍처 프리뷰 |
| Qwen4 | 미정(수개월 후) | 미정 | 미정 | 차세대 전체 제품군 |
커뮤니티가 참고하는 경험칙은 다음과 같습니다. sqrt(125B x 6B) = 27B. 이 계산이 대체로 맞다면 Flash-Next는 27B 밀집 모델에 가까운 품질을 내면서도, 추론 연산량은 6B 모델에 가까운 수준으로 낮출 가능성이 있습니다. 다만 Beer And Code의 Lucas Souza가 지적했듯 이는 정리가 아니라 경험칙일 뿐입니다. 라우팅 품질과 데이터 품질, n-gram 테이블의 기여도는 아직 측정되지 않았습니다.
여러 커뮤니티 분석에서 이 전략은 "벤치마크가 아닌 플랫폼을 위한 행보"로 설명됩니다. Qwen4가 출시되기 전에 llama.cpp, vLLM, SGLang 같은 추론 프레임워크가 커널 지원을 추가하도록 만드는 것입니다. Unsloth는 이미 출시 당일부터 지원하기 위해 작업 중이라고 밝혔습니다.
실제로 실행할 수 있을까? 하드웨어 현실 점검
| 형식 | 대략적인 가중치 메모리 |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4비트 | ~65–70 GB |
위 수치는 컨텍스트, KV 캐시, 런타임 오버헤드를 제외한 가중치만 계산한 값입니다. Q4 양자화 모델도 핵심 가중치에만 약 65–70 GB가 필요하며, 여기에 51B n-gram 테이블이 요구하는 메모리가 추가됩니다. n-gram 테이블까지 VRAM에 올려야 한다면 대부분의 단일 머신 구성으로는 감당하기 어렵습니다. 반대로 시스템 RAM에 메모리 매핑할 수 있다면 128GB 이상의 통합 메모리를 갖춘 시스템, 예를 들어 Mac Studio(M2 Ultra / M3 Ultra 최대 구성), AMD Strix Halo, NVIDIA DGX Spark에서는 실행 가능성이 있습니다. RTX 4090 또는 5090 한 장으로는 부족합니다.
Reddit의 u/KURD_1_STAN은 이 모델을 "로컬 친화적"이라고 부르는 데 반론을 제기했습니다. "램 가격이 이렇게 비싼데 어떻게 로컬 친화적이라고 할 수 있나?"라는 지적입니다. "활성 파라미터 6B"라는 설명과 250GB 메모리 요구량 사이의 간극은 분명히 존재합니다. X의 @Dicklong1999는 희소 활성화 패턴 덕분에 하드웨어를 갖춘 사용자라면 생성 속도가 합리적일 수 있다고 봤지만, "125B라면 일반 사람은 사실상 로컬 실행을 포기해야 한다"고 지적했습니다.
API 제공 여부와 가격은 어떻게 될까
이 글이 발행될 당시 Qwen3.8-Flash-Next의 API 가격과 제공 여부는 발표되지 않았습니다. Qwen 공식 가격 페이지에 따르면 Qwen3.8-Max의 가격은 입력 $2.00/M, 출력 $6.00/M입니다. 활성 파라미터가 6B인 Flash-Next는 이보다 상당히 저렴할 가능성이 있습니다. FP8 변형 모델은 BF16 대비 가중치 메모리를 절반으로 줄일 수 있어 API 서빙에 자연스러운 형식입니다. 실제 제공 시점은 추론 프레임워크 지원 여부에 달려 있으므로, 가중치가 공개된 뒤 각 제공업체 카탈로그를 확인해야 합니다.
가중치 공개 전에 준비할 일
Qwen3.8-Flash-Next가 자신의 개발 환경이나 연구 스택에 의미가 있는지 평가하려는 개발자와 연구자라면 다음 항목부터 준비하는 것이 좋습니다.
1. 하드웨어를 확인하세요. 로컬 실행을 계획한다면 128GB 이상의 통합 메모리 또는 멀티 GPU 구성을 갖췄는지 확인해야 합니다. 조건이 되지 않는다면 API 사용을 전제로 계획을 세우는 편이 낫습니다.
2. Hugging Face 저장소를 지켜보세요. 실제 사양과 라이선스, 컨텍스트 길이를 확인할 수 있는 첫 번째 공식 자료는 모델 카드가 될 것입니다. huggingface.co/Qwen/Qwen3.8-Flash-Next를 북마크해 두세요.
3. 평가 파이프라인을 미리 준비하세요. 가중치가 공개되기 전에 사용할 벤치마크 프롬프트와 평가 스크립트를 준비해 두는 것이 좋습니다. 공개 후 첫 24시간 동안 쌓이는 커뮤니티 벤치마크가 공식 수치보다 실제 판단에 더 많은 정보를 줄 수 있습니다.
4. 운영 환경은 당장 바꾸지 마세요. 아직 독립적인 벤치마크가 없습니다. 아키텍처는 새롭고 런타임 지원은 초기 단계이며, 라이선스도 확인되지 않았습니다. 우선 평가 용도로만 사용하고, 문제가 생겼을 때 비용이 발생하는 운영 작업에는 투입하지 않는 편이 안전합니다.
5. 추론 도구를 관리한다면 지금 시작하세요. GDN과 QSA 조합은 설정 변경이 아니라 커널 작업을 요구합니다. 아키텍처를 일찍 파악할수록 지원 기능도 더 빠르게 제공할 수 있습니다.
FAQ
가중치는 언제 공개되나요?
ModelScope 카운트다운은 2026년 8월 26일 약 23:00 UTC+8을 가리키고 있었습니다. Hugging Face 미러는 일반적으로 ModelScope 공개 후 몇 시간 안에 올라옵니다. Qwen 팀은 공식 채널을 통해 일정을 확인했으며, @Alibaba_Qwen은 "오늘 밤 어떤 깜짝 공개를 준비했는지"를 예고했고 @QwenDevs는 모델명을 직접 언급했습니다.
이게 Qwen4인가요?
아닙니다. Qwen3.8이라는 명명 체계를 사용해 Qwen4 아키텍처를 미리 선보이는 모델입니다. Qwen4 본체는 수 주가 아니라 수개월 뒤에 공개될 것으로 예상됩니다. Flash-Next는 전체 제품군이 출시되기 전에 생태계가 런타임 지원을 준비할 수 있도록 만든 모델입니다.
어떤 라이선스를 사용하나요?
아직 확인되지 않았습니다. 최근 Qwen 오픈 웨이트 모델인 Qwen3.8-27B와 Qwen3.8-Max는 Apache 2.0을 사용했으므로 이것이 가장 가능성 높은 결과입니다. 가중치가 공개되면 모델 카드에서 반드시 확인해야 합니다.
RTX 4090에서 실행할 수 있나요?
어렵습니다. Q4 양자화에서도 핵심 가중치만 약 65–70GB를 요구합니다. RTX 4090 한 장의 VRAM은 24GB입니다. 128GB 이상의 통합 메모리를 갖춘 시스템(Mac Studio, Strix Halo)이나 VRAM이 큰 GPU 여러 장이 필요합니다.
Qwen3.8-27B보다 성능이 좋은가요?
아직 알 수 없습니다. 공개된 벤치마크가 없습니다. sqrt(125B x 6B) = 27B라는 경험칙은 27B 밀집 모델과 비슷한 품질을 낼 가능성을 시사하지만, 측정 결과가 아닌 추정치입니다. 자신의 사용 사례에 맞는 독립 평가가 나올 때까지 기다리는 것이 좋습니다.
속도는 얼마나 빠를까요?
토큰당 활성 파라미터가 6B라는 점만 보면 생성 속도는 125B 모델보다는 소형 모델에 가까울 가능성이 있습니다. 하지만 n-gram 테이블의 메모리 접근 패턴과 GDN 커널의 효율은 아직 확인되지 않은 변수입니다. 첫 커뮤니티 벤치마크가 실제 속도를 보여줄 것입니다.
API 플랫폼에서도 사용할 수 있을까요?
가능성은 매우 높습니다. FP8 변형 모델은 API 서빙을 염두에 둔 형식으로 보입니다. AIReiter를 비롯한 여러 플랫폼은 일반적으로 가중치 공개 후 며칠 안에 Qwen 모델을 추가합니다. 다만 새로운 어텐션 메커니즘을 추론 프레임워크가 지원하는지가 병목이 될 수 있습니다.
지난해 Qwen3-Next는 어떻게 됐나요?
Qwen3-Next는 2025년 9월 총 80B, 활성 3B 파라미터 규모로 출시됐으며 Gated DeltaNet을 처음 도입했습니다. GDN 하이브리드 접근법이 실제로 작동하는지 확인한 소규모 아키텍처 테스트였습니다. Flash-Next는 이를 확장한 후속 모델입니다. X의 한 사용자인 @LufzzLiz는 지난해 Next 시리즈가 "실망스러웠다"고 평가했습니다. 이번에도 벤치마크를 기다려야 하는 이유입니다.