 AIREITER
Qwen Audio 3.0 Realtime은 사람과 대화하듯 음성을 주고받기 위한 Qwen의 실시간 오디오 기능이다. 체감상 전화 통화에 가까울 만큼 지연 시간이 짧으며, Alibaba 플랫폼에서는 Qwen3-Omni / Qwen3.5-Omni Realtime API로 제공된다. 대표 모델 ID는 qwen3-omni-flash-realtime이며, 단순 음성 합성에는 Qwen-TTS-Realtime, 음성 인식에는 qwen3-asr-flash를 쓴다. 호스팅형 omni Realtime 모델은 100개 이상의 언어를 인식하고, 끼어들기가 가능한 전이중 대화를 지원하며, 대화 1분당 비용도 1센트보다 훨씬 낮다.
가장 빠르게 시작하는 방법은 WebSocket으로 qwen3-omni-flash-realtime에 연결하는 것이다. 아래에서 모델별 역할과 가격, OpenAI Realtime·Gemini Live와의 차이, 시작 방법을 정리한다. 사양과 가격, 모델 ID는 대부분 Alibaba의 Model Studio Realtime documentation 및 Qwen3-Omni model card 원문에 연결해 두었다. 이 영역은 변경이 빠르므로 수치가 달라졌다면 링크한 원문을 우선 확인하는 편이 안전하다.
Qwen 오디오 모델 이름, 이렇게 구분하면 된다
Qwen의 오디오 계보를 알면 어떤 모델을 골라야 할지 훨씬 간단해진다.
Qwen-Audio(2023)와Qwen2-Audio는 오디오를 이해하는 모델이었다. 음성을 입력받아 텍스트를 출력하지만, 음성으로 답하지는 않았다.- 현 세대에서는 오디오 기능이 omni 모델에 통합됐다.
Qwen3-Omni와Qwen3.5-Omni는 텍스트·이미지·오디오·비디오를 입력받고 텍스트와 자연스러운 음성을 모두 생성한다. - 실시간 동작은 별도 모델 계열이 아니라 제공 방식에 가깝다. 동일한 omni 모델을 Realtime API로 호출하며, 모델 ID 끝에
-realtime이 붙는다.
즉 표기 방식이 어떻든 "Qwen Audio 3.0 Realtime"은 실시간으로 쓰는 Qwen3-Omni 계열을 가리킨다. 이 글에서 다루는 범위도 바로 이 스택이다.
Qwen 실시간 오디오 스택: 3개 레이어로 보기
이 기능을 하나의 모델로만 보기보다 파이프라인으로 이해하는 편이 낫다. 실제 음성 앱은 보통 아래 세 모델을 조합하며, 필요에 따라 함께 또는 개별적으로 사용할 수 있다.
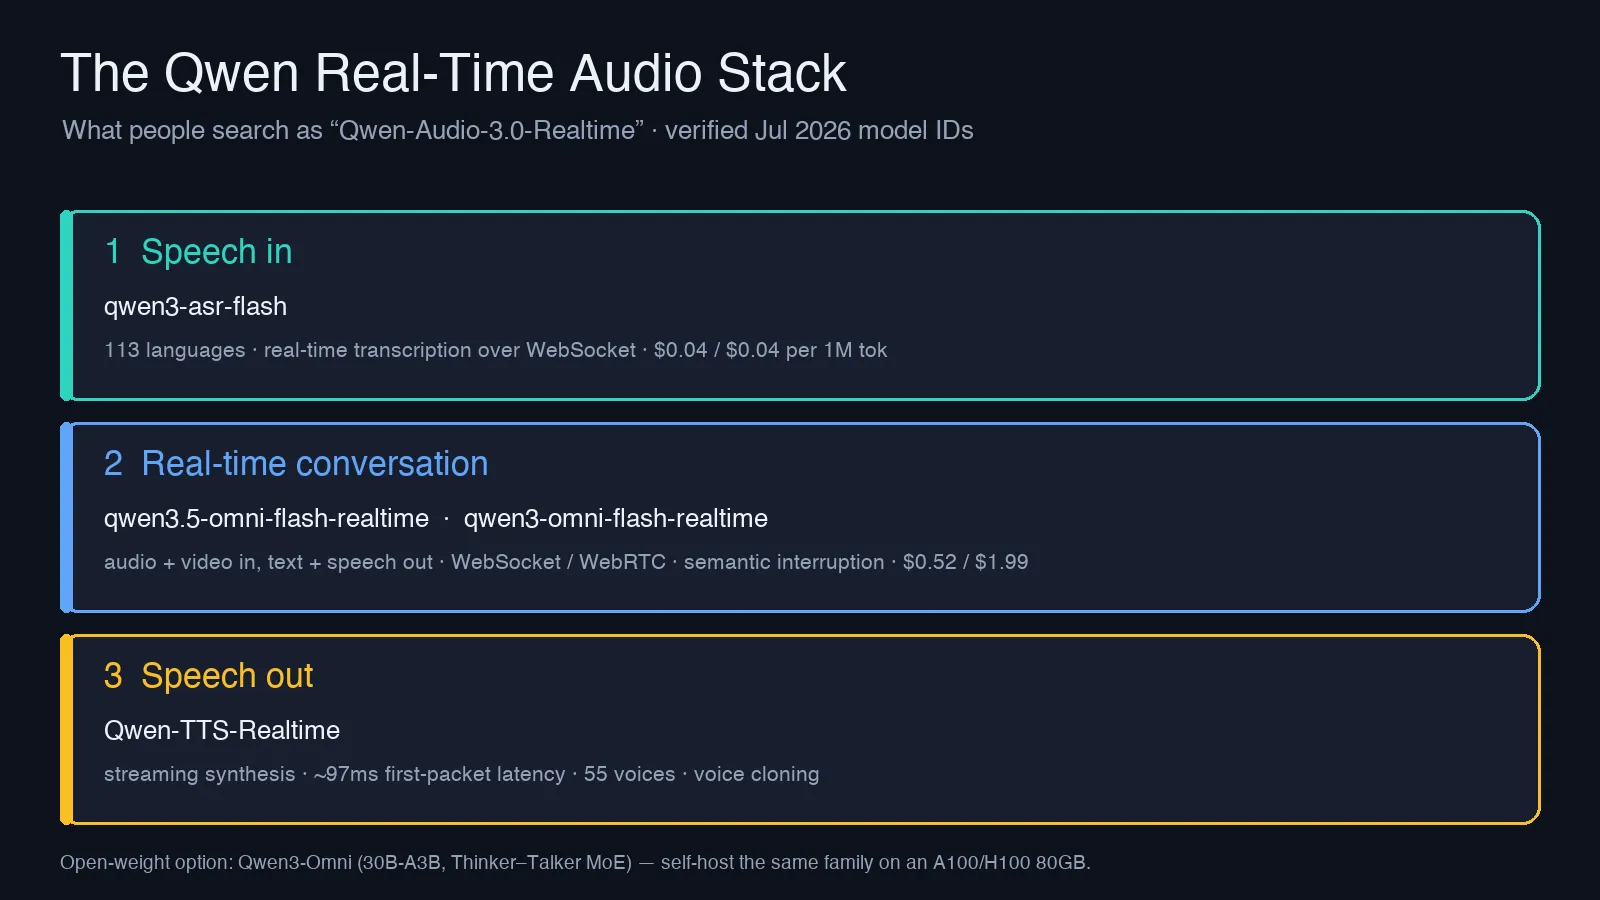
- 음성 입력 —
qwen3-asr-flash. 실시간 자막과 음성 에이전트 프런트엔드에 맞춘 WebSocket 기반 스트리밍 음성 인식 모델이다. 매우 폭넓은 언어를 전사하며, 저렴한 비용의 음성 전사 워크호스로 쓸 수 있다. - 실시간 대화 —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. 핵심 레이어다. 오디오와 비디오 프레임을 입력받아 텍스트와 합성 음성을 출력하며, 요청마다 연결을 새로 열지 않고 턴 사이에도 유지되는 지속 연결을 사용한다. - 음성 출력 —
Qwen-TTS-Realtime. 텍스트를 음성으로만 바꿔야 할 때 쓰는 전용 스트리밍 TTS 모델이다. 예를 들어 텍스트 LLM이 생성한 답변을 읽어주는 용도에 적합하다.
가운데 레이어에 omni Realtime 모델을 쓰면 음성 입력과 출력을 처음부터 끝까지 처리하므로, 별도의 ASR·TTS 호출이 필요 없는 경우가 많다. 다만 자체 STT와 Qwen TTS를 조합하는 식으로 구성 요소를 바꾸고 싶을 때는 개별 모델이 유용하다.
실제로 봐야 할 핵심 사양
아래 수치는 마케팅 페이지가 아니라 Model Studio Realtime documentation에 나온 내용이다.
| 항목 | Qwen Realtime API (omni 계열) |
|---|---|
| 오디오 입력 | PCM, 16 kHz |
| 오디오 출력 | PCM, 24 kHz |
| 기타 입력 | 이미지 / 비디오 프레임(JPG, 최대 1080p, 인코딩 후 256 KB) |
| 음성 인식 | 113개 언어 및 방언(호스팅 API) |
| 음성 생성 | 36개 언어 및 방언 |
| 음성 | 총 55개(다국어 47개, 방언 8개), 3.5 모델은 음성 복제 지원 |
| 연결 방식 | WebSocket(Bearer 인증, 수동 또는 서버 측 VAD) 및 WebRTC(SDP 협상) |
| 최대 세션 | WebSocket 기준 120분 |
| 추가 기능 | 의미 기반 끼어들기 감지, 함수 호출, 자율 웹 검색, 볼륨 / 속도 / 감정 음성 제어 |
특히 몇 가지는 눈여겨볼 만하다. 의미 기반 끼어들기 감지는 사용자가 말을 끊으려는 것인지, 단순히 "음, 네"처럼 호응하는 것인지를 모델이 구분한다는 뜻이다. 자연스러운 음성 에이전트와 불편한 음성 에이전트를 가르는 차이다. WebRTC 지원도 브라우저 기반 서비스라면 중요하다. 에코 캔슬링과 지터 처리를 WebRTC가 맡아주기 때문이다. 또한 113개 언어 인식 수치는 호스팅 API 기준이며, 뒤에서 설명하듯 오픈 웨이트 버전의 지원 범위는 이보다 좁다.
지연 시간을 보면, 전용 스트리밍 경로인 Qwen-TTS-Realtime은 Qwen3-TTS streaming docs 기준 약 97 ms의 첫 패킷 지연 시간을 목표로 한다. 음성이 즉각적으로 느껴지는지를 좌우하는 수치다. 이는 전체 응답이 끝나는 시간이 아니라 첫 오디오 청크가 도착할 때까지의 시간이다. 전체 대화 루프는 Thinker–Talker 설계 자체가 스트리밍을 염두에 두고 만들어졌으며, Qwen3-Omni technical report는 지연 시간 최소화를 목표로 한 멀티 코드북 구조를 설명한다. 커뮤니티 테스트에서는 전이중·인터럽트 가능한 턴에서 오디오-투-오디오 응답이 250 ms 미만 범위에 들어온다는 결과도 나왔다. 다만 실제 수치는 리전, 네트워크, 부하에 따라 달라지므로 하나의 홍보성 수치보다 자체 트래픽 측정을 신뢰해야 한다.
Qwen 실시간 오디오 가격: 숫자로 계산하기
Qwen의 호스팅형 실시간 가격은 폐쇄형 실시간 API보다 확실히 낮은 편이다. 아래는 Portkey's DashScope model directory에 기재된 100만 토큰당 입력 / 출력 가격이다. 이 사이트는 Alibaba 요금을 반영하는 서드파티 집계 서비스이므로, 실제 도입 전에는 Model Studio console에서 최신 금액을 확인해야 한다.
| 모델 | 입력 / 100만 토큰 | 출력 / 100만 토큰 |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (전사) | $0.04 | $0.04 |
통화 한 번당 비용은 어느 정도일까? 오디오는 토큰 소모가 큰 입력이다. 분당 약 427 tokens per minute of audio로 계산된다. 사용자가 5분 말하고 모델도 5분 답하는 10분 음성 대화를 가정해 보자. qwen3-omni-flash-realtime에서는 입력 약 2,135토큰, 출력 약 2,135토큰이므로 입력 약 $0.001 + 출력 약 $0.004, 즉 10분 통화당 약 반 센트 수준이다. 규모가 커져도 실시간 오디오 자체는 저렴한 편이다. 다만 출력 음성은 입력보다 약 4배 높은 가격이므로, 비용에서 의외로 커지는 부분은 출력 측 발화 시간이다.
예산을 잡기 전에 추가로 확인할 점은 두 가지다.
- 무료 할당량은 제공되지만 리전에 따라 다르다. 싱가포르(국제) 엔드포인트에서는 입력 100만 토큰과 출력 100만 토큰을 90일간 무료로 제공한 바 있다. 미국 엔드포인트에는 이 혜택이 없었다. 할당량은 바뀔 수 있으므로, 이를 전제로 계획하기 전 해당 리전의 Model Studio console에서 현재 혜택을 확인해야 한다.
qwen3.5-omni티어는 고정 요금제가 아니라 요청 크기별 가격 구간을 사용한다. 따라서 컨텍스트가 큰 요청 하나는 작은 요청 여러 개와 다른 가격대에 걸릴 수 있다. 도입 전 실제 트래픽 형태로 테스트하는 것이 좋다.
OpenAI Realtime·Gemini Live와 비교하면
2026년 중반 범용 프런티어 LLM 업체의 실시간 음성-투-음성 선택지는 OpenAI Realtime API, Google Gemini Live, Qwen omni Realtime 계열이 대표적이다. ElevenLabs, Deepgram, Cartesia, Hume 같은 전문 음성 업체도 TTS와 STT 분야에서 강력하게 경쟁하지만, 여기서는 완성형 멀티모달 모델 경로를 비교한다. 매달 바뀌는 경쟁사 가격을 나열하는 대신, 선택 기준을 중심으로 보자.
- 비용. 위의 통화당 비용 기준으로 보면 Qwen의 실시간 요금은 호스팅형 프런티어 모델 옵션 가운데 낮은 쪽에 속한다. 비교를 위해 OpenAI Realtime 오디오는 입력 분당 약 $0.06, 출력 분당 $0.24 수준으로 책정된 바 있다(pricing breakdown here). 이 기준이라면
qwen3-omni-flash-realtime에서 약 반 센트인 동일한 10분 통화가 OpenAI에서는 $1.50에 가까워진다. 모든 요금은 변하므로 차이에 의존하기 전 양쪽의 최신 가격을 확인해야 하지만, 격차 자체는 크다. 또한 셋 중 Qwen만 한계 비용을 0에 가깝게 낮출 수 있는 오픈 웨이트 버전을 제공한다. - 개방성. OpenAI Realtime과 Gemini Live는 폐쇄형 API로만 제공된다. Qwen3-Omni는 오픈 웨이트로 배포되므로, 앱을 다른 모델 동작에 맞춰 다시 설계하지 않고도 호스팅 환경에서 자체 호스팅으로 옮길 수 있다.
- 품질. 서드파티 자료에 따르면 최상위
qwen3.5-omni-plus티어는 일부 오디오 이해 벤치마크에서 Gemini 3.1 Pro와 동등하거나 더 나은 성능을 보인다. 다만 어떤 단일 벤치마크든 출발점으로만 보고, 실제 서비스 오디오로 검증해야 한다. - 생태계. 현재는 OpenAI와 Google 쪽이 도구, SDK, 커뮤니티 예제 면에서 더 깊다. Qwen 문서도 충실한 편이지만, WebSocket/WebRTC 원시 스펙을 직접 다뤄야 하는 비중은 더 크다.
실무적으로 정리하면, 비용이나 자체 호스팅 선택지가 중요하다면 Qwen이 가장 강력한 선택이다. 가장 다듬어진 SDK 경험이 필요하고 그만큼의 비용을 감수할 수 있다면 OpenAI와 Google이 여전히 앞선다. 폐쇄형 대안의 자세한 비용 구조는 아래 관련 글에서 확인할 수 있다.
어떤 모델을 선택해야 할까?
| 상황 | 추천 모델 |
|---|---|
| 가장 저렴한 호스팅형 전체 음성 대화 | qwen3-omni-flash-realtime |
| 최고의 호스팅 품질, 긴 세션, 음성 복제 | qwen3.5-omni-plus-realtime |
| 음성 전사만 필요 | qwen3-asr-flash |
| 텍스트 음성 변환만 필요 | Qwen-TTS-Realtime |
| 데이터를 자체 하드웨어에만 보관해야 함 | 오픈 웨이트 Qwen3-Omni (30B-A3B) 자체 호스팅 |
3.5 티어는 경량형 qwen3-omni-flash(8턴)보다 음성 복제, 더 긴 컨텍스트와 대화 한도(최대 100턴, 보존 오디오 600초)를 제공한다. 프로토타입 단계라면 Flash로 시작하고, 명확한 한계에 부딪혔을 때만 Plus로 올리는 편이 합리적이다.
이용 방법
호스팅 API를 직접 쓰는 방법. Alibaba Cloud Model Studio에서 API 키를 발급한 뒤, Bearer 인증으로 WebSocket을 열면 된다. 브라우저 앱이라면 SDP POST로 WebRTC를 협상할 수도 있다. PCM 오디오를 스트리밍으로 전송하고, PCM 오디오와 텍스트를 수신한다. 소켓을 직접 관리하고 싶지 않다면 DashScope Python SDK가 Realtime 인터페이스를 감싼다. 오류 처리를 생략한 최소 연결 예시는 다음과 같다.
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. 세션 설정: 음성, 출력 형식, 서버 측 턴 감지
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. 마이크 오디오를 base64 PCM 16 kHz 프레임으로 스트리밍 전송
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. 이벤트 수신: response.audio.delta에는 재생할 PCM 24 kHz가 담김
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
서버 측 VAD를 사용하면 사용자가 말을 멈춘 시점을 모델이 판단한다. 턴 경계를 직접 제어하고 싶다면 수동 방식으로 바꾸면 된다. 이벤트 흐름은 OpenAI Realtime 구조와 상당히 비슷하므로, 기존 Realtime 클라이언트 코드도 약간의 수정만으로 이식할 수 있다. 다만 싱가포르와 미국 배포 환경은 필드명, 음성 목록, 리전별 엔드포인트 호스트가 다를 수 있고 API도 계속 바뀌므로, 출시 전 Realtime docs에서 정확한 값을 확인해야 한다.
자체 호스팅. 오픈 웨이트 Qwen3-Omni는 Thinker–Talker MoE(Mixture-of-Experts) 구조를 사용한다. 전체 파라미터는 30B, 활성 파라미터는 약 3B이며, Alibaba는 일반 Transformers보다 vLLM 사용을 권장한다. 전체 30B 모델을 BF16으로 추론하려면 third-party deployment guides 기준 최소 80GB 카드 1장(A100 또는 H100)이 필요하다. RTX 4090 같은 24 GB 카드는 전체 웨이트를 올리기에는 부족하지만, 양자화 빌드는 이 기준을 낮춘다.
문제는 실시간 서빙이 배치 추론보다 어렵다는 점이다. 자체 호스팅 사용자들은 동시 부하에서 멈춤 현상을 피하려면 KV 캐시를 제한해야 했고, 단일 카드의 토큰 처리량도 호스팅 API보다 낮다고 보고한다. 스트리밍에 맞춘 서빙 스택은 이 차이를 상당 부분 줄인다. Red Hat AI와 vLLM 작업을 하는 엔지니어들은 파이프라인 단계를 겹쳐 처리하면 3초 클립의 음성 생성을 약 8초에서 약 0.5초로 줄일 수 있다고 보고했다. 분명한 개선이지만 그만큼의 추가 엔지니어링이 필요하다. 자체 호스팅은 토큰당 비용을 없애는 대신 GPU와 운영 비용을 더하므로, 프로토타입보다는 높고 안정적인 트래픽에서 효과가 크다.
현재 실시간 omni 음성을 위한 정석 경로는 DashScope 엔드포인트다. 여러 공급자를 하나의 게이트웨이로 연결하는 스택이라면 그 앞에 애그리게이터를 둘 수도 있다. 다만 많은 중계 서비스가 텍스트·이미지 모델만 제공하고 실시간 오디오 티어는 제외하므로, 해당 서비스 카탈로그에 Qwen 실시간 모델 ID가 실제로 있는지 먼저 확인해야 한다.
개발 전에 알아둘 제한 사항
- 세션은 최대 120분이다. 고객 지원 전화나 장시간 튜터링처럼 더 긴 세션에는 소켓 간 컨텍스트를 이어가는 재연결 로직이 필요하다.
- 리전에 따라 무료 할당량과 제공 여부가 달라진다. 처음 가입한 엔드포인트가 아니라 실제 배포할 엔드포인트를 기준으로 테스트해야 한다.
- 호스팅 API와 오픈 웨이트는 동일하지 않다. 호스팅 API는 113개 언어 인식과 36개 언어 생성을 내세우지만, 오픈 웨이트 Qwen3-Omni release는 더 좁은 범위인 음성 입력 19개, 음성 출력 10개 언어를 지원한다. 특정 언어가 필수 요건이라면 출시할 정확한 모델 변형에서 검증해야 한다.
- 실시간 비용은 요청 수가 아니라 발화 시간에 비례한다. 오디오는 토큰을 많이 쓰므로, 짧게 말하는 사용자보다 대화량이 많은 사용자의 비용이 더 높다. 청구액은 호출 수가 아닌 대화 시간(분)을 기준으로 모델링해야 한다.
자주 묻는 질문
Qwen 3는 오디오를 지원하나요?
지원한다. Qwen3-Omni 모델은 오디오, 텍스트, 이미지, 비디오를 입력으로 받는 네이티브 멀티모달 모델이며, 실시간 텍스트 또는 음성으로 응답할 수 있다.
Qwen은 오디오를 이해하는 것뿐 아니라 생성도 할 수 있나요?
가능하다. 텍스트만 출력했던 초기 Qwen-Audio와 달리 omni Realtime 모델과 Qwen-TTS-Realtime은 음성 출력을 생성한다. 3.5 티어에서는 복제한 음성도 사용할 수 있다.
Qwen 실시간 오디오는 무료인가요?
무료 체험 할당량이 있다. 과거 국제(싱가포르) 엔드포인트에서는 입력 100만 토큰과 출력 100만 토큰을 90일간 제공했다. 이후에는 토큰당 과금되며, 완전한 오픈 웨이트인 Qwen3-Omni는 자체 GPU를 제공한다면 무료로 실행할 수 있다.
Qwen 오디오를 로컬에서 실행하려면 어떻게 하나요?
오픈 웨이트 Qwen3-Omni (30B-A3B)를 내려받아 vLLM으로 서빙하면 된다. 전체 모델을 BF16으로 실행하려면 A100 또는 H100급 약 80GB 카드가 필요하다. 소형 소비자용 GPU에서는 전체 웨이트가 아니라 양자화 빌드만 처리할 수 있다.
관련 자료
주요 출처:
대안 서비스의 가격 비교: