 AIREITER
짧은 영어·중국어 오디오를 만든다면 Seed Audio 1.0은 지금 시험해볼 만하다. 다만 공식 API가 아니라 서드파티 게이트웨이를 통해서다. ByteDance의 이 모델은 프롬프트 하나만으로 대화, 배경 음악, 효과음이 어우러진 완성형 오디오 장면을 생성한다. 여러 화자의 대화와 음악 믹싱까지 한 번에 처리한다는 점이 단일 목적 TTS나 음악 생성 도구와의 가장 큰 차이다. 반면 생성당 최대 길이는 2분이고, 지원 언어는 영어와 중국어뿐이다. 공식 API도 아직 초대 전용이며 공개 가격은 없다.
Seed Audio 1.0은 어떤 모델인가
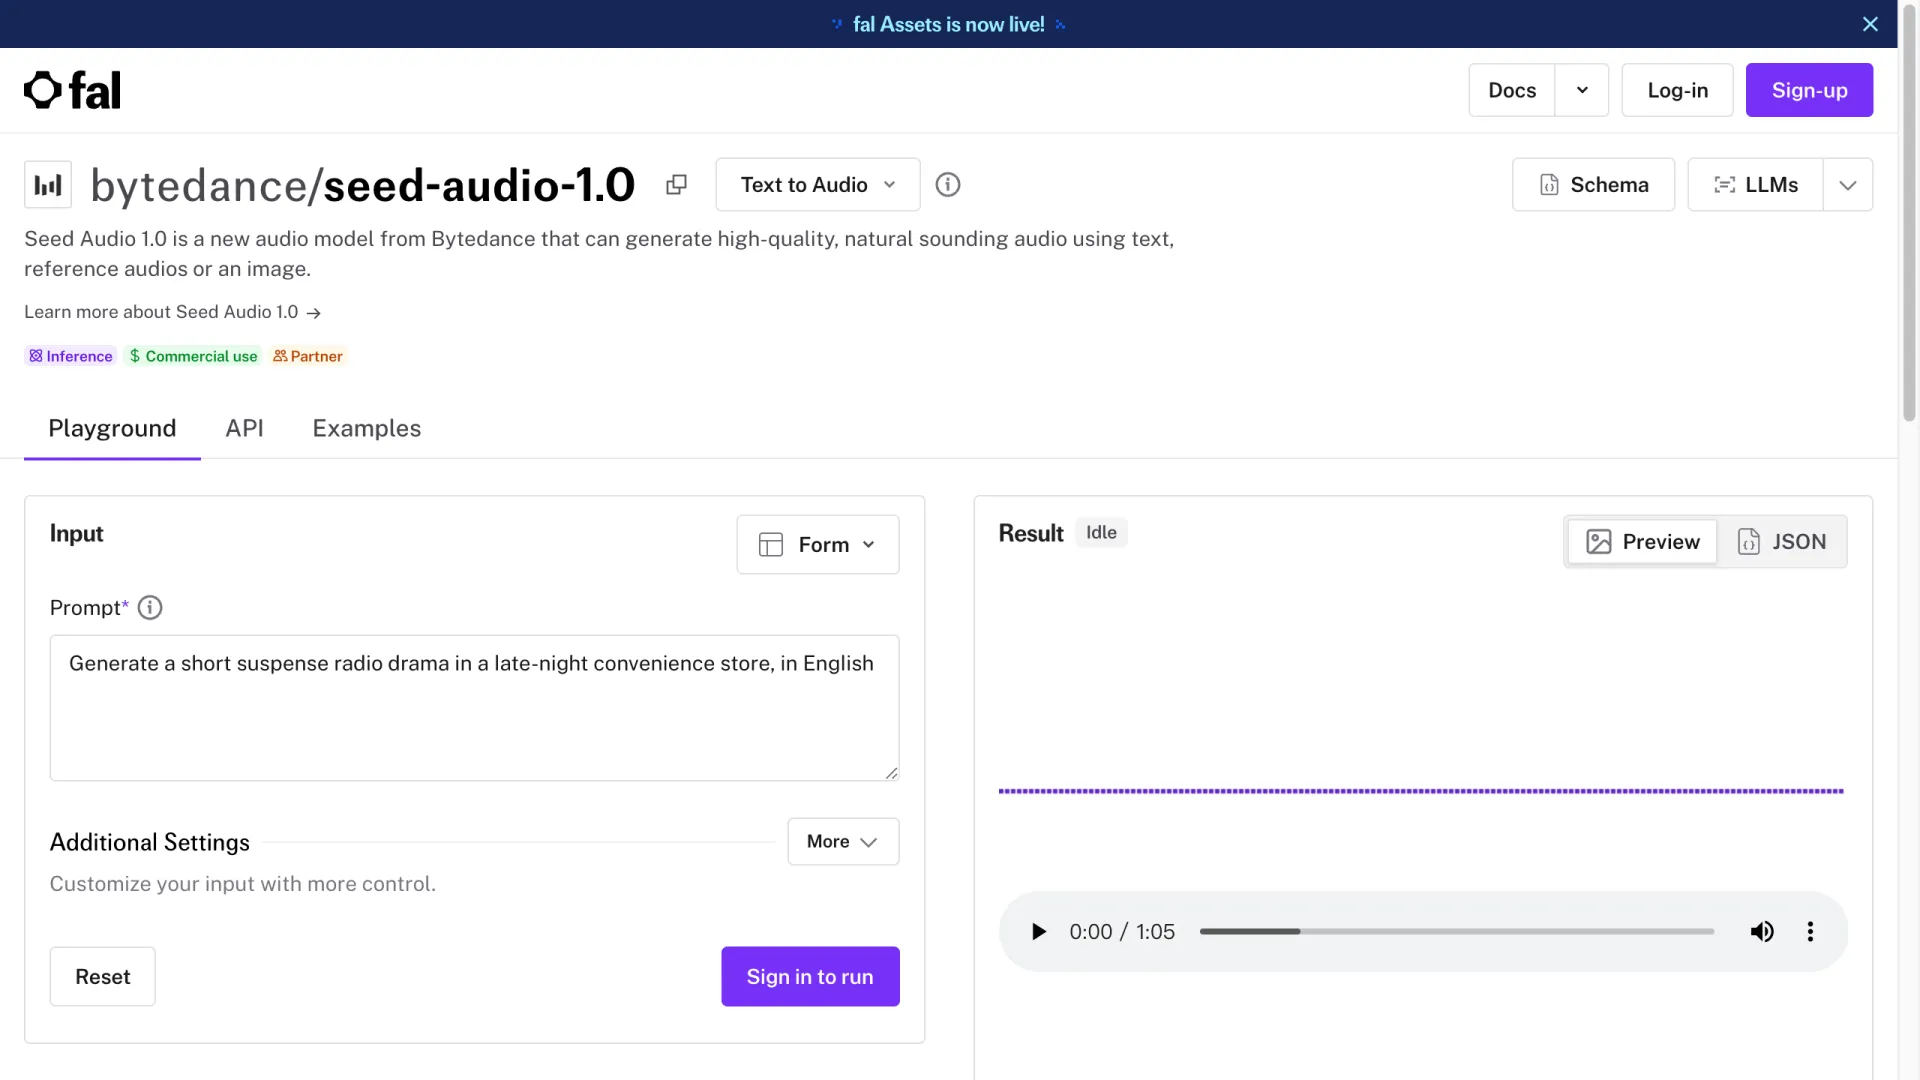
대부분의 오디오 도구는 TTS, 음악, 효과음 중 하나에 집중한다. Seed Audio 1.0의 정식 명칭은 Doubao-Seed-Audio 1.0이며, 이 세 요소를 하나의 타임라인에서 한 번에 생성한다. 예를 들어 "심야 편의점을 배경으로 한 긴장감 있는 라디오 드라마"라고 입력하면 대사, 현장 분위기음, 배경 음악이 이미 믹싱된 오디오를 돌려준다.
작동 방식은 세 가지다. 텍스트 설명만으로 장면을 만드는 Text-to-audio(T2A), 참조 클립과 텍스트를 함께 넣어 음성과 스타일을 유도하는 Text-and-audio-to-audio(TA2A), 그리고 깔끔한 내레이션이 필요할 때 쓰는 일반 TTS가 있다. 어떤 입력을 넣느냐에 따라 모드를 선택하면 된다.
한 가지는 분명히 해둘 필요가 있다. 이것이 음성 복제 도구인가? Seed Audio 1.0은 하나의 목소리로 여러 역할을 연기하게 하거나 참조 클립의 톤을 따라 하게 할 수 있다. 하지만 결과물은 특정 실존 인물의 정체성에 묶인 음성이 아니라 합성 음성이다. 이름을 지정한 인물을 동의 없이 복제하는 도구라기보다 제로샷 음성 스타일링으로 보는 편이 맞다. ByteDance의 기존 Seed-TTS 및 Seed-Music 연구를 기반으로 하기 때문에, 표현력 있는 음성과 음악 생성 역량이 하나의 모델에 함께 들어갔다.
도입 전 확인할 핵심 사양
무엇보다 사용 목적이 하드 리밋 안에 들어오는지부터 확인해야 한다. 아래는 fal과 EvoLink의 모델 목록을 교차 확인해 정리한 주요 수치다.
| 항목 | 사양 |
|---|---|
| 생성당 최대 출력 길이 | 120초(2분) |
| 텍스트 프롬프트 한도 | 약 1,500~2,000자(출처마다 다르므로 콘솔에서 확인 필요) |
| 참조 오디오 | 최대 3개 클립, 각 클립 ≤30초 |
| 지원 언어 | 영어 및 중국어만 |
| 출력 형식 | WAV, MP3, PCM, OGG Opus |
| 샘플레이트 | 48K / 24K / 16K / 8K |
| 제어 항목 | 속도, 피치, 볼륨(SSML 미지원) |
| 과금 방식 | 출력 길이 기준 |
가장 크게 체감되는 제약은 2분 제한이다. 팟캐스트 한 편이나 긴 내레이션을 만들려면 스크립트를 나누고 결과를 이어 붙여야 하며, 이 과정에서 구간마다 톤이 달라질 수 있다. fal의 모델 노트에는 단일 생성 길이를 약 10분까지 늘리고, 명시적인 길이 제어와 더 폭넓은 언어 지원을 더하는 업데이트가 계획돼 있다고 나온다. 장편 오디오가 주력 업무라면 이 업데이트를 기다릴 만하다.
가격: 아직 공개되지 않았다
공식 가격은 아직 없다. 2026년 7월 기준 Volcengine은 Seed Audio 1.0의 초당 요금을 공개하지 않았다. Volcano Ark에서 여전히 초대 전용으로 제공 중이며, 공식 요금은 보통 정식 출시 시점에 나온다. fal과 EvoLink 같은 게이트웨이도 고정 요금을 명시하지 않는다. 생성된 초 수에 요율을 곱하는 방식으로 청구하므로 재시도한 결과도 비용에 포함된다. 토큰 기준 가격 정보가 떠돌더라도 무시하는 것이 좋다. 길이 기준 오디오 모델에는 토큰 과금이 맞지 않는다.
지금 Seed Audio 1.0에 접근하는 방법
실제로 이용하는 경로는 두 가지이며, 경험 차이도 크다.
공식 경로는 Volcano Ark다. 이곳에서 Seed Audio 1.0은 초대 전용으로 제공된다. 접근 권한을 신청하고 승인을 기다린 뒤 ByteDance의 자체 콘솔을 이용하는 방식이다. 정식 출시와 가격이 발표된 뒤에는 이 경로가 기준이 될 것이다.
당장 쓸 수 있는 방법은 서드파티 게이트웨이다. fal은 bytedance/seed-audio-1.0 모델을 화이트리스트 없이 제공한다. 일반 키로 API 엔드포인트를 호출할 수 있고, EvoLink도 유사한 접근 방식을 제공한다. 현재 초대를 기다리지 않고 이 모델을 생성에 활용하는 사람 대부분은 이런 경로를 쓴다.
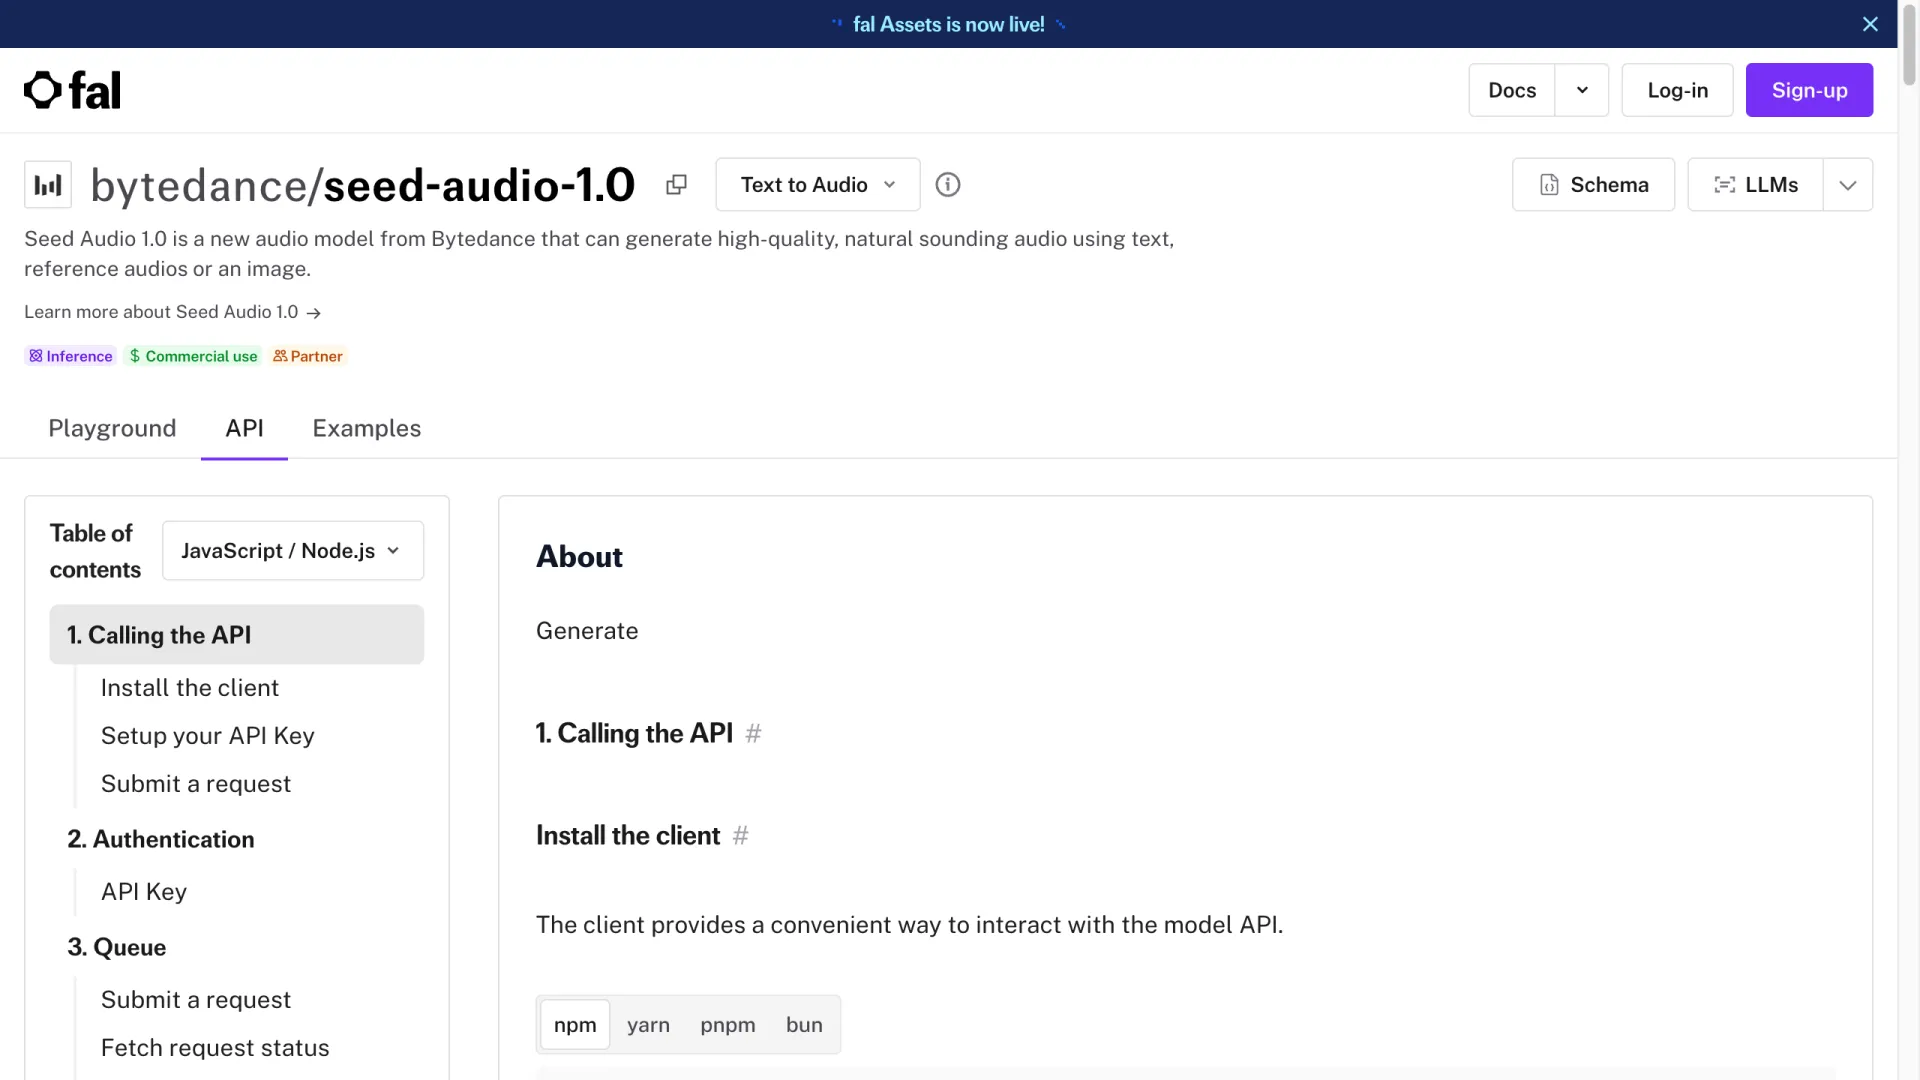
호출 패턴은 일반적인 큐 기반 API다. 클라이언트를 설치하고 키를 설정한 다음 프롬프트를 제출하고, 결과를 폴링하면 된다. 이전에 호스팅형 생성 모델을 연동해봤다면 새롭게 배울 내용은 거의 없다. 개발자 경험은 fal.ai 리뷰에서 더 자세히 다뤘다.
첫 테스트로는 대화, 현장음, 호흡을 동시에 확인할 수 있는 짧은 다화자 장면이 좋다. 가령 "심야 편의점을 배경으로 한 30초짜리 긴장감 있는 라디오 드라마, 영어"처럼 입력해볼 수 있다. 모델이 프롬프트를 해석하는 방식을 익히는 동안 실패 비용을 낮추려면 첫 클립은 30초 미만으로 유지하자.
Seed Audio 1.0 vs ElevenLabs, Stable Audio & AudioCraft
중요한 비교 기준은 클립 하나의 품질이 아니다. 각 도구가 어떤 작업을 위해 설계됐는지를 봐야 한다.
| 도구 | 핵심 강점 | 장면 믹싱 | 지원 언어 | 음성 제어 |
|---|---|---|---|---|
| Seed Audio 1.0 | 완성형 오디오 장면(음성 + 음악 + SFX) | 지원, 원패스 | 영어, 중국어 | 제로샷 스타일링 |
| ElevenLabs | 음성 및 음성 복제 | 음성만 | 30개 이상 | 가장 강력한 복제 기능 |
| Stable Audio | 음악 및 사운드 생성 | 단일 트랙 | 해당 없음(음악) | 프롬프트 기반 |
| AudioCraft | 오픈소스 음악/SFX | 단일 트랙 | 해당 없음(음악) | 프롬프트 기반 |
다양한 언어에서 최고 수준의 순수 음성 품질이나 정교한 음성 복제가 필요하다면 여전히 ElevenLabs가 낫다. 독립적인 음악 트랙이 목적이라면 Stable Audio나 Meta의 AudioCraft가 맞다. Seed Audio 1.0의 강점은 대화, 음악, 효과음을 일관된 하나의 편집 가능한 장면으로 결합한다는 데 있다. 여기 비교한 도구 중 이를 단 한 번의 호출로 해내는 제품은 없다.
강점과 아쉬운 점
강점: 다화자 대화와 음악·효과음의 원패스 믹싱이 핵심 매력이다. fal의 사용 가이드에 나온 클립 연장, 일부 구간 인페인팅, 여러 테이크 연결 같은 편집 워크플로도 지원해, 단발성 생성기를 넘어 실제 제작 도구로 활용할 수 있다.
한계: 2분 제한 때문에 긴 콘텐츠는 반드시 이어 붙여야 한다. 영어와 중국어만 지원하므로 글로벌 음성 작업의 대부분에는 맞지 않는다. 오프라인 생성 모델이므로 실시간 음성 에이전트 용도로도 적합하지 않다. 공식 접근 권한 역시 여전히 초대에 묶여 있다.
지금 써볼 가치가 있을까?
영어 또는 중국어 콘텐츠를 만들고, 더빙·오디오북 일부·숏폼 영상 사운드트랙·오디오 드라마 프로토타입처럼 짧은 형식이 중심이라면 게이트웨이를 통해 지금 Seed Audio 1.0을 써볼 만하다. 음성, 음악, 효과음을 직접 겹쳐 조합하던 작업을 장면 단위의 한 번 생성으로 줄일 수 있다.
실시간 상호작용, 미지원 언어, 길게 끊기지 않는 오디오가 필요하다면 기다리는 편이 낫다. 정식 출시와 예정된 길이 확장 업데이트가 나오면 판단 기준도 달라질 것이다. 그때까지 라이브 활용 사례에는 Qwen Audio 3 같은 실시간 모델이 더 적합하다. 그 외 사용자에게 지금은 기존 스택을 완전히 교체할 때가 아니라, 게이트웨이에서 테스트하면서 현행 도구를 유지할 때다.
FAQ
Seed Audio 1.0은 무료인가?
아니다. 공식 무료 티어는 없으며, Volcano Ark API는 초대 전용이다. 접근 권한을 얻으면 출력 길이 기준으로 과금된다. 서드파티 게이트웨이는 자체 계량 요금을 청구한다.
Seed Audio 1.0으로 내 목소리를 복제할 수 있나?
참조 클립의 스타일을 따라 하거나 여러 역할의 목소리를 생성할 수는 있다. 하지만 특정 실존 인물에 고정된 복제 음성이 아니라 합성 음성을 만든다. 신원을 그대로 복제하는 도구처럼 생각해서는 안 된다.
Seed Audio 1.0은 어떤 언어를 지원하나?
출시 시점 기준으로 영어와 중국어만 지원한다. fal의 모델 노트에 따르면 예정된 업데이트 로드맵에는 더 폭넓은 다국어 지원이 포함돼 있다.
생성 가능한 오디오 길이는 얼마인가?
현재 생성 1회당 최대 120초다. 예정된 업데이트에서는 명시적인 길이 제어와 함께 단일 생성 길이가 약 10분까지 늘어날 예정이다.
공식 Seed Audio 1.0 API가 있나?
있다. Volcengine의 Volcano Ark에서 제공하지만 현재는 초대 전용이다. 화이트리스트 없이 공개 접근이 필요하다면 bytedance/seed-audio-1.0을 호스팅하는 fal 같은 게이트웨이를 이용하면 된다.
Seed Audio와 Seed Music의 차이는 무엇인가?
Seed-Music은 ByteDance가 이전에 연구한 음악 중심 모델이다. Seed Audio 1.0은 이 음악 생성 역량에 음성과 효과음을 결합해 하나의 장면 생성 모델로 확장했다.