 AIREITER
OpenRouter 대시보드 출시 당시 공개된 플랫폼 전체 캐시 히트율은 82.8%였습니다(@OpenRouter). 하지만 실제 사용자 경험은 사뭇 다릅니다. 커뮤니티에는 1% 미만의 히트율(@miolini)과 예상보다 10~32배 높은 청구액(r/openrouter)이 잇따라 올라옵니다. OpenRouter의 프롬프트 캐싱은 분명 입력 비용을 낮춰주지만, 먼저 네 가지 대표적인 실패 지점을 해결해야 합니다. 그중 가장 큰 변수는 연속 요청을 하나의 캐시가 워밍업된 공급자에 계속 보내는 일입니다. 단, 아무리 설정을 바꿔도 공급자가 요구하는 최소 토큰 수에 못 미치는 프롬프트는 캐시되지 않습니다.
OpenRouter에서 프롬프트 캐시 히트란 무엇인가
프롬프트 캐싱은 공급자가 이미 처리한 안정적인 프롬프트 앞부분을 재사용하는 기능입니다. 같은 입력 토큰을 다시 보낼 때 정가 대신 할인된 비용으로 처리할 수 있습니다. 다만 캐시는 최초 요청을 처리한 특정 공급자 엔드포인트에만 존재합니다. 프롬프트 구조만큼 라우팅 방식이 중요한 이유입니다. 이는 라우팅이 시작되기도 전에 완전히 동일한 요청을 무료로 재생하는 응답 캐싱과는 별개의 계층입니다.
| 프롬프트 캐싱 | 응답 캐싱 | |
|---|---|---|
| 재사용 대상 | 모든 요청의 안정적인 접두부 | 바이트 단위로 동일한 요청(정규화된 본문의 SHA-256) |
| 활성화 방법 | 대부분 자동 적용, Anthropic·Qwen·Gemini는 cache_control 사용 | X-OpenRouter-Cache: true 헤더 또는 프리셋 |
| 비용 | 캐시 토큰은 입력 비용의 0.1~0.5배 | 히트는 무료, 미스는 일반 요금 청구 |
| 유지 시간 | 일반적으로 3~5분, Anthropic은 최대 1시간 | 기본 300초, 1~86,400초 범위 |
| 미스 원인 | 접두부 변경, 공급자 전환, 최소 토큰 미달 | JSON 변경, API 키 교체, 계정 ZDR |
응답 캐싱은 재시도, 단위 테스트, 에이전트 워크플로의 동일 호출 반복에 특히 유용합니다. JSON 속성 순서도 캐시 키에 포함되므로, 의미 없는 직렬화 변경만으로도 미스가 발생합니다. 공급자 측 동작 방식은 OpenRouter의 프롬프트 캐싱 가이드가 기준 문서입니다.
공급자별 OpenRouter 프롬프트 캐싱 비용
캐시 읽기는 어느 공급자에서나 일반 입력보다 훨씬 저렴합니다. 하지만 캐시를 처음 만드는 쓰기에는 할증이 붙을 수 있습니다. Anthropic은 기본 5분 TTL에서 일반 입력의 1.25배, 1시간 옵션에서는 2배를 받습니다. 따라서 동일한 접두부를 충분히 많이 다시 읽어야 쓰기 비용을 상쇄할 수 있습니다. 한 번만 요청한다면 캐싱이 오히려 더 비쌀 수 있습니다. OpenRouter가 제시한 계산 예시에 따르면 Claude Sonnet 4.6의 캐시 입력은 $0.30/M이며, 새 입력의 $3.00/M과 비교됩니다.
같은 출처에서 정리한 공급자별 캐시 쓰기·읽기 배수는 다음과 같습니다.
| 공급자 | 캐시 쓰기 | 캐시 읽기 | 비고 |
|---|---|---|---|
| Anthropic | 1.25배(5분) / 2배(1시간) | 0.1배 | 브레이크포인트별 TTL 선택 가능 |
| OpenAI, GPT-5.6 이전 | 무료 | 0.25~0.5배 | 1,024토큰부터 자동 적용 |
| OpenAI GPT-5.6+ | 1.25배 | 0.25~0.5배 | 명시적 브레이크포인트 지원 |
| Google Gemini | 무료 | 0.25배 | 2.5+에서 암묵적 적용, TTL 약 3~5분 |
| Grok | 무료 | 0.25배 | 자동 적용 |
| Moonshot | 무료 | 0.25배 | 자동 적용 |
| Groq | 무료 | 0.5배 | Kimi K2 모델만 해당 |
| DeepSeek | 1.0배 | 0.1배 | 쓰기는 일반 입력과 동일하게 과금 |
| Alibaba Qwen | 1.25배 | 0.1배 | 명시적 cache_control 필요 |
| Z.AI | 무료 | 약 0.2배 | 캐시 저장은 기간 한정 무료로 표기 |
OpenRouter의 튜토리얼은 10,000개의 반복 토큰을 여섯 턴에 걸쳐 사용하는 경우를 계산합니다. 캐싱하지 않으면 단일 턴 비용의 6.0배, Anthropic의 5분 캐시와 스티키 라우팅을 적용하면 1.75배, 쓰기 무료·읽기 0.25배 공급자라면 2.25배입니다. 이 계산에는 늘어나는 메시지와 출력 토큰이 포함되지 않습니다.
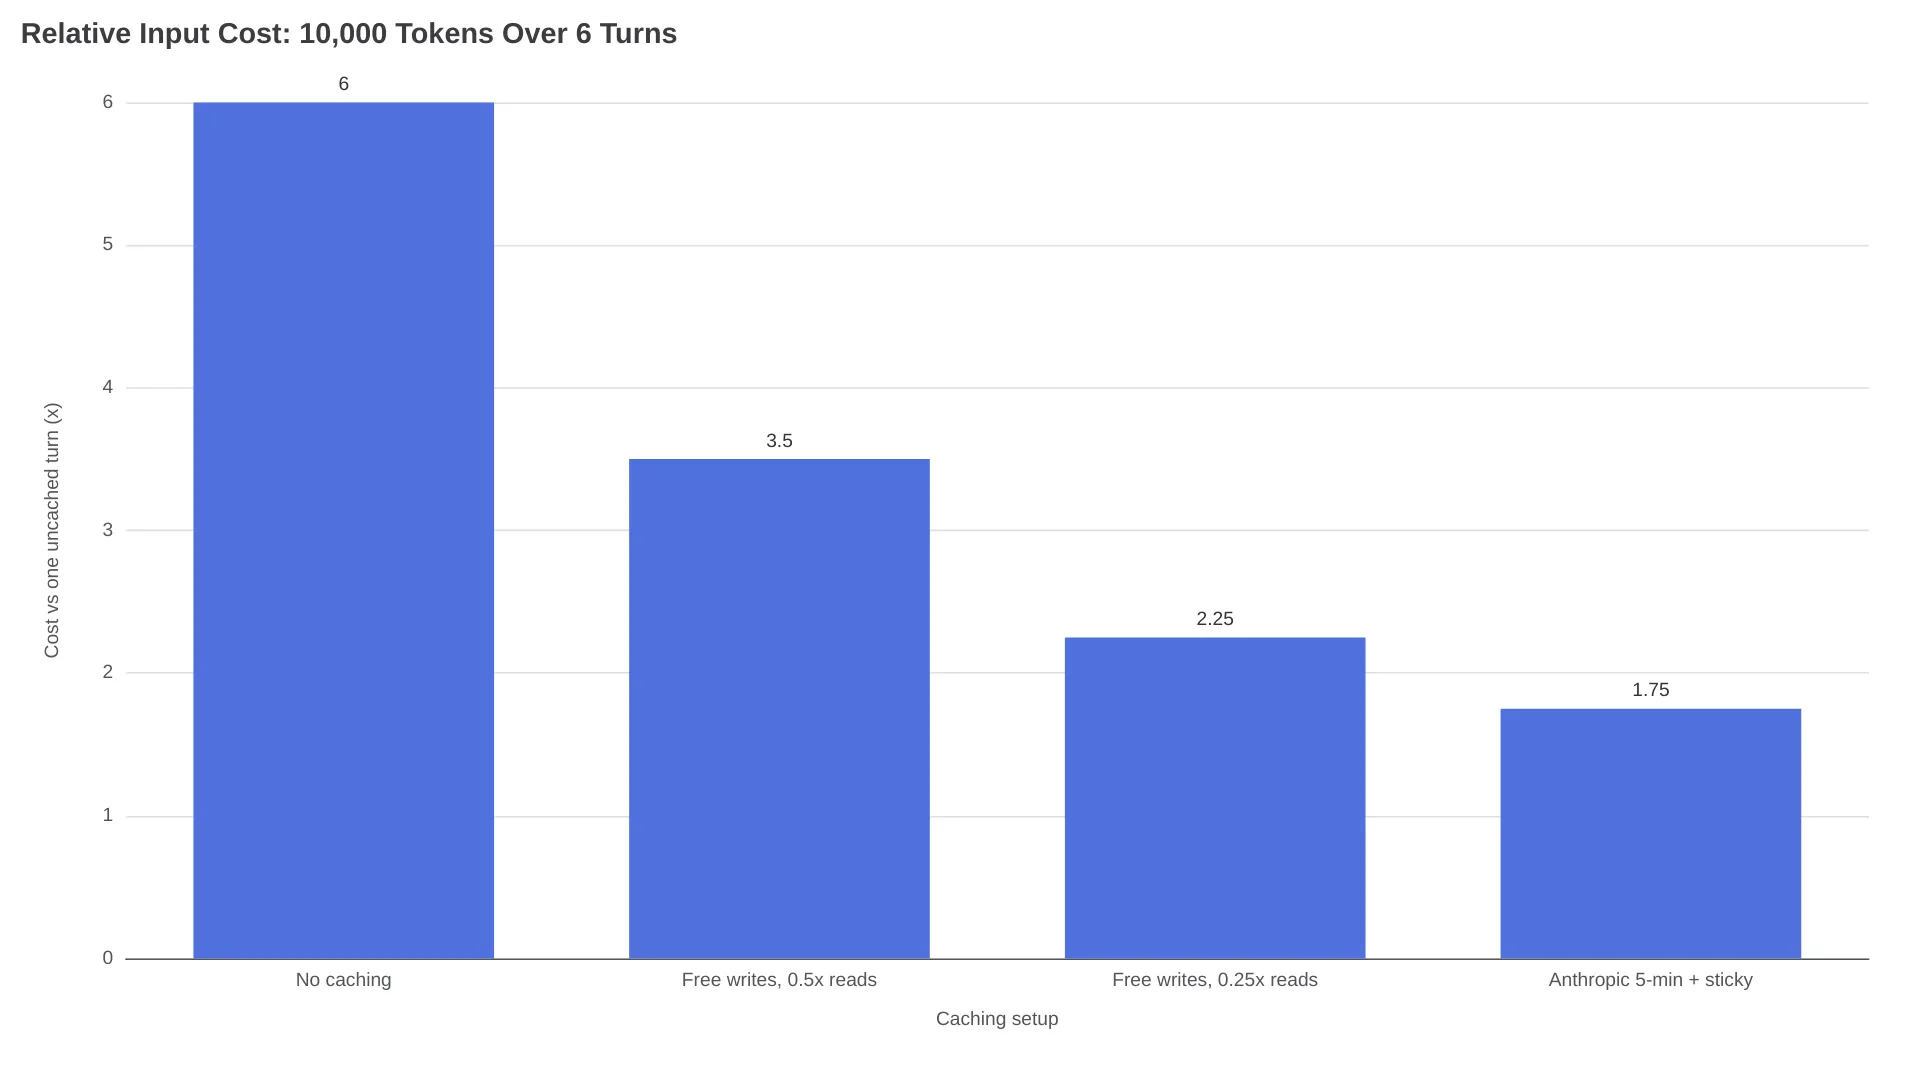
Anthropic은 쓰기 비용이 비싸도 두 번째 턴부터 0.1배 읽기 비용이 크게 작용하므로 여섯 턴 기준으로 유리합니다. 턴 사이에 5분 TTL이 만료될 때만 상황이 뒤집힙니다. 요청마다 1.25배 쓰기 비용을 다시 내면 여섯 턴에 7.5배가 되어 캐싱하지 않는 것보다 비싸집니다. 반면 쓰기 무료 공급자는 입력 비용 1.0배로 여섯 턴을 처리해도 캐싱하지 않은 6.0배와 같을 뿐입니다.
디버깅 전 확인할 세 가지 수치
OpenRouter 응답의 usage 객체에는 판정에 필요한 값이 들어 있습니다. cached_tokens, cache_write_tokens, cache_discount이며, 각 필드의 의미는 OpenRouter의 캐싱 가이드에 정리돼 있습니다. 무엇을 바꾸기 전에 이 세 값을 읽어보면 실제 캐시 미스와 예상과 다른 과금 문제를 구분할 수 있습니다. cached_tokens가 0보다 크면 워밍업된 캐시를 사용한 것이고, 0이면 Activity 대시보드가 어떻게 보이든 캐시 히트가 아닙니다.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
이 응답의 히트율은 99.8%입니다. 프롬프트 토큰 10,339개 중 10,318개가 캐시에서 왔습니다. cache_write_tokens는 최초로 캐시를 생성하는 요청에서 나타납니다. cache_discount는 절감액을 보여주며 Anthropic 쓰기에서는 음수가 될 수도 있습니다. 1.25배의 쓰기 할증은 실제 비용이고, 이후 읽기에서 이를 회수하기 때문입니다. 이 수치는 Activity의 generation 상세 화면이나 /api/v1/generation에서도 확인할 수 있습니다. Activity 화면에서의 위치는 Activity 대시보드 가이드에서 다룹니다.
UI가 아니라 원시 메타데이터가 기준입니다. 한 SillyTavern 사용자는 로그를 직접 확인하고서야 존재하지 않는 캐시 문제를 추적하고 있었다는 사실을 알았습니다.
"원시 openrouter 메타데이터에
native_tokens_cached: 0[그리고]usage_cache: null이라고 명확히 나옵니다." — u/HauntingWeakness
세 수치가 매일 0으로 나온다면, 아래 네 가지 실패 원인 중 하나가 캐시를 잡아먹고 있는 것입니다.
워밍업된 캐시가 식는 네 가지 이유
OpenRouter 문서와 커뮤니티 사례는 히트율 급락의 원인을 네 가지로 모읍니다. 최소 토큰 수 미달, 턴 사이 TTL 만료, 접두부 변경, 공급자 이동입니다. 로그에서 보이는 징후도, 해결 방법도 각각 다릅니다.
1. 프롬프트가 공급자의 최소 토큰 수보다 짧다
프롬프트 캐싱을 지원하는 공급자는 모델별 최소 토큰 수를 강제합니다. 900토큰짜리 시스템 프롬프트는 어떤 Claude 모델에서도 캐시되지 않습니다. 이를 넘기려고 의미 없는 텍스트를 덧붙이는 방법도 명시적으로 권장되지 않습니다. OpenRouter 튜토리얼 역시 "억지로 캐싱시키기 위해 요청에 채우기 텍스트를 넣지 말라"고 말합니다. 모델 카탈로그 전반에서 최소치 차이는 최대 네 배에 이릅니다.
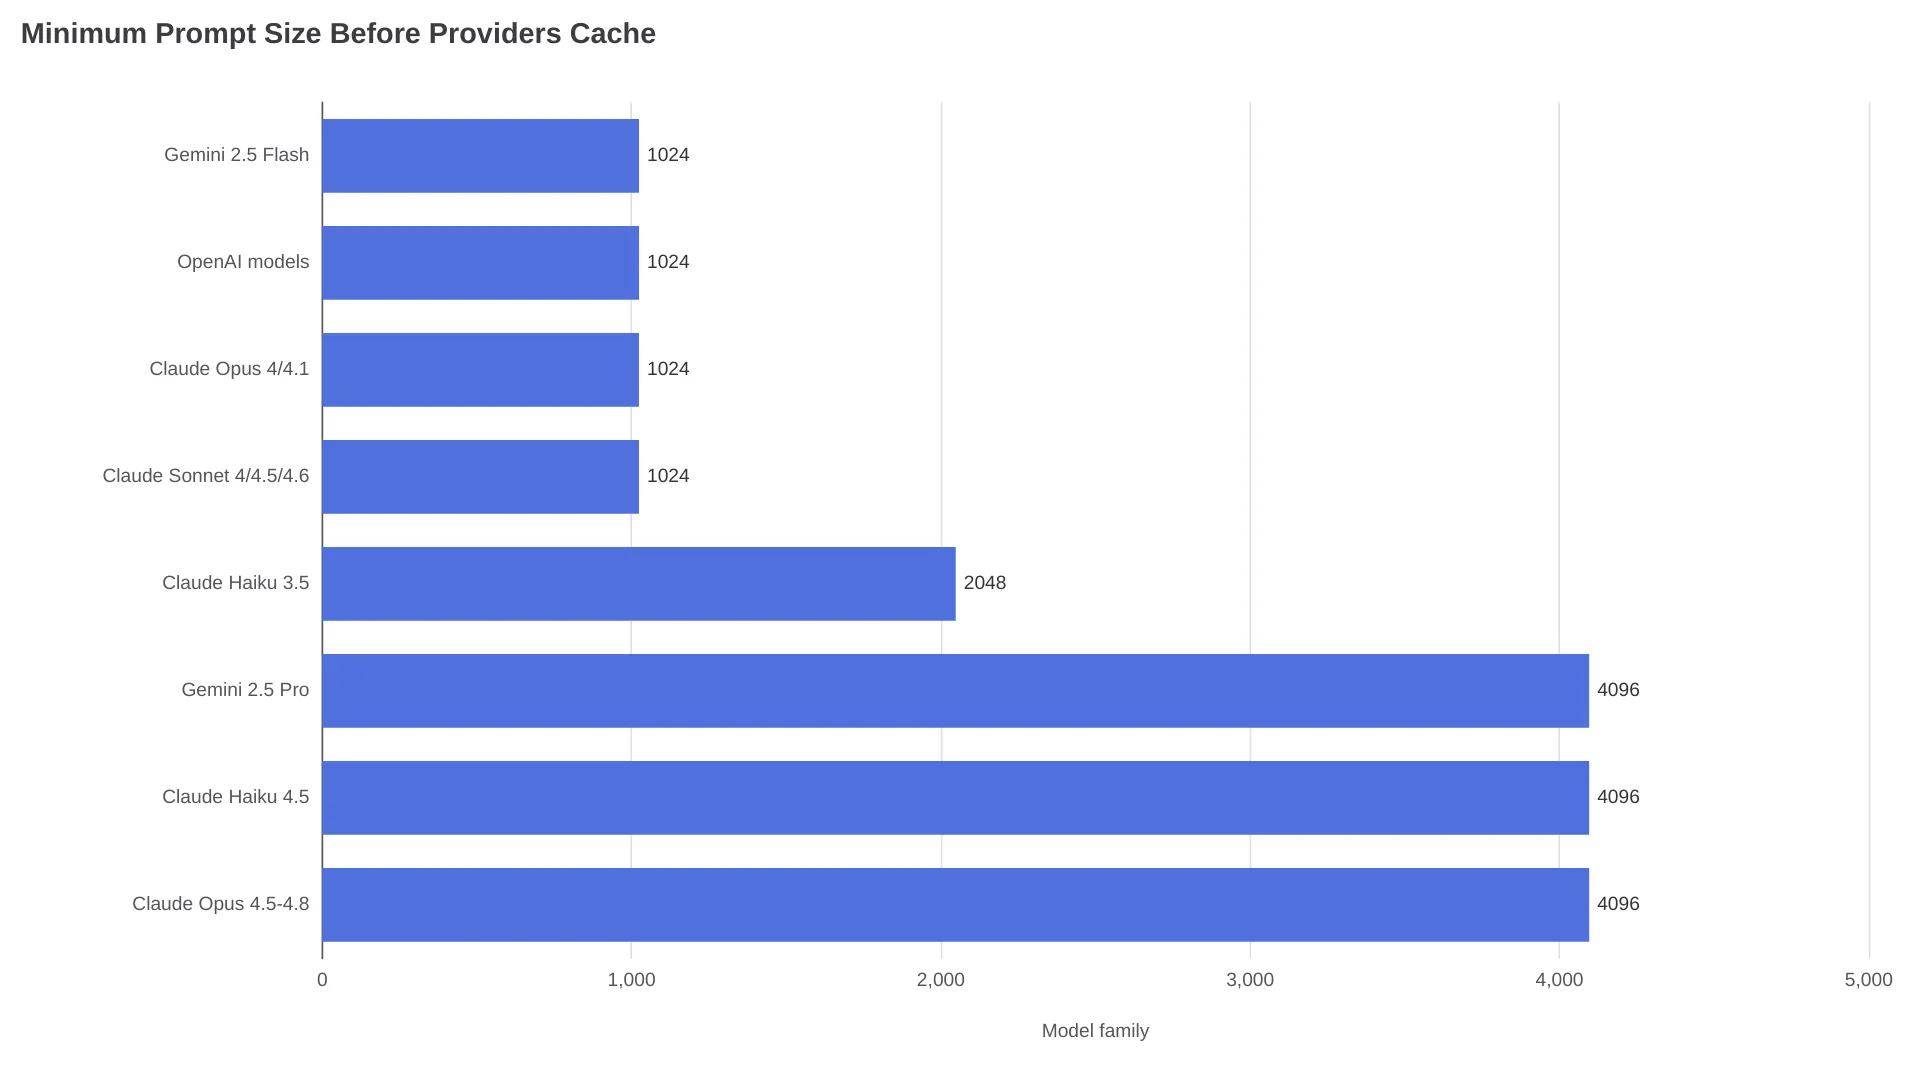
OpenRouter의 공급자 참고 사항에 따르면 Claude Opus 4.5~4.8과 Haiku 4.5는 최소 4,096토큰이 필요합니다. Sonnet 4/4.5/4.6과 Opus 4/4.1은 1,024토큰부터 가능하며, Gemini 2.5 Pro는 4,096토큰, Gemini 2.5 Flash는 1,024토큰부터입니다. OpenAI 모델도 1,024토큰부터 캐싱합니다. 짧은 프롬프트를 Opus 4.8에 보내는 워크로드는 구조적으로 캐시할 수 없습니다. 도구 스키마, 참조 문서, few-shot 예시 같은 정적 자료를 하나의 접두부로 모으거나 최소치가 낮은 모델로 옮겨야 합니다.
2. 다음 턴이 오기 전에 캐시가 만료됐다
Anthropic의 기본 캐시는 5분간 유지되며, 1시간 TTL은 쓰기 비용이 2배입니다. Gemini의 암묵적 캐시는 약 3~5분 유지됩니다. 특히 읽기 요청을 해도 타이머가 초기화되지 않는다는 점이 중요합니다(OpenRouter 튜토리얼). 같은 공급자에 머물게 하는 스티키 세션도 10분간 활동이 없으면 종료됩니다. 호출 사이에 5~6분을 생각하는 에이전트 루프라면 이 모든 시간을 넘기게 됩니다.
"OpenRouter는 모델 테스트에는 훌륭합니다. 하지만 프로덕션 에이전트에는 조용히 끔찍합니다. 불편한 진실은 실제 워크로드에서 캐싱이 사실상 0이라는 점입니다." — @ran_cohenn, 5~6분 간격의 에이전트 요청이 스티키 선호도를 만료시키고 완전한 캐시 미스와 비싼 캐시 쓰기로 이어지는 상황을 설명하며
세션이 1시간 안에 이어진다면, Anthropic의 1시간 TTL과 2배 쓰기는 5분마다 1.25배를 다시 내는 것보다 낫습니다. 그러나 사용자 요청 간격이 20분이라면 제공되는 TTL 중 어느 것도 버티지 못합니다. 이 경우 캐싱은 짧게 이어지는 턴 묶음 안에서만 효과가 있습니다.
3. 프롬프트 접두부가 바뀌었다
OpenRouter는 첫 번째 시스템 메시지와 첫 번째 비시스템 메시지를 해싱해 기본 대화 키를 만듭니다. 프롬프트 시작 부분이 바뀌면 그 지점부터 캐시는 무효가 됩니다. 흔한 원인은 시스템 프롬프트 위에 삽입되는 RAG 컨텍스트, 첫 메시지에 들어가는 타임스탬프나 요청 ID, 호출마다 다시 작성되는 도구 정의, 대화 이력 중간에 메시지를 삽입하는 프론트엔드 채팅 앱입니다.
"프롬프트 시작 부분의 내용이 계속 바뀌면 캐시 미스율이 올라갑니다." — u/Exact_Law_6489
변화의 원인이 직접 작성하지 않은 도구일 때도 있습니다. u/askchris는 "Claude Code가 캐시 히트 문제를 일으킨다는 것을 알았다. 도구를 주입하는 방식 때문인 듯하다"고 말합니다. Gemini에는 추가로 주의할 점이 두 가지 있습니다. OpenRouter는 전송한 cache_control 브레이크포인트 중 마지막 하나만 사용합니다. 또한 시스템 지침은 변경 불가능한 캐시 콘텐츠로 처리되므로, 동적 자료는 시스템 프롬프트 뒤에 덧붙이지 말고 이후 사용자 메시지로 옮겨야 합니다. 해결 원칙은 같습니다. 정적인 시스템 프롬프트, 도구 스키마, 참조 문서를 먼저 두고, 요청마다 달라지는 내용은 마지막에 배치해야 합니다.
4. 요청이 캐시 없는 공급자로 갔다
OpenRouter는 70개가 넘는 공급자에 요청을 라우팅하며(자체 튜토리얼 기준), 프롬프트 캐시는 이를 작성한 엔드포인트에만 있습니다. 스티키 라우팅은 후속 요청을 캐시가 있는 공급자로 되돌립니다. 단, 해당 공급자의 캐시 읽기 비용이 일반 입력보다 저렴한 경우에만 적용됩니다. 수동 provider.order 설정은 스티키 동작을 완전히 덮어씁니다. 공급자 오류가 발생해도 핀이 풀립니다.
이 문제에 관한 커뮤니티 데이터는 뚜렷합니다.
- @bruceforai는 동일한 모델 이름을 여러 공급자에서 측정해 캐시 히트율이 95.3%부터 0%까지 나타났다고 밝혔습니다. 일부 서드파티의 캐시 가격은 공식 가격보다 10배 높았습니다.
- @Bryan_1269는 OpenRouter를 통한 GLM 5.2에서 매우 낮은 히트율을 경험했지만, Fireworks에 같은 프롬프트를 직접 보냈을 때는 85% 이상을 기록했습니다.
- @miolini는 OpenRouter 라우팅에 대해 "캐시 히트율이 정말 나쁘다. 1% 미만 수준"이라고 말했습니다.
OpenRouter의 공식 입장은 핀이 유지된다는 것입니다. "모델 또는 공급자에서 캐시가 되면 캐시가 만료될 때까지 해당 대상에 고정됩니다"(@OpenRouter). 이는 문서 내용과도 일치합니다. 따라서 관리해야 할 대상은 핀 동작 자체라기보다 공급자별 편차입니다.
cache_control은 어디에 넣고, 무엇이 이를 제거하는가
OpenRouter에서 Anthropic 모델은 두 방식으로 캐시를 사용합니다. 첫째는 대화가 길어질수록 자동으로 진행되는 최상위 cache_control 객체로, OpenRouter가 멀티턴 채팅에 권장하는 방식입니다. 둘째는 개별 콘텐츠 블록에 최대 네 개까지 두는 명시적 브레이크포인트입니다. 도구 스키마, RAG 문서, CSV 덤프, 캐릭터 카드처럼 크고 고정된 자료에 적합합니다. 최상위 방식은 Anthropic 네이티브, Vertex, Azure, Bedrock에서 모두 동작합니다. Bedrock API는 최상위 필드를 받지 않으므로 OpenRouter가 이를 끝부분 브레이크포인트로 변환합니다. 명시적 TTL을 설정하려면 Responses가 아니라 Chat Completions 또는 Anthropic Messages API를 사용해야 합니다.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens of tool schemas and reference docs>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI의 방식은 다릅니다. 1,024토큰부터 캐싱이 자동 적용되며, 명시적 prompt_cache_breakpoint 마커는 GPT-5.6 이상에서만 사용할 수 있습니다. input_text 또는 text 블록에 설정하며, TTL을 요청할 때 최소값은 30분입니다.
공급자 참고 사항에 따르면 OpenRouter는 각 방언을 서로 변환합니다. Anthropic cache_control 마커는 OpenAI 브레이크포인트가 되고, OpenAI 브레이크포인트는 기본 5분 Anthropic 마커가 됩니다. 단, TTL 값은 변환되지 않습니다. Qwen은 명시적 cache_control 마커가 필요하고 캐시는 5분간 유지됩니다. 지원 대상도 일부 모델로 제한됩니다. qwen3-max, qwen-plus, qwen3-coder-plus 등이 해당하며, qwen3.5-plus-02-15 같은 스냅샷은 제외됩니다.
눈에 덜 띄는 실패 원인도 있습니다. 앱과 OpenRouter 사이에 있는 일부 클라이언트와 게이트웨이가 전달 전 비표준 필드를 제거할 수 있습니다.
"게이트웨이 뒤에서 anthropic 프롬프트 캐싱이 0으로 떨어지는 문제는 대개 마샬링 버그입니다. ... openrouter로 포워딩되기 전에 cache_control 마커가 조용히 제거되는 것이죠. 스키마 확장을 버리는 방식으로는 공급자를 추상화할 수 없습니다." — @SiddharthInk_
마커가 실제로 도착하는지 확인해야 합니다. Activity의 generation 상세 화면에서 원시 요청 메타데이터를 확인하거나, 중간에 아무것도 끼지 않는 curl 테스트 요청을 한 번 보내보세요. 메시지를 하나의 텍스트 덩어리로 평탄화하는 도구는 브레이크포인트를 아무리 정확히 배치해도 무력화합니다. OpenRouter의 examples repo에는 마커를 보존하는 실행 가능한 TypeScript, Vercel AI SDK, Effect 예제가 있습니다.
공급자 고정하기: session_id와 provider order
안정적인 세션 식별자는 라우팅에 가장 강력하게 작용합니다. session_id를 사용하면 첫 번째 성공한 요청을 처리한 공급자에 후속 요청이 고정됩니다. 아직 캐시 히트가 발생하지 않았어도 적용됩니다. 이를 사용하지 않으면 첫 캐시 히트가 감지된 뒤에야 스티키 동작이 시작됩니다. 기본 식별자는 첫 시스템 메시지와 첫 비시스템 메시지의 해시이므로, 접두부가 조금만 바뀌어도 조용히 달라집니다. 이는 실패 원인 3과 직결됩니다(OpenRouter의 라우팅 문서).
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
알아둘 동작은 다음과 같습니다. session_id는 요청 본문 또는 x-session-id 헤더에 넣습니다. 둘 다 설정했다면 본문 값이 우선합니다. 최대 길이는 256자이며, 둘 다 없으면 OpenRouter는 OpenAI 스타일의 prompt_cache_key로 대체합니다.
문서에는 두 가지 주의점도 나옵니다. 공급자 오류가 발생하면 핀이 풀립니다. 또한 Batch API의 각 라인은 동시에, 순서 없이 실행되므로 한 라인의 캐시 쓰기가 다음 라인에서 보이지 않습니다. 배치 간에 "ttl": "1h" 접두부를 공유하거나, 먼저 동기 요청 하나로 캐시를 워밍업해야 합니다. Auto Router가 결정된 모델을 최선의 노력으로 재사용하는 방식은 auto router 가이드에서 다룹니다.
핀만으로 부족하다면 공급자 집합 자체를 제한할 수 있습니다.
"제가 찾은 해결책은 선호도 순서대로 사용할 공급자 목록을 설정하는 것입니다." — u/nabil9506
캐시 읽기 비용이 저렴한 공급자 두세 곳으로 provider.order 목록을 구성하면, 폭넓은 페일오버 대신 캐시 지역성을 얻을 수 있습니다. 에이전트 워크로드에는 합리적인 선택입니다. u/welcome_to_milliways는 이 수동 설정 부담을 "OR의 꽤 근본적인 결함"이라고 평가합니다. 동의 여부와 별개로, 현재의 동작 계약은 그렇습니다.
라우터를 거친 캐싱이 이득이 아닌 경우
OpenRouter를 통한 프롬프트 캐싱은 세 가지 상황에서 수지가 맞지 않습니다. 프롬프트가 모델의 최소 토큰 수에 도달하지 못할 때, 세션 간격이 제공되는 모든 TTL보다 길 때, 쓰기 할증을 할인 읽기로 회수할 수 없는 일회성 요청일 때입니다. 네 번째 경우도 있습니다. 수정할 수 없는 도구가 cache_control을 라우터에 도달하기 전에 제거하는 경우입니다. @grapeot가 지적하듯 게이트웨이 계층에서 캐싱이 실패하면 비용 차이는 한 자릿수 배수가 아니라 10배 수준이 되며, 라우팅 수수료 자체보다 훨씬 큰 문제가 됩니다.
캐시가 중요한 워크로드에서 위 해결책을 적용할 수 없다면 라우터보다 하나의 고정 업스트림이 낫습니다. 캐시 동작이 결정적이며 핀을 관리할 필요가 없습니다. 공급자 이동을 해결할 수 없다면 Anthropic 자체 캐싱을 사용하는 direct Claude API endpoint가 가장 단순한 우회로입니다.
계정 수준의 Zero Data Retention은 응답 캐싱을 완전히 비활성화합니다. ZDR 환경에서 프롬프트 캐싱이 가능한지와 관련해서는, 암묵적 캐싱이 데이터 보존에 해당하는지 분석한 OpenRouter의 자료를 확인하는 것이 기준입니다.
가장 효율적인 해결 순서
대부분의 절감 효과는 측정 순서대로 디버깅하면 불필요한 변경 없이 되찾을 수 있습니다. 먼저 검증하고, 프롬프트부터 라우팅, TTL 순으로 내려가세요.
| # | 조치 | 확인되는 문제 |
|---|---|---|
| 1 | 실제 요청 몇 건에서 cached_tokens와 cache_discount 확인 | 히트율 문제인지, 과금 기대치 문제인지 구분 |
| 2 | 프롬프트 크기를 모델의 최소 토큰 수와 비교 | 다른 작업 전에 '애초에 캐시 불가' 상태를 제외 |
| 3 | 접두부 고정: 정적 시스템 프롬프트·스키마·문서를 앞에, 타임스탬프와 RAG를 뒤에 배치 | 눈에 띄지 않는 무효화 원인 제거 |
| 4 | 대화의 모든 요청에 session_id 전달 | 첫 히트 이후가 아니라 첫 턴부터 공급자 고정 |
| 5 | provider.order를 캐시 읽기가 저렴한 공급자 두세 곳으로 설정 | 공급자 간 이동으로 인한 편차 제거 |
| 6 | "ttl": "1h"(Anthropic)를 추가하거나 긴 세션에는 쓰기 무료 공급자로 전환 | 턴 사이 캐시 만료 대응 |
1~3단계는 코드에서 제어할 수 있는 실패 유형을 제거합니다. 4~6단계는 1% 미만이라는 사용자 보고와 82.8%라는 헤드라인 사이의 간극을 다룹니다. 함께 읽을 자료로는 캐시 토큰이 청구서에 반영되는 방식을 다룬 OpenRouter 가격 가이드, 모델 고정 동작을 설명한 auto router 가이드, 시간에 따른 히트율 모니터링 방법을 정리한 activity dashboard 가이드가 있습니다.