 AIREITER
Muse Spark 1.3은 현재 OpenRouter에서 입력 토큰 100만 개당 $1.25, 출력 토큰 100만 개당 $4.25로 표시돼 있습니다. 하지만 실제 구매 판단은 가격표만으로 끝나지 않습니다. 긴 컨텍스트를 다루는 코딩과 에이전트 작업에는 특히 유망하지만, 출시 초기인 데다 출시 시점에는 max reasoning이 제공되지 않았고 첫 토큰이 나오기까지 오래 걸릴 수 있습니다.
Muse Spark 1.3이란 무엇이며, ‘사용 가능’하다는 말의 의미
Muse Spark 1.3은 Meta가 장시간 실행되는 에이전트 작업과 코딩, 멀티모달 작업을 겨냥해 만든 독점 추론 모델입니다. Meta는 2026년 9월 2일 Muse Code와 Meta Model API를 통해 순차적으로 제공한다고 발표했습니다. 기존 추론 모드는 먼저 제공되고, max reasoning은 추가 안전성 테스트가 끝난 뒤 지원될 예정이었습니다. (Meta AI Research 발표문)
출시 그래픽에는 max 결과가 포함돼 있지만 max reasoning에는 추가 안전성 테스트가 필요했습니다. 따라서 첫날부터 해당 결과를 그대로 재현할 수 있다고 가정해서는 안 됩니다.
Meta는 Muse Spark 1.3이 긴 작업에서 제약 조건을 더 잘 유지하고, 하나의 스레드 안에서 중단을 처리하며, 필요한 경우 명확화 질문을 던지고, 중요한 작업을 실행하기 전 확인을 요청한다고 설명합니다. 막힌 상황을 인지하고 이를 알리는 능력도 개선됐다고 주장합니다. 또한 내부 코딩 비교에서 Muse Spark 1.2보다 도구 호출은 약 20%, 토큰 사용량은 25% 적었다고 밝혔습니다. 다만 이는 재현 가능한 작업 세트나 오차 범위가 공개되지 않은 공급자 측 수치입니다.
출시 게시물은 오픈 웨이트를 향후 로드맵으로 설명합니다. 여기서 확인한 자료에는 Muse Spark 1.3이 호스팅/API 전용 모델로만 등록돼 있으며, 다운로드 가능한 체크포인트나 확정된 라이선스, 파라미터 수, 하드웨어 요구 사항은 문서화돼 있지 않습니다.
API 가격표는 단순하지만, 실제 비용 계산은 그렇지 않다
공개적으로 확인할 수 있는 가장 명확한 요금표는 Meta의 출시 게시물이 아니라 OpenRouter의 Muse Spark 1.3 페이지입니다. OpenRouter는 입력과 출력에 각각 토큰 100만 개당 $1.25와 $4.25를 부과하며, 캐시 읽기와 웹 검색에는 별도 요금이 붙는다고 표시합니다.
| 사용 항목 | 표시 가격 | 확인할 점 |
|---|---|---|
| 입력 | 토큰 1M개당 $1.25 | 새로 전달하는 프롬프트와 컨텍스트 토큰 |
| 출력 | 토큰 1M개당 $4.25 | 입력 요금의 약 3.4배 |
| 캐시 읽기 | 토큰 1M개당 $0.15 | 반복되는 에이전트 컨텍스트에 유용 |
| 웹 검색 | 호출 1,000회당 $2.50 | 토큰 요금과 별도 부과 |
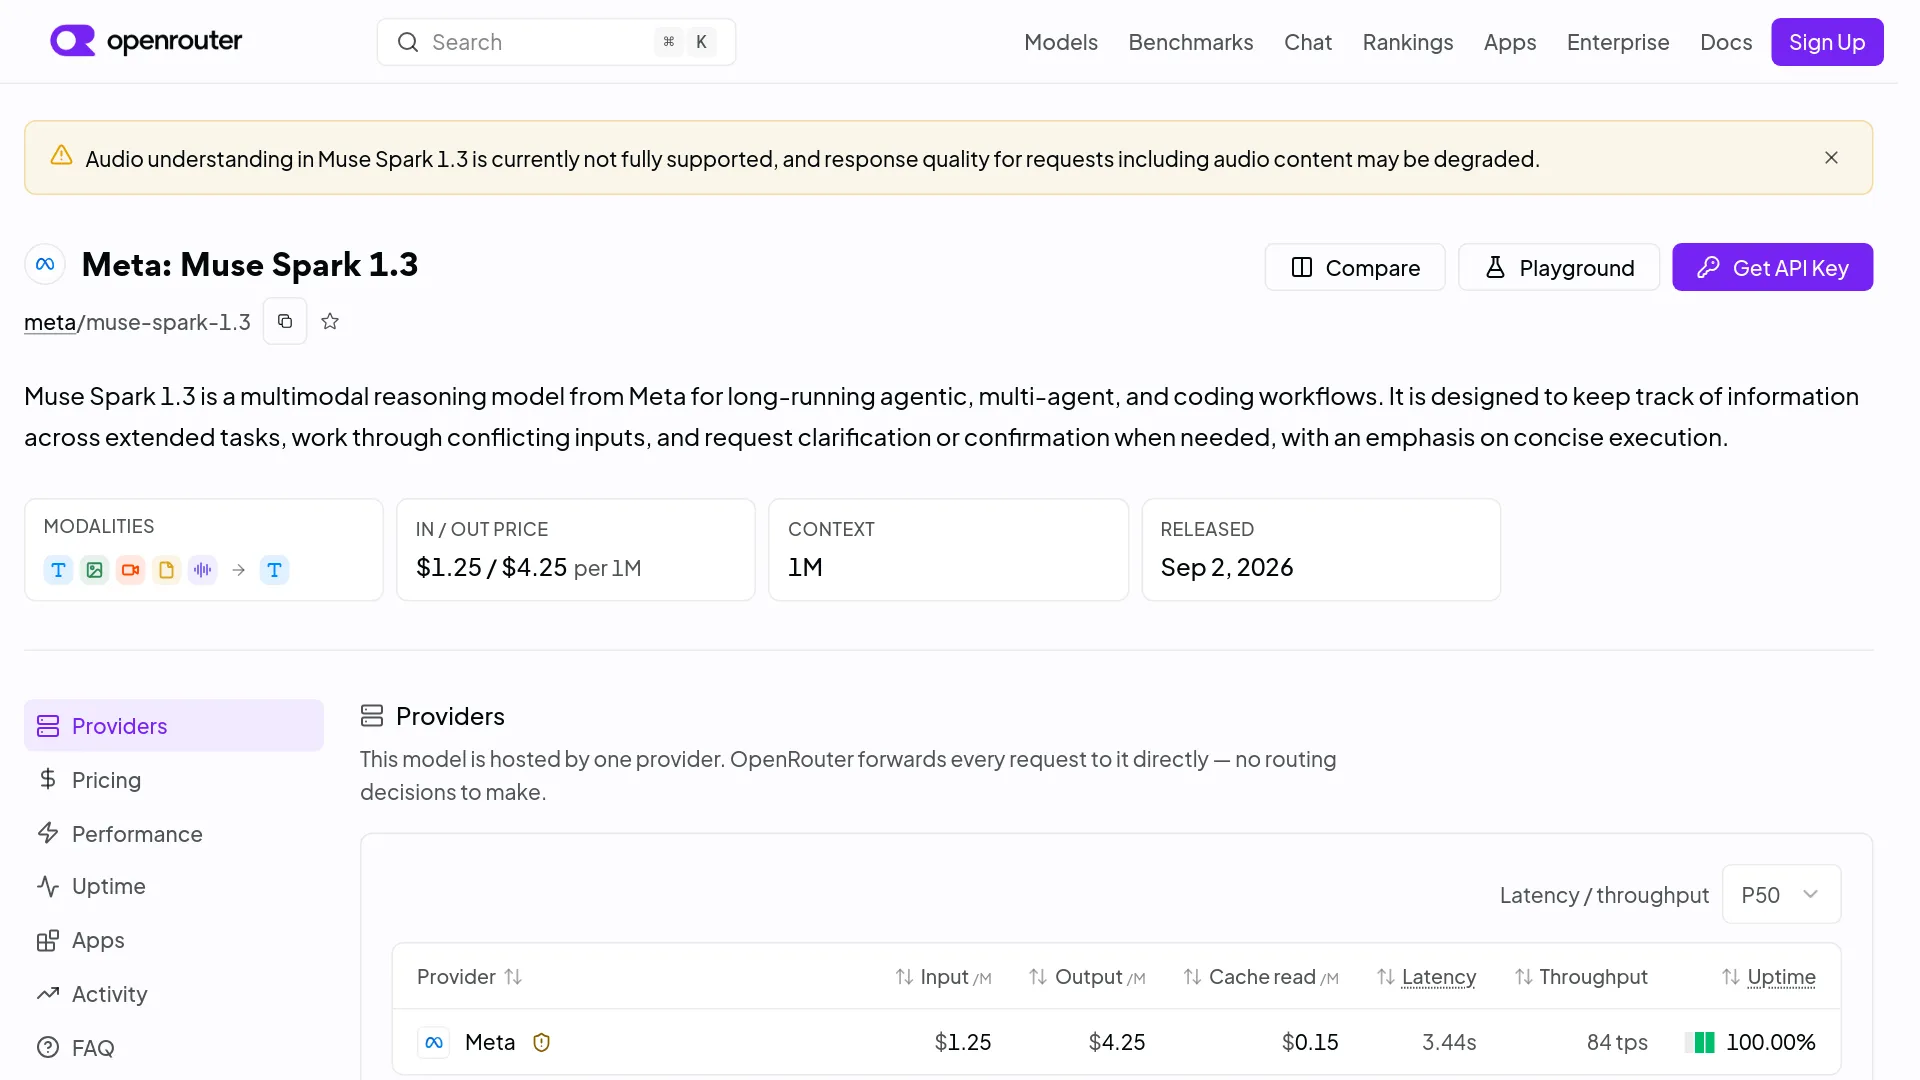
새 입력 토큰 100,000개와 출력 토큰 20,000개를 사용하는 요청은 캐시나 웹 검색 요금을 제외하면 약 $0.21입니다. 입력 비용 $0.125와 출력 비용 $0.085를 합친 금액입니다. 에이전트 루프, 재시도, 반복 컨텍스트가 포함되면 전체 작업 비용은 더 커집니다.
Artificial Analysis의 보고서는 캐시 적중, 입력, 출력 비율을 7:2:1로 가정했을 때 토큰 100만 개당 혼합 가격 $0.78로 계산합니다. 새로운 컨텍스트를 주로 사용하거나 출력량이 많은 워크플로에서는 비용이 더 커지므로, 이 수치는 보편적인 요금이 아니라 특정 시나리오의 추정치로 봐야 합니다.
Muse Spark 1.2 API 가격 가이드에 나온 Contributor 가정을 Muse Spark 1.3에 자동으로 적용해서는 안 됩니다. 1.3의 공개 등록 페이지에는 위의 표준 요금이 명시돼 있지만, 여기서 확인한 자료만으로는 데이터 사용, 속도 제한, 지역별 제공 여부를 모두 다루는 완전한 1.3 Contributor 계약을 확인할 수 없습니다. 프로바이더가 별도 조건을 확인해주기 전까지는 표준 요금을 기준으로 예산을 잡는 편이 안전합니다.
현재 근거가 보여주는 것은 ‘강력한 코딩 모델’이지 ‘모든 분야의 1위’가 아니다
현재까지의 자료는 Muse Spark 1.3이 코딩과 긴 컨텍스트 처리에 강한 모델이라는 점을 뒷받침하지만, 모든 영역에서 최고라는 뜻은 아닙니다. 아래 표는 Meta가 연결한 평가 방법론의 점수를 사용했습니다. 벤치마크마다 척도가 다르므로 숫자는 같은 행 안에서만 비교해야 합니다.
| 평가 항목 | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | 표에 나온 최고 점수 |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
Muse Spark 1.3의 강점이 가장 분명하게 드러나는 분야는 긴 컨텍스트를 사용하는 코딩입니다. 512K–1M 컨텍스트의 MRCR에서 max 결과는 98.1, DeepSWE에서는 75.4를 기록했습니다. Muse Spark 1.2 xhigh의 같은 점수는 각각 55.5와 55.0입니다. 반면 같은 표를 보면 전문 업무, 컴퓨터 사용, 브라우징 평가에서는 더 강한 대안도 확인됩니다.
Meta의 방법론에 따르면 표의 각 수치는 Meta 자체 평가, 공식 리더보드, 또는 프로바이더가 자체 보고한 결과에서 가져올 수 있습니다. 코딩 테스트는 제한된 도구와 외부 인터넷 접속이 없는 환경에서 진행됐습니다. 따라서 이 결과는 참고할 만한 신호이지만, 독립적으로 동일 조건에서 재실행한 종합 비교 결과는 아닙니다.
Artificial Analysis의 보고서는 Intelligence Index 61점을 제시하며, 비교 가능한 모델 196개 중 #10으로 평가합니다. 비교 모델의 중앙값은 36점입니다. ModelCap은 ModelCap Index 81.7점과 리더보드 #4를 보여주지만, 지원 수준은 20%, 공개 벤치마크 관측치는 1개로 평가합니다. 서로 다른 평가 체계가 공통으로 보여주는 결론은 하나입니다. 아직 근거가 충분히 쌓이지 않았다는 점입니다.
실제 워크플로에서는 먼저 저장소 탐색, 긴 터미널 에이전트 작업, 코드베이스 질의응답에 Muse Spark 1.3을 투입해보세요. 브라우징 비중이 높은 작업이나 전문적인 컴퓨터 사용 작업 전반에 같은 결과가 나온다고 일반화해서는 안 됩니다.
속도의 역설: 생성은 빠르지만 시작이 느리다
Muse Spark 1.3은 일단 생성이 시작되면 빠른 편으로 보이지만, 첫 응답이 화면에 나타나기까지는 상당히 오래 걸릴 수 있습니다. 모든 턴이 즉시 시작돼야 하는 대화형 코딩보다는 지속 실행이나 배치 작업에 더 잘 맞는 특성입니다.
Artificial Analysis는 출력 속도를 초당 181.7토큰으로 측정했습니다. 비교 모델 중앙값은 68.1입니다. 반면 첫 토큰까지 걸리는 시간은 27.51초로, 중앙값 3.04초보다 훨씬 깁니다. 자체 워크로드 기준 500토큰 응답에는 41.26초가 걸릴 것으로 추정합니다. 프로바이더 페이지에는 첫 응답 토큰까지 38.51초, Intelligence Index 작업 1회당 비용은 $0.55로 표시돼 있습니다.
OpenRouter의 P50 수치는 다릅니다. 초당 62토큰, 지연 시간 1.83초로 표시됩니다. 각 페이지가 서로 다른 워크로드와 정의를 사용하고 Artificial Analysis는 첫 응답 측정에 추론 시간을 포함하기 때문에 두 수치를 직접 비교할 수는 없습니다. 실제 환경에서는 자체 테스트 도구로 첫 토큰까지 걸리는 시간과 전체 작업 완료 시간을 모두 측정해야 합니다.
“몇 분이 물어봐서 남기는 초기 인상(지금도 실행 중)입니다. 기계적인 느낌이지만(업무에는 훌륭하고, 전략 작업에는 어떨지 모르겠네요) 상당히 유능합니다. 꽤 빠른 것 같아요.” — u/NewYak4281, r/singularity
통제되지 않은 초기 사용 후기는 측정 결과와도 어느 정도 맞아떨어집니다. 첫 응답까지는 오래 걸릴 수 있지만 생성이 시작되면 빠르고, 상호작용 방식은 다소 기계적으로 느껴질 수 있습니다. 다만 이는 참고 자료일 뿐, 통제된 테스트를 대신할 수는 없습니다.
프로덕션 투입 전 확인해야 할 API 기능과 제공 범위
Muse Spark 1.3은 최신 에이전트 모델에 기대하는 통합 기능을 갖추고 있습니다. 하지만 프로덕션에 중요한 세부 사항 중 일부는 프로바이더에 따라 달라지거나 아직 공개되지 않았습니다. 현재 가장 강력한 API 근거는 출시 게시물의 완전한 공개 Meta 사양이 아니라 OpenRouter의 실제 모델 페이지와 Artificial Analysis의 프로바이더 추적 정보입니다.
| 기능 또는 한도 | 현재 확인된 내용 | 프로덕션에서의 의미 |
|---|---|---|
| 컨텍스트 윈도 | OpenRouter와 ModelCap은 토큰 1,048,576개로 표시 | 실제 호출 엔드포인트의 한도를 확인해야 함 |
| 최대 출력량 | ModelCap은 토큰 944K개로 표시 | 프로바이더별 출력 한도는 더 낮을 수 있음 |
| 입력 | 텍스트, 이미지, 동영상, 파일 지원. 오디오는 경고와 함께 표시 | 오디오 이해 기능은 아직 완전하지 않은 것으로 취급 |
| 출력 | 텍스트 | 텍스트를 매개로 한 워크플로를 설계해야 함 |
| 도구 호출 | 지원되는 것으로 표시 | 사용 중인 SDK에서 스키마와 도구 오류를 테스트해야 함 |
| 구조화된 출력 | JSON 스키마 응답 형식이 표시됨 | 엄격한 스키마에서 실패하는 경우를 테스트해야 함 |
| 프로바이더 지원 범위 | OpenRouter 페이지와 Artificial Analysis 추적 페이지에 Meta 프로바이더 1곳이 표시됨 | 장애 발생 시 대체 라우팅을 당연히 기대해서는 안 됨 |
| 모델 웨이트 | API 전용이며 다운로드 가능한 웨이트는 표시되지 않음 | 셀프 호스팅 경로가 확립되지 않음 |
ModelCap은 개별 프로바이더가 공개된 최대치보다 낮은 컨텍스트 또는 출력 한도를 제공할 수 있다고 경고합니다. OpenRouter의 제공 상태 패널에는 3일 기준 가동률 99.97%가 표시되지만, 72시간 및 24시간 기준 화면에서는 더 낮은 수치가 나타납니다. 서로 다른 페이지 지표이므로 프로덕션 트래픽을 라우팅할 때는 최신 상태 데이터와 자체 오류 로그를 함께 확인해야 합니다.
Meta는 출시 게시물에서 파라미터 수, 아키텍처, 공식 API 속도 제한, 라이선스 조건, 상세 안전성 테스트 결과를 공개하지 않았습니다. 프롬프트 인젝션에 대한 저항력과 되돌릴 수 없는 작업을 판단하는 능력이 개선됐다고 주장하지만, 공격 성공률이나 재현 가능한 레드팀 프로토콜은 제시하지 않았습니다.
지금 Muse Spark 1.3을 사용해도 될까?
Muse Spark 1.3은 즉각적인 첫 응답보다 낮은 토큰 비용과 지속적인 생성 속도가 중요한 긴 컨텍스트 코딩 및 도구 중심 에이전트 작업에 지금 테스트해볼 가치가 있습니다. 하지만 지연 시간에 민감하거나 오디오 사용량이 많고, 개인정보 보호 또는 이중화가 중요한 시스템에서 유일한 프로덕션 모델로 쓰기에는 아직 부족합니다.
| 사용 환경 | 판단 |
|---|---|
| 대규모 저장소, 코드베이스 Q&A, 긴 터미널 작업 | Muse Spark 1.3부터 테스트 |
| 출력 속도가 중요한 배치 에이전트 작업 | 유력한 후보. 전체 작업 비용을 측정할 것 |
| 대화형 페어 프로그래밍 | 첫 토큰 지연을 감수할 수 있을 때만 사용 |
| 오디오 중심 워크플로 | 확실한 오디오 지원을 기다리거나 다른 모델 선택 |
| 민감한 고객 코드 또는 규제 대상 데이터 | 먼저 데이터 계약을 확인 |
| 장애 대비가 필요한 미션 크리티컬 서비스 | 두 번째 모델과 라우팅 경로를 유지 |
리더보드 스크린샷을 한 장 더 확인하는 것보다, 위험을 낮춘 단계적 도입이 더 유용합니다.
- 민감하지 않은 저장소와 고정된 작업 다섯~열 개로 시작합니다.
- 셸, 파일 쓰기, 네트워크, 파괴적 도구의 권한을 최소 수준으로 제한합니다.
- 완료율, 도구 호출 횟수, 첫 토큰 지연 시간, 소요 시간, 토큰 수, 청구 비용을 기록합니다.
- 현재 기준 모델로 동일한 작업을 수행해 비교하고, 시간 초과나 신뢰도가 낮은 수정에 대비할 대체 경로를 유지합니다.
코딩 에이전트에서 Muse Spark 1.3을 실험 플래그 뒤에 배치한 다음, 출시 당일 순위가 아니라 실제 저장소 테스트 결과를 기준으로 결정하세요. 가격과 긴 컨텍스트 성능은 테스트를 정당화할 만하지만, 느린 초기 응답, 제한적인 프로바이더 지원, 불완전한 오디오 지원, 아직 잠정적인 벤치마크 근거는 단독 배포를 경계하게 만드는 요소입니다.
Muse Spark 1.3 API 및 가격 FAQ
Muse Spark 1.3은 공식 출시됐나요?
네. Meta는 2026년 9월 2일 발표에서 Muse Spark 1.3이 Muse Code와 Meta Model API에 순차적으로 제공된다고 밝혔습니다. max reasoning은 추가 안전성 테스트를 기다리는 상태였습니다.
Muse Spark 1.3에는 어떻게 접근할 수 있나요?
Meta는 Muse Code와 Meta Model API를 제공 경로로 명시합니다. OpenRouter에도 meta/muse-spark-1.3이 등록돼 있습니다. 실제 접근 가능 여부는 프로바이더, 계정, 지역에 따라 달라질 수 있습니다.
Muse Spark 1.3의 가격은 얼마인가요?
OpenRouter 등록 페이지에는 입력 토큰 100만 개당 $1.25, 출력 토큰 100만 개당 $4.25, 캐시 읽기 토큰 100만 개당 $0.15, 웹 검색 호출 1,000회당 $2.50로 표시돼 있습니다. 직접 이용하는 프로바이더가 별도 가격표를 확인해주지 않는 한, 이를 인용된 OpenRouter 요금으로 취급하세요.
Muse Spark 1.3은 컨텍스트 윈도 100만 토큰을 지원하나요?
OpenRouter와 ModelCap은 토큰 1,048,576개로 표시하고, Artificial Analysis는 이를 100만 토큰으로 반올림합니다. 실제 호출하는 엔드포인트에서 컨텍스트와 출력 한도를 확인해야 합니다.
비전, 동영상, 도구, JSON 출력을 지원하나요?
OpenRouter에는 텍스트, 이미지, 동영상, 파일 입력과 도구 호출, JSON 스키마 기반 구조화 출력이 지원되는 것으로 표시돼 있습니다. 오디오는 완전히 지원되지 않는다는 경고와 함께 등록돼 있습니다.
Muse Spark 1.3은 오픈 소스 모델인가요? 셀프 호스팅할 수 있나요?
여기서 확인한 자료에서는 다운로드 가능한 웨이트나 셀프 호스팅 패키지를 확인할 수 없었습니다. Meta는 오픈 웨이트를 향후 로드맵으로 설명했을 뿐, 현재 사용할 수 있는 Muse Spark 1.3 아티팩트로 제공하지 않았습니다.
max reasoning을 사용할 수 있나요?
Meta는 기존 추론 모드를 먼저 제공하고 max reasoning은 추가 안전성 테스트 이후 지원한다고 밝혔습니다. 발표문에는 확정된 일정이 제시되지 않았습니다.
Muse Spark 1.2 Contributor 가격이 1.3에도 적용된다고 봐도 되나요?
아니요. 1.2 Contributor 조건은 별도로 문서화돼 있지만, 여기서 확인한 자료만으로는 완전한 1.3 Contributor 계약을 확인할 수 없습니다. 프로바이더가 다른 등급과 데이터 정책, 속도 제한을 확인해주기 전까지는 표준 1.3 요금을 기준으로 예산을 잡으세요.
프로덕션에 투입하기 전, 민감하지 않은 소규모 저장소 벤치마크를 실행하세요. 현재 사용하는 모델과 동일한 작업을 비교하면서 첫 토큰 지연, 완료된 변경 사항, 도구 호출 횟수, 비용을 기록하면 됩니다. 이렇게 해야 출시 당일 순위보다 실제 배포 여부를 더 정확하게 판단할 수 있습니다.