 AIREITER
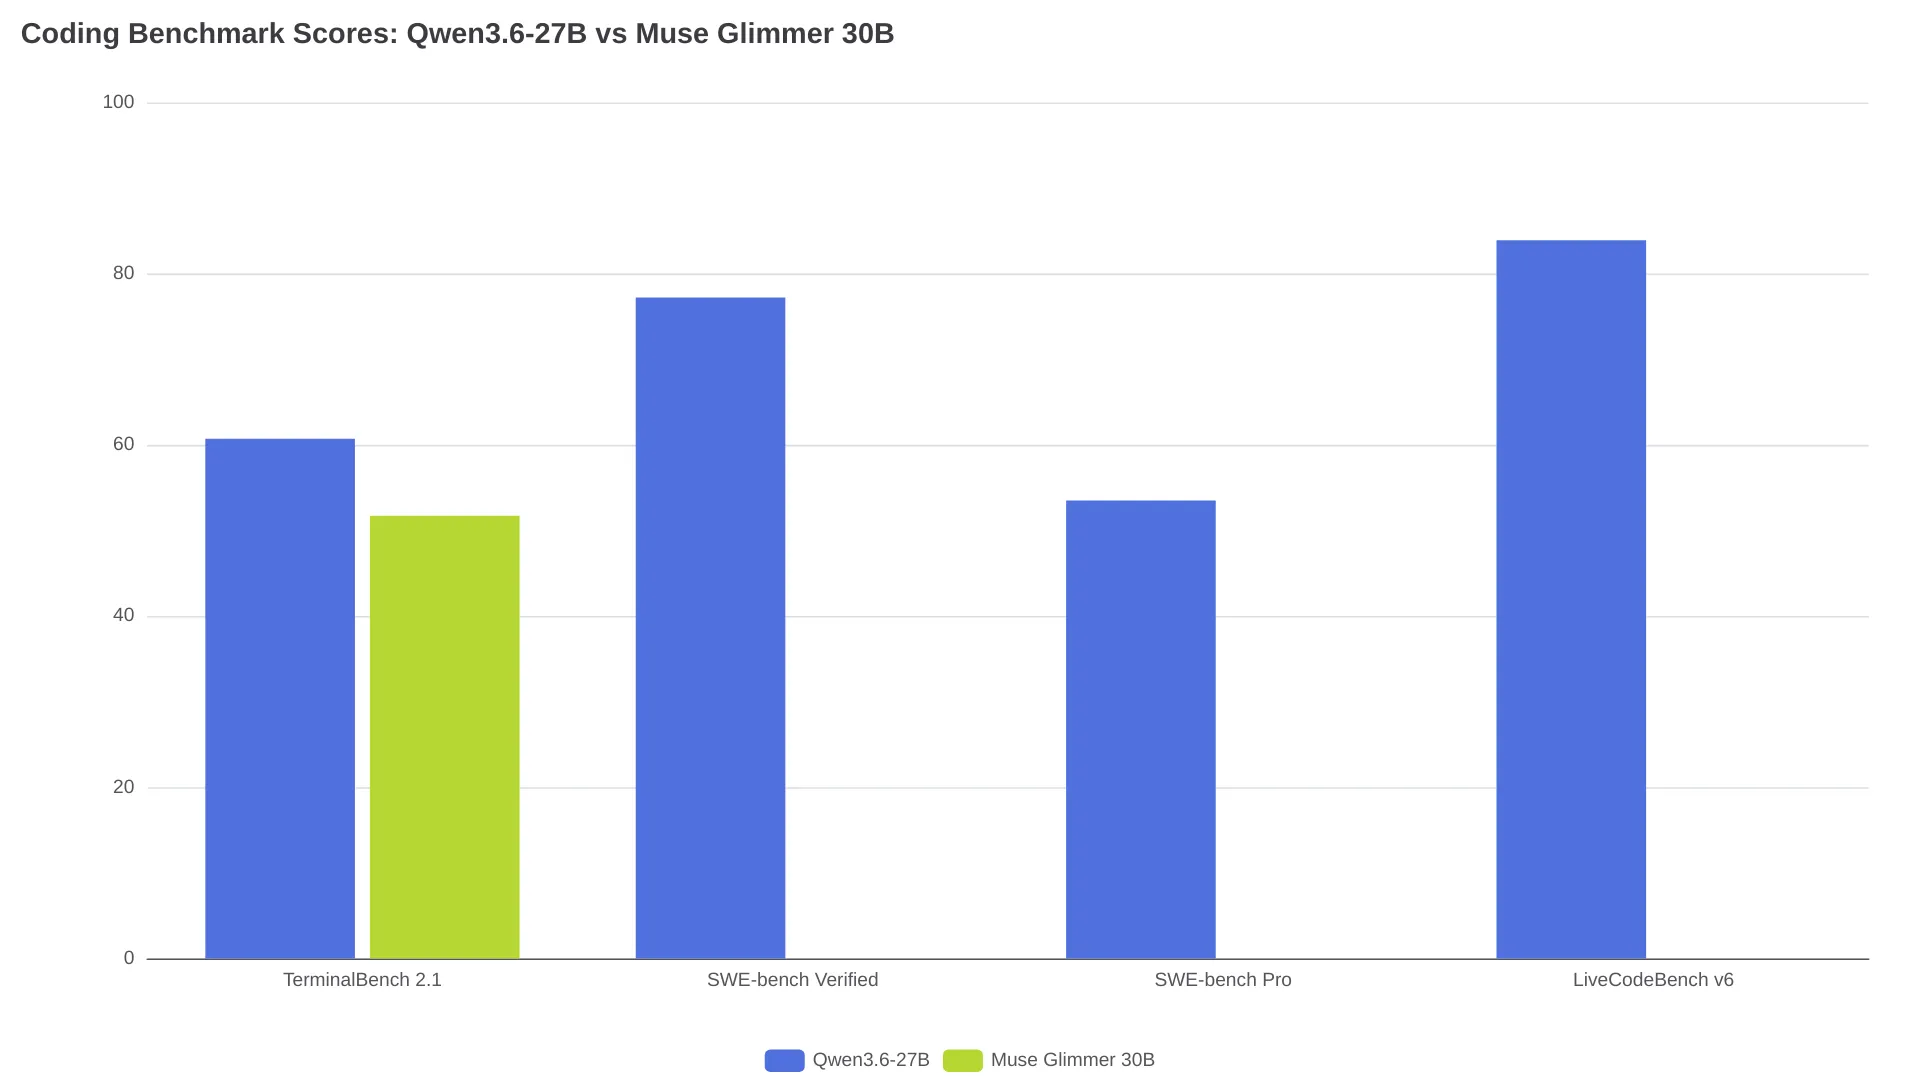
로컬에서 코딩 모델을 돌릴 때는 점수만으로 선택하기 어렵습니다. Qwen3.6-27B는 2026년 4월 Hugging Face 모델 카드와 함께 상세한 벤치마크를 공개했고, Meta의 오픈 웨이트 모델 Muse Glimmer 30B는 2026년 8월 뒤이어 등장했습니다. 수일 안에 로컬 LLM 커뮤니티의 정면 비교가 시작됐습니다. 순수 코딩 에이전트 점수는 Qwen 쪽이 우세합니다. TerminalBench 2.1에서 Qwen은 60.7점, Glimmer는 51.7점이었고 Qwen의 공식 SWE-bench Verified 점수는 77.2입니다. 다만 GPU 한 장으로 구동할 수 있는 컨텍스트 규모까지 보면 Glimmer의 VRAM 효율은 선택을 바꿀 만한 변수입니다.
TerminalBench 2.1: Qwen이 9점 앞섰다
TerminalBench는 도구 호출, 여러 단계에 걸친 작업 수행, 긴 세션에서의 컨텍스트 유지 능력을 포함해 터미널 에이전트의 신뢰성을 측정합니다. 링크된 커뮤니티 토론에서는 현재 확인 가능한 코딩 에이전트 정면 비교 결과로 TerminalBench 2.1을 주로 인용합니다.
2026년 8월 10~11일 r/LocalLLaMA 토론에 올라온 커뮤니티 보고 TerminalBench 2.1 점수는 다음과 같습니다.
| 모델 | TerminalBench 2.1 | 출처 유형 |
|---|---|---|
| Qwen3.6-27B | 60.7 | 커뮤니티 보고 |
| Muse Glimmer 30B | 51.7 | 커뮤니티 보고 |
| Gemma 4 31B | 43.4 | 커뮤니티 보고 |
다만 TerminalBench는 베이스 모델 단독이 아니라 모델과 하니스의 조합을 평가한다는 점을 짚어야 합니다. Qwen3.6-27B 공식 모델 카드는 Harbor/Terminus-2 하니스, 3시간 제한 시간, CPU 32개, RAM 48 GB, 최대 출력 80K, 컨텍스트 256K, 5회 실행 평균을 명시합니다. Glimmer의 점수는 다른 하니스 또는 최적화 수준이 낮은 구성에서 나왔을 수 있습니다. 따라서 9점 차이는 실제 에이전트 구성에 따라 줄어들 수도, 커질 수도 있습니다.
공식 코딩 벤치마크는 Qwen만 공개했다
Qwen3.6-27B는 모델 카드에 공식 벤치마크 결과를 공개했습니다. 반면 이번 비교에서 검토한 링크된 출처에서는 2026년 8월 기준 Muse Glimmer의 공식 SWE-bench, LiveCodeBench 또는 이에 준하는 에이전트형 코딩 벤치마크를 찾지 못했습니다. 공개된 근거의 폭은 Qwen이 더 넓지만, 두 모델을 동일한 조건으로 비교한 공식 결과는 아직 없습니다.
Qwen의 공식 코딩 벤치마크는 다음과 같습니다.
| 벤치마크 | Qwen3.6-27B (공식) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
위 수치는 벤더가 공개한 결과입니다. 모델 카드에 따르면 SWE-bench 평가는 Qwen의 내부 bash/file-edit 스캐폴드를 사용했으며, temperature 1.0, top-p 0.95, 컨텍스트 윈도우 200K 조건으로 진행됐습니다. SWE-bench Pro는 Qwen이 문제가 있는 항목을 수정한 정제 태스크 세트에서 산출됐으므로, 공개 리더보드 수치와 완전히 같은 조건으로 비교하기는 어렵습니다. morphllm의 서드파티 분석도 Qwen 자체 에이전트 스캐폴드에 의존하며 독립 재현 사례가 제한적이라는 점을 지적합니다.
로컬 실사용 테스트에서 확인된 점
M5 Pro에서 OpenCode Q4 테스트
한 개발자는 48 GB RAM을 탑재한 M5 Pro에서 OpenCode로 Muse Glimmer의 Q4 양자화(Unsloth 빌드)를 테스트했습니다. 모델은 약 20 GB RAM을 사용했고 생성 속도는 초당 17토큰이었습니다. 결론은 다음과 같았습니다.
"전반적으로 Qwen3.6 27B보다 아래다" - u/curiousily_
프론트엔드와 백엔드 코딩 결과 모두 Qwen보다 낮은 평가를 받았습니다. 다만 테스트 중 도구 호출이 한 번도 실패하지 않았다는 점은 긍정적으로 언급됐습니다. 추론 루프나 확장 사고 설정은 사용하지 않았기 때문에, 이것이 Glimmer 성능을 제한했을 가능성도 있습니다.
max_tokens 설정이 성능을 망칠 수 있다
r/LocalLLM의 또 다른 테스터는 출력 토큰 예산이 지나치게 작으면 Muse Glimmer가 실제보다 훨씬 못하는 모델처럼 보일 수 있음을 확인했습니다. 화면에 표시할 답변을 만들기 전에 추론 과정에서 토큰 예산을 소진해 빈 응답이나 잘린 응답이 나오는 방식입니다. max_tokens를 늘리자 모델을 바꾸지 않고도 테스트 하니스의 통과 태스크가 6/13에서 11/13으로 증가해 통과율이 거의 두 배가 됐습니다. 기본 출력 제한으로 Glimmer를 테스트한다면, 모델이 아니라 설정을 측정하고 있을 수 있습니다.
Hermes에서 나타난 터미널 루프
또 다른 사용자는 Hermes 에이전트 프레임워크와 함께 쓸 때 Muse Glimmer가 과도한 터미널 명령에 빠지는 현상을 보고했습니다. 같은 설정에서 Qwen3.6-27B를 사용할 때는 겪지 못한 동작이라고 합니다. 이 일화는 현재 확인 가능한 TerminalBench 격차와 방향성 면에서 일치하지만, 모델 자체의 문제와 Hermes 설정의 영향을 분리한 결과는 아닙니다.
토큰 효율: 가능성은 있지만 정량 근거는 없다
u/NoFaithlessness951의 벤치마크 갤러리 게시물은 효율 측면을 제기했습니다.
"Qwen보다 조금 덜 똑똑하지만, 작업당 토큰은 훨씬 적게 쓴다." - u/NoFaithlessness951
이는 통제된 작업당 성공 토큰 측정이 아니라 커뮤니티의 정성적 관찰입니다. 동일 태스크와 성공률, 지연 시간 데이터를 맞춘 상태에서 Glimmer와 Qwen의 토큰 사용량을 비교한 연구는 아직 없습니다. 효율 우위 주장은 확립된 사실이 아니라 주목할 만한 단서로 받아들이는 편이 적절합니다.
VRAM과 컨텍스트에서는 Glimmer가 유리하다
Muse Glimmer가 확실히 앞서는 지점은 여기입니다. r/LocalLLaMA의 한 테스터는 Q4_K_XL, DFlash speculative decoding, 멀티모달 프로젝터, 전체 F16 KV 캐시를 적용한 Muse Glimmer 30B가 RTX 3090 한 장에서 약 22-23 GB 안에 들어가며, 262,144토큰 컨텍스트 윈도우를 설정할 수 있음을 시연했습니다.
같은 RTX 3090, 같은 Q4_K_XL 양자화 기준입니다.
| 모델 | F16 KV 컨텍스트 | Q8 KV 컨텍스트 | 사용 VRAM |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | 24 GB에 탑재 가능 |
| Gemma 4 31B | 52,000 | 81,000 | 24 GB에 탑재 가능 |
해당 작성자는 대규모 리포지터리 컨텍스트를 프롬프트에 넣는 워크플로에서는 Qwen의 70K F16 컨텍스트가 "사실상 쓰기 어려운 수준"이라고 평가했습니다.
이 RTX 3090 구성에서 보고된 Muse Glimmer 처리량은 다음과 같습니다.
- 생성 속도: 초당 64-124토큰(코드와 일반 텍스트에 따라 변동)
- 프롬프트 처리: 초당 ~1,400토큰
- 장문 컨텍스트 검색: 약 150K 토큰에서 two-needle haystack 테스트를 첫 시도에 통과
같은 하드웨어에서 Qwen3.6-27B로 긴 컨텍스트를 쓰려면 출력 충실도와 컨텍스트 길이를 맞바꾸는 Q8 KV 캐시 압축을 적용하거나, 더 강력한 장비로 오프로드해야 합니다. 해당 테스터는 전체 컨텍스트가 필요할 때 Qwen을 DGX Spark로 옮겨 사용했다고 밝혔는데, 이는 상당히 더 비싼 장비입니다.
상위급 하드웨어에서는 Qwen3.6-27B NVFP4 빌드가 DGX Spark에서 최대 128K 컨텍스트까지 단일 세션 기준 초당 28-33토큰을 기록했다고 kie.ai의 벤치마크 분석은 전합니다. Unsloth Muse Glimmer Q5_K_M 빌드는 RTX 5090에서 패치된 llama.cpp DFlash 경로를 통한 코드 패치 생성 시 초당 220-253토큰에 도달한 것으로 보고됐습니다.
어떤 모델을 선택해야 할까?
| 사용 시나리오 | 추천 모델 | 이유 |
|---|---|---|
| 코딩 전용, 단발성 생성 | Qwen3.6-27B | 공개된 코딩 벤치마크 근거가 더 강하며, 현재 확인 가능한 TerminalBench 2.1 커뮤니티 비교에서도 앞섬 |
| 24 GB GPU 한 장에서 대형 컨텍스트 에이전트 코딩 | Muse Glimmer 30B | 동일 하드웨어의 Q4_K_XL/DFlash 구성에서 Qwen은 70K, Glimmer는 262K F16 컨텍스트 지원 |
| 장기 실행 터미널 작업 | Qwen3.6-27B | TerminalBench 2.1에서 60.7 대 51.7이며, Glimmer에서는 에이전트 프레임워크 루프 커뮤니티 보고도 있음 |
| 대량 처리와 비용 민감 작업 | Muse Glimmer 30B (가능성) | 작업당 토큰이 더 적다는 커뮤니티 보고가 있으나, 성공당 비용을 맞춰 비교한 자료는 없음 |
| 대규모 컨텍스트 기반 리포지터리 코딩 | Muse Glimmer 30B (VRAM이 제한적일 때) | 24 GB 환경에서 Qwen은 큰 컨텍스트를 위해 Q8 KV 압축 또는 멀티 GPU가 필요함 |
| 하드웨어 제약 없는 최고 코딩 정확도 | Qwen3.6-27B | 공식 점수를 포함한 공개 벤치마크 근거가 더 강함 |
FAQ
Muse Glimmer에 공식 SWE-bench 점수가 있나?
없습니다. 이번 비교에서 검토한 출처에서는 2026년 8월 기준 Muse Glimmer 30B의 공식 SWE-bench, LiveCodeBench, TerminalBench 점수를 찾지 못했습니다. TerminalBench 2.1의 51.7점은 Meta의 공식 평가가 아니라 Reddit 스레드의 커뮤니티 테스트 결과입니다.
두 모델 모두 RTX 3090 한 장에서 실행할 수 있나?
가능합니다. Muse Glimmer 30B는 Q4_K_XL에서 전체 F16 KV 캐시와 262K 컨텍스트를 적용해도 ~22-23 GB에 들어갑니다. Qwen3.6-27B도 Q4_K_XL에서 구동되지만, 동일 GPU에서는 F16 컨텍스트가 70K로 제한되며 Q8 KV 캐시 압축을 적용하면 125K까지 가능합니다.
Muse Glimmer는 코딩 작업에서 검열이 심한가?
한 사용자가 Python 마우스 제어 코드의 디버깅을 요청했을 때 Muse Glimmer가 잠재적 보안 문제로 보고 도움을 거부했다고 보고했습니다. 그러나 시스템 프롬프트와 구성은 공개되지 않은 단일 일화입니다. 이 동작이 모델 자체에서 비롯된 것인지, 추론 설정의 영향인지를 판단하기에는 충분하지 않습니다.
에이전트형 코딩 워크플로에는 어느 쪽이 더 적합한가?
TerminalBench 점수와 커뮤니티 보고를 기준으로 보면, 긴 시간 이어지는 터미널 에이전트 작업에서는 Qwen3.6-27B가 더 신뢰할 만합니다. Muse Glimmer 30B는 VRAM 효율 덕분에 제약된 하드웨어에서 더 현실적인 선택이며, 작업당 토큰이 적을 가능성도 있어 대량 에이전트 루프의 비용과 지연 시간을 낮출 수 있습니다. 다만 이를 정량화한 통제 비교는 아직 없습니다.
Muse Glimmer 코딩에는 어떤 max_tokens 값을 써야 하나?
출력 예산은 넉넉하게 잡는 편이 좋습니다. 한 테스터는 낮은 max_tokens 제한 때문에 Glimmer가 화면에 보이는 출력을 만들기 전 추론에 토큰 예산을 모두 소진했고, 이로 인해 빈 응답이나 잘린 응답이 실패처럼 보였다고 밝혔습니다. 제한을 늘리자 통과 태스크가 6/13에서 11/13으로 개선됐습니다. Qwen3.6-27B 모델 카드는 일반 질의에 32,768토큰, 어려운 벤치마크 작업에 81,920토큰을 권장합니다. Meta가 자체 가이드를 공개하기 전까지는 Glimmer에도 같은 출력 예산을 출발점으로 삼는 것이 합리적입니다.