 AIREITER
30B급 멀티모달 모델을 RTX 3090 한 장에서 262K 컨텍스트까지 돌릴 수 있다면 어떨까. 2026년 8월 10일 공개된 Meta의 Muse Glimmer는 바로 그 가능성 때문에 로컬 AI 커뮤니티의 집중 테스트 대상이 됐다. 결론부터 말하면, DFlash를 적용한 RTX 5090에서는 236 tok/s를 기록하고 RTX 3090 한 장에서도 전체 262K 컨텍스트를 담을 수 있다. 반면 TerminalBench 2.1 점수는 Qwen 3.6 27B보다 9점 낮고, OS 수준 자동화 작업을 거부하는 경향도 있다.
Muse Glimmer 30B는 어떤 모델인가
Muse Glimmer는 Meta Superintelligence Labs가 Apache 2.0 라이선스로 공개한 30B 파라미터 밀집형 멀티모달 모델이다. 코딩 리더보드 최상위를 노린 모델이라기보다, 로컬 환경에 상주하는 에이전트 워크플로를 염두에 두고 설계됐다. 27.9B 텍스트 디코더와 1.9B ViT 비전 인코더, GELU 기반 멀티모달 프로젝터를 결합해 텍스트와 이미지를 모두 이해한다. 아래 아키텍처 정보는 SGLang Day-0 지원 블로그를 바탕으로 했다.
핵심 아키텍처 사양
| 항목 | 세부 내용 |
|---|---|
| 총 파라미터 | 30B |
| 텍스트 디코더 | 27.9B dense |
| 비전 인코더 | 1.9B ViT |
| Transformer 레이어 | 52 |
| 어텐션 | Grouped-query (32 query heads, 2 KV heads - 16:1 GQA) |
| 피드포워드 | SwiGLU |
| 컨텍스트 윈도우 | 128K+ (262K까지 테스트) |
| 라이선스 | Apache 2.0 |
어텐션은 하이브리드 방식이다. 2,048토큰 슬라이딩 윈도우 어텐션 레이어 3개 뒤에 전체 시퀀스 어텐션 레이어 1개가 배치되며, 이 구성이 4개 레이어마다 반복된다. 로컬 윈도우 레이어에는 RoPE를, 전체 어텐션 레이어에는 NoPE를 적용해 학습 시점의 한계를 넘는 컨텍스트 확장을 가능하게 한다. 16:1 grouped-query attention 비율은 KV 캐시를 작게 유지한다. 커뮤니티 측정 결과 F16에서 131K 토큰당 약 1.8 GiB 수준으로 나타났으며, 덕분에 Qwen 3.6 27B가 같은 F16 설정에서 70K 토큰에 그치는 24 GB GPU에서도 전체 길이 컨텍스트를 유지할 수 있다.
내 하드웨어에서 실행할 수 있을까
가능 여부는 어떤 양자화를 선택하느냐에 크게 좌우된다. SGLang은 BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic, MLX 4-bit 공식 체크포인트를 제공한다. VRAM이 특히 부족한 환경을 위해 커뮤니티에서는 2-bit GGUF까지 시도했다.
구성별 VRAM 요구량
| 구성 | 대략적인 VRAM | 권장 하드웨어 |
|---|---|---|
| BF16 | ~60 GB | Single H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K context | ~22-23 GB | RTX 3090 (24 GB) |
| 2-bit GGUF | ~14 GB | RTX 4060 Ti / lower-end |
| MLX Q4 (Apple Silicon) | Unified memory | Mac mini / MacBook Pro |
한 Reddit 사용자는 테스트를 통해 DFlash speculative decoding, 멀티모달 프로젝션 파일, F16 KV 캐시를 적용한 Q4_K_XL Muse Glimmer가 RTX 3090 한 장에서 22-23 GB로 여유 있게 동작한다는 것을 보여줬다. 이때 전체 262,144토큰 컨텍스트도 활성화했으며, 약 150K토큰짜리 헤이스택에서 두 개의 니들을 첫 시도에 찾아냈다.
비교하면 같은 RTX 3090에서 Qwen 3.6 27B는 F16 KV 캐시 기준 70K 토큰까지만 지원한다. Q8 KV 캐시를 쓰면 125K까지 늘어난다. Gemma 4 31B는 F16에서 52K, Q8에서 81K다. 같은 하드웨어에서 Muse Glimmer가 더 긴 컨텍스트를 담는 핵심 이유는 16:1 GQA 비율이 제공하는 KV 캐시 효율이다.
실행 경로: NVIDIA 환경에서는 NVFP4 또는 GGUF 체크포인트와 함께 SGLang이나 llama.cpp를 사용하고 --speculative-algorithm DFLASH를 활성화하면 된다. Apple Silicon에서는 MLX 백엔드를 사용해야 하며 DFlash는 지원되지 않는다. 96 GB 통합 메모리의 M3 Max 사용자는 17 tokens/s를 보고했고, 해당 시스템에서 Muse Glimmer가 Qwen과 Gemma보다 모두 빨랐다고 전했다.
Muse Glimmer 추론 속도는 어느 정도인가
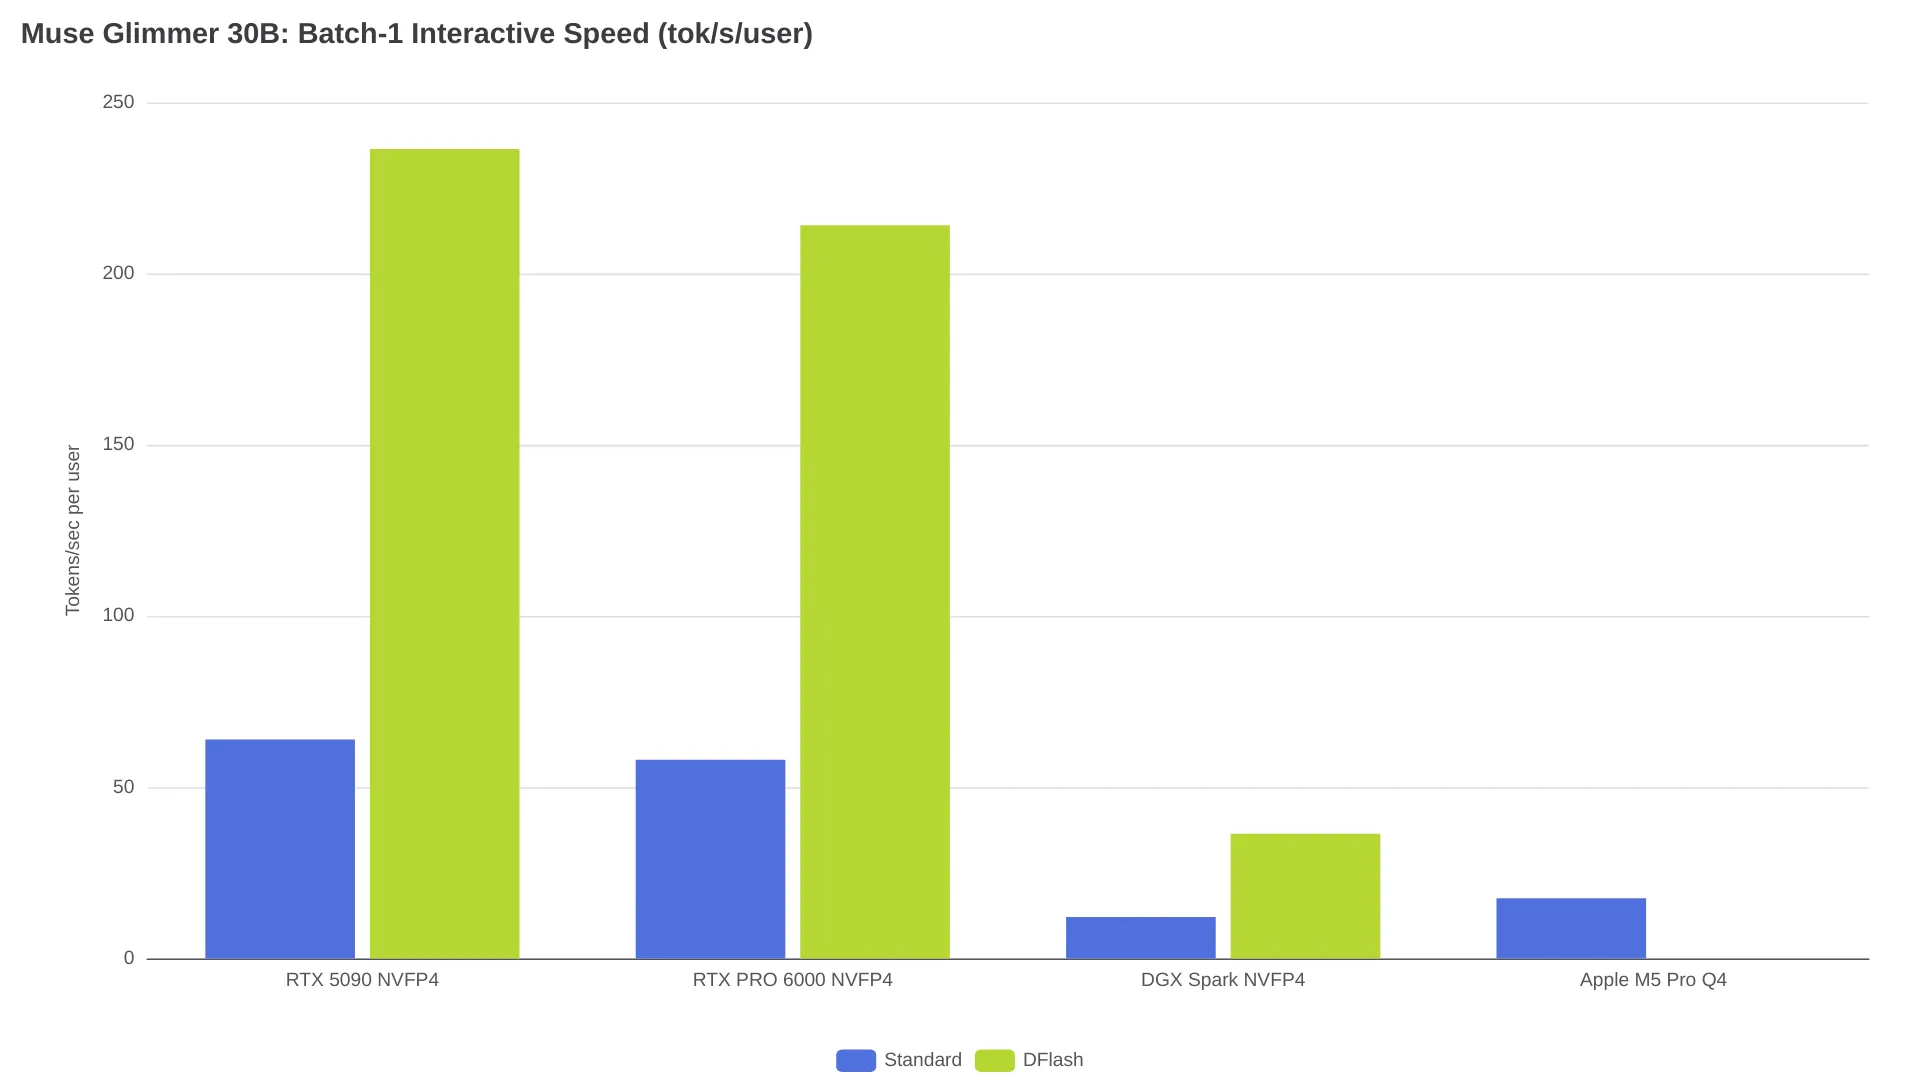
SGLang은 7개 하드웨어 구성에서 배치 크기 1부터 8까지 측정한 벤치마크를 공개했다. --speculative-algorithm DFLASH로 활성화하는 DFlash speculative decoding은 NVIDIA 플랫폼에서 배치 1 인터랙티브 처리량을 1.9배에서 4.3배까지 높였다.
SGLang 주요 벤치마크 수치
| 플랫폼 | 정밀도 | 디코딩 | 배치 1 tok/s/user | 배치 8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
RTX 5090에서 배치 8 기준 1,452 output tokens/s는 합산 처리량이다. 단일 사용자가 로컬 추론을 할 때 참고할 수치는 NVFP4와 DFlash 조합의 236 tok/s다. 같은 구성이라도 DFlash를 끄면 63.9 tok/s까지 내려간다. 커뮤니티 결과도 비슷하다. RTX 5090 사용자 한 명은 Unsloth Q5_K_M 양자화에서 220-253 tokens/s를 보고했다.
DFlash 성능은 드래프트 수용률에 따라 달라진다. Vulkan/RX 7900 XTX 및 SYCL/B70 사용자는 모두 낮은 드래프트 수용률과 그에 따른 전체 처리량 저하를 보고했다.
Muse Glimmer와 Qwen 3.6 27B, 무엇을 선택할까
TerminalBench 2.1 비교
| 모델 | TerminalBench 2.1 | RTX 3090 컨텍스트 (F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
TerminalBench 2.1 점수는 커뮤니티 토론에서 인용했다. 컨텍스트 수치는 RTX 3090 테스트 기준이다.
장기 작업에서 모델이 신뢰성 있게 터미널 명령을 실행할 수 있는지 평가하는 핵심 지표로 커뮤니티가 보는 TerminalBench 2.1에서 Qwen 3.6 27B는 9점 앞선다. 직접 코딩 테스트에서도 격차는 일관됐다. 한 사용자의 비공개 평가 스위트에서는 Qwen이 12/13, Glimmer가 11/13을 기록했다. Qwen은 953줄짜리 도쿄 관광 페이지를 첫 시도에 올바르게 생성한 반면, Glimmer의 결과는 200줄에 못 미쳤다(전체 스레드).
"Qwen 3.6 27B와는 비교가 안 된다" - Reddit 사용자 BarberIcy366. Glimmer가 21,000토큰을 소비하고도 8-ball pool 게임용 HTML을 220줄만 생성한 뒤 남긴 평가다(r/LocalLLaMA). 같은 스레드에는 MTP를 활성화한 Qwen 3.6 27B가 Tetris 구현을 1.7배 더 빠르게 완료했다는 보고도 있다.
다만 Glimmer에는 분명한 강점도 있다.
- 컨텍스트 용량: 같은 F16 KV 설정에서 RTX 3090 한 장으로 Qwen의 70K 대비 262K 토큰을 지원한다. 대형 코드베이스 작업에서는 3.7배의 차이다.
- KV 캐시 효율: 16:1 GQA 비율 덕분에 KV 캐시가 훨씬 작으며, 그만큼 컨텍스트에 할당할 VRAM이 남는다.
- 비전 기능: Glimmer는 기본적으로 멀티모달 모델인 반면 Qwen 3.6 27B 기본 모델은 텍스트 전용이다.
- MCP 및 도구 Q&A: 한 사용자는 터미널 코딩에서는 Glimmer가 Qwen에 뒤처지지만, MCP를 활용한 코드베이스 검색과 질의응답 워크플로에서는 가능성을 보였다고 전했다.
- 글쓰기 품질: 여러 사용자가 Qwen보다 Glimmer의 자연어 출력 품질을 선호했다.
한 댓글은 이 선택지를 이렇게 요약했다. Glimmer는 "Qwen 3.6 27B에 글쓰기 스타일 5%를 더하고 에이전트 능력 5%를 뺀 모델"이다.
결론
주된 작업이 원샷 코딩이나 자율 터미널 에이전트라면 Qwen 3.6 27B가 여전히 더 나은 선택이다. TerminalBench 2.1에서 9점 높았고, OS 수준 자동화에서 Glimmer를 괴롭히는 안전성 거부 문제도 없다. 반대로 소비자용 GPU 한 장에서 긴 컨텍스트 검색, 멀티모달 입력 또는 MCP 보조 워크플로가 필요하다면 Muse Glimmer는 충분히 테스트할 가치가 있다. 신뢰도 높은 터미널 자동화가 필요하다면 커뮤니티 파인튜닝을 기다리는 편이 좋다.
알아둘 문제와 주의점
max_tokens 설정의 함정
Muse Glimmer는 출력을 만들기 전 내부 추론에 토큰 예산의 상당 부분을 사용한다. max_tokens를 너무 낮게 설정하면 사고 과정 중간에 예산이 소진돼 빈 응답이 돌아올 수 있다. 한 사용자는 처음에 평가 스위트에서 Glimmer를 6/13으로 측정했지만, 출력 토큰 예산을 높이자 11/13까지 올라갔다(원본 스레드). 추론 오버헤드를 감당할 만큼 max_tokens를 넉넉히 잡지 않으면 응답이 생각 도중 끊길 수 있다.
OS 수준 자동화에 대한 안전성 거부
여러 사용자는 Muse Glimmer가 마우스 제어, 키보드 자동화, 기타 OS 수준 도구 호출이 포함된 작업을 거부한다고 보고했다. 일반적인 Python 라이브러리를 사용하는 요청인데도 모델은 이를 잠재적인 보안 위험으로 판단한다.
"마우스를 프로그래밍 방식으로 움직이는 행위는 자동화, 클릭재킹 또는 보안 프롬프트 우회에 악용될 수 있습니다." - Reddit 사용자 Cold_Tree190이 보고한 Muse Glimmer의 거부 응답(r/LocalLLaMA)
의도한 사용 사례에 관한 정보를 더 제공한 새 세션에서는 거부가 해소되는 경우도 있다. 하지만 같은 세션에서 이미 한 차례 거절했다면, 모델은 대체로 기존 입장을 유지한다.
일관되지 않은 도구 호출
도구 호출 신뢰성에 관한 커뮤니티 보고는 C 코드베이스에서 "한 번도 실패하지 않았다"는 평가부터, 일부 설정에서 무한 루프와 빈 API 응답이 반복된다는 보고까지 엇갈린다. 특정 구성에서는 Unsloth Q4 및 Q5 양자화가 도구 호출 중 루프를 많이 일으킨다고 보고됐다. 반면 24 GB와 32 GB VRAM을 겨냥한 공식 GGUF는 더 안정적으로 동작할 수 있다(원본 스레드).
지역별 다운로드 제한
공식 Hugging Face 페이지는 홍콩, 마카오, 중국에서 다운로드를 비활성화한 것으로 알려졌다. 대안으로 Unsloth의 서드파티 GGUF 배포본은 계속 이용할 수 있다.
관련 글: Muse Spark 1.2 API 가격 가이드 | 2026년 프로그래밍용 최고의 무료 OpenRouter 모델