 AIREITER
멀티 벡터 임베딩은 정확도를 조금 더 얻는 대신 인덱스 크기를 크게 치르는 방식이다. Hugging Face가 2026년 8월 18일 발표한 Sentence Transformers 6.0은 Sentence Transformers에 MultiVectorEncoder를 추가하며 이를 정식 모델 유형으로 편입했다. 다만 출시 벤치마크는 과장보다 현실에 가깝다. 동일한 밀집 모델 쌍과 비교했을 때 레이트 인터랙션은 NanoBEIR 13개 데이터셋 중 9개에서 이겼지만, 평균 NDCG@10 차이는 약 1포인트였다. 반대로 예시 인덱스는 384차원 MiniLM 기준선보다 42배, 같은 급의 밀집 모델보다도 21배 컸다. 결국 이 비용을 감수할지는 쿼리와 문서의 성격이 결정한다.
멀티 벡터와 레이트 인터랙션의 작동 방식
멀티 벡터 모델은 문서 전체를 하나의 풀링 벡터로 압축하지 않는다. 토큰마다 벡터 하나를 남긴다. Hugging Face 지원 모델에서는 토큰 벡터가 관례적으로 128차원인 반면, 일반적인 밀집 임베딩은 384·768·1,024차원을 사용한다. 점수 계산 시에는 MaxSim 연산자가 각 쿼리 토큰과 가장 잘 맞는 문서 토큰의 내적을 고른 뒤, 그 최대값을 모두 더한다. MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). 이 모델들은 L2 정규화를 적용하므로 각 항은 [-1, 1] 범위에 있고, 최종 점수는 쿼리 길이에 따라 커진다.
레이트 인터랙션은 다음 두 구조의 중간 지점에 있다.
| 아키텍처 | 문서 측 표현 | 점수 계산 | 비용 특성 |
|---|---|---|---|
| 밀집 바이인코더 | 사전 계산한 풀링 벡터 하나 | 단일 내적 | 검색이 가장 빠르지만 풀링 과정에서 토큰 세부 정보가 사라진다 |
| 레이트 인터랙션 | 사전 계산한 토큰별 벡터 | 토큰 쌍 전체의 MaxSim | 매칭 표현력은 높지만 문서 길이에 따라 인덱스가 커진다 |
| 크로스인코더 | 사전 계산 없음 | 쿼리-문서 쌍마다 전체 순전파 | Hugging Face 출시 글 기준 쌍 단위 정확도는 가장 높지만 1차 검색에는 비용이 너무 크다 |
원조 ColBERT 논문은 이 접근을 ‘문맥화된 레이트 인터랙션’으로 정식화했다.
장점은 토큰 수준에서 드러난다. Hugging Face의 lightonai/mLateOn 예시에서 쿼리 토큰 "live"는 문서 토큰 "inhabit"와 0.94의 유사도로 연결됐다. 표면적인 단어 중복은 없지만 의미적으로는 맞아떨어지는 사례다.
멀티 벡터가 특히 강한 검색 시나리오
짧은 패시지 중심 벤치마크만 보면 멀티 벡터의 강점을 충분히 보기 어렵다. 이 글에서 비교한 다섯 자료, 즉 Hugging Face 출시 글, TopK, Qdrant의 엔지니어링 글, Data AI Hub의 프로덕션 가이드, Suhas Bhairav의 프로덕션 검색 비교에서는 다음 상황이 반복해서 핵심 사례로 꼽힌다.
- 의미 검색 안의 정확한 식별자. 제품 코드, 함수명, 성씨, 오류 문자열, 조항 번호처럼 풀링 벡터가 뭉개기 쉬운 정보를 토큰 단위로 유지한다.
- 조건이 여러 개인 쿼리. "Y와 Z를 갖춘 X"처럼 여러 조건이 있는 경우, 각 쿼리 토큰이 독립적으로 근거 문서 토큰을 찾는다. 특정 조건이 평균화되어 사라질 가능성이 줄어든다.
- 답이 문서 일부에만 있는 긴 문서. 다국어 장문서 벤치마크 MLDR에서 멀티 벡터
mLateOn은 77.92,mDenseOn은 51.59를 기록했다. 짧은 패시지 평균보다 한 자릿수 이상 큰 격차다. - PDF, 표, 스캔 문서. ColPali 계열은 텍스트 쿼리로 페이지 이미지를 직접 인덱싱하므로 OCR을 건너뛸 수 있다. Hugging Face 출시 글은 시각 문서 검색을 레이트 인터랙션의 최첨단 영역으로 꼽았고, TopK의 분석은 소형 멀티 벡터 검색기가 자기보다 80배 큰 단일 벡터 모델보다 ViDoRe v3에서 재현율이 +34% 높았다고 전한다. 산업 문서 재현율도 약 42%에서 76%로 올랐다.
- 도메인 밖의 어휘. Hugging Face 출시 글은 아웃오브도메인 데이터에서의 향상을 보고했다. 밀집 모델의 학습된 압축 과정에서 실제 프로덕션 쿼리에 필요한 세부 정보가 빠질 수 있는 영역이다.
시각 검색에 레이트 인터랙션이 잘 맞는 이유는 Hugging Face 수치에서도 보인다. 렌더링한 페이지 하나는 colqwen2.5-v0.2에서 약 755개의 토큰 벡터를 만든다. 평균 텍스트 패시지는 약 125개다. 차트, 레이아웃, 표처럼 페이지 정보가 풍부할수록 단일 풀링 벡터가 버려야 할 정보도 많아진다.
품질 향상은 분명하지만, 기대만큼 압도적이진 않다
가장 깔끔한 비교 대상은 LightOn의 짝 모델인 LateOn과 DenseOn이다. 두 모델은 모두 1억 4,900만 파라미터 ModernBERT 백본과 동일한 학습 데이터를 사용한다. 차이는 헤드뿐이다. 하나는 128차원 토큰 벡터를 만들고, 다른 하나는 768차원 문서 벡터 하나를 만든다.
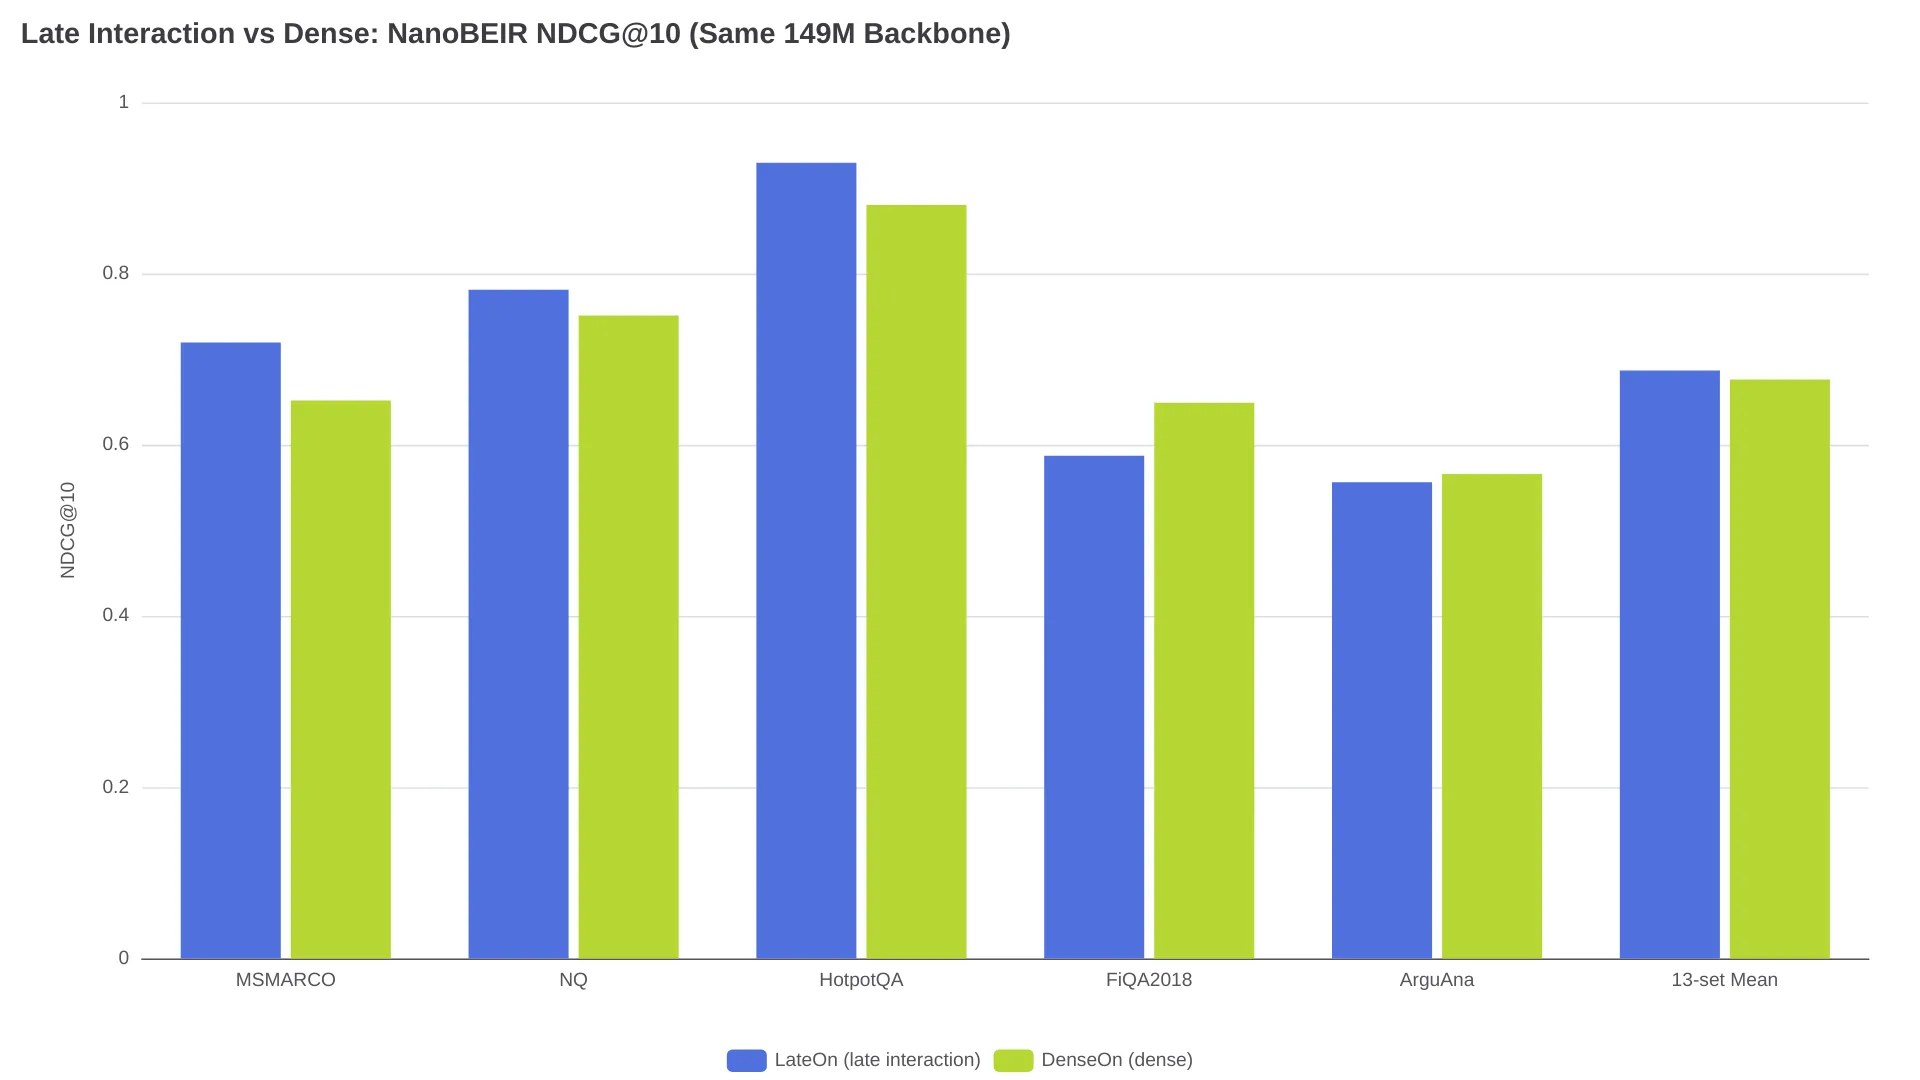
LateOn은 NanoBEIR 13개 데이터셋 중 9개와 평균 점수에서 승리했다. 평균 NDCG@10은 0.6868 대 0.6764다. 전체 15개 데이터셋 BEIR에서는 57.22 대 56.20이다. 다만 ArguAna, FiQA2018, SCIDOCS, SciFact에서는 DenseOn이 명확히 앞섰다. 같은 모델 크기에서 의미 있는 평균 향상이 있다는 결과이지, 완전히 다른 급의 성능이라는 뜻은 아니다.
메인테이너 Tom Aarsen이 v6.0을 발표한 뒤 개발자 @saen_dev는 현업에서 반복되던 질문을 던졌다. “도메인 특화 코퍼스에서는 바이인코더와 비교해 성능이 어떤가?” (스레드) 솔직한 답은 평균 약 1포인트이며, 큰 폭의 개선은 장문서에 집중된다는 것이다. Hugging Face 역시 데이터셋별 효과가 다르므로 각자의 검색 과제에서 평가하라고 권한다.
압축 전 인덱스 비용: 최대 42배
Hugging Face는 Natural Questions 패시지 4,874개를 대상으로 인덱스 크기를 계산했다. lightonai/LateOn은 여기서 608,414개의 토큰 벡터를 생성했다. 패시지당 평균 124.8개다.
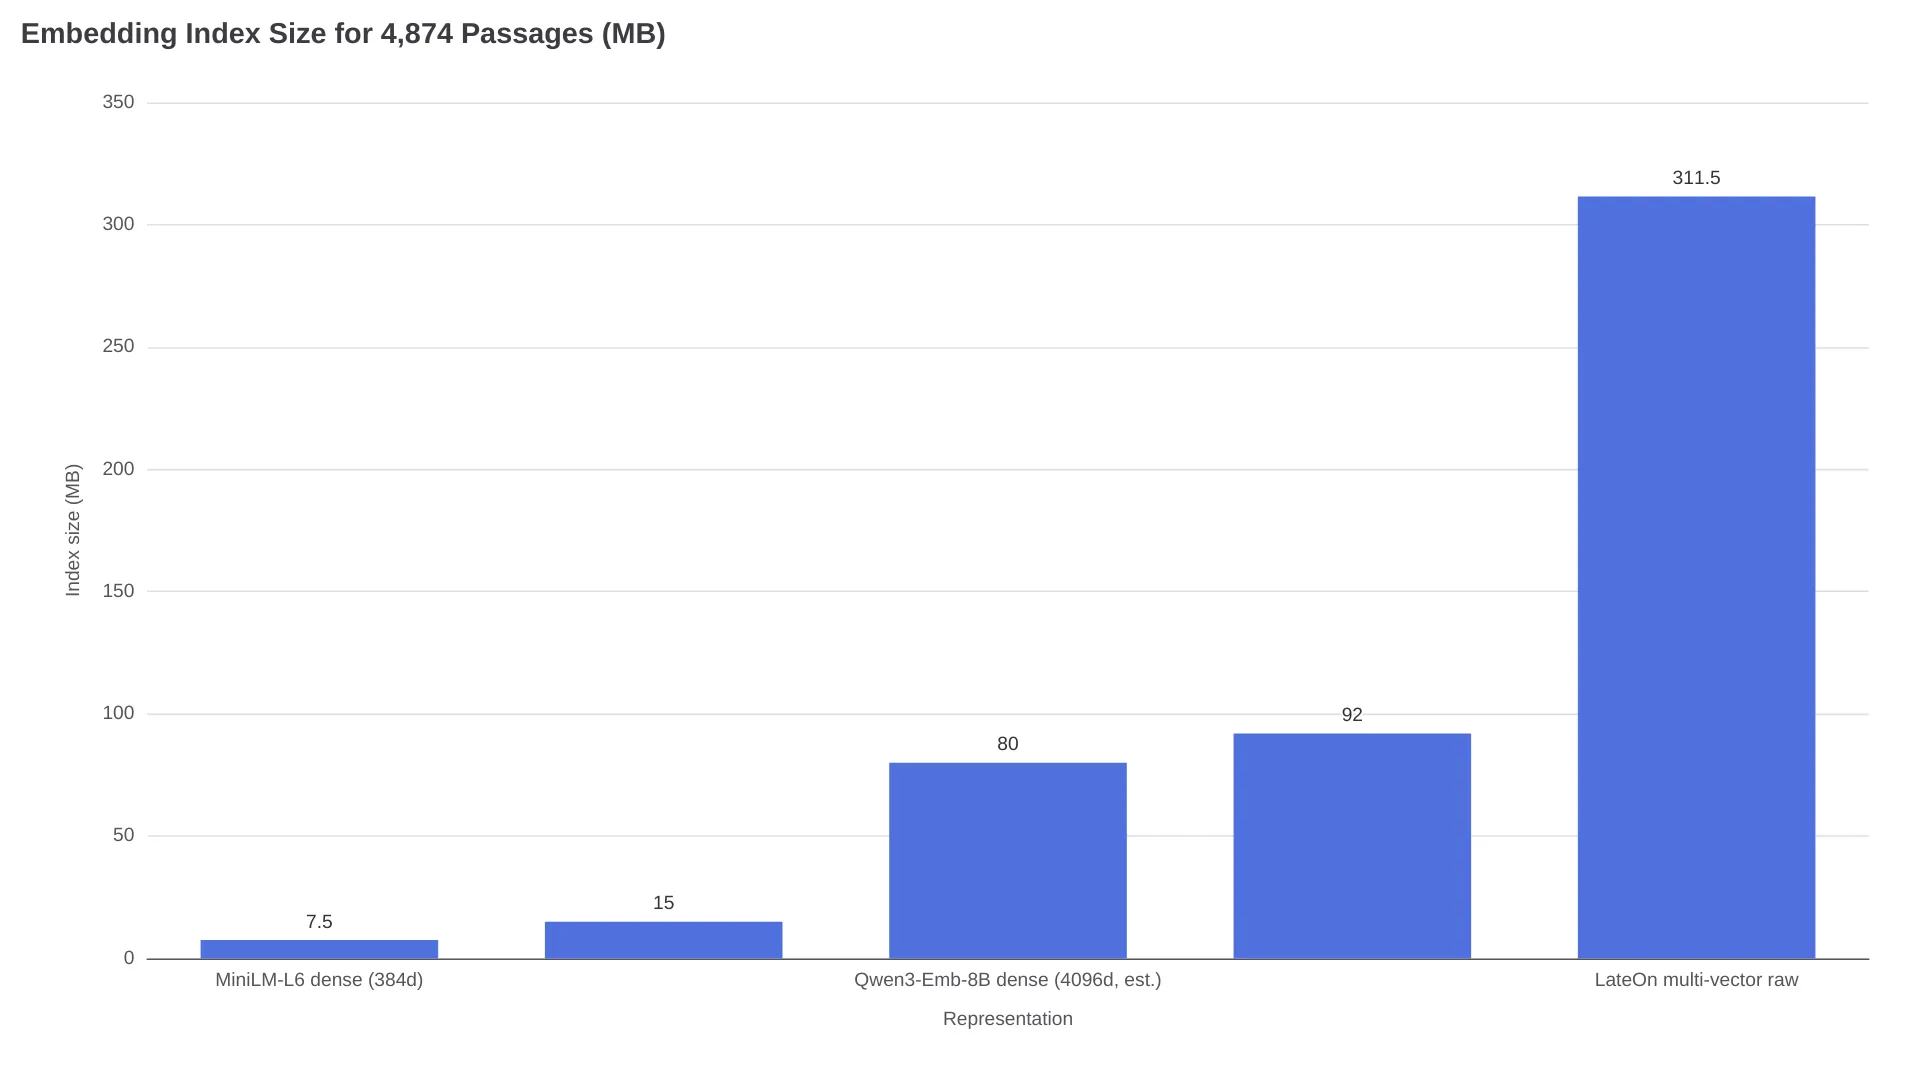
원시 float32 멀티 벡터 인덱스는 311.5MB다. 같은 패시지를 all-MiniLM-L6-v2로 밀집 임베딩하면 7.5MB면 된다. 42배 차이이며 패시지당 62KiB다. 같은 급의 768차원 밀집 모델 gte-modernbert-base와 비교해도 21배 차이인 15MB다. TopK는 문서 길이와 정밀도에 따라 10~100배 범위를 언급하며, 쿼리당 점수 계산량은 단일 벡터 비교보다 수천 배 많을 수 있다고 추산한다.
출시 당일 한 개발자는 프로덕션 관점을 이렇게 요약했다.
토큰 풀링이 실제 배포를 좌우하는 부분이다. 레이트 인터랙션은 정확도보다 인덱스 크기와 메모리에서 먼저 죽는 경우가 많다. - X의 @JudeJobs
규모 감각을 위해 덧붙이면, 동일 코퍼스에 대한 4,096차원 Qwen3-Embedding-8B 밀집 인덱스는 약 80MB다. 아래에서 볼 압축 레이트 인터랙션 인덱스 92MB와 비슷한 수준이다.
인덱스를 줄이는 세 가지 방법
1. 토큰 풀링. Sentence Transformers v6.0에는 HierarchicalTokenPooling이 포함됐다. 코사인 거리를 기준으로 Ward linkage를 사용해 문서 토큰 벡터를 클러스터링하고, 각 클러스터를 평균 벡터 하나로 대체한다. 기본값은 문서에만 풀링을 적용한다. 쿼리는 짧고 왜곡에 민감하기 때문이다. 608,414개 벡터 코퍼스의 결과는 다음과 같다.
| 풀링 배수 | 토큰 벡터 수 | float32 인덱스 | 보고된 검색 성능 유지율 |
|---|---|---|---|
| 1 (없음) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | 약 98% 추세 |
전체 코퍼스 풀링에는 약 6초가 걸렸다. LightOn의 정규화 변형 모델은 Hugging Face 글에서 5배 압축 시 품질 99.4%를 보고했다. 다만 v6.0 출시 시점에는 이 정규화 항을 적용한 학습이 라이브러리에 아직 통합되지 않았다고 Hugging Face는 밝힌다.
2. 압축 인덱스. 같은 벡터로 만든 fast-plaid Rust PLAID 인덱스는 92MB이며, 구축에는 5초가 걸렸다. RTX 3090 + i7-13700K에서 응답 시간은 11ms다. 근사 방식이므로 Hugging Face 테스트에서는 최상위 점수가 11.92에서 11.88로 달라졌지만 순위는 유지됐다. Weaviate의 MUVERA는 적재를 3배, 쿼리를 1.8배 빠르게 했지만 테스트 코퍼스에서는 정답 하나가 상위 50개에서 빠졌다.
3. 양자화와 추론 최적화. Qdrant는 토큰 임베딩에 uint8 스칼라 양자화를 적용해 메모리를 4배 줄였다. SciFact NDCG@10은 0.70724에서 0.70297로 움직이는 데 그쳐 손실은 미미했다. Hugging Face는 fp16과 Flash Attention 조합이 측정 가능한 품질 손실 없이 fp32 대비 2.44배의 인코딩 처리량을 낸다고 보고했으며, CPU에서 int8을 쓰면 정확도 비용은 약 0.4%다.
풀링 배수 2~3과 압축 인덱스를 함께 적용하면 밀집 모델 대비 실질 격차는 42배에서 한 자릿수까지 줄어든다. 대신 튜닝할 파라미터가 두 개 더 생긴다.
기본 배포 구조는 리랭커 우선이다
단일 RTX 3090에서 4,874개 문서 전체에 MaxSim을 수행하면 98ms, 엔드투엔드로는 122.7ms가 걸렸다. 문서가 수천 개라면 충분히 실용적이지만, 수백만 개에서는 선형 비용이 문제가 된다. 여기서 비교한 세 배포 가이드는 모두 같은 구조로 수렴한다. 저렴한 밀집 또는 희소 검색으로 후보를 먼저 뽑고, 레이트 인터랙션으로 재정렬하는 방식이다.
- Hugging Face 예시. 밀집 검색 상위 50개를 가져온 뒤 MaxSim으로 리랭킹한다. 문서는 한 번 배치 인코딩하고 행렬 곱으로 점수를 계산하므로, 쿼리-문서 쌍마다 순전파를 수행하는 크로스인코더보다 훨씬 저렴하다.
- Qdrant. v1.10부터 네이티브 멀티 벡터를 지원하는 Qdrant는 전체 스캔보다 수백 개 후보를 리랭킹하는 용도를 우선 권장한다.
- Data AI Hub 프로덕션 가이드. 하이브리드 검색으로 상위 150개를 가져오고, 레이트 인터랙션으로 20개까지 리랭킹한 뒤, 필요하면 최종 5개에 크로스인코더를 적용해 LLM으로 넘기는 구성을 권한다.
리랭커 전용 패턴에는 분명한 한계가 있다. 1차 단계가 놓친 문서는 되살릴 수 없다. 게다가 주변 파이프라인의 정답도 아직 정해지지 않았다.
보편적으로 좋은 청킹, 검색, 리랭킹 전략은 거의 없다. - u/gamerx88, r/MachineLearning
멀티 벡터를 지원하는 데이터베이스와 실제 성능
Hugging Face 출시 글은 같은 4,874개 패시지 코퍼스에서 주요 엔진을 비교했다. 아래 숫자는 벤더 마케팅이 아니라 해당 테스트의 결과다.
| 엔진 | 네이티브 멀티 벡터 지원 시점 | 적재 / 쿼리 (해당 테스트) | 주의할 점 |
|---|---|---|---|
| Qdrant | v1.10 | 26.3초 / 18ms | 정확한 MAX_SIM 지원, 서버 사용 권장 |
| Weaviate | v1.29 | 41초 / 17ms | MUVERA는 더 빠르지만 정답 하나를 놓쳤고, Windows 임베디드 모드는 없다 |
| Vespa | "수년 전부터" | 약 80초 / 웜 상태 75ms | 텐서 표현식으로 MaxSim 구현, 기본 2단계는 후보 100개만 리랭킹해 정답 상위 3개 중 2개를 놓쳤다 |
fast-plaid | - | 5초 / 11ms | 서버 없음, 근사 점수지만 순위는 유지 |
| LanceDB | v0.15.0 | 벤치마크 없음 | 네이티브 MaxSim |
| Milvus | v2.6.4 | 벤치마크 없음 | array-of-structs 스토리지 |
| VectorChord | - | 벤치마크 없음 | PostgreSQL용 MaxSim 연산자 |
| Elasticsearch / OpenSearch | - | - | 리스크ोर 전용, ES 기능은 Enterprise 티어의 기술 미리보기다 |
Hugging Face 비교 표에서 turbopuffer의 레이트 인터랙션 인덱싱은 프라이빗 베타로 표기됐다.
Sentence Transformers v6.0에서 달라진 점
2026년 8월 18일 이전에는 ColBERT 계열을 돌리려면 PyLate, Stanford ColBERT 리포지터리, colpali-engine처럼 별도 프레임워크를 써야 했다. 6.0은 MultiVectorEncoder를 라이브러리의 네 번째 정식 모델 유형으로 올렸고, 학습·추론·해석 기능을 내장했다. Sentence Transformers, PyLate, Stanford ColBERT, ColPali 체크포인트를 불러올 수 있다. 기본 transformer도 로드할 수 있지만, 이 경우 투영층이 무작위 상태이므로 학습이 필요하다. 요구 사항은 transformers v5.x, torch 2.2+, huggingface-hub v1.x다.
출시 문서에서 특히 주의할 세 가지 함정은 다음과 같다.
- 쿼리와 문서는 비대칭이다.
encode_query()와encode_document()는 서로 다른 프롬프트, 길이 제한, 점수 마스크를 적용한다. 둘 다 범용encode()로 처리하면 결과가 조용히 나빠질 수 있다. - 잘림은 조용히 발생한다. 662토큰 패시지를 LateOn의 문서 길이 제한 300토큰으로 넣으면 273개 벡터가 생성되고 나머지는 버려진다. 제한을 512로 늘릴 수는 있지만 모델의 학습 분포에서 멀어지고 인덱스도 커진다.
- Flash Attention에는 예외가 있다.
colbert-ir/colbertv2.0,answerai-colbert-small-v1처럼 non-attend 쿼리 확장을 사용하는 모델은 대신"sdpa"가 필요하다.
Hugging Face가 공개한 점수 기준으로 지원 모델 범위는 두 자릿수 규모 차이에 걸쳐 있다.
| 등급 | 예시 모델 (파라미터 수) | 점수 (평균 NDCG@10) |
|---|---|---|
| 엣지 텍스트 | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| 소형 텍스트 | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| 텍스트 선두 | LateOn 계열 (149M) | 0.6868–0.6897 NanoBEIR |
| 시각 문서 | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
단일 벡터 밀집 임베딩이 여전히 맞는 경우
피해야 할 실수는 멀티 벡터가 필요 없는 워크로드까지 도입하는 것이다. 쿼리가 "공급망 관련 기사"처럼 넓은 주제 중심이거나, 텍스트가 제목·FAQ 쌍·트윗처럼 짧거나, 클러스터링·중복 제거·추천처럼 항목 전체의 유사도가 필요한 작업이라면 멀티 벡터를 건너뛰는 편이 낫다. 밀집 검색과 리랭커 조합이 이미 재현율 SLO를 충족하고 비용이 병목이라면 더더욱 그렇다. Data AI Hub 가이드도 영어 중심 ColBERT 체크포인트는 다국어 코퍼스에서 다국어 바이인코더와 리랭커 조합보다 성능이 떨어질 수 있으며, 쓰기 빈도가 높고 실시간성이 중요한 코퍼스는 토큰 단위 인덱스와 맞지 않는다고 지적한다.
숫자로 답하는 자주 묻는 질문
일반 밀집 모델을 멀티 벡터 모델처럼 쓸 수 있나?
의외로 잘 되는 경우가 있다. Qdrant는 3,300만 파라미터 밀집 모델 BAAI/bge-small-en의 출력 토큰 임베딩을 MaxSim으로 점수화했다. SciFact에서 NDCG@10 0.73696을 기록해 colbert-ir/colbertv2.0의 0.69579와 bge-small 자체의 풀링 벡터 0.68213을 앞섰다. ArguAna에서는 순서가 뒤집혀 풀링 밀집 모델이 이겼다. 새 모델 없이 리랭킹 단계를 더할 수 있는 유효한 방법이지만, 항상 통하는 보장은 아니다.
압축 멀티 벡터 인덱스는 얼마나 빨라지나?
4,874개 패시지 코퍼스에서 전체 MaxSim은 98ms, fast-plaid는 11ms였다. 인덱스 크기는 311.5MB에서 92MB로 줄었다.
멀티 벡터 모델이 크로스인코더 리랭커를 대체하나?
비용 측면에서는 그렇다. 문서 표현을 미리 계산해 두고 행렬 곱으로 점수화하므로, 쿼리-문서 쌍마다 순전파를 실행할 필요가 없다. 다만 Hugging Face 출시 글은 쌍 단위 정확도에서 크로스인코더를 여전히 가장 정확한 선택지로 평가한다. 품질 요구가 높은 파이프라인이 최종 상위 5~20개에 크로스인코더를 유지하는 이유다.
RAG에 레이트 인터랙션을 쓸 만한가?
하이브리드 또는 밀집 검색 후보를 대상으로 한 리랭킹 단계라면 그렇다. 앞서 언급한 세 배포 가이드가 모두 권하는 패턴이다. 1차 검색기로 쓰는 경우는 측정 결과 1차 재현율 부족이 실제 실패 원인이고, 토큰 벡터 인덱스 비용이 예산에 들어올 때에 한정하는 편이 좋다.
워크로드별 선택 가이드
| 워크로드 | 권장 선택 |
|---|---|
| 식별자가 많거나 조건이 복합적인 쿼리, 긴 문서, 법률·기술 문서 | 멀티 벡터 검색 또는 리랭킹 — MLDR에서 +26포인트가 나온 영역이다 |
| PDF, 스캔 페이지, 표, 차트가 페이지 이미지로 있는 문서 | ColPali 계열 멀티 벡터 — OCR 파이프라인이 필요 없다 |
| 넓은 주제 검색, 짧은 텍스트, 클러스터링·중복 제거·추천 | 단일 벡터 밀집 임베딩 — 이 경우 풀링 손실은 중요하지 않다 |
| 품질은 거의 충분하지만 예산이 빠듯한 경우 | 밀집 1차 검색은 유지하고 상위 50~150개에 MaxSim 리랭킹을 추가 |
| 수백만 문서, 비용이 핵심 제약인 경우 | 밀집 + 크로스인코더 리랭커, 또는 측정 후 압축 레이트 인터랙션(풀링 배수 2~3 + fast-plaid) |
@JudeJobs가 지적한 미해결 과제는 여전히 남아 있다. 압축 후 성능 유지율은 벤치마크에서 측정된 값이지, 복잡한 프로덕션 코퍼스에서 검증된 값은 아니다. 우선 풀링 배수 2부터 적용하고, 이후에는 자체 데이터에서 측정한 재현율로 압축 곡선을 어디까지 내려갈지 결정하는 편이 낫다.