 AIREITER
파일 크기는 똑같은데 성능은 전혀 다를 수 있다. 2026년 8월 19일, Liquid AI는 LFM2.5-2.6B 저장소에 기존 파일과 나란히 1.59GB짜리 Q4_0 파일을 하나 더 올렸다. 이름도 거의 비슷하다. 하지만 새 파일은 양자화 인식 증류(QAD)를 적용한 모델이다. 4비트 양자화로 잃는 품질 대부분을 되찾았고, 공식 수치도 꽤 좋다. 문제는 두 파일 중 잘못 고르면 아무런 보정이 없는 구형 버전을 실행하게 된다는 점이다.
QAD는 모델 내부에서 무엇을 바꾸나
QAD는 quantization-aware distillation, 즉 양자화 인식 증류를 뜻한다. Liquid AI는 LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct, LFM2.5-2.6B 등 네 모델을 Q4_0 반올림 오차에 맞춰 학습했다. 고정밀 교사 모델이 학습 중 양자화된 학생 모델을 가르치기 때문에, 가중치가 양자화 오차를 미리 예상하고 그 영향을 줄이는 방향으로 적응한다.
같은 저장소에 남아 있는 기존 Q4_0 파일은 일반적인 사후 학습 양자화(PTQ) 방식이다. 완성된 BF16 모델을 나중에 낮은 정밀도로 변환할 뿐, 그 과정에서 생긴 오차를 보정하는 학습은 없다. Liquid AI의 출시 글에 따르면 네 QAD 체크포인트는 추론, 지시 따르기, 도구 사용, 에이전트 동작 등을 포함한 평가 묶음에서 BF16 평균의 “약 97%에 도달”했다. 수치는 다섯 번 실행한 결과의 평균이다. QAD는 새로운 파일 형식이 아니라 학습 방식의 변화다. 결과물은 llama.cpp가 그대로 실행할 수 있는 표준 GGUF Q4_0 파일이다.
파일명 함정과 정확한 실행 명령어
LFM2.5-2.6B 저장소에는 LFM2.5-2.6B-Q4_0.gguf와 LFM2.5-2.6B-QAD-Q4_0.gguf가 모두 올라와 있으며, 둘 다 1.59GB로 표시된다. 게다가 저장소의 기본 코드 스니펫은 QAD가 아닌 Q4_K_M을 가리킨다. 그대로 복사해 설치하면 QAD 파일은 내려받지 않는다. 파일명을 직접 지정해야 한다.
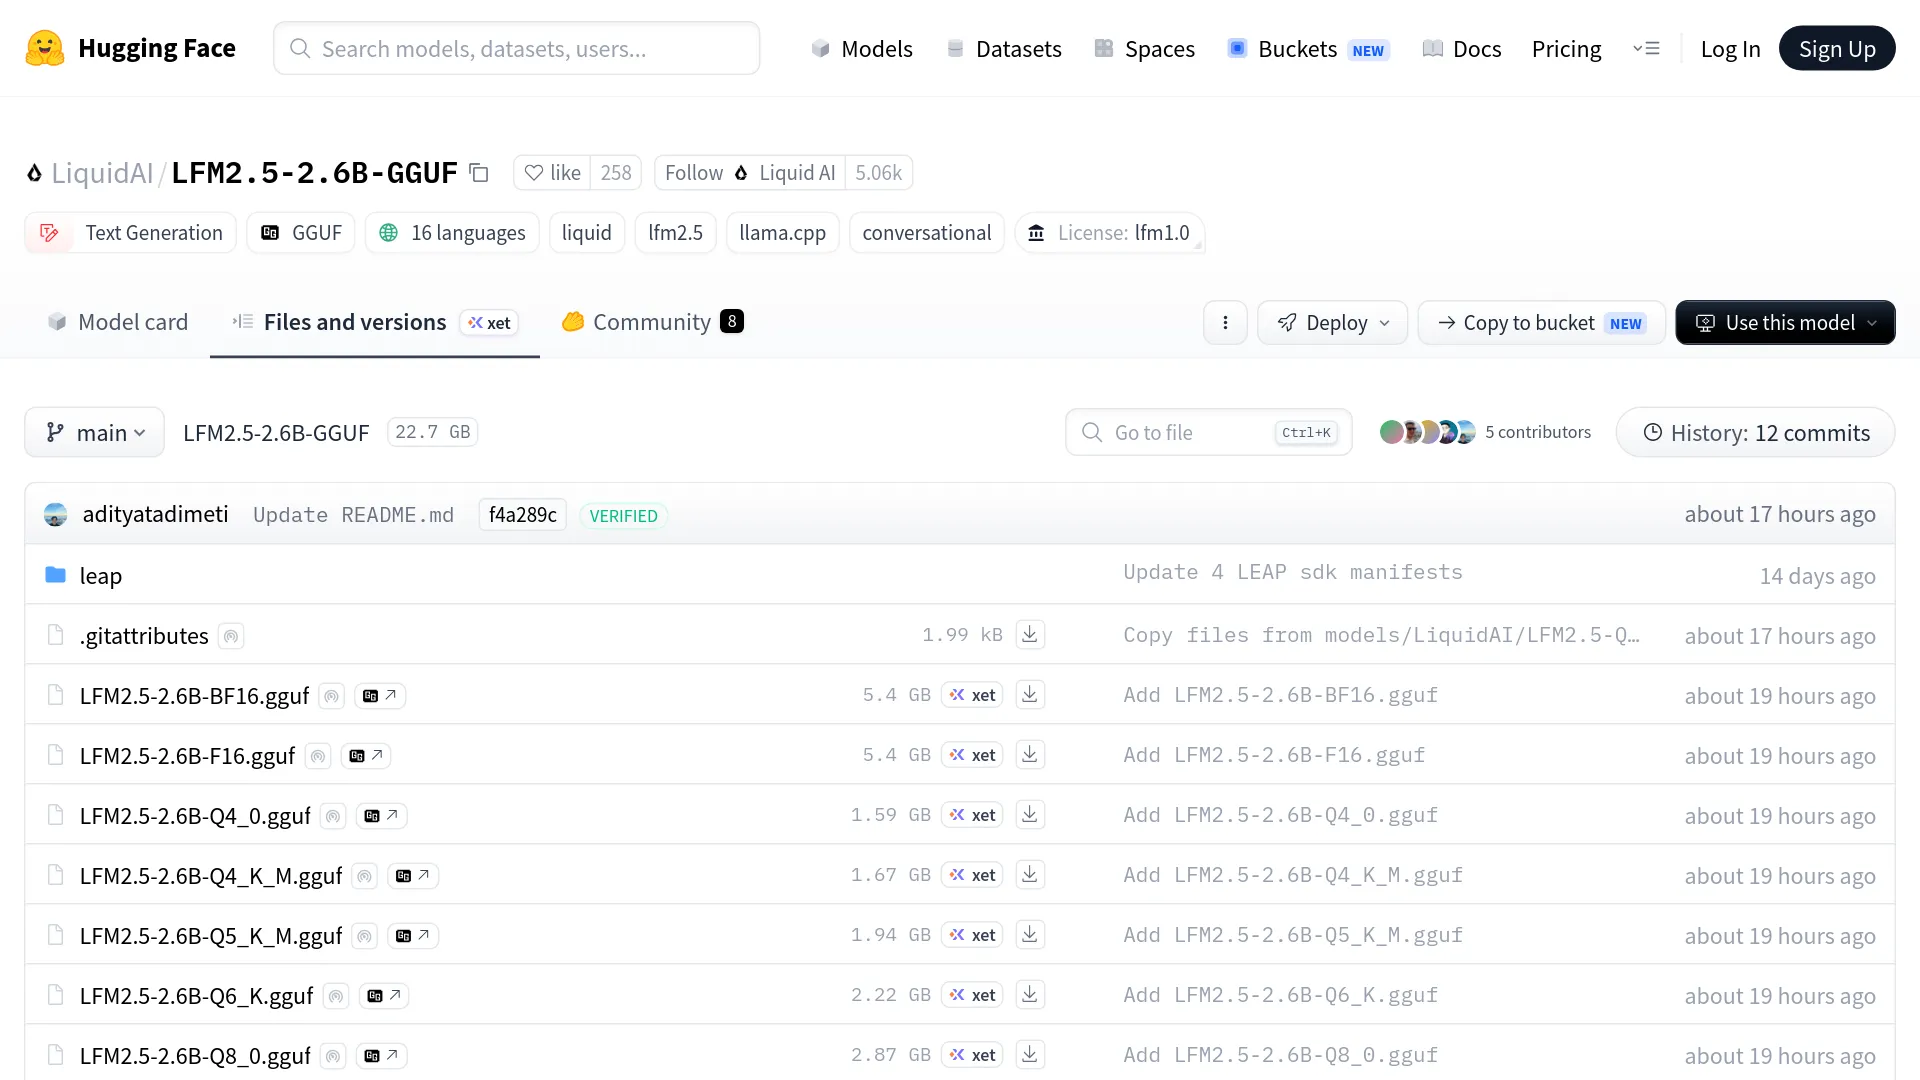
출시 후 몇 시간 만에 이런 혼란이 커뮤니티에 등장했다.
“어디서 다운로드하나요? Hugging Face에서 파일은 보이는데 일반 버전인지 QAD인지 모르겠습니다. 방법을 알려주실 수 있을까요?” - X의 @Chitacc72
초기 사용자 중 한 명인 @MarMarLabs는 저장소의 파일을 비교한 뒤 기존 Q4_0과 새 Q4_0의 크기 차이가 약 4KB에 불과하다고 확인했다. 파일 브라우저만으로는 구분하기 어려운 수준이다. 해결책은 --hf-file에 QAD 파일명을 정확히 넣는 것이다.
# official example from Liquid AI's release post
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, with the sampling flags from the official model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
230M과 1.2B-Instruct 저장소에도 같은 --hf-file 방식을 적용하면 된다. 서버에서 실행할 때는 HF가 자동 생성한 명령어가 불완전하다는 사실을 확인한 @nicolasembleton가 다음과 같은 축약형을 공유했다. llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. 콜론 뒤의 한정자가 QAD 빌드를 선택한다.
공식 수치가 말하는 것과 말하지 않는 것
Liquid AI의 벤치마크 표를 보면 각 QAD 체크포인트는 BF16 기준 품질의 96.5~97.4%를 유지한다. 평가에는 GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF, BFCLv4가 포함됐고, 작은 두 모델에는 GSM8K, 큰 두 모델에는 AIME25가 추가됐다. 모든 수치는 다섯 번 실행한 평균이다.
| 체크포인트 | 유지한 BF16 품질 | 품질 비교 | 디코드 처리량 |
|---|---|---|---|
| LFM2.5-230M | 97.1% | 분산 범위 내에서 Q5_K_M과 동일 | Q5_K_M 대비 +4~33% |
| LFM2.5-350M | 96.5% | 분산 범위 내에서 Q5_K_M과 동일 | Q5_K_M 대비 +4~33% |
| LFM2.5-1.2B-Instruct | 97.4% | Q4_K_M과 동일 | Q4_K_M 대비 +3~14% |
| LFM2.5-2.6B | 96.6% | Q4_K_M과 동일 | Q4_K_M 대비 +3~14% |
처리량은 네 가지 환경에서 측정됐다. GPU 환경은 MacBook Pro와 NucBox EVO-X2, Arm CPU 환경은 Samsung Galaxy S26 Ultra와 Raspberry Pi 5다. 230M과 1.2B 모델의 경우 Liquid AI는 QAD Q4_0이 강력한 외부 PTQ 체크포인트라고 소개한 Unsloth의 UD-Q4_K_XL과도 같은 수준이라고 밝혔다.
다만 출시 글에는 벤치마크별 점수, 기기별 실제 초당 토큰 수, 파일 크기, RAM 사용량, 오차 막대가 없다. 공개된 것은 백분율 범위와 동급이라는 주장뿐이다. 커뮤니티에서는 곧바로 용량 계산이 나왔다.
“그러니까 로컬 LFM2.5-2.6B를 F16에서 QAD Q4_0으로 바꾸면 5.4GB에서 1.6GB로, 21에서 64tok/s로 바뀌면서 BF16 성능의 약 97%를 유지한다는 말인가요?” - 출시 차트를 읽은 @firedUp_Neyu
용량 계산은 맞다. 공식 저장소에서 F16은 5.4GB, QAD Q4_0은 1.59GB다. 다만 tok/s 수치는 Liquid AI가 텍스트로 직접 제시한 값이 아니라 해당 사용자가 차트를 보고 해석한 결과다.
출시 글에서 빠진 세 가지
이 파일로 배포 환경을 바꿀지 판단하려면 다음 세 가지 공백을 염두에 둬야 한다.
지원 모델은 정확히 네 개다. 출시 시점 기준으로 LFM2.5-VL-450M이나 LFM2.5-8B-A1B용 QAD 빌드는 없다. X의 출시 스레드에서는 사용자들이 Liquid AI에 8B 버전을 요청하고 있다. 대상 기기가 이 모델 중 하나라면 현재 QAD가 바꾸는 것은 없다.
imatrix 적용 여부는 아직 논쟁 중이다. QAD 파일은 Q4_0에 맞춰 학습됐지만 중요도 행렬(imatrix) 없이 만들어졌다. 양자화 관련 커뮤니티는 이 점을 곧바로 지적했다.
“QAD Q4_0 GGUF는 imatrix 없이 만들어졌습니다. imatrix가 있었다면 QAD 학습 모델의 품질에도 도움이 됐을 겁니다.” - u/Chromix_, r/LocalLLaMA
3B 미만 모델의 한계가 사라지는 것은 아니다. 양자화 복구는 모델의 능력 상한을 높여주지 않는다. LocalLLaMA 스레드에도 관련 사례가 있다. 한 NPU 사용자는 다음과 같이 말했다.
“회의 요약을 위해 NPU에 LFM2.5 2.6B를 막 구현했습니다. 크기를 생각하면 인상적이지만, 큰 모델이 만드는 요약과 비교하면 결과가 훨씬 나쁩니다.” - u/DerDave
이 한계는 양자화가 아니라 모델 자체의 문제다. KikoCis 양자화 보고서에서는 Q8_0에서도 SWE-bench Verified 6개 중 해결된 사례가 0개였다. 1.2B 사용자는 실행 환경에 따라 품질이 크게 달라진다고 보고했다. 한 Ollama 설정에서는 프롬프트 10개 중 9개가 횡설수설했지만, 다른 환경에서는 싱글보드 컴퓨터에서 5W 미만으로 실용적인 동작을 보였다. 특정 작업에서 최첨단 수준의 품질이 필요하다면 저렴한 LLM API로 큰 모델에 출력을 교차 확인하는 편이 낫다. 전체 테스트 세트를 돌려도 비용은 몇 센트 수준이다.
QAD Q4_0과 Q4_K_M, 어떤 파일을 받을까
이 네 체크포인트를 llama.cpp로 실행하면서 RAM이 빠듯하다면, 우선 테스트할 4비트 기본값은 QAD Q4_0이다. 일반 Q4_0과 같은 1.59GB 용량이지만, 1.2B와 2.6B에서는 Q4_K_M 수준의 품질을, 230M과 350M에서는 Q5_K_M 수준의 품질을 목표로 학습됐다. 디코드 속도는 각각 3~14%, 4~33% 빠르다는 것이 Liquid AI의 주장이다. 이미 Q4_K_M을 여유 있는 RAM으로 돌리고 있다면 굳이 바꿀 필요는 없다. 80MB가 해결해야 할 문제라면 QAD가 답이 아닐 수 있다.
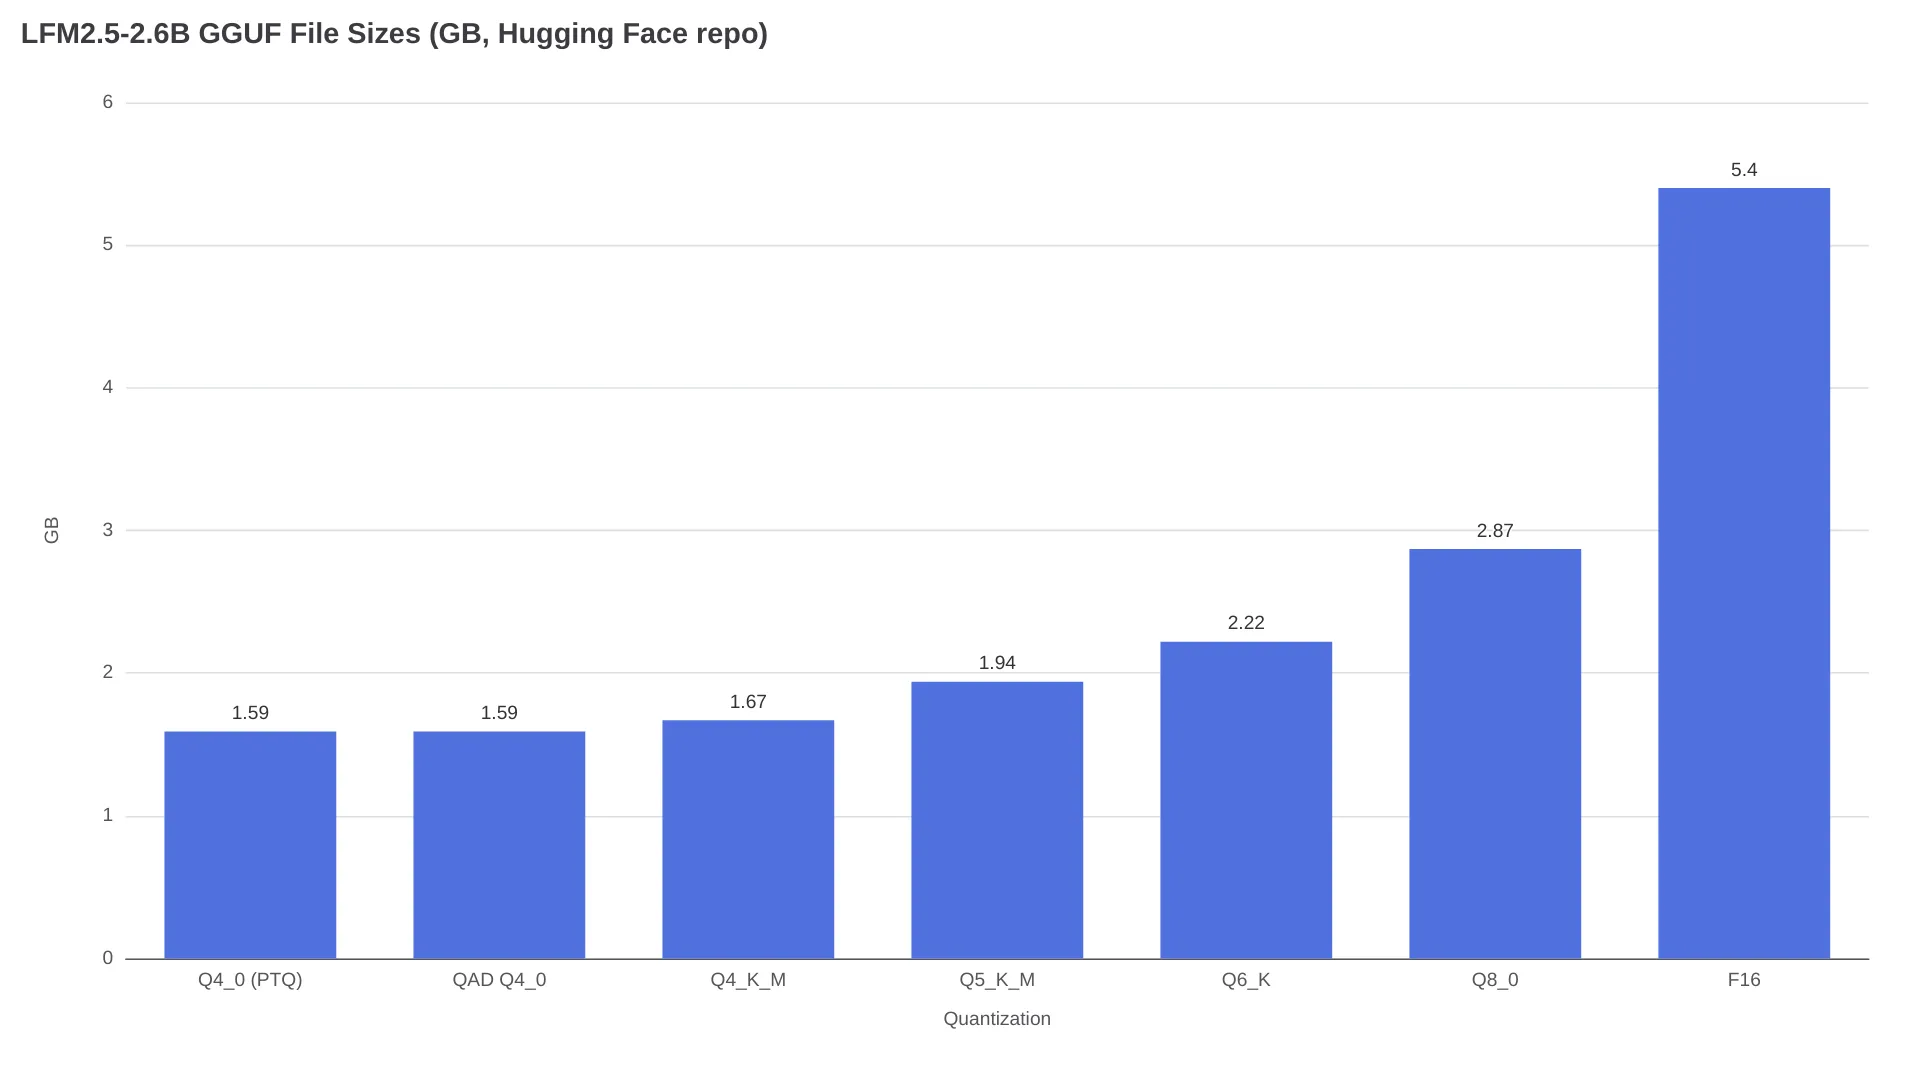
| 파일(2.6B) | 크기 | 포지션 | 이럴 때 선택 |
|---|---|---|---|
| Q4_0(기존 PTQ) | 1.59GB | 보정 없는 기준선 | 이제 QAD가 있으므로 피한다 |
| QAD Q4_0 | 1.59GB | BF16의 96.6%, Q4_K_M과 동일 | RAM 3~4GB, CPU 디코드, 스마트폰, Pi |
| Q4_K_M | 1.67GB | Liquid 문서의 기본 선택 | 실행 환경에서 QAD 파일을 선택할 수 없을 때 |
| Q5_K_M | 1.94GB | KikoCis 기준 F16 대비 top-1 91.4% | RAM 6GB 이상 |
| Q6_K / Q8_0 | 2.22 / 2.87GB | 무손실에 가까움 | RAM 8GB 이상, 품질 우선 |
이 품질 비교를 해석할 때는 맥락이 필요하다. KikoCis의 PTQ 단계별 측정에서 이 모델의 F16 대비 top-1 토큰 일치율은 Q4_K_M이 84.36%, Q6_K가 95.07%, Q8_0이 98.23%였다. Liquid AI의 주장은 QAD가 같은 파일 용량으로 4비트 품질 격차를 줄인다는 것이다. 다섯 번 실행한 자체 수치이며, 아직 독립적인 재현 결과는 없다. 출시 당일 논의에서 나온 설명은 다음과 같다.
“Q4_0이 K-quant보다 뛰어나다는 뜻이 아닙니다. 이 네 체크포인트가 Q4_0에 맞춰 학습됐다는 뜻입니다.” - @MarMarLabs
이 결과를 다른 모델에 일반화해서는 안 된다. 다른 모델의 Q4_0 파일은 여전히 일반적인 PTQ 파일이다.
메모리 사용량에 대해 출시 글은 RAM 수치를 제공하지 않는다. 따라서 KikoCis 저장소의 계산을 참고해야 한다. 2.6B의 f16 KV 캐시는 토큰당 약 16KB이며, 컨텍스트 32K에서 약 0.54GB, 기본 128K 창에서 2.15GB다. --cache-type-k q8_0 --cache-type-v q8_0를 사용하면 절반으로 줄어든다. QAD Q4_0 가중치 1.59GB에 32K 컨텍스트를 더하면 런타임 오버헤드 전 약 2.13GB다. 128K에서는 3.7GB를 넘기므로 4GB는 여유 있다고 보기 어렵다. 실제 대상 런타임에서 메모리 할당을 확인해야 한다.
FAQ
QAD Q4_0이 Q4_K_M보다 좋은가?
이 네 체크포인트에 한해서 Liquid AI의 수치는 QAD Q4_0이 Q4_K_M과 같은 품질을, 가장 작은 두 모델에서는 Q5_K_M과 같은 품질을 더 빠른 디코드 속도와 작은 파일 크기로 제공한다고 말한다. 따라서 RAM이 제한된 환경이라면 그렇다고 볼 수 있다. 다만 수치는 다섯 번 반복한 제조사 측 결과이며, 아직 독립적인 재현은 없다.
Ollama나 LM Studio가 QAD 파일을 자동으로 고르나?
아니다. 공식 저장소 페이지에 따르면 Ollama의 문서화된 방식은 ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M이고, Hugging Face의 기본 스니펫도 Q4_K_M을 대상으로 한다. GGUF를 지원하는 런타임이라면 QAD 파일을 불러올 수 있지만, 명시적인 파일명이나 :QAD-Q4_0 한정자를 직접 지정해야 한다.
LFM2.5-2.6B QAD Q4_0에는 RAM이 얼마나 필요한가?
가중치 크기는 1.59GB다. KikoCis의 계산에 따르면 f16 KV 캐시는 컨텍스트 32K에서 약 0.54GB, 128K에서 약 2.15GB다. 가중치와 캐시를 합치면 런타임 오버헤드 전 32K에서 약 2.13GB, 128K에서 3.74GB이며, KV 캐시를 Q8_0으로 양자화하면 캐시 비용이 절반으로 줄어든다.
QAD 체크포인트가 있는 LFM2.5 모델은 무엇인가?
2026년 8월 19일 기준으로 LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct, LFM2.5-2.6B뿐이다. VL-450M과 8B-A1B 변형에는 QAD가 없지만, 출시 스레드에서 사용자들이 Liquid AI에 8B QAD 빌드를 요청하고 있다.
LFM2.5 QAD 체크포인트를 상업적으로 사용할 수 있나?
저장소에는 LFM Open License v1.0이 적용돼 있다. 커뮤니티 저장소의 요약에 따르면 연 매출 1,000만 USD 미만인 기업은 상업적으로 사용할 수 있으며, 이 기준 이상이면 별도의 Liquid AI 상업 라이선스가 필요하다(KikoCis의 요약). 제품에 탑재하기 전에는 라이선스 원문을 직접 확인해야 한다.
BF16의 97%라는 주장은 독립적으로 검증됐나?
아직 아니다. 96.5~97.4%라는 유지율은 출시와 함께 공개된 Liquid AI 자체의 다섯 번 실행 평균이다. 이 글을 작성할 당시 QAD 파일에 대한 제3자 벤치마크는 없었고, imatrix 적용 여부도 r/LocalLLaMA에서 여전히 논의 중이다.
오늘 직접 A/B 테스트해 보자
중요한 것은 벤치마크 평균이 아니라 실제 작업에서의 오류율이다. 도구 호출용 JSON, 사용하는 추출 스키마, 실제 언어처럼 평소 쓰는 프롬프트 열 개를 골라 두 파일을 동일한 설정으로 실행해 보자.
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
감으로 판단하지 말고 파일별 파싱 실패 횟수와 잘못된 도구 선택 횟수를 세어야 한다. 품질 대비 용량이라는 관점에서는 QAD Q4_0이 유리해 보이지만, 실제 배포 환경에서의 트레이드오프는 분명히 남아 있다. 추론에 토큰 예산을 써버려 빈 답을 내놓는 문제나 온도 설정에 따른 형식 이탈은 런타임과 작업에 따라 달라진다. 결국 그 차이를 제대로 평가할 방법은 직접 준비한 열 개의 프롬프트뿐이다.