 AIREITER
코딩 에이전트의 컨텍스트가 대체로 150K 토큰 아래에서 끝난다면 Hy3가 더 나은 선택이다. 입력 토큰 가격은 사실상 비슷하지만, 추론 품질에서 한 발 앞선다. 반대로 세션이 길고 저장소가 크거나 프로덕션에서 높은 동시성을 요구한다면 DeepSeek V4 Flash가 유리하다. Hy3가 따라가기 어려운 세 가지 수치, 즉 1M 토큰 컨텍스트 윈도우, 명시된 $0.0028 캐시 히트 가격, 2,500건 동시 요청 한도를 갖췄기 때문이다. 이것이 hy3 vs deepseek v4 flash 비교의 결론이다. 아래 내용은 2026년 7월 14일 기준 DeepSeek 공식 문서와 OpenRouter 실시간 목록에서 확인한 가격, 제3자 벤치마크, 그리고 Hacker News 및 Reddit에서 두 모델을 매일 사용한 개발자들의 평가를 바탕으로 정리했다.
비슷한 규모, 다른 설계 목표
Tencent는 2026년 7월 6일 최종 Hy3를 출시했다. 4월 23일부터 제공되던 프리뷰 버전을 정식으로 끌어올린 것이다. 발표에 따르면 Hy3는 총 295B, 활성 21B 파라미터의 Mixture-of-Experts 모델이다. 요청마다 어느 정도의 추론을 투입할지 모델이 결정하는, Tencent가 말하는 하이브리드 고속·저속 사고 방식을 채택했다. 컨텍스트는 최대 256K 토큰이며, 가중치는 Apache 2.0 라이선스로 공개됐다. API는 Tencent Cloud TokenHub에서 제공한다.
DeepSeek V4 Flash는 2026년 4월 V4 제품군의 고속 티어로 출시됐다. Artificial Analysis 기준 총 284B, 활성 13B 파라미터의 오픈 웨이트 MoE 모델이며, MIT 라이선스를 따른다. 설계 초점은 다르다. 1M 토큰 컨텍스트를 저렴하게 처리하는 데 맞춰져 있다. 기본값인 thinking 모드와 non-thinking 모드를 모두 지원하며, 최대 출력 길이는 384K 토큰이다.
파라미터 규모만 보면 두 모델은 비슷해 보인다. 하지만 지향점은 다르다. Hy3는 토큰당 추론 품질에 더 많은 자원을 쓰고, Flash는 긴 컨텍스트와 캐시 효율, 처리량에 집중한다. 실제 사용에서 나타나는 차이도 대부분 여기서 출발한다.
| 사양 (2026-07-14 확인) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| 파라미터 | 총 295B / 활성 21B | 총 284B / 활성 13B |
| 컨텍스트 윈도우 | 256K | 1M (최대 출력 384K) |
| 추론 | 하이브리드 고속/저속 사고 | Thinking + non-thinking 모드 |
| 라이선스 | Apache 2.0 | MIT |
| 출시일 | 2026년 7월 6일 (프리뷰 4월 23일) | 2026년 4월 |
| 공식 API | Tencent Cloud TokenHub | api.deepseek.com (OpenAI + Anthropic 형식) |
벤치마크가 보여주는 실제 격차
Artificial Analysis Intelligence Index v4.1에서 Hy3는 41점, DeepSeek V4 Flash는 고노력 reasoning 모드에서 37점을 기록했다. 이 지수에서 4점 차이는 실제 차이다. Flash와 그보다 한 단계 아래 모델 사이의 간격에 대략 해당한다. 다만 세대가 완전히 갈리는 수준은 아니다. 두 모델 모두 ‘매우 유능하지만 최전선 모델은 아닌’ 범주에 속한다.
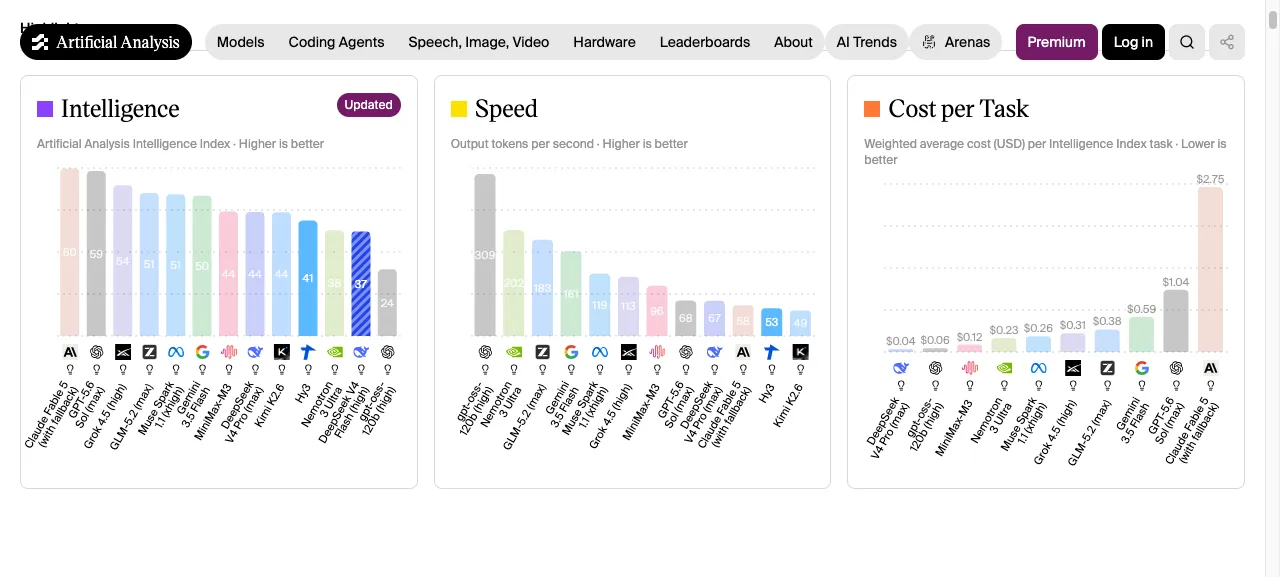
다만 이 점수에 과도한 비중을 두기 전에 두 가지는 짚어야 한다.
우선 에이전트 코딩 벤치마크에서는 두 모델 모두 더 냉정한 평가를 받는다. Hacker News 출시 스레드의 한 댓글 작성자는 Hy3의 DeepSWE 결과를 찾아냈다. Hy3는 28%였고, 최고 노력 설정의 GPT-5.4는 52%였다. 두 중국 모델 모두 최전선 에이전트 코딩 모델과는 아직 거리가 있다. 이들은 리더보드 최상위 모델이 아니라 서로를 경쟁 상대로 삼는다.
또한 어느 회사든 직접 공개한 벤치마크 표는 일반적인 수준의 의심을 갖고 봐야 한다. Hy3 출시 수치는 HN 스레드에서 곧바로 ‘benchmaxxed’라는 의혹을 받았고, DeepSeek의 표 역시 자사가 선택해 실행한 평가만 담고 있다. 여기서 기준점으로 삼을 만한 것은 앞서 언급한 제3자 수치다. 결론도 명확하다. Hy3가 약간 더 똑똑하지만, 그 차이는 가격과 컨텍스트 조건에 따라 선택이 뒤집힐 정도로 작다.
가격표보다 중요한 캐시 비용
가격표는 2026년 7월 14일 기준으로 확인했으며, 두 종류를 구분해서 볼 필요가 있다. DeepSeek는 API 문서에 정확한 퍼스트파티 토큰당 요금을 공개한다. 반면 Tencent는 최종 Hy3에 대한 동등한 영문 요금표를 공개하지 않았다. 보도자료에는 TokenHub에서 Hy3 프리뷰의 입력 가격이 100만 토큰당 약 $0.18이라고만 나온다. 따라서 아래 Hy3 열은 퍼스트파티 가격이 아니라 OpenRouter에 표시된 요금을 사용했다.
| 100만 토큰당 | Hy3 (OpenRouter 마켓플레이스) | DeepSeek V4 Flash (퍼스트파티 API) |
|---|---|---|
| 입력 | $0.14 | $0.14 (캐시 미스) |
| 캐시된 입력 | $0.035 | $0.0028 (캐시 히트) |
| 출력 | $0.58 | $0.28 |
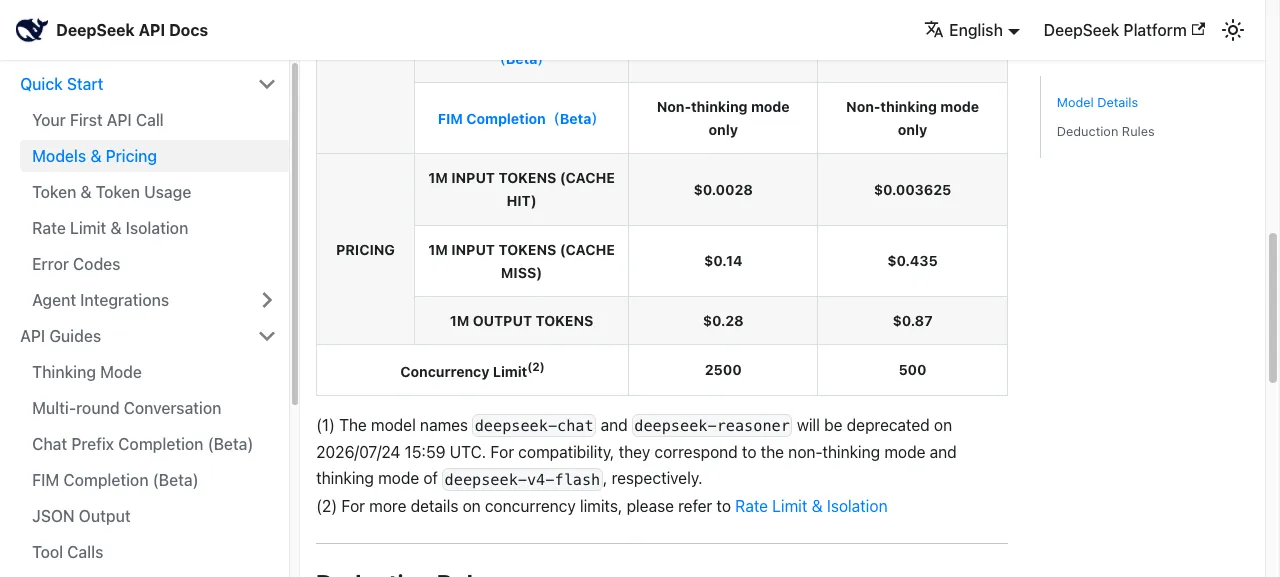
입력 기본 가격은 같다. 실제 차이는 나머지 두 행에서 벌어진다.
캐시 히트가 만드는 큰 차이
DeepSeek의 캐시 히트 가격은 캐시 미스 가격보다 50배 저렴하고, OpenRouter의 Hy3 캐시 가격보다 12.5배 낮다. 물론 두 캐시 요금은 엄밀히 동등한 조건은 아니다. DeepSeek는 퍼스트파티 API 가격이고, Hy3는 OpenRouter의 기반 제공업체가 캐시 읽기에 부과하는 가격이다. 그래도 현재 실제로 지불하게 되는 요금이라는 점은 같다. 에이전트를 운영한다면 이 숫자가 이 글에서 가장 중요한 숫자일 수 있다. 에이전트 루프는 매 턴마다 시스템 프롬프트, 도구 정의, 파일 내용, 대화 이력처럼 계속 커지는 동일 컨텍스트를 재전송한다. 40턴 세션에서는 입력 토큰 대부분이 반복분이다. 캐시 히트율이 90%라면 Flash의 실효 입력 가격은 100만 토큰당 $0.14에서 약 $0.017로 떨어진다. Hy3는 약 $0.045가 된다. 여전히 저렴하지만 거의 3배 비싸며, 세션이 길어질수록 격차도 더 커진다.
Hy3는 출력 토큰에서 비용이 커진다
둘 다 추론 모델이므로 thinking 토큰도 출력 토큰으로 과금한다. Hy3의 출력 가격은 $0.58로 Flash의 $0.28보다 두 배 이상 높다. 긴 추론 체인 하나당 Hy3 사용자는 대략 두 배의 비용을 내는 셈이다. Flash에는 Hy3에 없는 절약 수단도 있다. 포맷팅, 추출, 단순 편집처럼 기계적인 작업에서는 non-thinking 모드로 전환해 불필요한 추론 비용을 줄일 수 있다. deepseek-v4-flash-vs-deepseek-v4-pro 비교 글에서 이 모드 전환이 실사용에서 어떻게 작동하는지 다뤘다.
무료 티어
Hy3의 확실한 장점도 하나 있다. OpenRouter는 속도 제한이 있기는 하지만 무료인 tencent/hy3:free 변형을 제공한다. 도입 전 모델을 평가할 때는 무료 API 티어가 없는 Flash보다 낫다. 4월 체크포인트를 감수할 수 있다면 Hy3 프리뷰도 $0.063/$0.21로 여전히 제공되며, 최종 버전보다 저렴하다.
256K 컨텍스트가 치르는 대가
Hy3의 256K 컨텍스트는 충분해 보이지만, 실제 코드베이스에 에이전트를 붙이면 이야기가 달라진다. r/hermesagent의 한 Reddit 사용자는 동일한 하네스에서 두 모델을 돌린 뒤 Hy3를 “컨텍스트 크기만 빼면 거의 동일해서, 압축이 자주 필요하다”고 평가했다. 압축은 단순히 불편한 문제가 아니다. 압축할 때마다 요약을 만들기 위해 출력 토큰을 소비하고, 세부 정보는 사라지며, 프롬프트 캐시도 무효화된다. 이후 캐시를 다시 만들려면 캐시 미스 가격을 내야 한다.
셀프 호스팅에서는 이 차이가 구조적인 문제가 된다. V4 아키텍처의 희소 어텐션 설계는 DeepSeek가 lightning indexer라고 부르는 메커니즘을 사용하며, Hy3의 일반적인 어텐션보다 KV 캐시를 훨씬 가볍게 만든다. 벤치마크가 아닌 단일 사용자 보고이기는 하지만, HN 스레드의 수치는 인상적이다. DGX Spark 두 대에서 두 모델을 실행한 한 댓글 작성자는 DeepSeek V4 Flash와 함께 3M 토큰의 KV 캐시를 올릴 수 있었지만, Hy3를 FP4로 양자화했을 때는 약 130K 토큰 수준이었다고 전했다. 다른 사용자는 llama.cpp가 indexer를 완전히 지원하게 되면 Flash의 전체 1M 컨텍스트에 필요한 RAM은 약 6GB에 그칠 것으로 추정했다. Flash는 공격적인 양자화에도 견디는 사례가 있다. 같은 스레드의 여러 사용자는 2비트에서도 일관성을 유지한다고 보고했지만, Hy3에서는 아직 입증되지 않은 결과다.
사용 사례가 200K 토큰을 한참 밑돈다면 이 섹션은 비용과 무관하다. Hy3의 Intelligence Index 4점 우위도 그대로 가져갈 수 있다. 하지만 그 수준을 넘기면 컨텍스트 비용은 누적된다. 압축은 늘고, 캐시는 더 자주 무효화되며, 세션당 메모리 사용량도 커진다.
출시 후 개발자들이 말한 차이
가장 유용한 신호는 벤치마크 표에 없었다. 코딩 에이전트 안에서 두 모델을 직접 돌린 개발자들이 공통적으로 언급하는 성격 차이다.
같은 Hacker News 스레드에서 Anthropic 구독을 해지한 뒤 DeepSeek V4 Flash와 Pro를 일상 모델로 쓰다가 Hy3까지 사용해 본 한 사용자는 Flash를 이렇게 표현했다. 속도는 훌륭하지만 “완전히 잘못된 멘탈 모델을 세운 뒤 엉뚱한 방향으로 돌진하는 경우가 잦다”는 것이다. 그래서 수시로 수정하고 이력을 압축해야 했다. 반면 Hy3는 “그만큼 빠르지는 않지만, 지금까지는 훨씬 안정적으로 작업을 따라간다”고 평가했으며 컨텍스트가 길어져도 성능 저하가 적다고 봤다. 같은 스레드의 다른 사용자들은 이 크기에서 Hy3의 세계 지식과 문장 품질이 Flash보다 낫다고 평가했다.
순수 코딩 결과만 보면 Reddit 쪽 평가는 Flash에 조금 더 기운다. r/LLMDevs의 동일 작업 비교에서는 “DeepSeek V4 Flash > Hy3 > GLM” 순으로 평가하면서도 Hy3를 “실용적인 코딩 워크플로에 유망하다”고 했다. r/opencode에서는 일상적인 에이전트 작업에 Flash가 “차고 넘친다”는 의견이 반복적으로 보인다.
운영 이력도 고려할 부분이다. Hy3 출시 직후 수요는 Tencent의 서빙 용량을 넘어섰다. HN 스레드 사용자들은 강한 속도 제한을 보고했으며, OpenRouter 공개 사용량 순위를 추적하는 한 사용자는 이 모델이 한 달 만에 상위권에서 8~9위로 내려갔다고 전했다. 원인으로는 이러한 제한을 직접 지목했다. 반면 DeepSeek는 공식 API에서 Flash의 동시 요청 한도를 2,500건으로 명시한다. 이는 V4 Pro에 허용하는 수치의 5배다. 프로덕션 트래픽 관점에서 한쪽은 공개된 용량 보장을 제공하고, 다른 한쪽은 혼잡 이력이 있다.
용도별 선택 가이드
- 150K 토큰 미만의 에이전트 코딩: Hy3. 추론 품질이 더 높고 작업 이탈이 적으며, 입력 비용은 Flash의 기본 가격과 같다. 256K가 아닌 150K를 기준으로 잡은 이유는 에이전트 컨텍스트가 빠르게 커지고, 압축이 시작되기 전의 여유 공간이 필요하기 때문이다.
- 긴 세션, 대형 저장소, 대규모 문서 RAG: 대체로 Flash가 더 적합하다. 1M 컨텍스트와 50배 캐시 할인은 완전히 다른 비용 구조를 만들며, Hy3의 압축 오버헤드는 추론 품질 우위를 갉아먹는다.
- 대량 프로덕션 API: Flash. 문서화된 2,500 동시성, 안정적인 서빙 이력, 저렴한 대량 호출을 위한 non-thinking 모드를 갖췄다.
- 글쓰기, 리서치, 세계 지식 작업: Hy3. 커뮤니티 평가와 AA 지식 평가 모두 이 규모에서 Hy3를 더 높게 본다.
- 로컬 배포: 대부분의 하드웨어에서는 Flash. KV 캐시 효율과 양자화 내성에 관한 실사용 근거가 훨씬 많다. 출시 스레드에서 인용된 Tencent의 Hy3 서빙 가이드는 H20급 GPU 8장을 요구한다.
- 도입 전 평가: Hy3의 OpenRouter 무료 티어는 비용 없이 시험할 수 있다. 이 글을 포함한 어떤 벤치마크 표보다도, 직접 작업을 넣어 보는 편이 낫다.
어디서 사용할 수 있나
DeepSeek V4 Flash: 공식 API는 OpenAI 형식(api.deepseek.com)과 Anthropic 형식(api.deepseek.com/anthropic) 엔드포인트를 모두 제공한다. 기본 URL만 바꾸면 Claude 호환 도구에 연결할 수 있다는 뜻이다. 같은 가격 페이지에 나온 마이그레이션 마감일도 확인할 필요가 있다. 기존 deepseek-chat 및 deepseek-reasoner 모델명은 2026년 7월 24일에 폐기되며, 각각 Flash의 non-thinking 및 thinking 모드로 매핑된다. OpenRouter에서는 $0.09/$0.18에 제공되며 공식 가격보다 약간 낮지만, 공식 API의 캐시 히트 가격은 적용되지 않는다.
Hy3: 퍼스트파티 경로는 Tencent Cloud TokenHub다. OpenRouter에서는 최종 버전, 더 저렴한 프리뷰 체크포인트, 무료 티어를 모두 제공한다. SiliconFlow는 출시 프로모션을 제공한 바 있다. GPU가 있다면 Apache 2.0 조건으로 셀프 호스팅할 수 있다. Hy3 API 설정 가이드에서 키 발급과 첫 호출 과정을 확인할 수 있다.
FAQ
Hy3는 무료로 쓸 수 있나?
일부 가능하다. OpenRouter에는 속도 제한이 있는 무료 tencent/hy3:free 티어가 있으며, Tencent의 소비자 제품인 Yuanbao와 ima도 Hy3를 무료로 사용한다. 다만 TokenHub 또는 OpenRouter 유료 티어를 통한 프로덕션 API 접근은 토큰당 과금된다.
Hy3는 Tencent Hunyuan과 같은 모델인가?
그렇다. Hy3는 Tencent의 Hunyuan 모델 라인 3세대이며, Tencent는 현재 이를 “Tencent Hy”라는 브랜드로 부른다. 프리뷰는 2026년 4월 23일에 출시됐고, 최종 버전은 2026년 7월 6일에 나왔다.
코딩에는 Hy3와 DeepSeek V4 Flash 중 무엇이 더 나은가?
작업 형태에 따라 커뮤니티 평가는 갈린다. 동일 작업 Reddit 비교에서는 Flash의 순수 출력이 Hy3보다 높게 평가됐지만, 장시간 세션을 돌리는 에이전트 사용자들은 Hy3가 더 안정적으로 작업을 유지한다고 말한다. 범위가 짧고 명확한 작업이라면 Flash의 속도가 유리하다. 반면 작업 이탈의 비용이 큰 수 시간짜리 에이전트 세션에서는 컨텍스트가 256K 안에 충분히 머무르는 한 Hy3가 낫다.
DeepSeek V4 Flash를 로컬에서 실행할 수 있나?
가능하며 Hy3보다 현실적이다. 가중치는 MIT 라이선스이고 아키텍처의 KV 캐시가 유난히 가볍다. 또한 약 96GB RAM을 갖춘 머신에서 2비트 양자화로도 실사용 가능한 품질을 보인다는 사용자 보고가 있다.
hy3 vs deepseek v4 flash 가격 비교가 복잡한 이유는 무엇인가?
적어도 네 가지 가격표가 있기 때문이다. Tencent TokenHub, OpenRouter의 Hy3 최종 및 프리뷰 목록, 그리고 별도 캐시 히트 요금이 있는 DeepSeek 공식 API가 있다. 자신의 트래픽 패턴에 따른 실효 가격을 비교해야 한다. 에이전트 워크로드에서는 캐시된 입력이 대부분을 차지하며, 이 구간에서 DeepSeek의 $0.0028 요금은 이기기 어렵다.
결론
현재 उपलब्ध한 제3자 근거만 보면 Hy3가 더 강한 모델이고, DeepSeek V4 Flash는 더 강한 서비스다. 프로덕션 API 워크로드에서는 Flash를 기본 선택으로 추천한다. 캐시 비용 구조, 컨텍스트 윈도우, 공개된 동시성 한도는 4점의 벤치마크 우위로 상쇄하기 어려운 복합적인 장점이다. 규모보다 프롬프트당 추론 품질이 중요하다면 Hy3를 선택할 만하다. 먼저 무료 티어에서 자신의 작업으로 테스트해 보자. 확인하는 데 비용이 들지 않는다.