 AIREITER
GLM-5.3과 DeepSeek V4 Pro의 차이는 단순히 모델 성능표로 끝나지 않는다. 2026년 8월 14일 출시된 GLM-5.3은 GLM-5.2 대비 코딩 성능이 50% 향상됐다는 Z.ai의 주장과 CyberGym 84.5%의 새 사이버보안 역량을 앞세운다. 반면 DeepSeek V4 Pro는 전체 API 접근, MIT 라이선스 오픈 가중치, 모델 카드 기준 SWE-Bench Verified 80.6%를 이미 제공한다. NIST의 독립 측정치는 81%다. 결정적인 차이는 GLM-5.3에 아직 공개 API가 없다는 점이다. 현재는 Z.ai의 관리형 제품인 ZCode와 GLM Coding Plan에서만 쓸 수 있으며, 이 접근 방식의 차이가 비교의 결론을 크게 좌우한다.
핵심은 성능보다 접근 방식의 차이
DeepSeek V4 Pro는 Hugging Face에서 MIT 라이선스로 오픈 가중치를 공개했고, api-docs.deepseek.com에 API 문서도 제공한다. SiliconFlow 같은 서드파티 호스팅도 지원한다. 지금 바로 직접 호스팅하거나 OpenAI 호환 클라이언트에 연결할 수 있고, Claude Code, Cline, 자체 스크립트에서도 호출할 수 있다.
GLM-5.3은 정반대의 전략을 택했다. Z.ai의 출시 발표에 따르면 이 모델은 GLM Coding Plan과 Z.ai 자체 코딩 IDE인 ZCode를 통해 즉시 사용할 수 있다. 다만 API 접근과 오픈 가중치는 "엄격한 안전성 평가"가 끝난 뒤에야 제공될 예정이다. 즉, 현재는 model: glm-5.3 엔드포인트도 없고 Hugging Face 다운로드나 서드파티 추론 서비스도 없다. Z.ai는 구체적인 일정도 밝히지 않았다.
코딩 벤치마크: 출시사 주장과 독립 검증의 간극
GLM-5.3과 DeepSeek V4 Pro는 모두 에이전트형 코딩을 겨냥한 대규모 중국 MoE 모델이다. 다만 성능을 뒷받침하는 근거의 성숙도는 크게 다르다.
Z.ai의 출시 자료는 GLM-5.3을 743B 기반 모델을 사후 학습한 변형으로 소개한다. 새 아키텍처가 아니라 사후 학습을 통해 "최상위권 코딩 및 에이전트 역량"을 달성했다는 설명이다. 중국어 발표문에는 더 구체적인 주장이 담겼다. GLM-5.2보다 코딩 성능이 약 50% 높고, Terminal-Bench 3.0에서 오픈 모델 중 1위이며, 화이트박스 코드 리뷰는 Mythos 5와 동급이라는 내용이다. 참고로 GLM-5.2는 Z.ai 릴리스 노트 기준 Terminal-Bench 2.1에서 81.0점을 기록했다. 당시 오픈 가중치 모델 중 최고점이었지만 Claude Opus 4.8의 85.0에는 못 미쳤다.
DeepSeek V4 Pro의 수치는 독립 검증도 갖추고 있다. Hugging Face 모델 카드는 SWE-Bench Verified 80.6%, HumanEval Pass@1 76.8을 제시한다. NIST의 CAISI 평가에서도 SWE-Bench Verified 81%가 독립 측정됐다. 아키텍처는 총 1.6T 파라미터, 활성 파라미터 49B의 MoE이며, 컨텍스트 윈도는 100만 토큰, 최대 출력은 384K 토큰이다.
| 항목 | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| 아키텍처 | 743B 기반, 사후 학습 | 총 1.6T / 활성 49B MoE |
| 컨텍스트 윈도 | 미공개 (GLM-5.2: 1M) | 100만 토큰 |
| 최대 출력 | 미공개 (GLM-5.2: 128K) | 384K 토큰 |
| 코딩 벤치마크 | Terminal-Bench 3.0 오픈 모델 1위 (출시사 주장) | SWE-Bench Verified 80.6% (모델 카드 + NIST) |
| 사이버보안 | CyberGym 84.5%; Mythos 5와 동급의 화이트박스 리뷰 | 동등한 포지셔닝 없음 |
| 오픈 가중치 | 안전성 평가 후 공개 예정 | MIT 라이선스, 현재 이용 가능 |
| API | 아직 없음 | 제공 중 (공식 + SiliconFlow) |
Terminal-Bench와 SWE-Bench는 측정 대상이 다른 벤치마크다. Terminal-Bench는 터미널 작업을 수행하는 에이전트를 평가하고, SWE-Bench Verified는 자동화된 풀 리퀘스트 패치를 평가한다. 따라서 Terminal-Bench 3.0 순위와 SWE-Bench Verified 백분율을 직접 비교할 수는 없다.
GLM-5.3은 DeepSeek V4 Pro가 별도로 내세우지 않는 사이버보안 영역도 추가했다. Z.ai는 CyberGym 84.5% 성능을 근거로 이 모델을 "사이버 방어 준비 완료" 모델로 포지셔닝한다. 다만 이는 아직 독립 검증되지 않은 출시사 발표 수치이므로, 확정된 결론보다 방향성을 보여주는 지표로 보는 편이 적절하다. Z.ai는 GLM-5.3이 GLM-5.2보다 "더 적은 출력 토큰으로 더 나은 결과"를 낸다고도 주장한다. 독립 테스트에서도 효율이 확인된다면 작업당 비용은 낮아질 수 있다.
구독형과 토큰 과금형, 비용 비교의 본질
DeepSeek V4 Pro는 공식 API에서 100만 토큰 단위로 과금한다.
| 토큰 유형 | 공식 DeepSeek API |
|---|---|
| 캐시 미적용 입력 | $0.435 / 100만 토큰 |
| 캐시 적용 입력 | $0.003625 / 100만 토큰 |
| 출력 | $0.87 / 100만 토큰 |
GLM-5.3은 GLM Coding Plan 구독으로만 이용할 수 있다.
| 티어 | 월 요금 | 제공량 |
|---|---|---|
| Lite | $18 | 주당 10,000크레딧 |
| Pro | $80 | Lite 사용량의 6배 |
| Max | $168 | Lite 사용량의 14배 |
GLM Coding Plan은 크레딧 하나가 몇 토큰에 해당하는지 공개하지 않는다. 따라서 두 서비스의 비용을 정확히 일대일로 비교하기는 어렵다. DeepSeek는 사실상 최소한의 약정으로 토큰 단위 과금이 이뤄지는 반면, GLM Coding Plan은 사용량과 관계없이 월 정액을 청구한다.
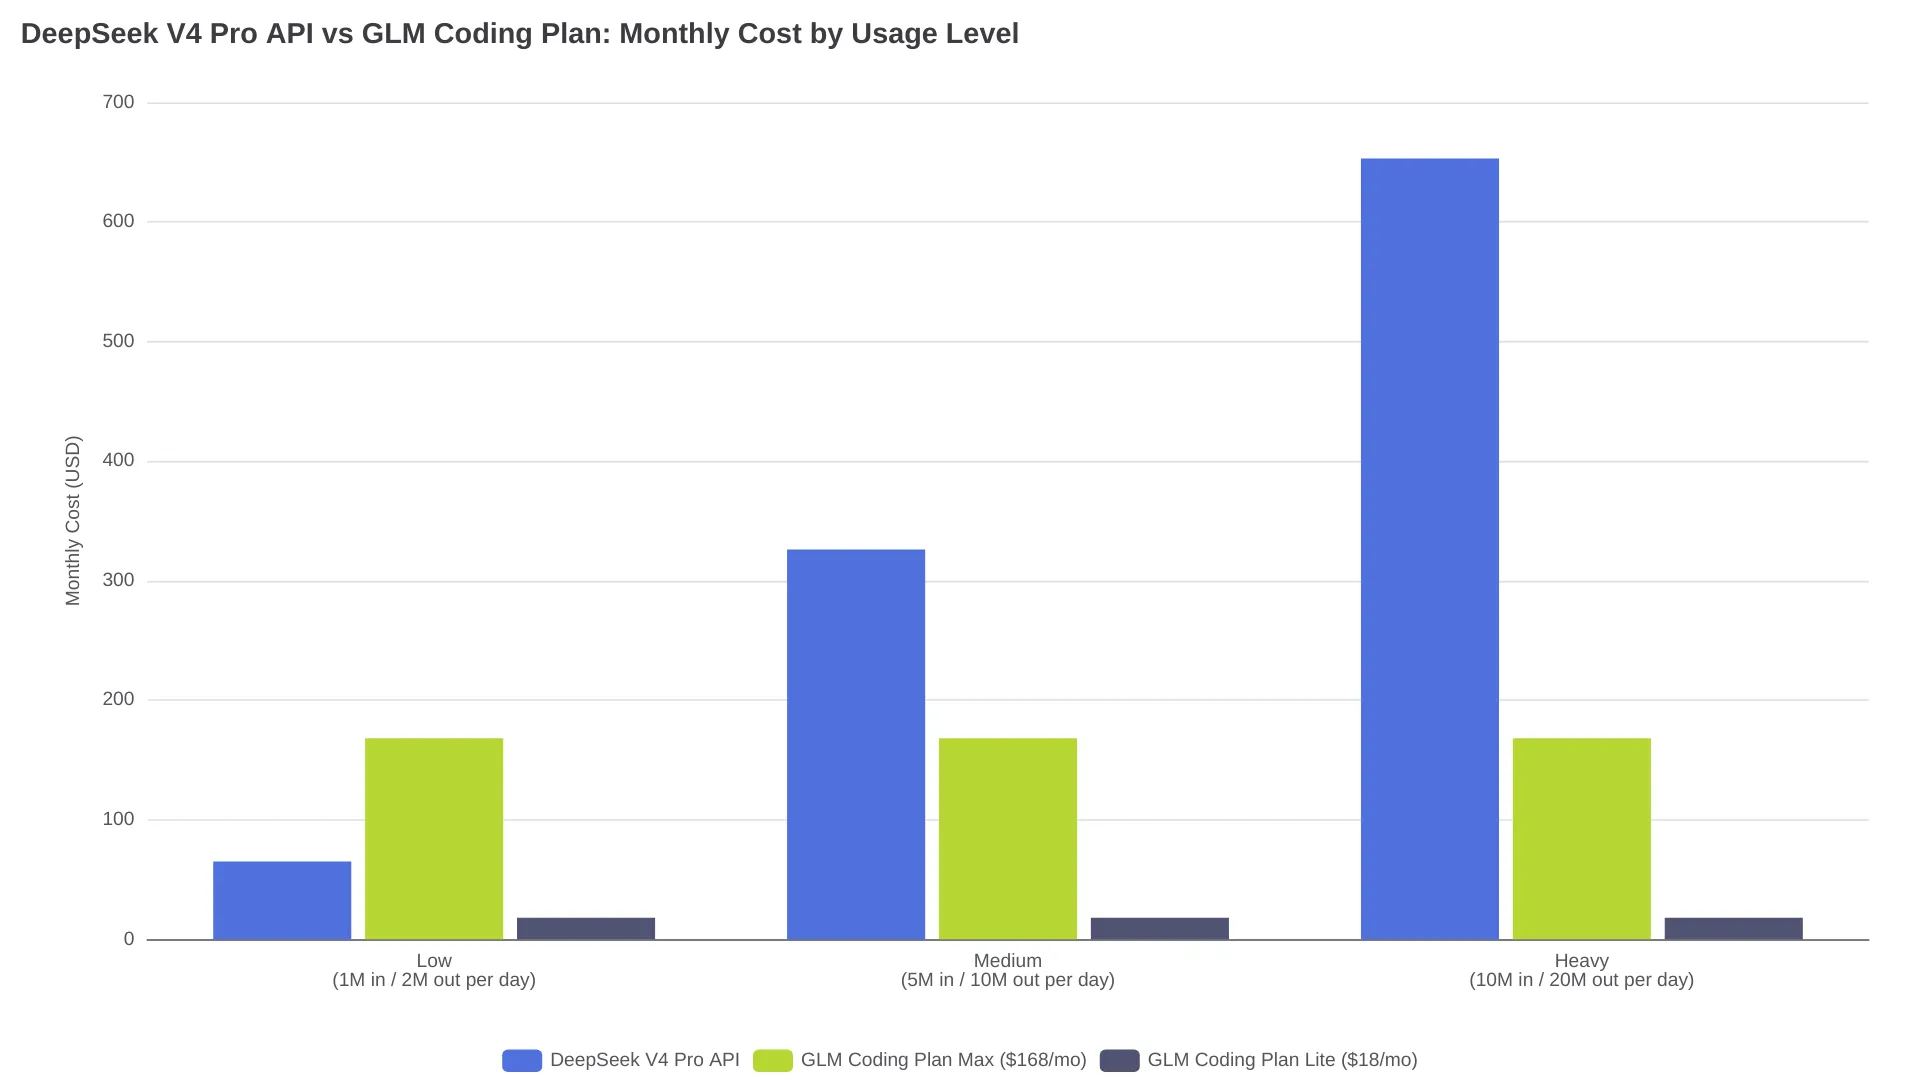
DeepSeek 비용을 구체적으로 계산해 보자. 하루에 캐시 미적용 입력 1M 토큰과 출력 2M 토큰을 쓰는 보통 수준의 코딩 세션이라면 API 비용은 월 약 $65다. 이를 하루 입력 5M 토큰, 출력 10M 토큰까지 늘리면 월 청구액은 $326에 이른다. 반복적으로 쓰는 코드베이스라면 캐시 입력 요금이 100만 토큰당 $0.003625이므로 비용을 크게 낮출 수 있다. GLM 쪽에서는 월 $168의 Max 티어가 사용량 기반 과금의 부담을 피하게 해주지만, 같은 작업량을 감당할 수 있는지는 공개되지 않은 크레딧-토큰 환산 기준에 달려 있다.
Reddit 사용자들이 말하는 실제 사용감
최근 r/ZaiGLM 스레드에서 두 모델을 모두 사용했다는 한 사용자는 이렇게 평가했다.
"작업 자체는 GLM보다 빨랐지만, 훨씬 더 많은 수동 개입이 필요했다."
같은 스레드에는 여러 모델을 병행하는 사용자도 있었다. 코딩과 저장소 탐색에는 GLM을 쓰고, 코드 리뷰에는 DeepSeek V4 Flash를 쓰는 방식이다. 다른 사용자는 DeepSeek V4 Pro가 공개된 지 약 24시간밖에 되지 않았다며 성급한 판단을 경계했다. 물론 이는 단일 커뮤니티 스레드의 개인 경험일 뿐, 통제된 벤치마크 결과는 아니다.
상황별로 고르는 추천 모델
| 상황 | 추천 |
|---|---|
| 지금 API 접근이나 CI/CD 통합이 필요하다 | DeepSeek V4 Pro — GLM-5.3에는 공개 API가 없다 |
| 데이터 상주 요건 때문에 직접 호스팅하고 싶다 | DeepSeek V4 Pro — Hugging Face에서 MIT 가중치를 현재 제공 |
| 주로 IDE에서 코딩하며 관리형 어시스턴트를 원한다 | GLM-5.3 — GLM Coding Plan 또는 ZCode 이용 |
| 예산이 제한적인 개인 개발자다 | DeepSeek V4 Pro는 저사용량에서 토큰당 비용이 더 낮고, GLM Lite ($18/월)는 사용량과 무관하게 지출 상한을 정한다 |
| 보안 감사나 취약점 연구가 목적이다 | GLM-5.3부터 테스트 — CyberGym 84.5%는 독특하지만 독립 검증은 아직 없다 |
| 긴 세션의 대규모 에이전트형 코딩이 필요하다 | GLM Coding Plan Max ($168/월 정액)가 비용 상한을 제공하지만, 크레딧 제공량이 작업량을 충족하는지 확인해야 한다 |
| 기존 코드가 거의 없는 그린필드 프로토타입을 만든다 | 어느 쪽이든 가능 — 둘 다 새 코드 작성에 대응하므로 접근 방식 선호도에 따라 선택 |
이미 GLM-5.2 Coding Plan을 사용 중이라면, 같은 구독 내에서 GLM-5.3으로 올리는 것이 가장 간편한 선택이다. DeepSeek V4 Pro API가 필요하다면 DeepSeek V4 Pro GA API 가이드에서 엔드포인트 설정과 비용 최적화 방법을 확인할 수 있다. 이전 GLM 세대까지 포함한 더 넓은 비교는 GLM-5.2 vs DeepSeek V4 Pro 분석을 참고하면 된다.
FAQ
GLM-5.3에도 공개 API가 생기나?
그렇다. Z.ai는 안전성 평가 후 API 접근과 오픈 가중치를 단계적으로 공개하겠다고 밝혔다. 다만 구체적인 날짜는 공개하지 않았다.
두 모델 모두 직접 호스팅할 수 있나?
DeepSeek V4 Pro는 가능하다. MIT 라이선스 가중치가 Hugging Face에 공개돼 있다. 1.6T 파라미터 MoE를 비양자화 FP16으로 돌리려면 약 3.2TB VRAM이 필요하고, 4비트 양자화 기준으로도 약 800GB가 필요하다. 즉 H100 또는 H200 여러 장으로 구성한 멀티 GPU 클러스터가 필요하다. GLM-5.3은 아직 불가능하다. 안전성 평가 후 오픈 가중치 공개가 예고됐지만 라이선스는 공개되지 않았다.
매일 코딩을 많이 한다면 어느 쪽이 더 저렴한가?
사용량에 따라 다르다. 하루 입력 1M 토큰과 출력 2M 토큰 기준 DeepSeek V4 Pro는 월 약 $65다. 하루 입력 5M 토큰과 출력 10M 토큰이라면 월 $326까지 올라간다. GLM Coding Plan Max는 월 $168이므로 이처럼 높은 사용량에서는 DeepSeek보다 저렴하다. 단, 공개되지 않은 크레딧 제공량이 해당 작업량을 감당한다는 전제에서만 그렇다. 결제 전에 실제 사용 패턴으로 두 서비스를 모두 테스트하는 편이 좋다.
GLM-5.3은 비전이나 이미지 입력을 지원하나?
아니다. Z.ai는 비전 기능을 별도의 GLM-V 모델 라인인 GLM-5V-Turbo, GLM-4.6V, GLM-OCR에 유지하고 있다. GLM-5.3은 텍스트 및 코드 모델이다. DeepSeek V4 Pro 역시 텍스트 전용이다.
지금은 역량보다 출시 시점이 더 중요하다
문서상으로는 GLM-5.3이 더 강해 보인다. 코딩 성능 50% 향상, 독특한 사이버보안 포지션, 더 나은 토큰 효율을 내세우기 때문이다. 하지만 이 수치들은 출시 발표가 나온 지 몇 시간밖에 되지 않은 시점의 출시사 발표에 기반하며, API와 오픈 가중치, 독립 벤치마크 검증도 아직 없다. DeepSeek V4 Pro는 GLM-5.3이 현재 제공하지 못하는 것을 제공한다. 즉시 쓸 수 있는 접근성, 검증된 벤치마크, 배포 가능한 가중치다. API 접근이나 직접 호스팅이 필요하다면 지금은 DeepSeek를 쓰고, GLM-5.3 API가 출시되면 자체 코드베이스에서 정면 비교 테스트를 해보는 것이 좋다.