 AIREITER
Gemini 3.5 Flash는 Gemini 3.1 Pro보다 초당 출력 토큰 생성량이 2.6배 많고 토큰당 가격은 25% 낮다. Artificial Analysis의 Intelligence Index도 Flash가 50점으로 Pro의 46점을 앞선다. 하지만 모든 작업에서 Flash가 답은 아니다. ARC-AGI-2에서는 Gemini 3.1 Pro가 77.1%로 Flash의 72.1%보다 5포인트 높고, Flash의 장문 컨텍스트 검색 성능은 128k 토큰을 넘기면 84.9%에서 77.3%로 떨어진다. 처리량과 도구 호출 지연 시간이 중요하다면 Flash, 여러 단계의 깊은 추론이 핵심이라면 Pro가 더 맞는다. 종합 벤치마크 점수 하나만으로는 실제 워크로드에 필요한 쪽을 가리기 어렵다.
벤치마크로 본 Flash와 Pro의 우세 영역
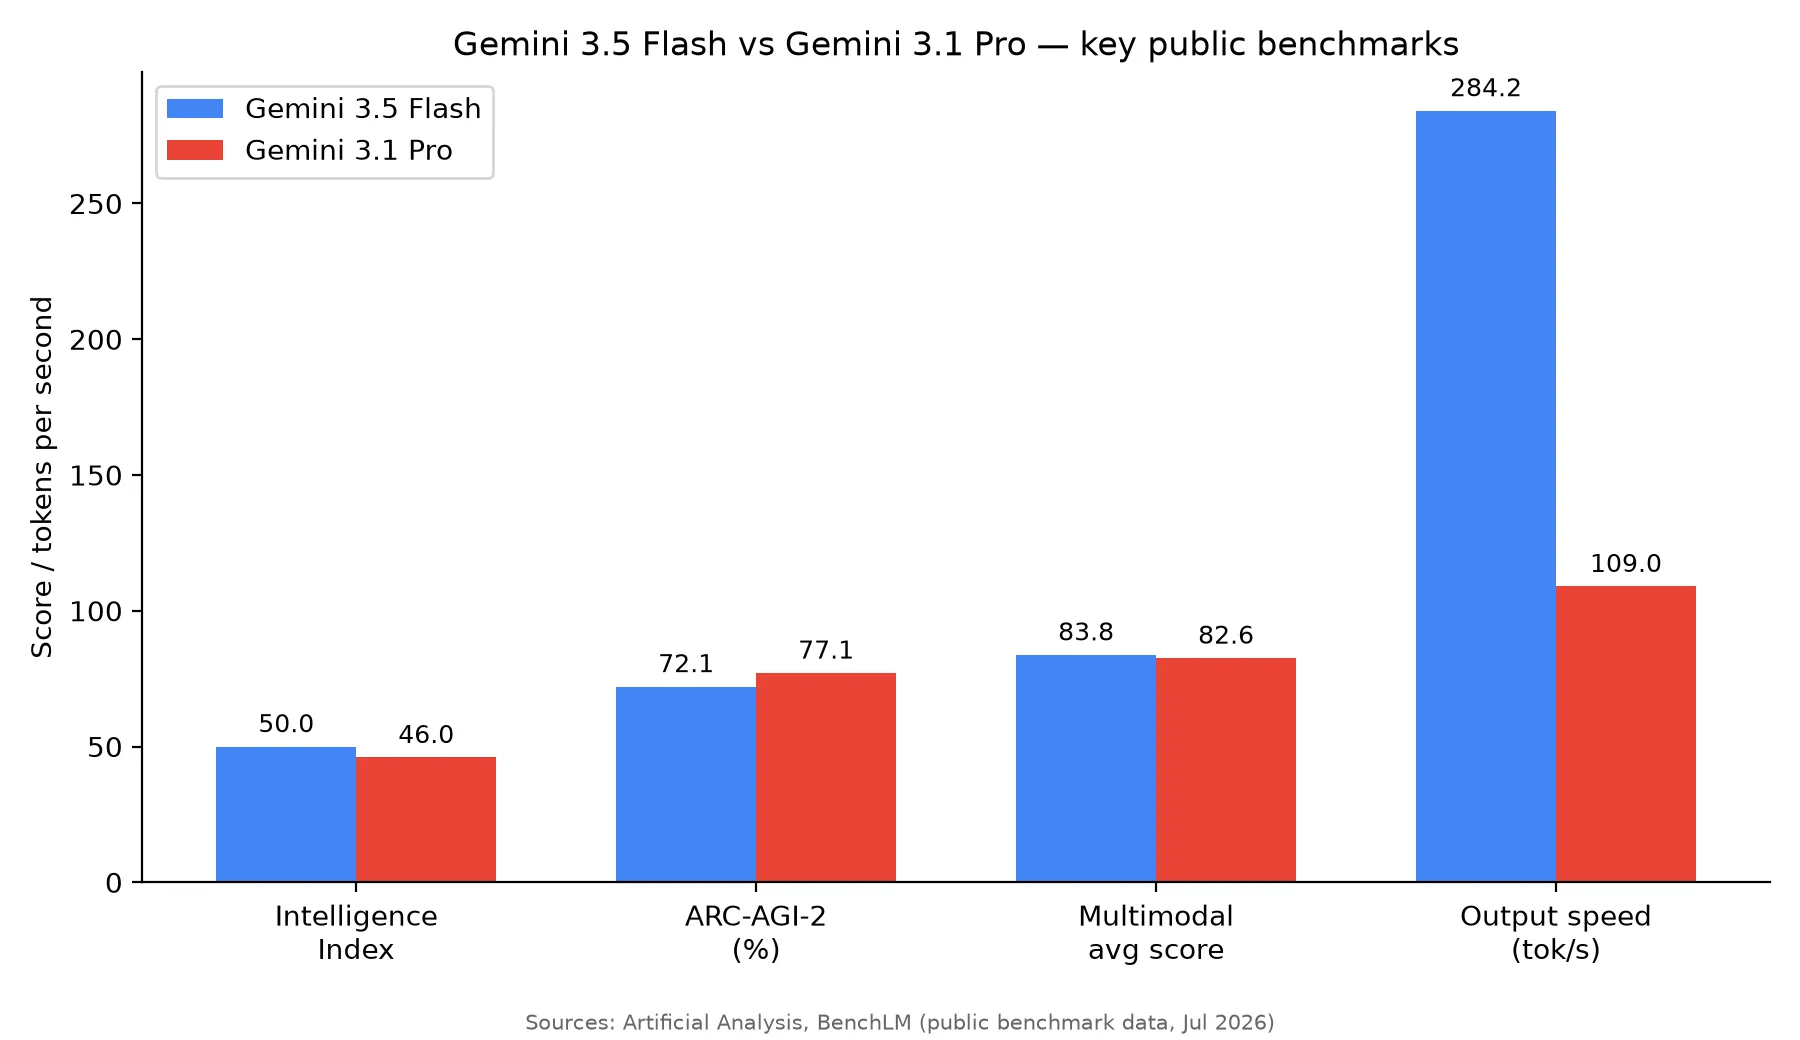
| 지표 | Gemini 3.5 Flash | Gemini 3.1 Pro | 우세 모델 |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, 추상 추론 (BenchLM) | 72.1% | 77.1% | Pro |
| 128k 컨텍스트 MRCR v2 (nxcode) | 77.3% (더 짧은 컨텍스트에서는 84.9%) | 같은 길이의 공개 결과 없음 | 데이터 부족 |
| 멀티모달 평균 점수 (BenchLM) | 83.8 | 82.6 | Flash |
| 출력 속도 (BenchLM) | 284.2 tok/s | 109 tok/s | Flash (2.6배) |
| GDPval-AA Elo, 실제 에이전트 작업 (apiyi) | 1656 | 1314 | Flash |
처리량과 범용 작업 처리 능력을 측정하는 지표에서는 Flash가 앞선다. 반면 Pro는 ARC-AGI-2에서 추론 깊이의 뚜렷한 우위를 보인다. 긴 컨텍스트 검색의 경우 Flash는 128k 토큰 이후 성능 저하가 확인됐지만, 같은 조건의 Pro 점수는 공개되지 않았다. 이를 Pro의 승리로 단정하기보다 아직 결론이 나지 않은 항목으로 보는 편이 맞다. 이 차이는 종합 Intelligence Index 하나보다 어떤 작업을 돌리는지에 더 직접적으로 연결된다.
BenchLM의 비교 방법론에는 한 가지 주의할 점도 있다. 두 모델 모두 결과가 공개된 약 34개 벤치마크 가운데 직접 비교할 수 있는 범주는 3개뿐이다. Pro만 결과가 있는 벤치마크는 14개, Flash만 있는 벤치마크는 17개이며, 두 모델의 thinking-budget 설정도 항상 같지는 않다. 위 표는 큰 방향을 파악하는 용도로는 신뢰할 만하다. ARC-AGI-2와 MRCR v2의 차이는 충분히 크지만, 공통 지표에서 1~2점 차이가 난다고 결정적 우위로 읽기는 어렵다.
Flash의 우세가 멈추는 지점
BenchLM 비교에서 두 모델 간 가장 큰 단일 범주 차이는 ARC-AGI-2의 5포인트 격차다. ARC-AGI-2는 패턴 매칭으로 쉽게 푸는 방식을 막도록 설계된 벤치마크다. 따라서 일반적인 벤치마크에서 비슷한 점수 차이가 나는 것보다, 여기서의 5포인트 차이가 추론 깊이에 관한 더 강한 신호다. nxcode의 MRCR v2 결과도 같은 방향의 단서를 하나 더 제공한다. 컨텍스트가 128k 토큰에 가까워질수록 Flash의 검색 정확도는 84.9%에서 77.3%로 하락한다. 같은 길이에서 Pro의 점수는 공개되지 않았으므로 Pro가 Flash를 이겼다는 직접 비교 결과는 아니다. 다만 Flash에 성능 저하가 있다는 사실은 확인됐고, Pro의 벤치마크 표만으로는 드러나지 않는다.
일화 수준의 참고 사항이며 벤치마크 증거는 아니다: 어려운 작업에 어떤 모델을 선호하는지 물은 Reddit r/GeminiAI 스레드에서 일부 사용자는 Flash가 "긴 컨텍스트와 추상적 [추론]을 제외한 모든 면에서" Pro를 이긴다고 말했다. 소수의 의견일 뿐 데이터는 아니다. 다만 벤치마크가 보여주는 두 가지 예외와 우연히 일치한다는 점에서, 독립적인 증명이라기보다 가벼운 현실성 점검 정도로는 볼 수 있다.
가격과 캐싱 비용, 실제 차이는 어디서 나나
기본 가격만 보면 처음 생각하는 것보다 격차는 크지 않다.
- Gemini 3.5 Flash: 입력 100만 토큰당 $1.50, 출력 100만 토큰당 $9
- Gemini 3.1 Pro: 입력 100만 토큰당 $2, 출력 100만 토큰당 $12
표면상 25% 할인이다. Flash가 이전 세대 Pro 모델 대비 가졌던 4~8배 수준의 격차와는 다르다. 비용을 더 크게 가르는 요소는 캐싱이다.
- Flash의 캐시 쓰기 비용은 무료이며, 캐시된 입력은 100만 토큰당 $0.15다.
- Pro의 캐시 쓰기 비용은 100만 토큰당 $0.38이고, 캐시된 입력은 100만 토큰당 $0.50이다. Flash의 캐시 입력 단가보다 3배 이상 높다.
같은 시스템 프롬프트나 문서 컨텍스트를 여러 턴에 걸쳐 반복 전송하는 워크플로에서는 이 차이가 빠르게 누적된다. 채팅 에이전트, 코드베이스 컨텍스트를 유지하는 코딩 어시스턴트, 다중 턴 지원 봇이 대표적이다. 요청 한 번에서는 차이가 작지만, 1,000턴짜리 에이전트 세션에서는 다르다.
다만 가격 차이가 항상 일정한 것은 아니다. apiyi의 가격 분석에 따르면 컨텍스트가 대략 200k 토큰을 넘으면 두 모델의 가격 차이는 25~50%까지 줄어든다. 이 규모에서는 두 모델의 토큰당 비용 구조가 가까워지기 때문이다. 짧은 반복 호출보다 매우 긴 단발성 문서가 대부분인 워크로드라면 Flash의 가격 우위도 약해진다.
계산 예시: 하루에 캐시된 입력 100만 토큰을 보내고 출력 50만 토큰을 생성하는 지원 봇을 생각해 보자. Flash는 캐시 쓰기 비용이 $0이고, $0.15 x 1(캐시 입력) + $9 x 0.5(출력)으로 하루 $4.65다. Pro는 같은 워크로드에서 $0.38(캐시 쓰기, 1회) + $0.50 x 1(캐시 입력) + $12 x 0.5(출력)으로 첫날 약 $6.88이 든다. 첫 쓰기 이후에는 하루 $6.50이다. 한 달로 보면 약 $140과 $195의 차이다. 물론 실제로 깊은 추론이 필요한 요청에서 Pro가 제공하는 이점은 여기에 반영하지 않은 수치다.
에이전트 루프: Flash는 빠르지만 언제나 더 안정적이진 않다
nxcode의 에이전트 루프 벤치마크는 8단계 에이전트 루프를 실행했다. Flash는 전체 시퀀스를 약 25초에 마친 반면 Pro는 100초가 걸렸으며, 약 4배 차이는 단계가 늘어날수록 누적된다. 실제 지식 노동형 에이전트 작업을 중심으로 구성된 GDPval-AA에서도 Flash의 Elo 점수는 1656으로 Pro의 1314보다 342포인트 높다. 이는 전체 벤치마크 표에서 가장 큰 격차다.
다만 이 속도와 점수 우위는 에이전트 루프가 매끄럽게 진행된다는 전제가 있어야 한다. 추론과 긴 컨텍스트 작업에서 나타난 ARC-AGI-2 및 MRCR v2의 차이를 고려하면, 루프 도중 도구 호출이 예상 밖의 결과를 반환해 에이전트가 계획을 다시 세워야 할 때 Flash의 대응 여유가 더 적을 것으로 추정할 수 있다. 이는 앞선 추론 깊이 데이터를 바탕으로 한 추론일 뿐, 별도 벤치마크로 입증된 주장은 아니다. 단계마다 사람이 결과를 확인하는 감독형 에이전트라면 Flash의 속도는 거의 손해 없는 이점에 가깝다. 반대로 사람 개입 없이 여러 단계를 수행하는 비감독형 에이전트라면, 두 모델의 실패율 데이터가 나오기 전까지는 Pro의 추론 우위가 더 안전한 선택이다.
작업별로 고르는 Gemini 3.5 Flash와 Gemini 3.1 Pro
| 작업 유형 | 권장 모델 | 이유 |
|---|---|---|
| 일상적인 코딩(테스트, PR 리뷰, 언어 간 변환) | Flash | 속도와 비용에서 유리하며, 추론 깊이가 병목이 되지 않는다. |
| 대규모 리팩터링, 새로운 알고리즘 설계 | Pro | ARC-AGI-2 격차가 여러 단계의 논리 추론에서 직접 드러난다. |
| 긴 문서 검색(128k 토큰을 넘는 계약서, 연구 자료) | Pro | Flash는 이 길이에서 MRCR v2 성능 저하가 확인됐다. Pro의 결과는 공개되지 않았지만, 알려진 약점이 없는 모델이 더 안전한 기본 선택이다. |
| 대량 배치 생성 | Flash | 규모가 커질수록 무료 캐시 쓰기와 2.6배 처리량이 가장 중요하다. |
| 사람이 출력을 확인하는 감독형 에이전트 워크플로 | Flash | 비감독형 신뢰성 위험 없이 속도 이점을 활용할 수 있다. |
| 고위험 비감독형 에이전트 체인 | Pro | 루프 중간 오류를 사람이 잡아주지 않는다면 추론 깊이의 여유가 더 안전하다. |
| 같은 컨텍스트를 재사용하는 잦은 다중 턴 호출 | Flash | 캐시 입력 가격이 Pro의 약 3분의 1 수준이다. |
대부분의 경우에는 간단한 기본 규칙으로 충분하다. 컨텍스트가 128k 토큰을 넘고 검색 정확도가 중요하거나, 작업이 추상적·다단계 추론에 해당하거나, 에이전트가 사람 개입 없이 몇 단계 이상 실행되는 경우가 아니라면 Flash로 보내면 된다. 이 세 조건 중 하나라도 해당하면 Pro 쪽이 더 적합하다. 어느 조건에도 해당하지 않는다면 Flash의 속도와 캐시 가격이 더 저렴한 기본값이 된다.
FAQ
Gemini 3.5 Flash가 3.1 Pro보다 더 좋은가요?
속도, 비용, 범용 벤치마크 기준으로는 그렇다. 다만 추상 추론을 측정하는 ARC-AGI-2에서는 Gemini 3.1 Pro가 5포인트 앞선다. 128k 토큰을 넘는 긴 컨텍스트 검색에서는 Flash의 성능 저하가 확인됐지만, 같은 조건의 Pro 점수는 공개되지 않았다. 따라서 Pro의 확정 승리로 보기보다 미해결 비교로 다뤄야 한다. 어느 모델이 더 좋은지는 작업이 어느 범주에 속하는지에 달려 있다.
Gemini 3.5 Flash는 3.1 Pro보다 얼마나 저렴한가요?
기본 입출력 가격 기준으로 약 25% 저렴하다. 100만 토큰당 $1.50/$9와 $2/$12의 차이다. 더 큰 절감은 캐싱에서 나온다. Flash는 캐시 쓰기가 무료이고 캐시 입력 단가도 Pro의 약 3분의 1이므로, 다중 턴 또는 대량 워크로드에서 특히 차이가 크다.
Gemini 3.5 Flash는 코딩에 적합한가요?
테스트 생성, PR 리뷰, 언어 간 코드 변환 같은 일상적인 작업에는 적합하다. 다만 깊은 리팩터링이나 새로운 알고리즘 설계에서는 Pro의 추상 추론 벤치마크 우위가 결과물 품질로 이어지는 경향이 있다.
Gemini 3.5 Flash는 긴 컨텍스트를 잘 처리하나요?
짧은 컨텍스트 길이에서는 그렇다. MRCR v2 검색 정확도는 84.9%를 유지한다. 그러나 128k 토큰을 넘으면 77.3%로 내려가며, 여러 문서에 걸친 계약서 검토 같은 작업에서는 의미 있는 차이다. 같은 길이에서 Gemini 3.1 Pro의 점수는 공개되지 않았으므로, 이를 Pro의 확정 우위가 아니라 Flash의 알려진 한계로 보는 것이 맞다.
결론
Gemini 3.5 Flash는 대부분의 일상 작업과 대량 처리 작업에서 더 나은 기본 선택이다. 속도가 빠르고 캐싱 비용이 낮으며, 범용 벤치마크에서도 차이가 실제 선택을 바꿀 정도로 크지 않은 경우가 많다. 반면 Gemini 3.1 Pro는 추상 추론과 비감독형 에이전트 체인에서 더 높은 비용을 정당화한다. 128k 토큰을 넘는 긴 문서에서는 Flash 자체 수치가 약점을 보여준다. Pro가 이를 확실히 해결한다고 확인된 것은 아니므로, 어느 쪽으로 결정하기 전에 직접 테스트해 볼 만한 영역이다.
이 비교는 직접 API를 테스트한 결과가 아니라 Artificial Analysis, BenchLM, nxcode, apiyi가 공개한 벤치마크 데이터를 바탕으로 작성했다. Gemini 3.1 Pro는 Flash의 속도 중심 포지셔닝과 달리 추론에 초점을 맞춰 출시됐다. 작성 시점 기준 Gemini 3.5 Pro는 아직 출시되지 않았다. 보도에 따르면 2026년 7월 출시가 예상된다. 따라서 Pro의 다음 버전이 나오면 두 모델과 이 비교 모두 다시 검토할 필요가 있다.