 AIREITER
"Sonnet 5 is close to Opus 4.8, but cheaper"는 Anthropic의 자체 홍보 문구입니다. 우리는 이 말이 언제부터 사실이 아니게 되는지 알고 싶어서, Claude Code CLI를 통해 동일한 네 가지 작업을 두 모델 모두에 실행하고 각 API 응답에서 실제 비용, 소요 시간, 도구 호출 횟수를 기록했습니다. 가장 중요했던 것은 Sonnet 5의 xhigh effort를 높여 Opus 4.8이 기본적으로 수행하는 수준과 맞추는 것이었고, 그렇게 하자 우리가 측정한 가격 차이는 거의 사라졌습니다. 반면 Opus 4.8은 대략 절반의 시간 만에 완료되었습니다.
Sonnet 5 vs Opus 4.8 한눈에 보기
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
출시 | 2026년 6월 30일 | |
컨텍스트 창 | 1M tokens | 1M tokens |
최대 출력 | 128K tokens | 128K tokens |
가격(in/out per 1M tokens) | $5/$25 | |
빠른 모드 | 지원되지 않음 | 지원됨(연구 미리보기), 프리미엄 가격으로 최대 약 2.5배 출력 속도 |
노력 수준 | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
포지셔닝 | 더 저렴한, 에이전틱 중심의 Sonnet 계열 모델 | Anthropic의 플래그십, 최고 정확도 옵션 |
컨텍스트 윈도우와 최대 출력은 동일하므로 여기서는 차별점이 아닙니다. 차별화되는 한 가지는 Sonnet 5가 Anthropic에 따르면 같은 텍스트에 대해 Sonnet 4.6보다 "약 30% 더 많은 토큰"을 생성하는 새로운 tokenizer에서 실행된다는 점입니다. 따라서 Sonnet 4.6에서 가져온 max_tokens 예산이나 비용 추정치는 그대로는 적용되지 않습니다.
공식 벤치마크 비교
Anthropic의 자체 공개 내용과 llm-stats.com의 제3자 분석을 함께 보면, 패턴은 일관됩니다: Sonnet 5는 몇몇 벤치마크에서 이기거나 동률을 이루고, Opus 4.8은 대부분의 다른 항목에서 앞서며, 보통 한 자릿수 차이입니다.
벤치마크 | Sonnet 5 | Opus 4.8 | 차이 |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | 거의 동률 |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
두 가지가 눈에 띕니다. Opus 4.8의 가장 큰 우위는 코딩이 아니라 어려운 수학(USAMO)에서이며, 코딩 격차(SWE-bench, Terminal-Bench)는 모두 한 자릿수이고, Sonnet 5는 실제로 그중 하나에서 완전히 앞섭니다. 도구가 보강된 일반 추론(HLE with tools)에서는 둘이 거의 비슷해 사실상 동률이라고 볼 수 있습니다.
이것은 능력 벤치마크는 아니지만, 주목할 만한 안전 수치도 있습니다. 같은 공개 자료에 따르면, 추가적인 보호 장치가 없는 browser-use 시나리오에서 Sonnet 5의 측정된 prompt-injection 공격 성공률은 0.93%였던 반면, Opus 4.8은 31.5%였습니다. Anthropic은 이 특정 격차에 대한 자세한 설명을 아직 공개하지 않았습니다. 열린 웹을 감독 없이 탐색하는 agentic한 무언가를 구축하고 있다면, 플래그십 모델이 자동으로 더 안전한 기본값이라고 가정하기보다는 자체 보호 장치를 직접 테스트해 보는 것이 좋습니다.
우리는 직접 네 번의 일대일 테스트를 수행했습니다
현재 나와 있는 것들 대부분은 위의 공식 벤치마크 표를 집계하거나, 주관적인 단일 모델 인상을 공유하는 수준입니다. 우리는 통제된 동일 프롬프트 기준의 비용 및 지연 시간 비교를 찾지 못해, 직접 수행했습니다.
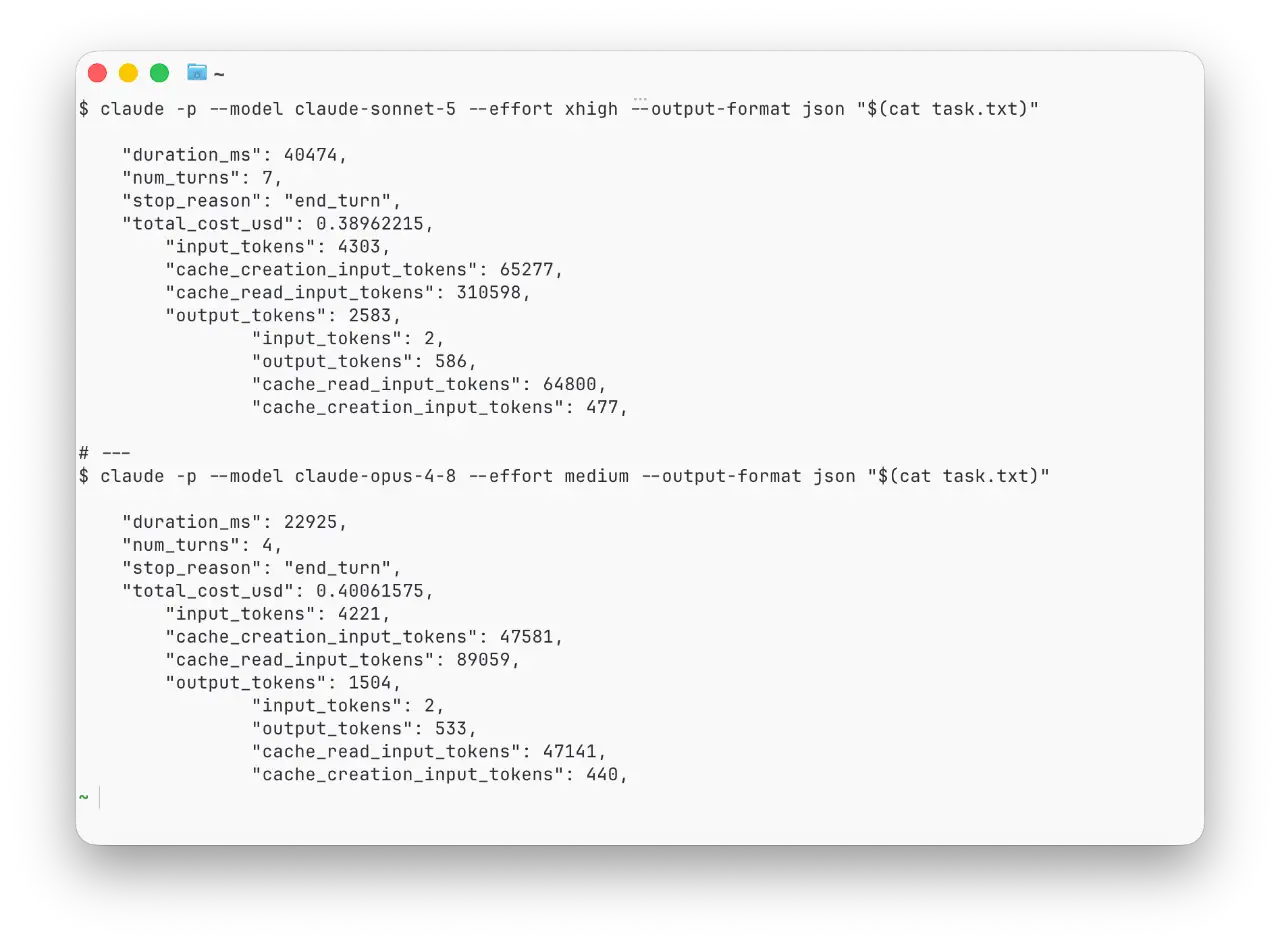
방법론: 2026-07-01에 실행된 네 개의 작업으로, Claude Code CLI를 통해 각 작업마다 동일한 프롬프트를 claude-sonnet-5 및 claude-opus-4-8 에 전송했습니다(claude -p --model <id> --effort <level> --output-format json). 비용, 소요 시간, 턴 수는 토큰 수에서 추정한 것이 아니라 각 실행의 API 응답에서 직접 읽어온 값입니다. 각 모델/effort 구성은 작업당 한 번씩만 실행되었으며, 이는 단일 실행에서 얻은 실제 수치이지 통계적으로 평균화된 표본이 아닙니다. 각 격차의 크기는 정확한 값이라기보다 방향성을 나타내는 것으로 보아야 하며, 우리가 수행한 모든 테스트에서 그 방향은 일관되었습니다.
테스트 1: 비용 역전 확인
가장 답하고 싶었던 질문은 이것입니다. 더 어려운 작업을 보완하기 위해 Sonnet 5의 effort level을 높였을 때도 여전히 더 저렴한가? 우리는 Test 2(아래)와 동일한 코딩 작업을 Sonnet 5 xhigh 와 Opus 4.8 medium에서 실행했습니다.
설정 | 비용 | 소요 시간 | 턴 수 | 결과 |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
3%의 비용 차이 — 사실상 무승부 — 이고 Opus 4.8는 더 낮은 노력 설정에서 거의 절반의 턴만 사용해 57%의 시간에 작업을 끝냈습니다. 둘 다 올바르고 작동하는 코드를 만들어냈습니다. 이는 사람들이 이미 Hacker News에서 지적하고 있는 내용과도 일치합니다: 그곳의 한 댓글 작성자는 비슷한 작업에 대해 Opus 4.8은 medium reasoning에서 대략 $0.45, Sonnet 5는 xhigh/max에서 대략 $0.52의 비용이 든다고 추정했습니다.
테스트 2: 동일한 노력의 코딩 과제
동일한 프롬프트, 두 모델 모두 high 노력: 효율적인 최장 팰린드롬 부분 문자열 함수를 작성하고, 엣지 케이스를 포함하는 테스트 케이스를 생성하고, 실행한 다음, 실패하는 부분을 수정합니다.
설정 | 비용 | 소요 시간 | 턴 수 | 결과 |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
둘 다 동일한 중심 확장 방식에 도달했고 첫 실행에서 모든 테스트를 통과했습니다. Opus 4.8은 더 적은 턴 수로 더 빨리 도달했지만, 비용은 약 16% 더 들었습니다. 품질이 동일하다면, 이 경우에는 속도만으로 Opus가 승리합니다.
테스트 3: 글쓰기 / 지식 작업
단일한 정답이 없는 비즈니스 판단 프롬프트: Series A 마감 6주 전인 12명 규모의 SaaS 회사에 재해 복구를 위해 두 번째 AWS 리전으로 마이그레이션하는 데 3~4주를 투자할지 조언하라.
설정 | 비용 | 지속 시간 | 턴 수 |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
두 모델 모두 본질적으로 같은 권고를 했습니다 — 전체 마이그레이션은 건너뛰고 대신 가벼운 백업/런북을 배포하라 — 그리고 추론 품질도 비슷했습니다. Sonnet 5는 약 3분의 2 정도의 시간에 도달했고 비용은 14% 더 적게 들었습니다. 이것은 “Sonnet 5는 지식 업무에서 충분히 괜찮다”는 점이 깔끔하게 드러난 유일한 테스트였습니다.
테스트 4: 에이전틱 조회 — Sonnet 5는 정말 "과도하게 생각"하는가?
일부 Reddit 스레드는 Sonnet 5가 Opus 4.8보다 단순한 요청에 대해 과도하게 생각하는 경향이 더 강하다고 설명합니다. 우리는 정말로 단순한 한 가지를 테스트했습니다: 디렉터리 트리 내 모든 .py 파일의 바이트 크기를 합산하고, 어느 하위 디렉터리에 그 파일이 가장 많은지 보고하는 것입니다.
설정 | 비용 | 지속 시간 | 턴 수 |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
둘 다 동일한 정답에 도달했습니다. 비용 차이는 반올림 오차 수준이었지만, Sonnet 5는 도구 호출을 한 번 더 사용했고 약 50% 더 오래 걸렸습니다. 이는 "과도한 사고"라는 불만에 대해 작지만 분명한 실제 데이터 포인트이며, Test 1과도 일치합니다: Sonnet 5는 같은 결론에 도달하기 위해 더 많은 단계를 거치는 경향이 있습니다.
그렇다면 실제로 어떤 것을 사용해야 할까요?
속도가 중요한 코딩 작업이나 많은 도구 호출이 있는 에이전틱 워크플로, 또는 Sonnet 5의 effort를 신뢰하기 위해
high보다 더 올리고 싶어질 만한 어떤 작업이든 Opus 4.8을 선택하세요 — 바로 그런 상황에서 Sonnet 5의 비용 우위는 사라집니다.대량 처리되며 예산에 민감한 작업과 일반 지식/글쓰기 작업에는 Sonnet 5를 선택하세요. 다만
medium또는higheffort로 유지하세요. “안전하게” 하려고 반사적으로xhigh로 올리지는 마세요 — 바로 그 지점에서 가격 측면의 장점이 무너집니다.둘 다 괜찮습니다 간단한 조회와 단일 턴 요청의 경우; 우리가 측정한 실질적인 차이는 틀린 답이 아니라 턴 한 번 추가와 몇 초 정도였습니다.
자주 묻는 질문
Claude Sonnet 5가 실제로 Opus 4.8보다 더 저렴한가요?
같은 노력 수준에서는, 예 — 눈에 띄게 그렇습니다. 하지만 더 어려운 작업을 보완하려고 Sonnet 5를 xhigh 로 올리면 격차가 몇 퍼센트까지 줄어들 수 있는 반면, 더 낮은 노력 설정의 Opus 4.8은 더 빨리 완료됩니다. 돈을 절약하고 있다고 가정하기 전에 실제로 어떤 노력 수준으로 실행 중인지 확인하세요. Haiku, Sonnet, Opus 전반의 전체 가격표는 Claude API pricing guide를 참조하세요.
Claude Sonnet 5와 Sonnet 4.6은 어떤가요?
세대 업그레이드이지, 모델 티어 선택은 아닙니다 — 그리고 비용도 그 방향으로는 움직이지 않습니다. Sonnet 5는 Terminal-Bench에서 Sonnet 4.6을 두 자릿수 차이로 앞서지만, 저희가 직접 진행한 일대일 비용 테스트에서는 새 tokenizer 때문에 시도한 모든 노력 수준에서 Sonnet 5가 Sonnet 4.6보다 더 비싼 것으로 나왔습니다. 전체 테스트와 수치는 Sonnet 5 vs Sonnet 4.6: Is It Actually Cheaper?에서 확인하세요.
Claude Sonnet 5와 Opus 4.6를 비교하는 것은 공정한 비교인가요?
그렇지 않습니다 — Opus 4.6은 Opus 4.8보다 한 세대 뒤처져 있습니다. 오늘 무엇을 사용할지 결정하고 있다면, 이전 모델이 아니라 Opus 4.8과 비교하세요.
두 모델 간에 컨텍스트 윈도우가 다른가요?
아니요 — 둘 다 1M 토큰 컨텍스트 창과 128K 최대 출력을 제공합니다.
브라우저 사용에서 Opus 4.8의 프롬프트 인젝션 비율이 왜 그렇게 더 높은가?
Anthropic의 공개에 따르면, 추가적인 보호장치가 없는 경우 31.5%였으며, Sonnet 5의 0.93%와 비교됩니다. 특히 비감독 브라우저 사용 시나리오에서 그렇습니다. Anthropic은 이에 대한 자세한 설명을 공개하지 않았습니다. 이를 플래그십 모델이 자동으로 더 안전한 기본값이라고 가정하기보다는, 귀하의 특정 보호장치를 테스트해야 하는 이유로 받아들이십시오.
부록: 정확한 프롬프트와 원시 출력
이를 재현하고 싶은 분들을 위해, 각 테스트에 보낸 정확한 프롬프트를 아래에 적었습니다(Test 1과 Test 2는 같은 코딩 프롬프트를 사용했으며, 단지 서로 다른 노력 수준으로 설정했습니다).
테스트 1 & 2 — 코딩 프롬프트:
`longest_palindromic_substring(s: str) -> str` Python 함수를 작성하세요. 이 함수는
s의 가장 긴 회문 부분 문자열을 반환해야 하며, brute-force O(n^3)보다 더 효율적인 접근 방식(예: 중심 확장 또는 Manacher의 알고리즘)을 사용해야 합니다. 이를
solution.py에 저장하세요.

그다음 최소 6개의 테스트 케이스를 포함하는 test_solution.py를 작성하세요. 다음을 포함해야 합니다: 빈 문자열,
단일 문자, 모두 같은 문자, 길이 1보다 긴 회문이 없는 경우, 짝수 길이 회문, 그리고 홀수 길이 회문.

pytest로 테스트를 실행하고 모두 통과하는지 확인하세요. 실패가 있으면, 코드를 수정하고
모두 통과할 때까지 다시 실행하세요. 최종 pytest 출력을 보고하세요.
테스트 3 — 글쓰기/지식 작업 프롬프트:
당신은 작은 SaaS 회사(직원 12명, 월 반복 매출(MRR) $80k, 현재 단일 AWS 리전 사용)에 조언하고 있습니다. 이 회사는 6주 후 마감되는 Series A 자금 조달 전에 재해 복구를 위해 두 번째 AWS 리전으로 확장해야 할지 검토 중입니다. 엔지니어링 팀의 추정에 따르면 마이그레이션에는 3~4주가 걸리며, 그 기간 동안 팀 역량의 대부분을 소모해 고객이 요청한 두 가지 기능이 지연됩니다.

약 350단어 분량의 경영진 권고안을 작성하세요: 지금 바로 해야 할까요, 미뤄야 할까요, 아니면 중간 경로를 찾아야 할까요? 상충 관계를 근거로 정당화하세요. 서문은 없이, 권고안만 작성하세요.
테스트 4 — 에이전틱 조회 프롬프트:
현재 디렉터리 트리에서 .py 확장자를 가진 모든 파일을 찾아 총 바이트 크기를 합산하고, 작업 디렉터리의 즉시 하위 디렉터리 중 어떤 하나의 하위 디렉터리가 개수 기준으로 가장 많은 .py 파일을 포함하는지 알려주세요. 두 개의 숫자/답변만 주세요. 새 파일을 작성할 필요는 없습니다.
Test 1에서 실행한 Sonnet 5 (xhigh)의 실제 API 응답이며, 비용과 시간에 관련된 필드만 남기고 잘라낸 것입니다:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
그것이 해당 실행에 대해 Claude Code CLI가 반환한 편집되지 않은 total_cost_usd, duration_ms, 그리고 토큰 수입니다 — 위의 Test 1 표에 있는 숫자들은 이러한 필드에서 직접 가져온 것이며, 실행당 JSON 응답 하나씩입니다.