 AIREITER
Baiduのモデルに同梱される設定ファイルでは、max_position_embeddingsが32,768に設定されている。「Unlimited」という名称を文字どおりには受け取れない理由はここにある。Unlimited OCRは、ページ単位で繰り返していたOCR処理を1回のフォワードパスへまとめられる。ただし対象は32Kトークンの枠に収まる文書であり、スキャン品質もある程度は良好でなければならない。
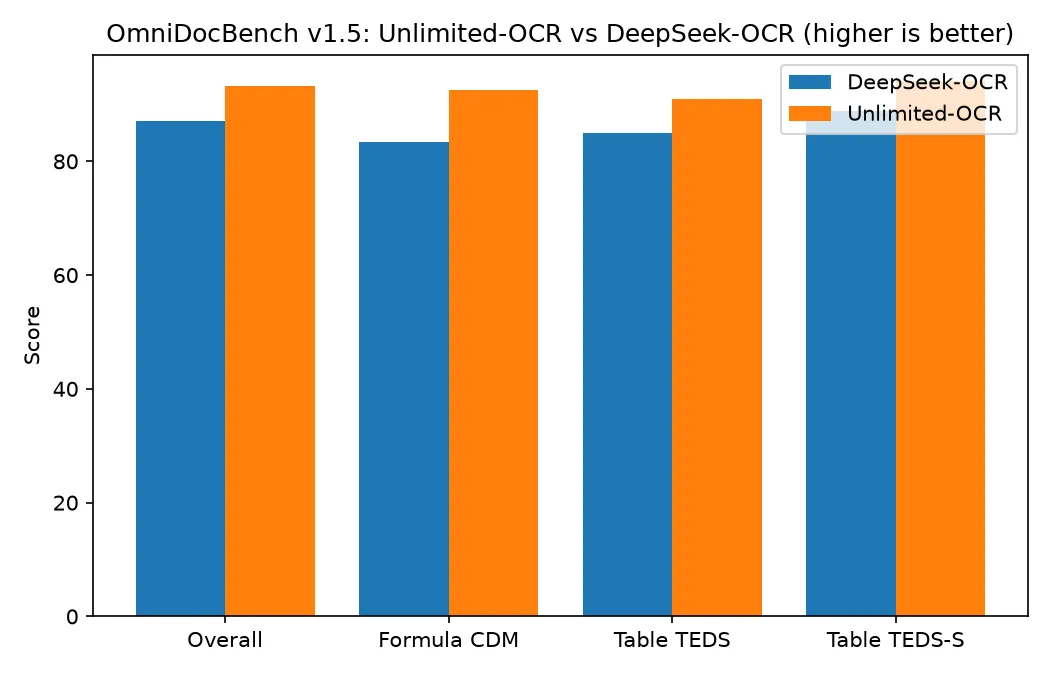
もっとも、この制約を差し引いてもリリース内容は強力だ。重みはMITライセンスで公開され、safetensorsのメタデータではBF16で3,336,106,240パラメータ。OmniDocBench v1.5では、ベースとなったDeepSeek-OCRの87.01に対して総合93.23を記録している。Hugging Faceでは、2026-07-29時点の過去30日間ダウンロード数が2,694,935、いいねは3,389だった。
Unlimited OCRにもある32Kトークンの上限
複数ページ処理では、各ページを1024×1024でエンコードし、16分の1まで圧縮して約256個の視覚トークンにする。コードを書く前でも、1回の処理に何ページを入れられるかはこの数字から見積もれる。
| 1回で処理するページ数 | 視覚トークン(prefill) | 出力に残るトークン数 | 1ページ当たりの予算 |
|---|---|---|---|
| 10 | ~2,560 | ~30,200 | ~3,020 |
| 20 | ~5,120 | ~27,600 | ~1,380 |
| 40 | ~10,240 | ~22,500 | ~560 |
スライド資料や余白の多い契約書なら、40ページでも十分に収まる。一方、密な2段組の新聞紙面では、1ページだけで560 markdownトークンを超えることがある。この種の入力では、実用上の上限は40ページをかなり下回る。論文も、ページ数に応じてprefillが増える以上、有限のコンテキスト長で解析を真に無制限にはできないと明記している。Baiduが示すロードマップには、128Kコンテキスト版と、必要に応じてページチャンクを取り出す「prefill pool」がある。この名称が意味するのはキャッシュ容量に対するデコード長の無制限性であって、ページ数が無制限という意味ではない。
R-SWAで変わった部分、変わらない部分
DeepSeek-OCRからの変更点は2つだ。SAM-ViT-BとCLIP-Lを連結したDeepEncoderのビジョンスタックは維持され、学習中も凍結されていた。代わりにデコーダーの全アテンション層をReference Sliding Window Attentionへ置き換えている。生成トークンは、参照トークン全体――視覚トークンとプロンプト――を参照できる一方、出力側は直近128トークンだけを見る。config.jsonにも、sliding_window_size: 128、デコーダー12層、ルーテッドエキスパート64個、トークンごとに有効なエキスパート6個と記載されている。
改善は特定の指標に限られず、長い生成でも保持されるページ要素で幅広く現れている。OmniDocBench v1.5では、数式CDMが83.37から92.61へ、表のTEDSが84.97から90.93へ上昇した。読み順の編集距離も0.086から0.045へ半減している。エンコーダー自体は再学習していないため、この差分はより強い視覚スタックではなく、デコーダー変更によるものだ。
裏を返せば、エンコーダーが苦手だったものは新モデルでも苦手なままだ。長く生成できても、色あせたFAXの文字認識精度まで向上するわけではない。
速度差が効くのは出力が長いときだけ
出力256トークン時点では、両モデルはほぼ同じだ。7,229.52対7,229.32トークン/秒となる。差が開くのは生成が続いてからで、出力6,144トークンではベースラインが5,822.87まで低下するのに対し、Unlimited OCRは7,847.71を維持する。およそ35%高速だ。
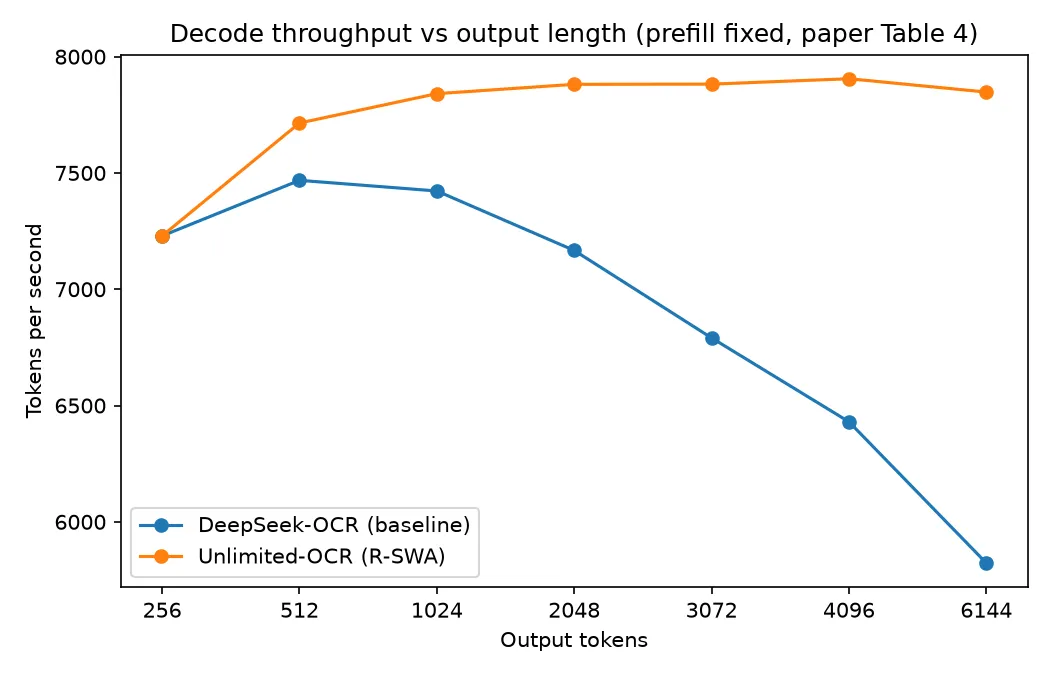
ただし、baseモード・同時実行512で行ったOmniDocBench全体の実行では、差は12.7%まで縮まる。Unlimited OCRが5,580、ベースラインが4,951トークン/秒だ。バッチ処理ではステップごとのアテンションコストの多くがすでに隠蔽されるためである。同時実行数の多い単一ページ請求書処理では、R-SWAによる恩恵はほとんどない。
40ページまでは精度を保つが、その先では崩れ始める
論文では、1回のパスで処理したページ数ごとの編集距離を報告している。この曲線はフラットではない。
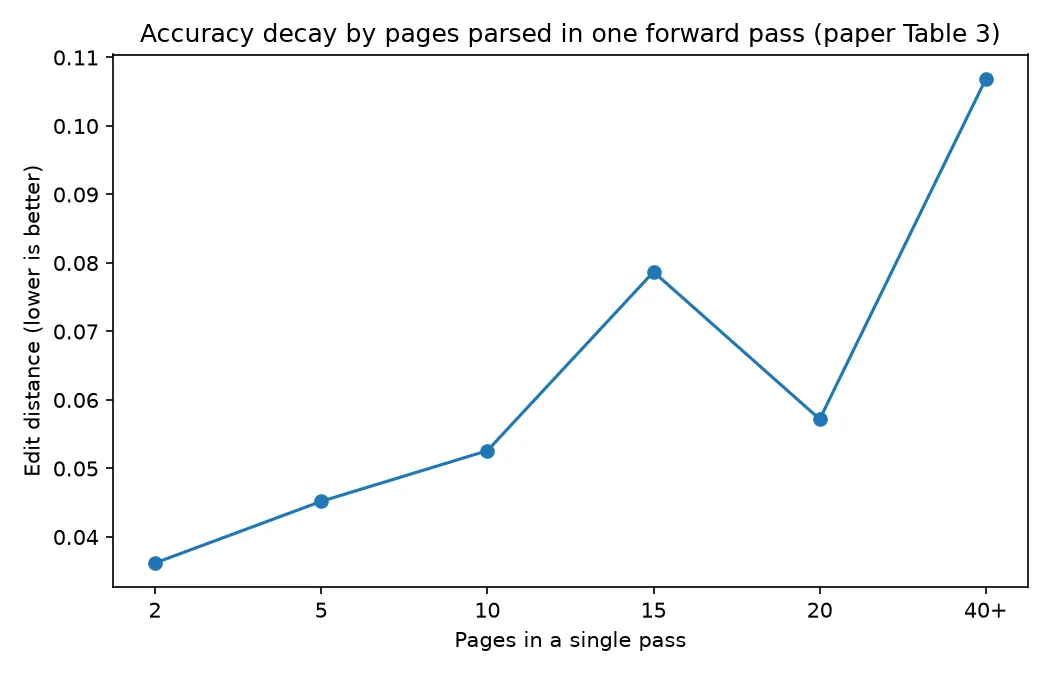
2ページでは0.0362、10ページでは0.0526、40ページ以上では0.1069に達する。Distinct-35も約99.9%から96.90%へ下がっており、出力に繰り返しn-gramが現れ始めることを示す。15ページ時の測定値0.0787が20ページ時の0.0572より悪いため、ページ数ごとの保証値ではなく傾向として読むべきだ。Baiduは反復エラーの主因をアテンションのドリフトではなく、1024×1024というベース解像度での小さな文字にあるとしている。これは設計上のトレードオフとも一致する。複数ページおよびPDF入力では、単一画像で使える高精細なcropモードを利用できない。
「8 GBで動く」をVRAM使用量から読み解く
vLLMのレシピでは、BF16推論には8 GB以上の単一GPUで十分とされている。しかしコミュニティの報告はそれと一致せず、その隔たりはモデル自身の設定を見ると説明できる。
単一のsafetensorsファイルは6.673 GBある。キャッシュ側の計算には、config.jsonの4項目、num_hidden_layers: 12、num_attention_heads: 10、num_key_value_heads: 10、v_head_dim: 128と、use_mla: falseを使う。queryヘッド数とkey/valueヘッド数が同じなので、GQAやMQAの共有による削減がない通常のMHAだ。トークン当たりのキャッシュは、2(KとV)×12層×10ヘッド×128次元×2バイト = 61,440バイト、すなわち60 KiBとなる。ここから3つの数字が出る。
- 32Kをフルでprefillする場合:32,768 × 60 KiB = 1.875 GiBのキャッシュ
sliding_window_size: 128で上限が決まるR-SWAのデコード側:一定で7.5 MiB- R-SWAなしの同じデコーダーで出力6,144トークンの場合:線形に増える360 MiB
これはピークアロケーションではなく、理論上のキャッシュサイズだ。この上にビジョンエンコーダーのアクティベーション、アロケーターの断片化、エンジンが事前確保するキャッシュブロックが乗る。そのため、重みに長いprefillが加わると8 GBカードはすぐに厳しくなる。16 GBのRTX 4070 Ti Superで行われたローカルSGLang実行の報告では、使用量は約12 GBだった。これはこの計算と整合的だが、計算そのものの証明ではない。8 GBという数字は、40ページ処理の仕様ではなく、短い単一ページを扱う最低ラインとして受け止めるべきだ。
この数字から、R-SWAで何が得られるかも見えてくる。このモデル規模では、デコードキャッシュにより削減できるのは数GBではなく数百MBだ。実運用で効くのは、ステップごとのアテンションコストが増え続けなくなることにあり、それを示しているのがスループット曲線である。
公式APIはない。実際の動かし方
Hugging Faceのモデルページには「This model isn't deployed by any Inference Provider.」と表示される。ファーストパーティーのエンドポイントも、Baiduによるホスティング価格ページもない。自前でサーブする方法は、trust_remote_codeを使うTransformers、SGLang、またはvLLMレシピの3つだ。vLLMでは、アーキテクチャーがまだ安定版pip wheelに含まれていないため、専用のvllm/vllm-openai:unlimited-ocrコンテナからvLLM 0.25.0以降を使う必要がある。
出力を得られるかどうかは、次の4設定で決まる。
- n-gram logits processorを登録する:
NGramPerReqLogitsProcessorなしでは、長文書の生成が<|det|>座標トークンをループする。 - n-gramとウィンドウサイズを指定する:単一画像では
ngram_size: 35とwindow_size: 128、複数ページまたはPDF入力では1024を設定する。 - テキストの先頭を
<image>にする:<image>Multi page parsing.のように、リテラルの<image>トークンから始める。モデルにはchat templateが同梱されていない。 skip_special_tokens: Falseを渡す:デフォルトのままだと空文字列が返る。
生の生成結果にはgrounding用マークアップが含まれる。きれいなmarkdownが必要なら、<|ref|>内のテキストを残し、<|det|>のバウンディングボックスを捨てればよい。ページ境界もネイティブには出力されないため、監査証跡で必要ならプロンプト内でページラベルを出すよう指示する。
レシピで動作確認されているサーバーとリクエストは次のとおりだ。
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Hopperカードではunlimited-ocr-cu129イメージタグを使う。また、1リクエスト内に複数画像を渡す場合は非cropのbaseモードにフォールバックする。このケースではwindow_size: 1024が必要になる。
1,000ページ当たりのコスト:自前運用とマネージドAPI
オープンウェイトは無料でも、実行コストは無料ではない。公開されている数少ない実測のひとつが、Hacker Newsのスレッドに投稿された事例だ。Transformersを使い、RTX 4090で日本語文法PDFを約200ページ/時のペースで変換したという。比較対象として、RunPodのCommunity料金では4090が1時間当たり$0.34だ。
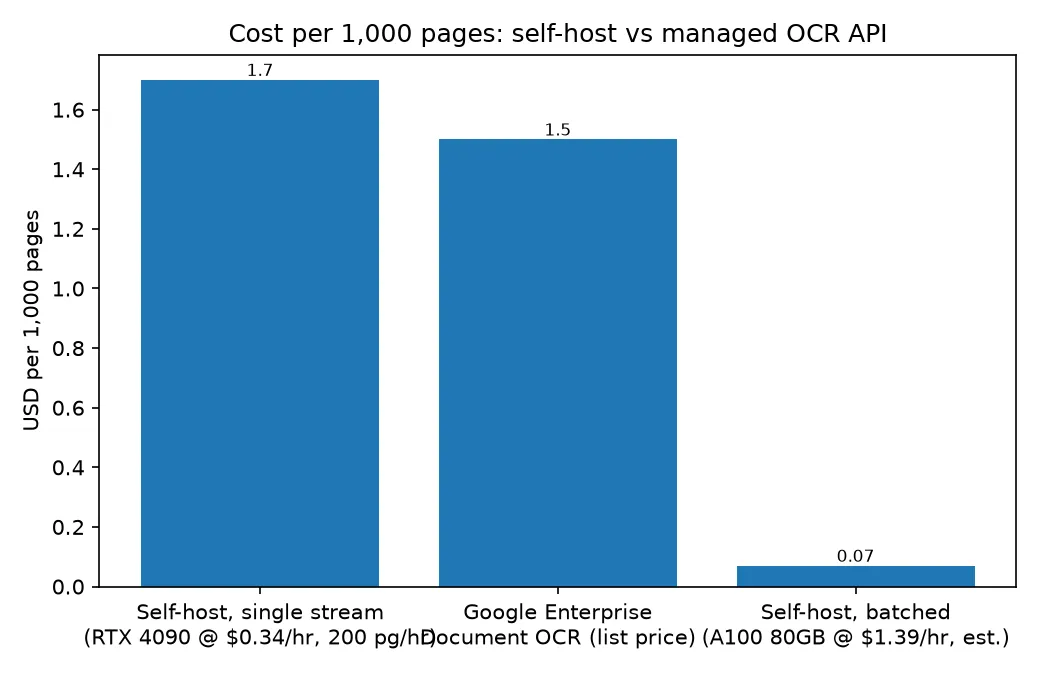
| 選択肢 | 1,000ページ当たりのコスト |
|---|---|
| 自前運用、単一ストリーム(4090を$0.34/時、200ページ/時) | ~$1.70 |
| Google Enterprise Document OCR、月間1K~5Mページ | $1.50(リスト価格) |
| Google Layout Parser、同じページ数 | $10.00(リスト価格) |
| 自前運用、飽和バッチ時の下限(A100 80GBを$1.39/時、モデル計算) | ~$0.07 |
リスト価格は2026-07-29時点のもの。Googleは月間最初の1,000ページが無料で、500万ページを超えると料金は$0.60まで下がる。最下段は実測ではなくモデル上の下限であり、出力長によって変動する。論文にある同時実行512で5,580トークン/秒という値では、1ページ当たり700出力トークンなら約28,700ページ/時で1,000ページ当たり$0.05、1,000トークンなら約20,000ページ/時で$0.07、密な2,000トークンのページなら約10,000ページ/時で$0.14となる。このスループットはBaidu自身の評価クラスタで測定されたもので、レンタルA100上の値ではない。つまりこの行はベンチマーク速度とレンタル価格を組み合わせたものだ。アイドル容量、失敗ページの再試行、前処理、ストレージを加えれば、実運用のコストは3つの数値すべてを上回る。
コンシューマー向けカードでの単一ストリーム運用は、GoogleのマネージドOCRとほぼ同額になる。自前運用の利点はライセンスではなく、同時実行性とデータ所在にある。また、解析は仕事の半分にすぎない。markdownをフィールドへ変換するには、長コンテキストのテキストモデルを呼び出す必要があり、自前スタックでもGPT-5.6 APIのようなサービスでも、そこで再びページ単価ではなくトークン単価の課金に戻る。
壊れやすい入力と失敗パターン
報告されている失敗モードは、凍結されたエンコーダーから予想できるものだ。同じ4070 Ti Superでの実行報告では、きれいな印刷ページは処理できた一方、レシート、手書き、複雑なスキャンでは出力の文字化け、領域の取りこぼし、構造のずれが起きた。Hacker Newsのスレッドで実務者が挙げているのは、コンプライアンス用途で問題になるVLM-OCR特有のエラーだ。外国語の単語が黙って英語に翻訳されたり、手書きの氏名がもっとありそうな綴りに「修正」されたりする。どちらも単一の事例にすぎないため、発生率として扱うのではなく、自分のデータで確認すべき項目と考えたい。
立ち位置も重要だ。Unlimited OCRは精度ランキングの首位ではない。集計されたOmniDocBenchの一覧では、PaddleOCR-VL-1.6は96.33(ベンダー自己報告)、Unlimited OCRはv1.6で93.92となっており、このモデルはolmOCR-Benchにはまだ掲載されていない。ページ単位の精度は、このモデルが競う軸ではない。
Unlimited OCRを使うべきか
今のパイプラインがページごとに処理してからテキストをつなぎ合わせているなら、有力な選択肢になる。born-digital文書やきれいにスキャンされた文書が中心で、改ページをまたぐ表のようなクロスページ構造が既存出力を壊している場合にも向く。
逆に、単一ページの請求書を毎日数千件処理するなら適さない。ページ単位のパイプラインの方がバッチ効率とコストで有利だからだ。手書きや撮影レシートが入力の大きな割合を占める場合、あるいはGPUとコンテナタグではなく、今すぐSLAと監査証跡が必要な場合も、適合度は低い。
どちらにせよ、導入前のテストは必須だ。最低限、独自コーパスから50文書を選び、長さを1~5ページ、6~20ページ、20ページ以上に分け、さらに入力品質をborn-digital、きれいなスキャン、撮影画像に分類する。そのうち10文書は人手で正解データを入力し、文字誤り率、読み順の編集距離、表のTEDSを平均化せず別々に測定する。借りる予定のGPUでページ当たりの実時間も記録したい。同じ50ファイルで現在の仕組みと比較し、下流処理が実際に破綻する地点を合格ラインにする。フィールド抽出では、一般に生のCERより表構造がその地点になりやすい。チューニングで数値がどこまで動くかの参考として、エンタープライズ規模のPDF処理を行うあるチームは、推論レイヤーをRustで書き直した後、文字誤り率0.94%を報告している。
FAQ
Unlimited OCRは無料ですか?
重みはMITライセンスで、商用利用を含めてHugging FaceまたはGitHubから無料でダウンロードできる。推論は無料ではない。バッチ効率にもよるが、1,000ページ当たりおよそ$0.07~$1.70に加え、エンジニアリング工数を見込む必要がある。
Unlimited OCRに公式APIはありますか?
ない。モデルページにはInference Providerへのデプロイがないと表示される。見つかるエンドポイントはすべて、オープンウェイトを提供するサードパーティーのものとなり、価格やレート制限はBaiduではなくその事業者が決める。
Unlimited OCRは現在最高のOCRモデルですか?
精度表ではそうではない。PaddleOCR-VL-1.6はOmniDocBenchで96.33を報告しており、Baiduはv1.6で93.92だ。Unlimited OCRにはolmOCR-Benchのエントリーもまだなく、ベンチマークをまたいだ一貫性は未検証である。測定済みの強みは、編集距離0.1069で40ページを1回のパスで処理できることにある。
Unlimited OCRはOllamaで動かせますか?
公式カードが案内しているのはTransformers、vLLM、SGLangのみで、カスタムアーキテクチャーにはtrust_remote_codeが必要だ。Hugging Faceにはコミュニティ製量子化モデルがあるが、Ollamaビルドは自分のファイルでリファレンス経路との出力比較を終えるまで未検証として扱うべきだ。