 AIREITER
Devinで定型的な作業を大量に回すなら、SWE-2 Flashが有力な標準選択肢になる。毎秒200トークンで、SWE-2の5分の1のコストだからだ。ただし、Terminal-Bench 4.0のような仕事では話が変わる。SWE-2 Flashは20.0%にとどまり、SWE-2の27.3%、トップモデルの40%以上に届いていない。
結論:定型処理はFlash、難しい1割はSWE-2
Devin内で大量に発生する、曖昧さの少ない開発タスクならSWE-2 Flashをまず選びたい。ベンチマークによって品質面の差は残るものの、生成速度は3倍で、タスクあたりのコストも大幅に低い。
| タスクの種類 | 振り分け先 | 理由 |
|---|---|---|
| 自動化、コードレビュー、小規模機能、ドキュメント更新 | SWE-2 Flash | CognitionはSWE-2 Flashを日常的な作業向けに位置付けている。深い計画性より速度が重要 |
| 大規模リファクタリング、新規性の高いリポジトリ、Terminal-Bench-4.0に近いターミナル作業 | SWE-2 | Terminal-Bench 4.0ではSWE-2が27.3%、SWE-2 Flashが20.0%。DeepSWE 1.1でも73.0%対60.1%でSWE-2が上回る |
| セキュリティに関わる作業、オンプレミス環境での作業 | 待機 | SWE-2 Flashの重みは公開されておらず、現時点では将来のセキュア共有プログラムが予告されているだけ |
Devin DesktopとCLIでは2026年11月30日まで無料で使えるため、試すためのコストは低い。まずは定型的なキューをSWE-2 Flashで処理し、手戻りがどの程度発生するかを測ってから本格導入を判断したい。
SWE-2 Flashの正体:Inkling-Smallに中間学習を追加
SWE-2 Flashは、Thinking MachinesのInkling-SmallをベースにCognitionが開発した高速コーディングモデルだ。総パラメータ276B、アクティブパラメータ12Bのmixture-of-expertsベースに、強化学習の前段としてCognition独自の中間学習ステージを組み合わせている。
中間学習では、トークン効率のグラフを使ってデータの組み合わせを選び、数兆トークンを3段階に分けて学習した。データ量の少ないものを最後に回した結果、ホールドアウト損失は安定した対数線形のペースで低下。その後、監査済みタスクによる強化学習を行い、Cognitionが2026年11月4日の投稿で報告した数字では、Terminal-Bench 4.0が0.9%から20.0%に、FrontierCode 2.0が3.2%から24.0%に上昇した。生成速度はSWE-2が毎秒60トークンなのに対し、SWE-2 Flashは毎秒200トークンだという。
「Cognitionの最新モデル、SWE-2 Flashが登場!総パラメータ276B、アクティブパラメータ12BのFlashモデルだ。SWE-2のFlashモデルが出るとは思っていなかったので驚いたが、歓迎したい。ベンチマークの結果は素晴らしく、2.8TのSWE-2からそれほど遠くない」 — @ItsmeAjayKV、実ユーザーによる第一印象
ベンチマークは一致しない。スイートごとに読むべき理由
SWE-2 Flashの結果は、ベンチマークの種類によってはっきり分かれる。構造化されたソフトウェア開発タスクでは健闘する一方、自由度の高いターミナル作業では大きく見劣りする。単純な平均値だけで評価すると、実力を読み違える。
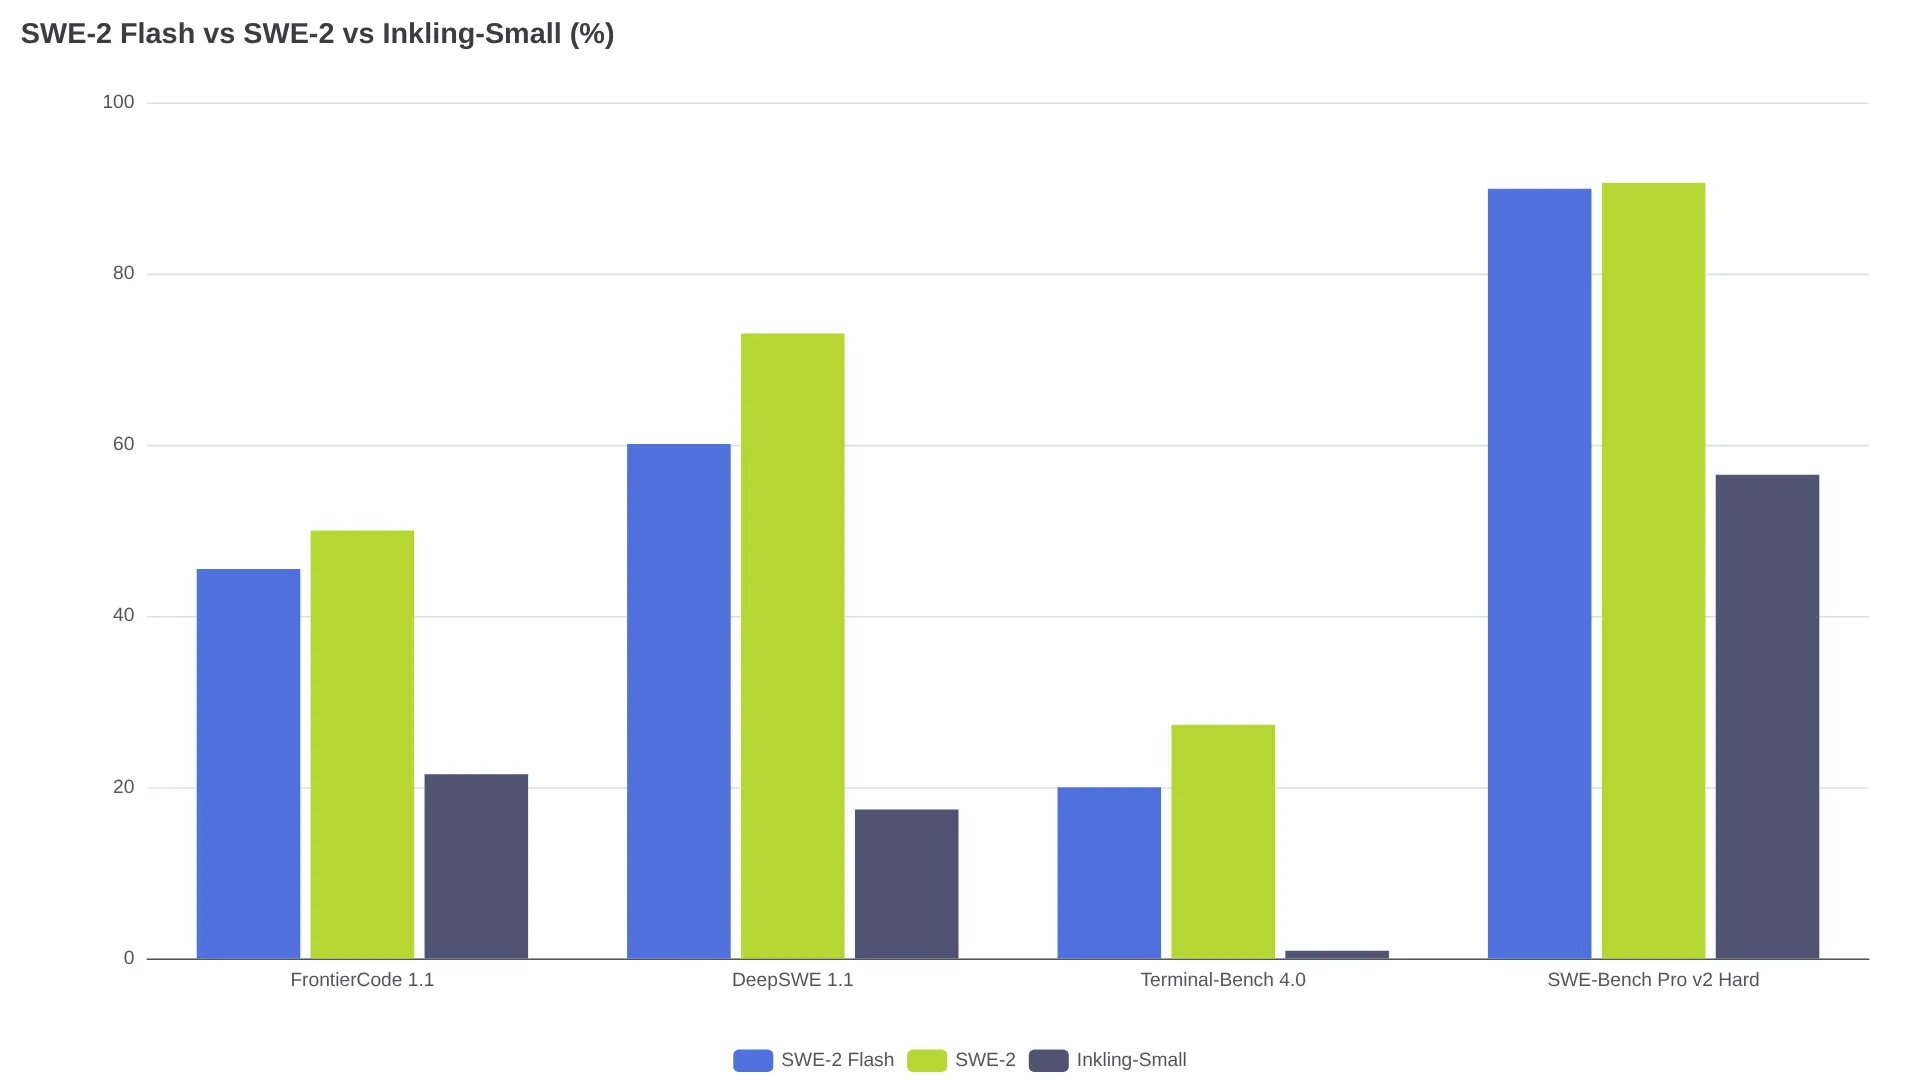
| ベンチマーク | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Cognitionの表での最高値 |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45.5% | 50.0% | 21.5% | 50.0% SWE-2 |
| FrontierCode 2.0 | 24.0% | 23.8% | 3.2% | 27.7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60.1% | 73.0% | 17.4% | 77.0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89.2% | 92.8% | 64.7% | 94.4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20.0% | 27.3% | 0.9% | 42.3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89.9% | 90.6% | 56.5% | 90.6% SWE-2 |
| SWE-Atlas QA | 50.0% | 56.3% | 27.4% | 71.0% DeepSeek V4.1 Flash |
| ExploitBench | 34.8% | 36.1% | 11.3% | 44.7% GPT-6 Luna |
性能向上には限界がある。 SWE-2 FlashはFrontierCode 1.1 MainでInkling-Smallの21.5%から45.5%へと2倍以上に伸びた。また、SWE-Bench Pro v2 Hardでも56.5%から89.9%へ上昇し、90.6%のSWE-2とほぼ肩を並べている。
FlashでもSWE-2の弱点がすべて解消されるわけではない。 SWE-Bench Proでの成功を、長時間のターミナルセッションにそのまま当てはめてはいけない。同じ表では、GLM 5.3 FlashがTerminal-Bench 4.0で41.8%を記録している。
オープンウェイトという主張には注意が必要だ。 SWE-2 Flashは多くの項目でMuse Spark Openを上回る。DeepSWE 1.1では60.1%対60.0%、FrontierCode 2.0では24.0%対6.2%だ。一方で、Terminal-Bench 4.0、SWE-Atlas QA、DeepSWE 1.1ではDeepSeek V4.1 FlashやGLM 5.3 FlashがSWE-2 Flashを上回る。いずれも各ベンダーが報告した数値で、各モデルの最良設定による結果だ。ベンダーごとにハーネスも異なる。
「価格が5分の1」とは何を意味するのか。そもそも料金表はない
単体エンドポイントが存在しないため、トークン単価は公開されていない。利用できる価格情報は、モデル、ハーネス、サービング基盤を含めたロールアウト1回あたりのコストが、SWE-2の5分の1になるというCognitionの比較だけだ。
この比率は参考にはなるが、全体像ではない。CognitionはSWE-2についてもタスク単価を公表していない。OrcaRouterによるSWE-2の内訳が比較材料として引用できたのは、Fable 5.1のFrontierCodeタスクあたりの料金だけで、中程度の推論強度では$3.28、最大設定では$12.83だった。そこに記載されたDevinのプランは、Freeが$0、Proが月額$20、Maxが月額$200、Teamsが$80に加えて1席あたり$40。これはサブスクリプション料金であり、従量制のトークン料金ではない。タスク単価が5分の1になっても、Devinの請求額が自動的に5分の1になるわけではない。
実際に判断するなら、2026年11月30日までDevin DesktopとCLIで利用できる無料期間を使うのが最も安い。Pro、Max、Teamsのユーザーが対象だ。見るべき指標はトークン数ではなく、週あたりの完了タスク数と手戻り率。SWE-2 Flashが毎秒200トークンで定型チケットを一度で終えられるなら、実際の節約幅は「5分の1」という数字以上になる。反対に、SWE-2へのエスカレーションが頻発すれば、その差は消えてしまう。
利用できるのは誰か:Devin限定提供と、オープンウェイトではない重み共有計画
現時点でSWE-2 Flashの提供範囲は狭い。Cognitionが案内している利用先はDevin DesktopとDevin CLIだ。
公開APIの識別子はなく、Hugging Faceの重みも、自分でホスティングするためのパスも用意されていない。Cognitionはこの制限をサイバーリスク管理として説明している。SWE-2 Flashの学習ではサイバーセキュリティ関連の作業を意図的に強化しており、ExploitBenchは11.3%から34.8%に上昇した。同じ能力が攻撃者を助ける可能性もあるためだ。対策として、信頼できる業界パートナーや研究機関に重みを安全に共有するプログラムを提案しており、詳細は数週間以内に明らかにするとしている。これは管理されたアクセス計画であって、オープンウェイト化の約束ではない。
Devinの外部でSWE-2 Flashを直接評価することは、現時点ではできない。公開エンドポイントも、自前でホスティングする手段も存在しないためだ。
SWE-2 FlashとSWE-2の使い分け:タスク単位のルール
量の多い作業はSWE-2 Flashへ、曖昧さの大きい作業はSWE-2へ回す。
自動化、依存関係の更新、テストの追加、レビューへの返信、受け入れ条件が明確な小規模機能、ドキュメントの更新には、まずSWE-2 Flashを使いたい。これらはSWE-2との差が数ポイント以内に収まるスイートに近い。FrontierCode 2.0では24.0%対23.8%、SWE-Bench Pro v2 Hardでは89.9%対90.6%だ。
複数ファイルにまたがる計画、長いターミナル操作、エクスプロイトに近い推論が必要なら、SWE-2へ切り替える。差は無視できない。DeepSWE 1.1では12.9ポイント、SWE-Atlas QAでは6.3ポイント、Terminal-Bench 4.0では7.3ポイントの差がある。HamiRevのSWE-2レビューでは、SWE-2がSWE-1.7より少ないステップと早い編集を重視するよう調整されていると説明している。短いタスクに寄った設計思想を、SWE-2 Flashはさらに推し進めたモデルだ。
各チケットはSWE-2 Flashで開始し、2ループを上限にする。そこで進まない作業はSWE-2へエスカレーションすればよい。無料期間が終わる11月30日以降、実際のDevin利用額が「5分の1」という比率に置き換わった段階で、もう一度判断する必要がある。残る問題は透明性だ。セキュアな重み共有プログラムによってプライベート環境への導入が可能になるかもしれないが、条件が公開されるまでは、規制の厳しいチームはSWE-2 Flashを前提に計画を立てられない。
SWE-2 Flash FAQ
SWE-2 FlashはAPIで利用できますか?
単体のSWE-2 Flash APIは存在しない。利用できるのはDevin DesktopとDevin CLI経由で、Pro、Max、Teamsでは2026年11月30日まで無料で使える。
SWE-2 Flashはオープンウェイトですか?
違う。Cognitionはサイバーリスクを理由に挙げており、将来的にも選ばれたパートナーや研究機関向けのセキュア共有プログラムしか約束していない。
SWE-2 FlashとSWE-2の違いは?
SWE-2 Flashは毎秒200トークンで、SWE-2の毎秒60トークンを上回る。Cognitionのタスクコスト計算では料金は5分の1だ。一方、DeepSWE 1.1ではSWE-2が73.0%、SWE-2 Flashが60.1%、Terminal-Bench 4.0では27.3%対20.0%で、SWE-2が優位に立つ。
SWE-2 Flashのコンテキストウィンドウはどのくらいですか?
CognitionはSWE-2 Flashのコンテキストウィンドウ、最大出力、モダリティの仕様を公開していない。Inkling-Smallの制限をそのまま引き継いでいると考えるべきではない。
11月30日の無料期間が終わるとどうなりますか?
Cognitionは、キャンペーン終了後のSWE-2 Flashの料金体系を明らかにしていない。別建てのトークン料金ではなく、Devinのサブスクリプション内の利用として扱われると考えられる。