 AIREITER
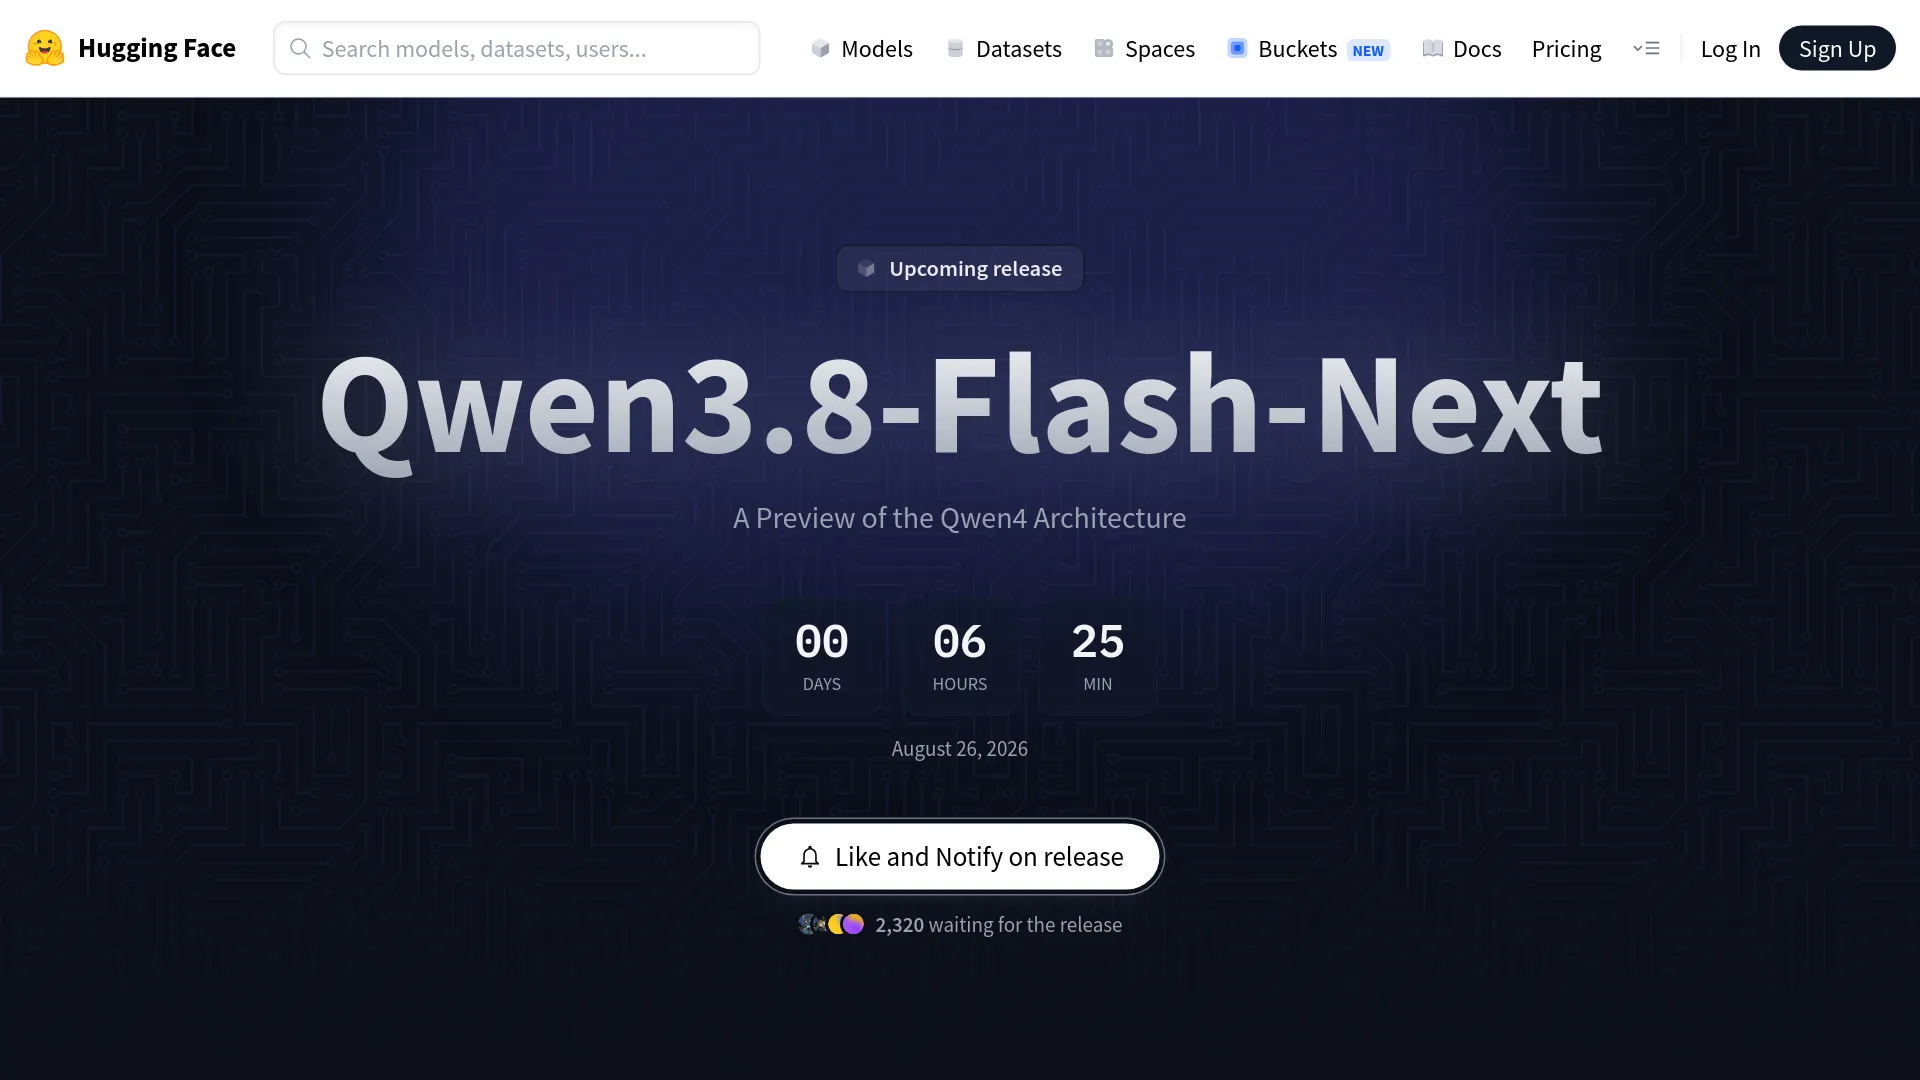
AlibabaのModelScopeにQwen3.8-Flash-Nextのカウントダウンページが登場したのは、2026年8月25日。次世代ファミリーであるQwen4が姿を見せる前に、その基盤となる新アーキテクチャを先に公開するという、少し変わった展開です。この記事の執筆時点では、重みは8月26日23:00(UTC+8)に公開される予定でした。狙いは明快で、Qwen4の正式投入に先立ち、オープンソースの推論エコシステムがカーネルや量子化、サービング対応を準備できる時間を確保することです。
Qwen3.8-Flash-Nextとは何か。Qwen4そのものではない
Qwen3.8-Flash-Nextは、今後登場するQwen4ファミリー向けのアーキテクチャを採用したマルチモーダルMixture-of-Experts(MoE)モデルです。ただし、Qwen4そのものではありません。新しいアテンション機構やレイヤー構成、スパース性のパターンを実際に動くモデルとして公開し、フル版のQwen4が登場する前に推論フレームワーク側の対応を進めてもらうための技術デモと考えると分かりやすいでしょう。
QwenのHugging Faceページでは、「Upcoming release」「A Preview of the Qwen4 Architecture」と案内されています。ModelScopeのカウントダウンページには、「Onward to the Next-Gen — Lightning-Fast.」というキャッチコピーも掲載されていました。いずれもQwen公式の発信ですから、リリース自体は確定しています。ただし、記事執筆時点ではまだ完全公開前でした。
現時点で公式に確認できる情報と、コミュニティで語られている段階にとどまる情報を分けると、次のようになります。
| 公式チャンネルで確認済み | まだ未確認 |
|---|---|
| ModelScopeとHugging Faceでのオープンウェイト公開 | 最終的なパラメータ数(125B/6B/51B) |
| マルチモーダル(ビジョン+テキスト) | ライセンス(過去の例からApache 2.0が有力) |
| GDNハイブリッドアーキテクチャとQwen Sparse Attention | ベンチマークスコア全般 |
FP8版(Qwen/Qwen3.8-Flash-Next-FP8) | APIの料金や提供状況 |
| Qwen4向けアーキテクチャプレビュー | コンテキスト長(ネイティブ256K、拡張時1Mという推測) |
広く引用されている総パラメータ125B、トークンあたりのアクティブパラメータ6B、n-gram埋め込み51Bという数字は、ModelScopeのモデルカードに一時表示された後、Qwenチームによって短縮された内容から広まったものです。複数の独立した観測者が同じ数字を確認しており、内容としても不自然ではありません。ただし、長期的に参照できる公式ドキュメントではありません。SaaSCity創業者のghostyは、次のように指摘しています。
「今日このモデルのベンチマークグラフを投稿している人は、数字を捏造しています」
推論フレームワークの実装を変える新アーキテクチャ
Qwen3.8-Flash-Nextを現行のQwenラインアップと大きく異なるものにしているのが、3つのアーキテクチャ要素です。いずれも設定ファイルを変更するだけでは対応できず、推論フレームワーク側に新しいカーネル実装が必要になります。
GDNレイヤー:固定サイズの再帰状態で長文脈のメモリ使用量を抑える
Gated Delta Network(GDN)は、大半のレイヤーで従来のアテンションを置き換えます。一般的なTransformerアテンションでは、シーケンス長に応じて増え続けるKVキャッシュを保持します。一方、GDNはサイズが固定された再帰状態を使うため、GDNレイヤーのメモリ使用量はコンテキスト長に左右されず、計算量も二次ではなく線形に伸びます。ハイブリッド構成に残るフルアテンションレイヤーは、正確な情報検索のためにKVキャッシュを利用します。
実運用でのメリットは、長文脈処理のコストを大幅に下げられることです。100Kトークンに及ぶ会話でも、100Kトークン分のKVキャッシュをそのまま確保する必要はありません。Qwen3.8アーキテクチャのレイヤー構成は、ModelScopeに短時間表示されたカードをコミュニティが分析した結果では、GDNレイヤー69層とフルアテンションレイヤー23層。およそ3対1の比率です。フルアテンションが全体的な検索精度を支え、GDNがシーケンス処理の大部分を担当します。
QwenにとってGDN自体が完全に新しいわけではありません。2025年9月のQwen3-Nextは、総パラメータ80B、アクティブ3Bの構成でGated DeltaNetを導入しました。その後のQwen3.5/3.6/3.7ファミリーも、同様のハイブリッド構成を維持したと報じられています。Flash-Nextで新しいのは、この方式を125B規模に拡大したこと、そして次の2つの要素を加えたことです。
QSA:スパースアテンションの正体はまだ不明
Qwen Sparse Attention(QSA)はモデルカードに名前が記載されているものの、詳しい仕組みは説明されていません。コミュニティでは、全トークン間を密に見るのではなく、各トークンが一部のトークンだけを参照するスパースなパターンを採用したものだと考えられています。ただし、学習型スパース性なのか、ブロックスパース性なのか、スライディングウィンドウなのか、あるいは複数方式の組み合わせなのかは分かっていません。技術レポートが公開されれば、QSAが段階的な改良なのか、それとも本当に新しいアテンションの基本要素なのかが見えてくるはずです。
51Bのn-gramテーブル:ドラフトモデルなしの投機的デコーディング
最も目を引くのが、51Bパラメータのn-gram埋め込みテーブルです。コミュニティで有力視されている仮説は、これが高速なトークン検索機構、つまり投機的デコーディング用の統合型ドラフトモデルとして機能するというものです。通常は、小型モデルで次の数トークンを予測し、メインモデルで検証します。n-gramテーブルを使えば、次トークン候補を低コストで直接取得できる可能性があります。
未解決の点は多く残っています。テーブル全体をVRAMに置く必要があるのか、メモリマップできるのか。量子化した場合にどう振る舞うのか。125Bという数字に含まれるのか、それとも別枠なのか。技術レポートや最初のコミュニティベンチマークが出るまでは、51Bという数字を確定コストではなく、デプロイ計画上の変数として扱うべきでしょう。
Qwenファミリーの中でのFlash-Nextの位置づけ
Flash-Nextは、単純な世代交代の延長線上にあるモデルではなく、並行して進むトラックに位置づけられます。
| モデル | リリース | 総パラメータ | アクティブパラメータ | 役割 |
|---|---|---|---|---|
| Qwen3-Next | 2025年9月 | 80B | 3B | GDNアーキテクチャの初期テスト |
| Qwen3.8-27B | 2026年8月 | 27B(Dense) | 27B | ミドルレンジのDenseモデル |
| Qwen3.8-Max | 2026年8月 | 約2.4T | 約95B | フラッグシップのオープンウェイトモデル |
| Qwen3.8-Flash-Next | 2026年8月26日 | 約125B | 約6B | Qwen4向けアーキテクチャプレビュー |
| Qwen4 | 未定(数か月以内) | 不明 | 不明 | 次世代ファミリー本体 |
コミュニティで使われている目安が、sqrt(125B x 6B) = 27Bという計算です。これが当てはまるなら、Flash-Nextは27BのDenseモデルに近い品質を、推論計算量としては6Bモデルに近い水準で実現できるかもしれません。ただし、Beer And CodeのLucas Souzaも指摘しているとおり、これは定石であって定理ではありません。ルーティングの品質、データの質、n-gramテーブルの寄与は、まだ測定されていないからです。
複数のコミュニティ分析が「ベンチマークではなく、プラットフォーム戦略」と表現しているように、Qwen4の登場前にllama.cpp、vLLM、SGLangなどの推論フレームワークへカーネル対応を追加してもらうのが、このモデルの主な役割です。Unslothも、リリース初日からの対応に取り組むと発表しています。
実際に動かせるのか。必要なハードウェアを確認する
| 形式 | おおよその重みメモリ |
|---|---|
| BF16 / FP16 | 約250 GB |
| FP8 | 約125 GB |
| Q4 / 4-bit | 約65–70 GB |
ここで示しているのは、コンテキスト、KVキャッシュ、ランタイムのオーバーヘッドを含まない重みだけの容量です。Q4量子化モデルでも、メインの重みに約65–70 GBが必要で、さらに51Bのn-gramテーブル分が加わります。n-gramテーブルまでVRAMに置く必要があるなら、一般的な単体マシンでは扱いにくい規模です。システムRAMへメモリマップできるのであれば、128GB以上のユニファイドメモリを備えたシステム、たとえば最大構成のMac Studio(M2 Ultra / M3 Ultra)、AMD Strix Halo、NVIDIA DGX Sparkなら、現実的な選択肢になる可能性があります。RTX 4090や5090を1枚だけ用意しても足りません。
Redditでは、u/KURD_1_STANが「ローカル向け」という見方に対して、次のように反論しています。「Ram prices this high, how can u call this local friendly?」。6Bアクティブという宣伝文句と、250GBのメモリ要件との間に大きな隔たりがあるのは事実です。Xでは@Dicklong1999が、スパースなアクティベーションによって、必要なハードウェアを持つユーザーなら生成速度は現実的になる可能性がある一方、「125Bなので、普通の人は基本的にローカル実行を忘れてよい」と述べています。
APIの提供状況と料金はどうなるのか
記事公開時点では、Qwen3.8-Flash-NextのAPI料金や提供状況は発表されていません。Qwen公式の料金ページによると、Qwen3.8-Maxは入力が$2.00/M、出力が$6.00/Mです。アクティブパラメータが6Bであることを考えると、Flash-Nextはこれより大幅に安くなるはずです。FP8版はBF16と比べて重みのメモリ使用量を半分にできるため、APIサービング向けの形式として自然な選択肢になります。提供開始の時期は推論フレームワークの対応状況次第です。重みが公開された後、各プロバイダーのモデルカタログを確認してください。
重みの公開前にやっておくこと
Qwen3.8-Flash-Nextが自分の開発環境や研究スタックにとって重要かどうかを見極めたいなら、次の項目を準備しておきましょう。
1. ハードウェアを確認する。 ローカル実行を考えているなら、128GB以上のユニファイドメモリ、または複数GPU構成があるか確認してください。条件を満たせない場合は、API利用を前提に計画します。
2. Hugging Faceのリポジトリを監視する。 実際の仕様、ライセンス、コンテキスト長を確認するうえで、モデルカードが最初の一次情報になります。huggingface.co/Qwen/Qwen3.8-Flash-Nextをブックマークしておきましょう。
3.評価パイプラインを用意する。 重みが公開される前に、ベンチマーク用のプロンプトと評価スクリプトを準備しておきます。公開後24時間に集まるコミュニティベンチマークは、公式の数字より多くのことを教えてくれるはずです。
4.本番ワークロードは移行しない。 現時点では独立したベンチマークが存在しません。アーキテクチャは新しく、ランタイム対応も成熟しておらず、ライセンスも未確定です。評価目的にとどめ、動かなくなったときに金銭的な損失が出る用途には使わないでください。
5.推論ツールを保守しているなら、今から準備する。 GDNとQSAの組み合わせへの対応には、設定変更ではなくカーネル開発が必要です。アーキテクチャを早く理解するほど、対応版を早くリリースできます。
FAQ
重みはいつ公開されますか?
ModelScopeのカウントダウンは、2026年8月26日、23:00(UTC+8)ごろを示していました。Hugging Faceのミラーは通常、ModelScopeでの公開から数時間以内に登場します。Qwenチームは公式チャンネルを通じてこのタイミングを示しており、@Alibaba_Qwenは「今夜どんなサプライズを投入するのか」と予告し、@QwenDevsはモデル名を直接明らかにしていました。
これはQwen4ですか?
いいえ。Qwen3.8という命名規則を使った、Qwen4アーキテクチャのプレビューです。Qwen4本体の登場は数週間後ではなく、数か月以内と見込まれています。Flash-Nextは、フルファミリーが登場する前にエコシステムがランタイム対応を準備できるようにするためのモデルです。
ライセンスは何になりますか?
未確認です。最近のQwenオープンウェイトモデルであるQwen3.8-27BとQwen3.8-MaxはApache 2.0を採用しているため、今回もその可能性が最も高いと考えられます。重みが公開されたら、モデルカードで確認してください。
RTX 4090で動かせますか?
できません。Q4量子化でも、メインの重みだけで約65–70 GBが必要です。RTX 4090は1枚あたり24 GBしかありません。128GB以上のユニファイドメモリを備えたシステム(Mac Studio、Strix Halo)か、大容量VRAMのGPUを複数枚搭載した構成が必要です。
Qwen3.8-27Bを上回りますか?
分かっていません。ベンチマークがまだ存在しないためです。sqrt(125B x 6B) = 27Bという目安からは、27BのDenseモデルに近い品質が期待されますが、これは推定であって測定結果ではありません。自分の用途に合った独立評価が出るまで待つべきでしょう。
どのくらい高速に動きますか?
トークンあたりのアクティブパラメータが6Bであることから、生成速度は125Bの巨大モデルより小型モデルに近くなる可能性があります。ただし、n-gramテーブルのメモリアクセスパターンや、GDNカーネルの効率はまだ不明です。最初のコミュニティベンチマークで明らかになるでしょう。
APIプラットフォームで利用できるようになりますか?
ほぼ確実に提供されるでしょう。FP8版はAPIサービングを意識した形式です。AIReiterをはじめとする各種プラットフォームは、通常、重みの公開から数日以内にQwenモデルを追加します。ボトルネックになるのは、新しいアテンション機構に対するフレームワーク側の対応です。
昨年のQwen3-Nextはどうなったのですか?
Qwen3-Nextは2025年9月、総パラメータ80B、アクティブパラメータ3Bで登場し、Gated DeltaNetを導入しました。GDNハイブリッド方式が機能することを示した、より小規模なアーキテクチャテストです。Flash-Nextは、その規模を拡大した後継モデルにあたります。Xのユーザー@LufzzLizは、前年のNextシリーズについて「期待外れだった」と評していました。だからこそ、今回はベンチマークが出るまで判断を急がないことが重要です。