 AIREITER
Muse Spark 1.2の結論
Metaは2026年8月5日、Muse Spark 1.1よりコーディングベンチマークを伸ばしたMuse Spark 1.2と、その実行を前提に設計した新しいターミナルエージェントをリリースした。ただし、コーディング系の3指標はいずれもClaude Opus 5に敗れている。これがMuse Spark 1.2を評価するうえでの要点だ。
改善そのものは確かにある。Metaはコーディング学習の計算量を増やし、Muse Codeエージェントとモデルを共同学習させたため、数値も上向いた。一方で、世代間の伸びにはモデル単体だけでなく、新しいハーネスの効果も含まれる。Terminal-Bench、DeepSWE、Meta独自の社内コーディング評価では、依然としてAnthropicのモデルが4〜9ポイント先行している。
それでも注目に値するのは価格だ。標準料金は100万トークンあたり入力$1.25、出力$4.25で据え置かれ、contributor tierならさらに約12分の1まで下がる。ただし、標準で案内される経路ではコードがMetaの学習に使われる。また、最高の推論強度では最初のトークンが返るまでの時間が約9倍に悪化した。本番のコーディング用途でMuse Spark 1.2を検討するなら、順位表よりもこの2点を重視したい。
1.1から変わったポイント
Muse Spark 1.2は、Metaのフロンティア推論モデルをコーディング向けに更新したバージョンだ。8月5日には、現在ベータ提供中のターミナルベースのコーディングエージェント、Muse Codeも同時に公開された。Meta自身はMuse Spark 1.1からの変更を「moderate improvement」と表現している。控えめな言い方ではあるが、複数ファイルにまたがるリファクタリング、長時間のデバッグ、1回のプロンプトでは終わらないタスクなど、コーディングエージェントが特に苦手としやすい領域に改善を集中させたアップデートだ。
性能向上の背景には、学習面での2つの変更がある。1つ目は、Muse Codeを初日から学習ループに組み込んだことだ。Metaは拒否サンプリングされたハーネス軌跡を用い、独自エージェント内で最も性能が出るようモデルを共同学習させた。同社によれば複数のハーネスで学習しており、他のコーディングツールへの汎化も維持しているという。2つ目は自己改善ループだ。Muse Spark 1.1に難易度の高いコーディング環境と指示追従テンプレートを生成させ、候補解をそれらで採点し、1.2用の学習データを作成した。Metaは、このループによって複雑な指示への追従能力が測定可能なレベルで向上したとしている。
今回の更新が狙うのは、Museファミリーの弱点だったエージェント型コーディングだ。2026年4月のMuse Spark登場時、SWE-Bench Verifiedでは77.4で、Claude Opus 4.6の80.8に後れを取っていた。コーディング特化チェックポイントと専用ハーネスの組み合わせは、この差への直接的な回答であり、汎用的なエージェント能力も維持されている。
ベンチマークはこう読むべき
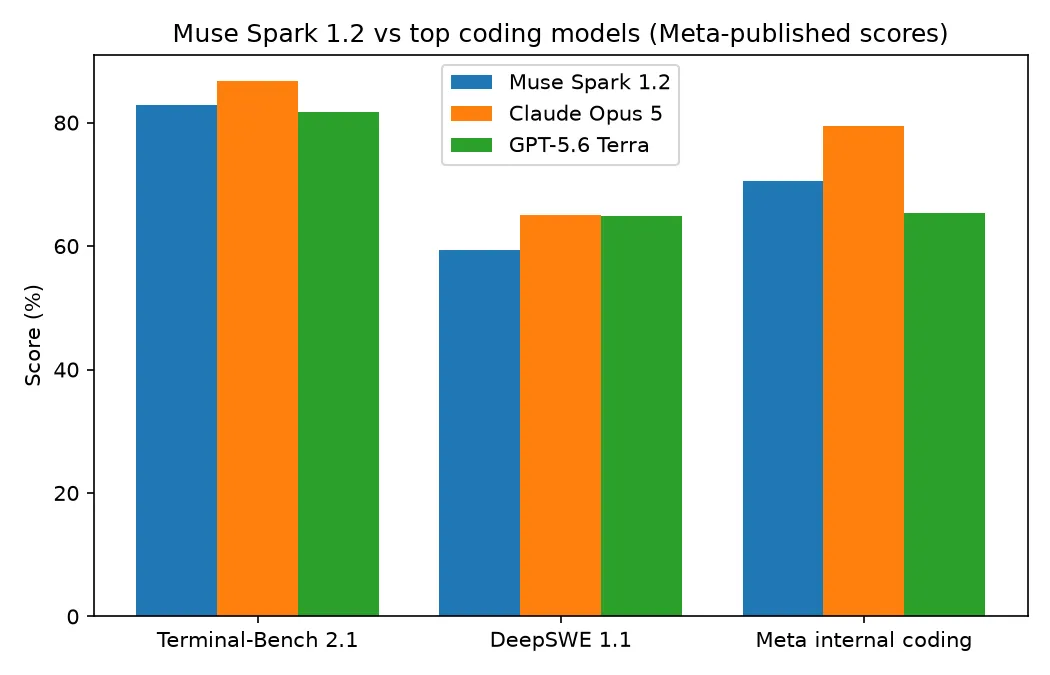
Terminal-Bench 2.1では、Muse Code上で動作するMuse Spark 1.2が82.9%を記録した。Codex上のGPT-5.6 Terraは81.8%、Grok Build上のGrok 4.5は81.6%で、これらをわずかに上回る。一方、Claude Codeで最大effortを設定したClaude Opus 5は86.7%で首位だ。DeepSWE 1.1ではMuse Spark 1.2は59.3%で、Opus 5の65.0%、GPT-5.6 Terraの64.8%に次ぐ3位となった。3つの中で最も率直なのはMeta独自の社内コーディング評価だろう。Muse Spark 1.2の70.6%はGPT-5.6 Terraの65.4%、Gemini 3.6 Flashの63.9%を上回るが、Opus 5の79.4%には約9ポイント届かない。3つの表すべてでClaudeが首位に立っている。
世代間の改善は実在する。Muse Spark 1.2は1.1比でTerminal-Benchを6.7ポイント、DeepSWEを6.3ポイント伸ばした。ただし、バージョン比較ではチャートのラベルにある違いを見落とせない。1.1のスコアは汎用のmini-swe-agentハーネスで測定されたのに対し、1.2はMuse Codeで動作している。伸びの一部は新ハーネスによるもので、モデルだけの改善ではない。Artificial Analysisの総合Intelligence Indexでは、1.2は54を記録し、186モデル中14位、同クラスの中央値32を上回る。1.1の51からは上昇しているが、コーディングチャートほど大きな差ではない。
ClaudeやGPTとの直接比較こそ、利用者が繰り返し尋ねてきた点だ。1.2のデータが出る前、Redditではある開発者がこう端的に質問していた。
「MetaのMUSE Spark 1.1を使った人はいますか? 推論、コーディング、速度、正確性、コンテキスト処理で、ClaudeやGPTと比べてどうなのか気になります。」
1.2のベンチマークは、この問いに対する最初の厳密な答えとなる。競争力はあり、コーディングでは明確に2番手で、ほとんどのチャートでGPT-5.6系とGemini系を上回った。
本番導入で効いてくる2つの注意点
Muse Spark 1.2を実際のワークフローで使えるかどうかは、順位表には現れない2つの実務的な条件で決まる。
xhighで大幅に悪化する応答開始時間
Muse Sparkは推論モデルであり、回答前に思考する。この思考は無効化できない。/effortはminimalからxhighまでの5段階で、思考トークンも出力として課金される。最高設定では、コストが2つの意味で重くなる。OrcaRouterが公開した独立測定では、xhigh時の最初のトークンまでの時間は1.1の2.90秒から26.12秒へと、約9倍に増加した。出力速度も毎秒213.5トークンから165.0トークンへ低下している。Artificial Analysis Intelligence Indexの評価を1.2で実行したコストは$637.85で、1.1の$548.07より16%高い。これはモデルがより長く熟考するためだ。開発者が返答を待つ対話型コーディングでは、最大effortは精度と引き換えに遅延を増やし、その見返りが割に合わない場面も多い。
contributor tierはコード提供と引き換えの割引
MetaはMuse Spark 1.2を2つの料金体系で提供しているが、新規利用者に案内するプランには条件がある。contributor tierは入力/出力100万トークンあたり$0.10/$0.20で、標準の$1.25/$4.25と比べると入力は約12分の1、出力は約21分の1だ。キャッシュ済み入力は$0.002とほぼ無料に近い。その代わり、Metaがプロンプトと補完結果を将来のモデル学習に利用することを明示的に許可する。この比較では最安の料金だが、データを対価として支払うことになる。
Muse Codeの標準的な導入経路は、このtierに開発者を案内する。VentureBeatが報じたテストでは、Mac miniで1行インストーラーは動作した。ダウンロードは97 MBで、あとはサインインするだけだった。しかしエージェントは利用可能なモデルが表示されないとして実行まで進まず、割引tierでも支払い方法の登録を求められた。低価格なのは事実だが、無料ではない。レート制限も標準の毎分3,000リクエストに対して毎分60リクエストと厳しい。このtierが本番用途より個人利用やプロトタイピング向けであることは明白だ。独自コードベースを持つチームは、標準料金へ意識的に切り替えるか、Metaの営業を通じてデータ保持なしを要請する必要がある。
価格帯で見るMuse Sparkの位置
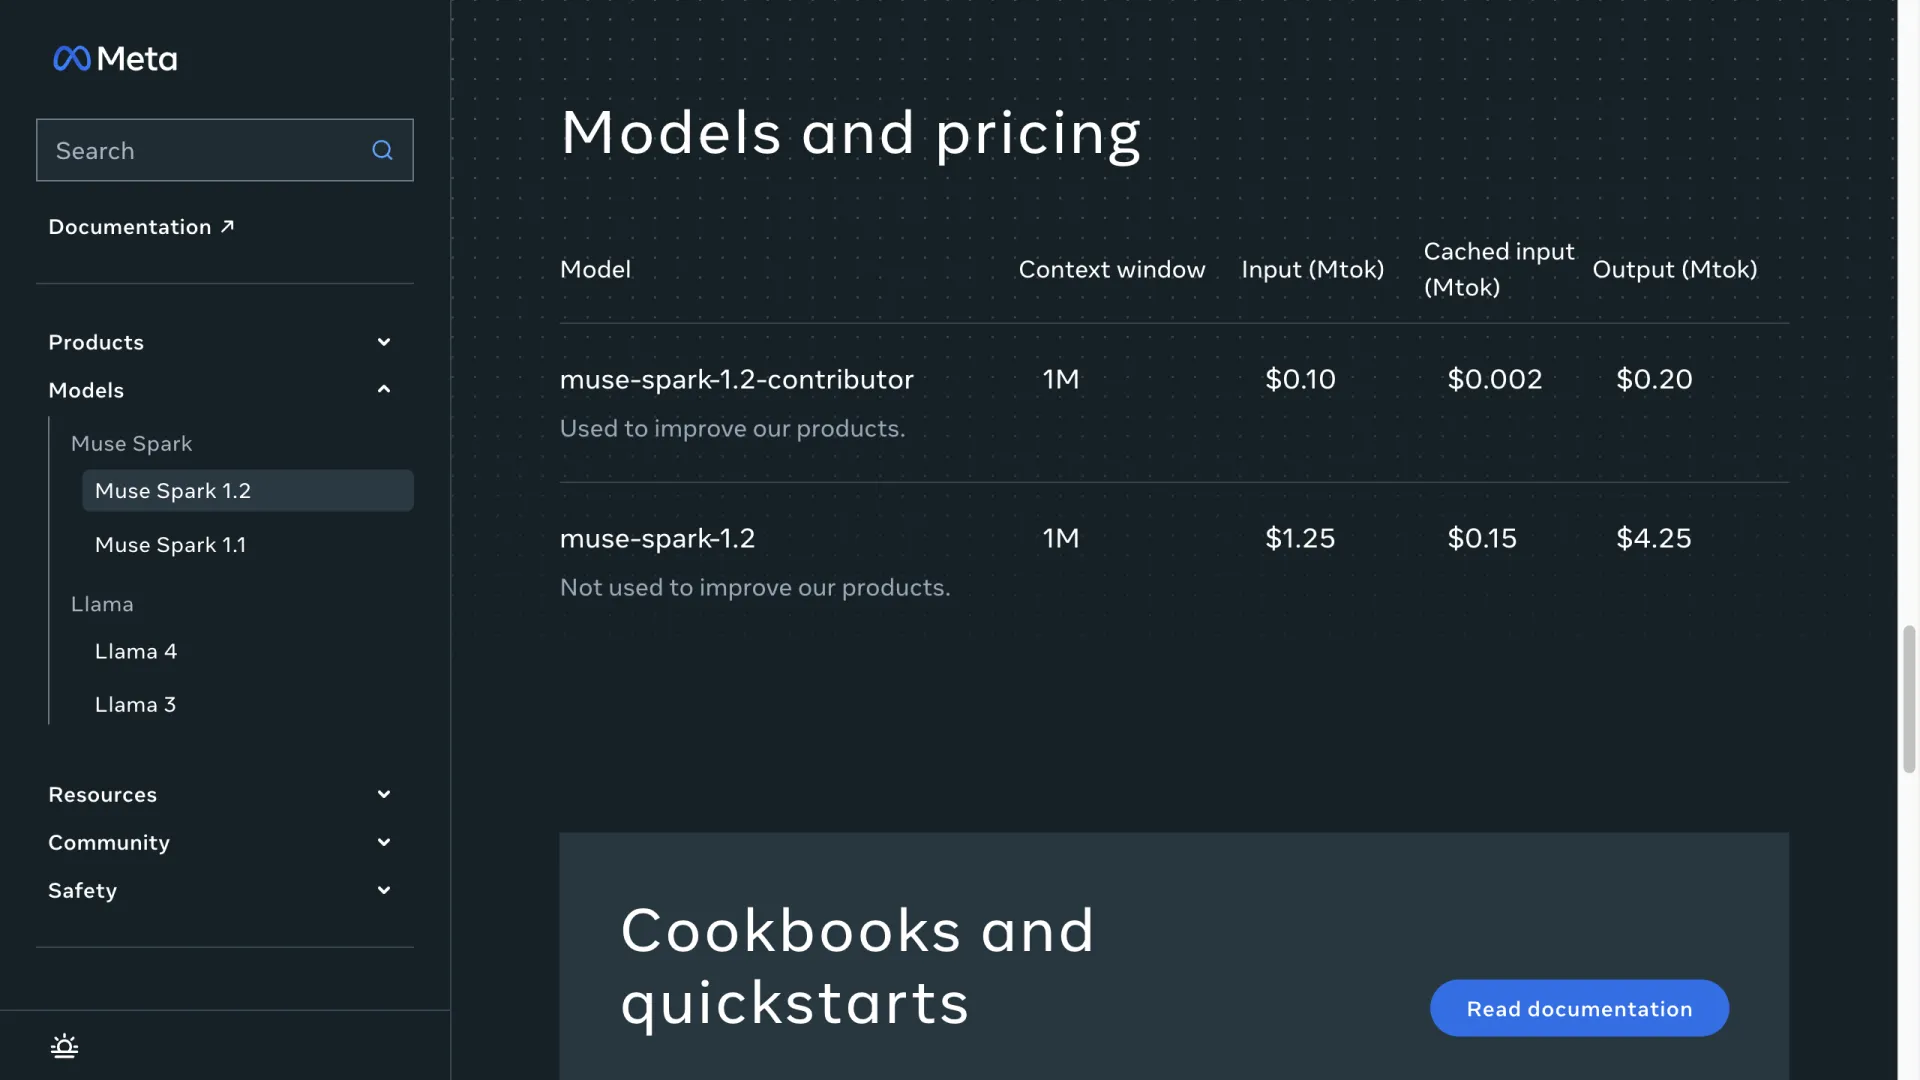
Muse Spark 1.2の標準tierは、入力100万トークンあたり$1.25、キャッシュ$0.15、出力$4.25、コンテキストウィンドウは100万トークンで、長文コンテキスト追加料金はない。コーディングモデル市場では下位から中位に位置する価格設定だ。フロンティア級のコーディング首位モデルと比べると明確に安く、Claude Opus 5の$5/$25、GPT-5.5の$5/$30は、出力単価でおよそ4〜7倍になる。Z.aiのGLM-5.2は$1.40/$4.40でほぼ同価格帯、Grok 4.5の$2/$6よりも一段低い。最安帯のDeepSeek V4 Proは$0.435/$0.87で、Muse Sparkを数倍の差で下回る。Muse Spark contributor tierも同様に安価だ。
| モデル | 入力 $/M | 出力 $/M | キャッシュ $/M | コンテキスト |
|---|---|---|---|---|
| Muse Spark 1.2(standard) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2(contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*contributor tierではMetaにデータを学習利用する権利を付与する。上限は毎分60リクエスト。
利用できる場所と、今すぐ選べる代替案
Muse Spark 1.2を使えるのは、Meta Model API、Muse Codeターミナルエージェント、OpenRouterの3か所だ。まだすべてのアグリゲーターには載っていない。2026年8月6日に確認したAIReiterのカタログにも掲載はなかった。統合APIを中心にスタックを組み、今すぐコーディングモデルを必要とするなら、すでにルーティングされている選択肢から選ぶことになる。
現時点で価格帯が最も近いのは、$1.40/$4.40のGLM-5.2だ。2026年8月6日、「今すぐ利用可能」なモデルで何ができるかを確かめるため、プラットフォームのAPI経由でglm-5.2に単発のコーディング推論タスクを実行した。内容は、当座貸越チェックが欠けたPythonの出金関数だ。GLM-5.2は3.2秒で返答し、プロンプト85トークン、補完128トークンで、不足している残高ガードを正しく特定した。修正コードとしてif amount > 0 and account_balance >= amount:を示し、修正前には失敗し修正後には通るテストも作成した。これはベンチマークではなく1つのタスクにすぎないが、同程度の価格で今すぐ呼び出せる実用的なコーディングモデルではある。AIReiterのカタログには、DeepSeek V4 Pro、Kimi K3、Claude Sonnet 5、GPT-5.6ファミリーも、すでにコーディング対応の選択肢として揃っている。
Muse Spark 1.2を選ぶべきか
何を優先するかによって、判断は3つに分かれる。
Muse Spark 1.2を選ぶケース:価格に敏感な大規模コーディング、たとえば複数ファイルの大規模リファクタリング、長時間のデバッグ、長期展開のエージェントタスクを行い、Meta、Muse Code、OpenRouterへ直接つなぐことを受け入れられる場合だ。$1.25/$4.25で中価格帯の料金ながらフロンティア級のコーディング能力を得られる。コンテキスト圧縮に対応した100万トークンのコンテキストウィンドウも、1プロンプトで終わらない作業に向く。最初のトークンまで26秒を許容できるタスクでない限り、推論effortはxhigh未満に抑えたい。
Claude Opus 5を選ぶケース:コーディングベンチマークで最高の結果が必要な場合だ。Muse Spark 1.2が登場する3つのベンチマークすべてで首位に立っている。その精度上の優位性には、トークン単価で4〜6倍を支払うことになる。
すでにアグリゲーターにあるモデルを選ぶケース:今日中に出荷する必要があり、利用中のプラットフォームにMuse Sparkがない場合だ。GLM-5.2なら待たずに同じ価格帯を選べる。コスト最優先ならDeepSeek V4 Proはさらに安い。
FAQ
Muse Spark 1.2はコーディングでClaude Opus 5より優れている?
いいえ。Metaが公開した3つのコーディングベンチマーク、Terminal-Bench 2.1、DeepSWE 1.1、Meta社内コーディング評価のすべてでClaude Opus 5が上回っており、差は3.8〜9ポイントだ。Muse Spark 1.2は明確な2番手で、ほとんどのチャートではGPT-5.6 TerraとGemini 3.6 Flashを上回っている。
Muse Spark 1.2はオープンソース?
いいえ。MetaのLlamaファミリーとは異なり、Muse Sparkはプロプライエタリモデルだ。クラウド専用で、ダウンロード可能な重みはなく、セルフホスティングもできない。Mark Zuckerbergはオープンソース公開の可能性について「have more to share」と述べているが、1.2は重みもライセンスも提供せずに出荷されている。