 AIREITER
MuseTalkは、4 GBのノートPC向けGPUでも動作します。公式READMEによれば、RTX 3050 Ti LaptopをFP16で使った場合、8秒の動画処理におよそ5分かかります。「動く」と「十分な速さで動く」は別の話です。この差こそがMuseTalkのリップシンク採用を判断するポイントであり、解像度、セットアップ、そして以下のコスト比較にもそのまま表れています。
MuseTalkが映像に手を加える部分、手を加えない部分
MuseTalkは既存動画の口元から顔の下半分を描き直し、入力した音声に合わせて唇を動かします。一方で、頭の位置、目の動き、表情、背景、カメラの動きは生成しません。元映像のものがそのまま残ります。つまり、これはトーキングヘッド動画を一から作るモデルではなく、既存映像への局所的な編集ツールです。顔がはっきり映っている素材を、あらかじめ用意しておく必要があります。
処理が速い理由は、その構成にあります。Tencent MusicのLyra Labが公開したこのリポジトリでは、マスクした顔を固定済みのsd-vae-ft-mse VAEでエンコードし、音声特徴量を固定済みのWhisper-tinyモデルから抽出します。そこにStable Diffusion v1.4由来のUNetを使ったクロスアテンションで両者を融合します。反復的なノイズ除去ループではなく、潜在空間での1ステップ・インペインティングを行うことで、NVIDIA Tesla V100上で30 fps以上という公称処理速度を実現しています。
1080p映像で見る256x256の顔領域の意味
256x256という数字は出力動画の解像度ではなく、編集対象となる顔領域のサイズです。1080pの映像を入力すれば、元のフレームレートを保った1080p動画として戻ってきます。ただし、口元周辺は256x256のパッチとして再生成され、元映像に合成されます。そのため、画面内で顔が小さいほど結果は安定します。逆に、顔の周囲がシャープなタイトなクローズアップでは、口元の柔らかさが目立ちやすくなります。
対策は2つありますが、どちらにも代償があります。--use_float16を外せば品質は向上しますが、必要なVRAMが増え、処理時間も長くなります。完成した動画をGFPGANやCodeFormerで顔補正にかければ口元をシャープにできますが、追加の処理工程が必要になり、被写体の見た目もわずかに変わります。
数値で見る品質:MuseTalkが勝つ場面とWav2Lipが上回る場面
MuseTalkが優位に立つのは、リップシンクの正確さよりも画質です。HDTFデータセットでは、MuseTalkの技術報告がFID 6.43を記録しています。DI-Netは7.27、VideoRetalkingは10.93、Wav2Lipは11.21でした。
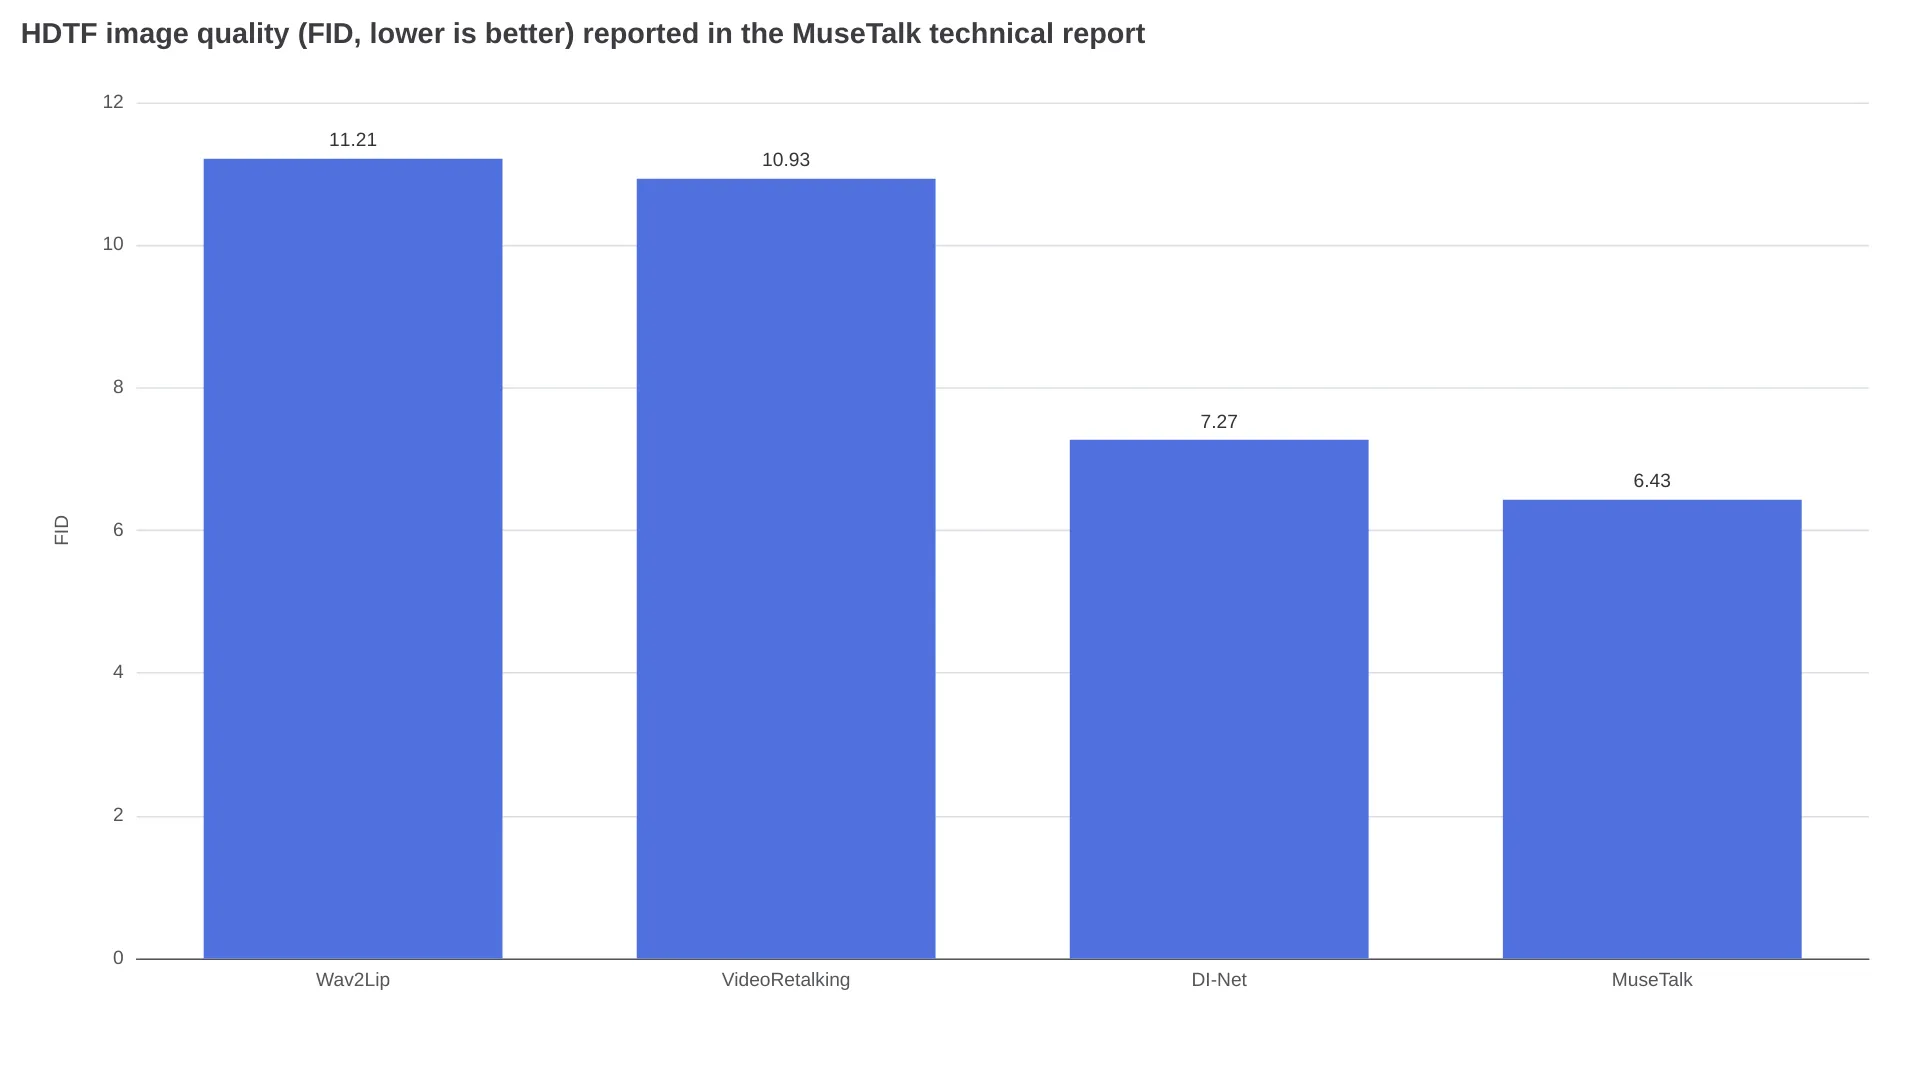
ところが同期精度の指標に切り替えると順位は変わります。同じ報告では、Wav2LipのLSE-Cが7.46、MuseTalkが6.53です。一方、人物同一性の類似度ではMuseTalkがCSIM 0.8225、Wav2Lipが0.8184となり、MuseTalkがわずかに上回ります。つまり、古いGANモデルのWav2Lipは唇の追従性に強く、MuseTalkは画像の忠実度に強いということです。なお、同報告のユーザー調査は全体として控えめな評価で、視覚品質が5点満点中3.62、人物同一性が3.55、リップシンクが3.41でした。
256x256という制約を踏まえると、これらの数字が示すのは、4Kのクローズアップにも耐えるモデルというより、説得力のあるミドルショット向けのモデルです。
リップシンク1分あたりの料金
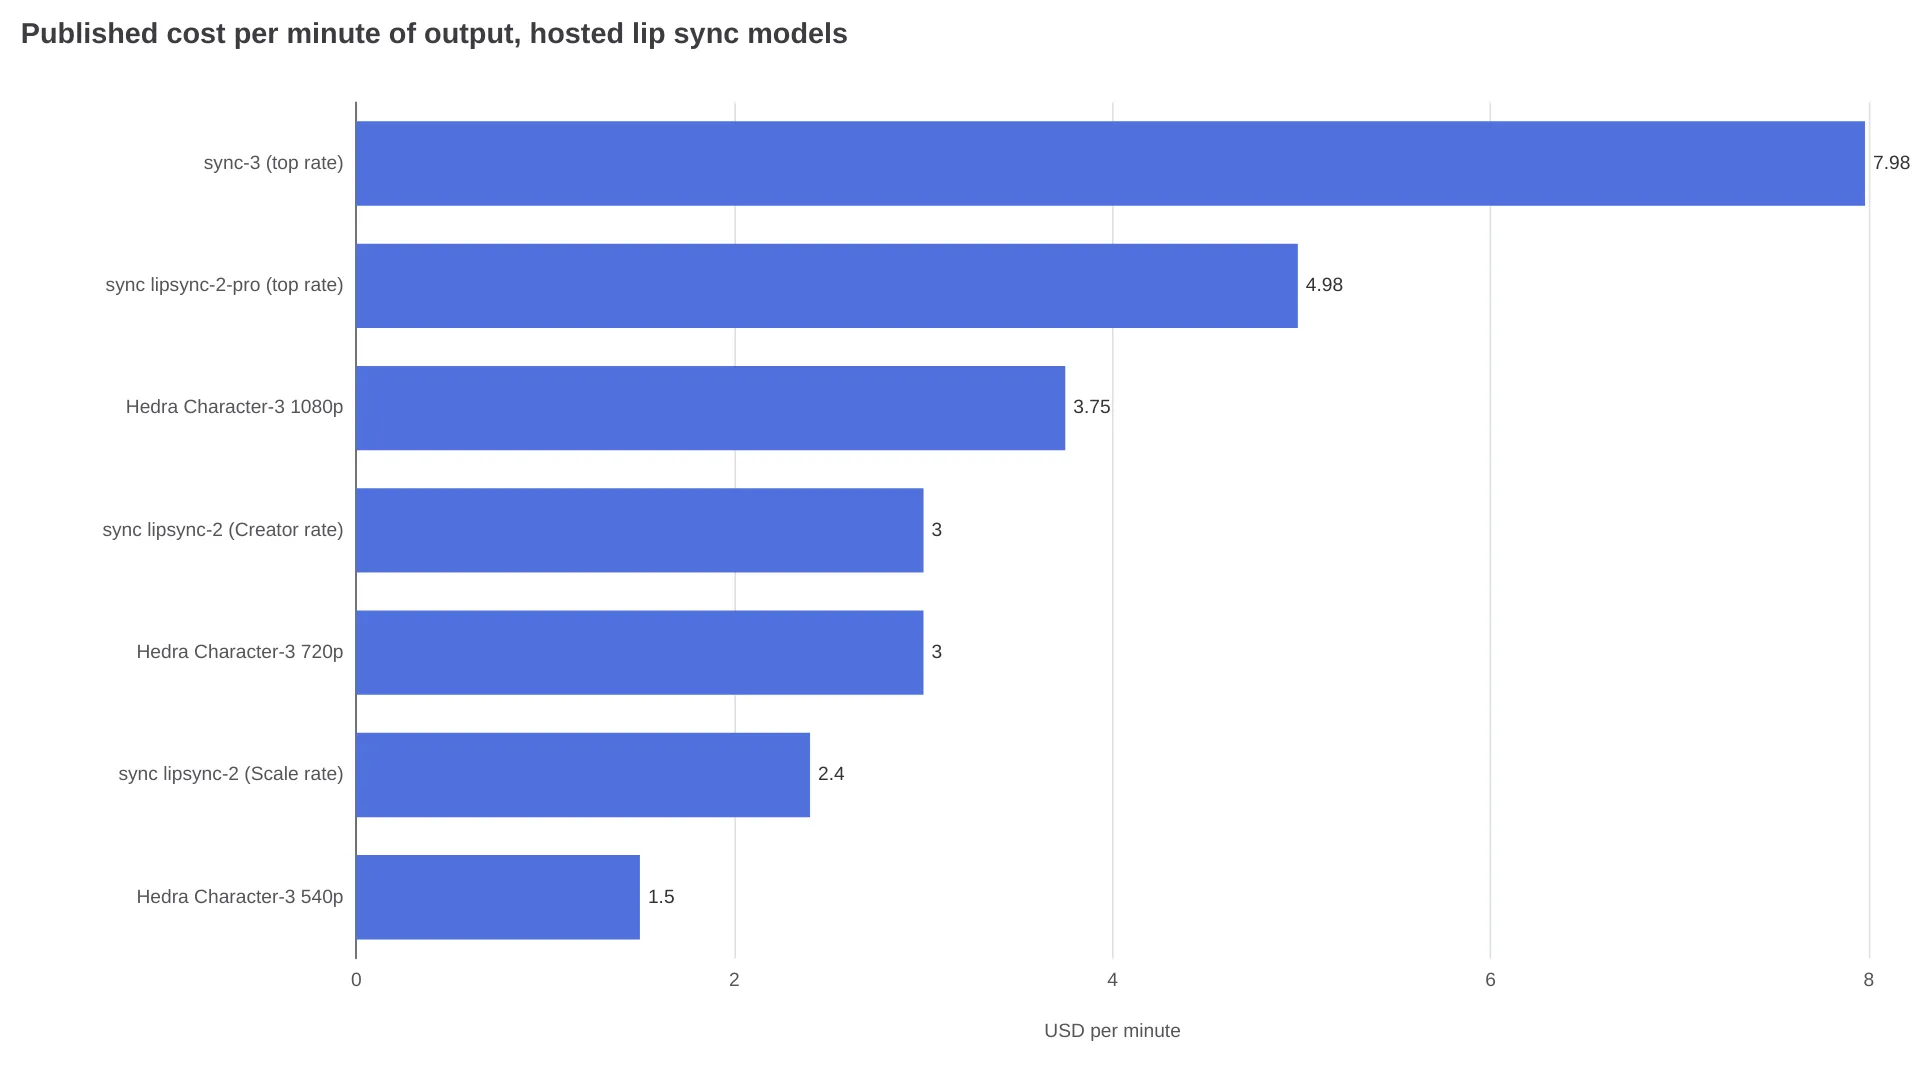
オープンソース方式が力を発揮するのはここです。ホスティング型のリップシンクモデルは、出力1分あたり1.50ドルから、ほぼ8.00ドルまでの料金が公開されています。
| 方式 | 公開料金(課金単位は異なる) | 出力1分あたり | 顔の解像度 |
|---|---|---|---|
| MuseTalkセルフホスト、Tesla V100レンタル | 0.188ドル / GPU時間 | クリップ1分あたりGPU 2分で約0.006ドル | 256x256 |
| Replicate上のMuseTalk | 約0.052ドル / 実行、モデルページによる標準的な実行時間は54秒 | 1分単位ではなく実行単位で課金 | 256x256 |
| fal.ai上のMuseTalk | コンピュート秒単位で課金 | モデルページに記載なし | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — 既存映像向けではなく、image-to-video | 1秒あたり2.5セント / 5セント / 6.25セント | 1.50ドル / 3.00ドル / 3.75ドル | 該当なし |
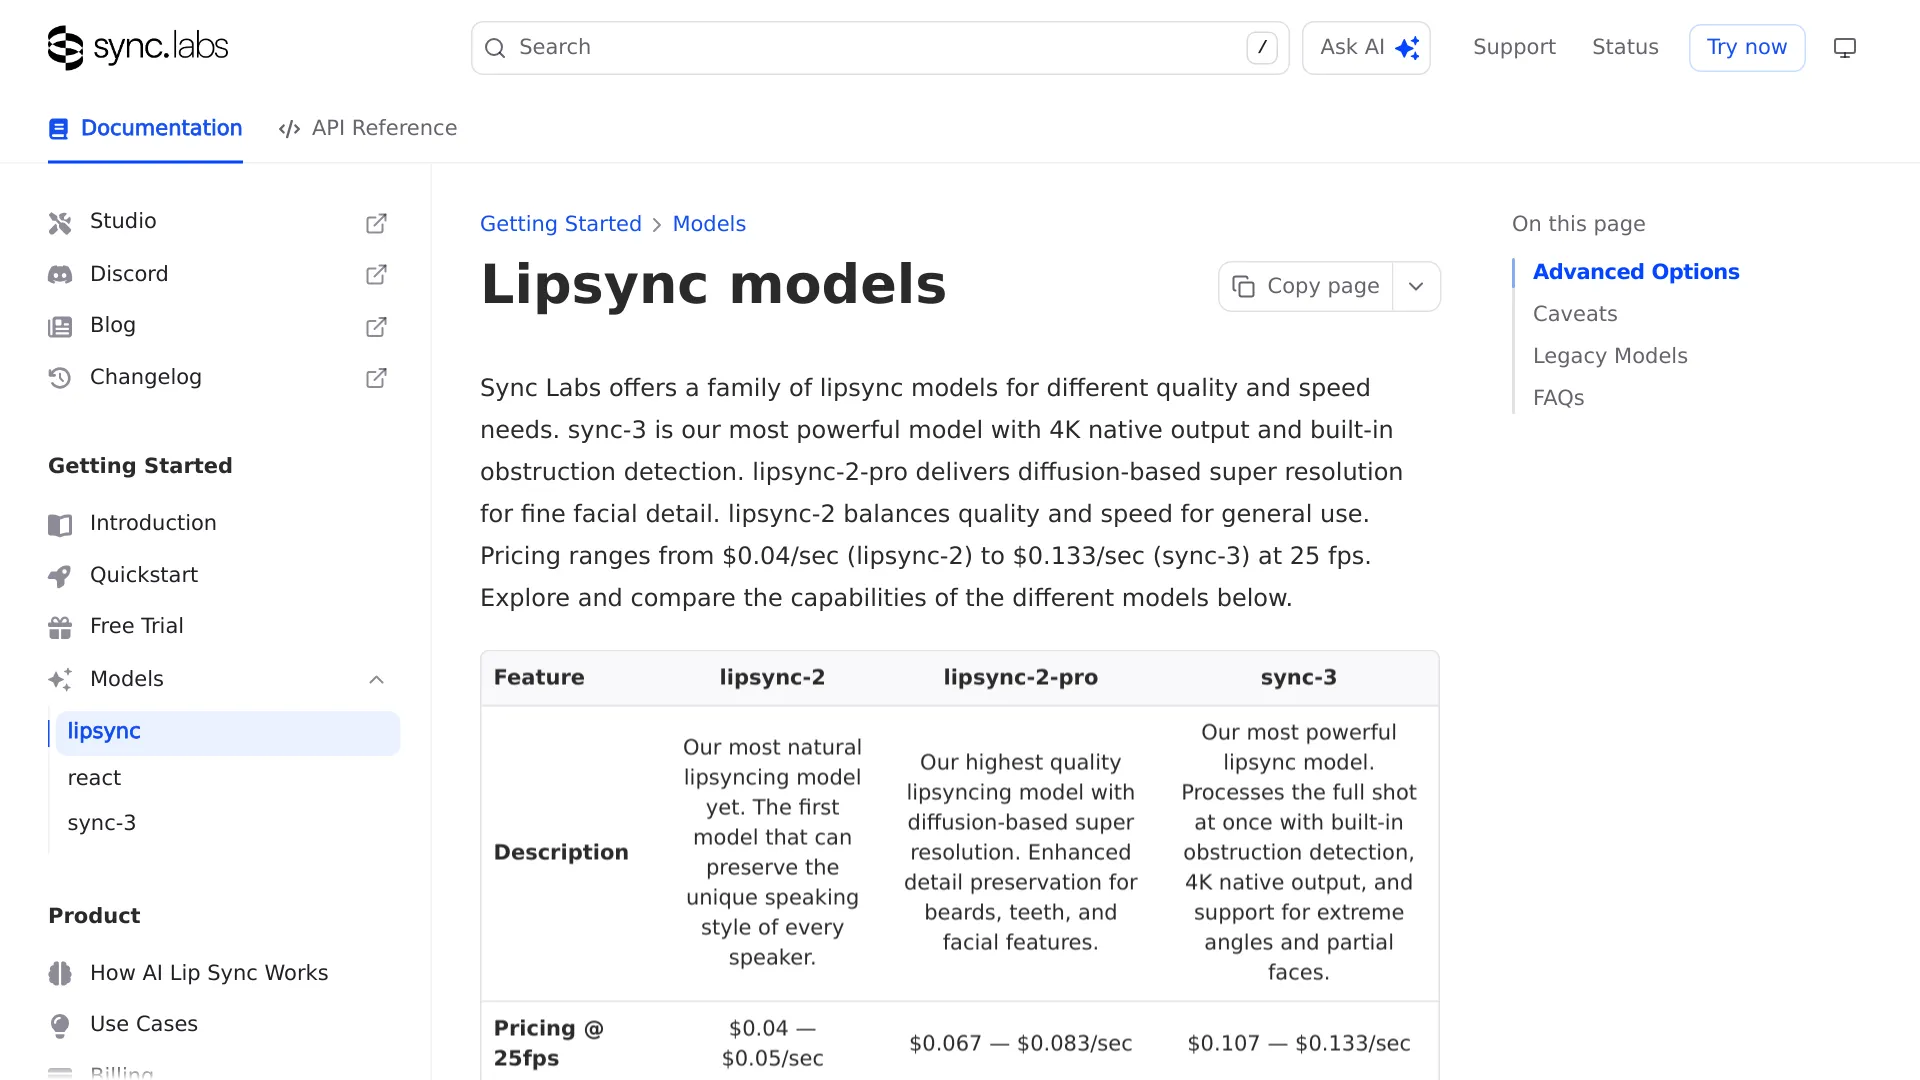
| sync lipsync-2 | 25 fpsで1秒あたり0.04~0.05ドル | 2.40~3.00ドル | 512x512 |
| sync lipsync-2-pro | 1秒あたり0.067~0.083ドル | 4.02~4.98ドル | 512x512 + ディテール処理 |
| sync-3 | 1秒あたり0.107~0.133ドル | 6.42~7.98ドル | 4Kネイティブ |
セルフホストの数字は、NexGPUのコスト解説に基づいています。1分の動画に対して、推論、DWPose検出、VAEのエンコードとデコード、FFmpegによる多重化を含め、エンドツーエンドでGPUを2分使う前提です。1分の動画を100本処理した場合、0.188ドル/時間のV100なら計算資源の料金は約0.63ドル、セットアップ時間を加えても約0.09ドルです。ただし、これはGPUレンタル代だけの数字で、エンジニアリングの工数、ストレージ、運用コストは含みません。
ローカライズ案件の規模に置き換えると、差はさらに明確になります。吹き替え動画500分を処理する場合、セルフホストのMuseTalkならV100のレンタル代はおよそ3ドルです。一方、Creator料金のsync lipsync-2では1,200ドルかかります。
無料方式が無料ではなくなる境界線
1分あたりの追加料金で買えるものは、かなり具体的です。
- 顔生成の解像度。syncのモデルドキュメントによれば、lipsync-2とlipsync-2-proは512x512で顔を生成します。MuseTalkの領域の2倍です。sync-3はネイティブ4Kで出力し、超解像も組み込みで処理します。
- 難しい構図への対応。同じドキュメントでは、sync-3が横顔、肩越しの構図、顔の一部しか映っていないショットをネイティブに処理し、遮蔽物も自動検出すると説明されています。MuseTalkはフレームごとに顔検出を行うため、顔を横に向けた場面や、口元を手で覆う場面は、ドキュメント上も失敗しやすいポイントです。
- 複数人の映像。syncの現行3モデルには、アクティブスピーカー検出がオプションとして用意されています。MuseTalkには同等のフラグはありません。
- セットアップ時間。セルフホストなら一度払えば済むコストですが、決して小さくありません。
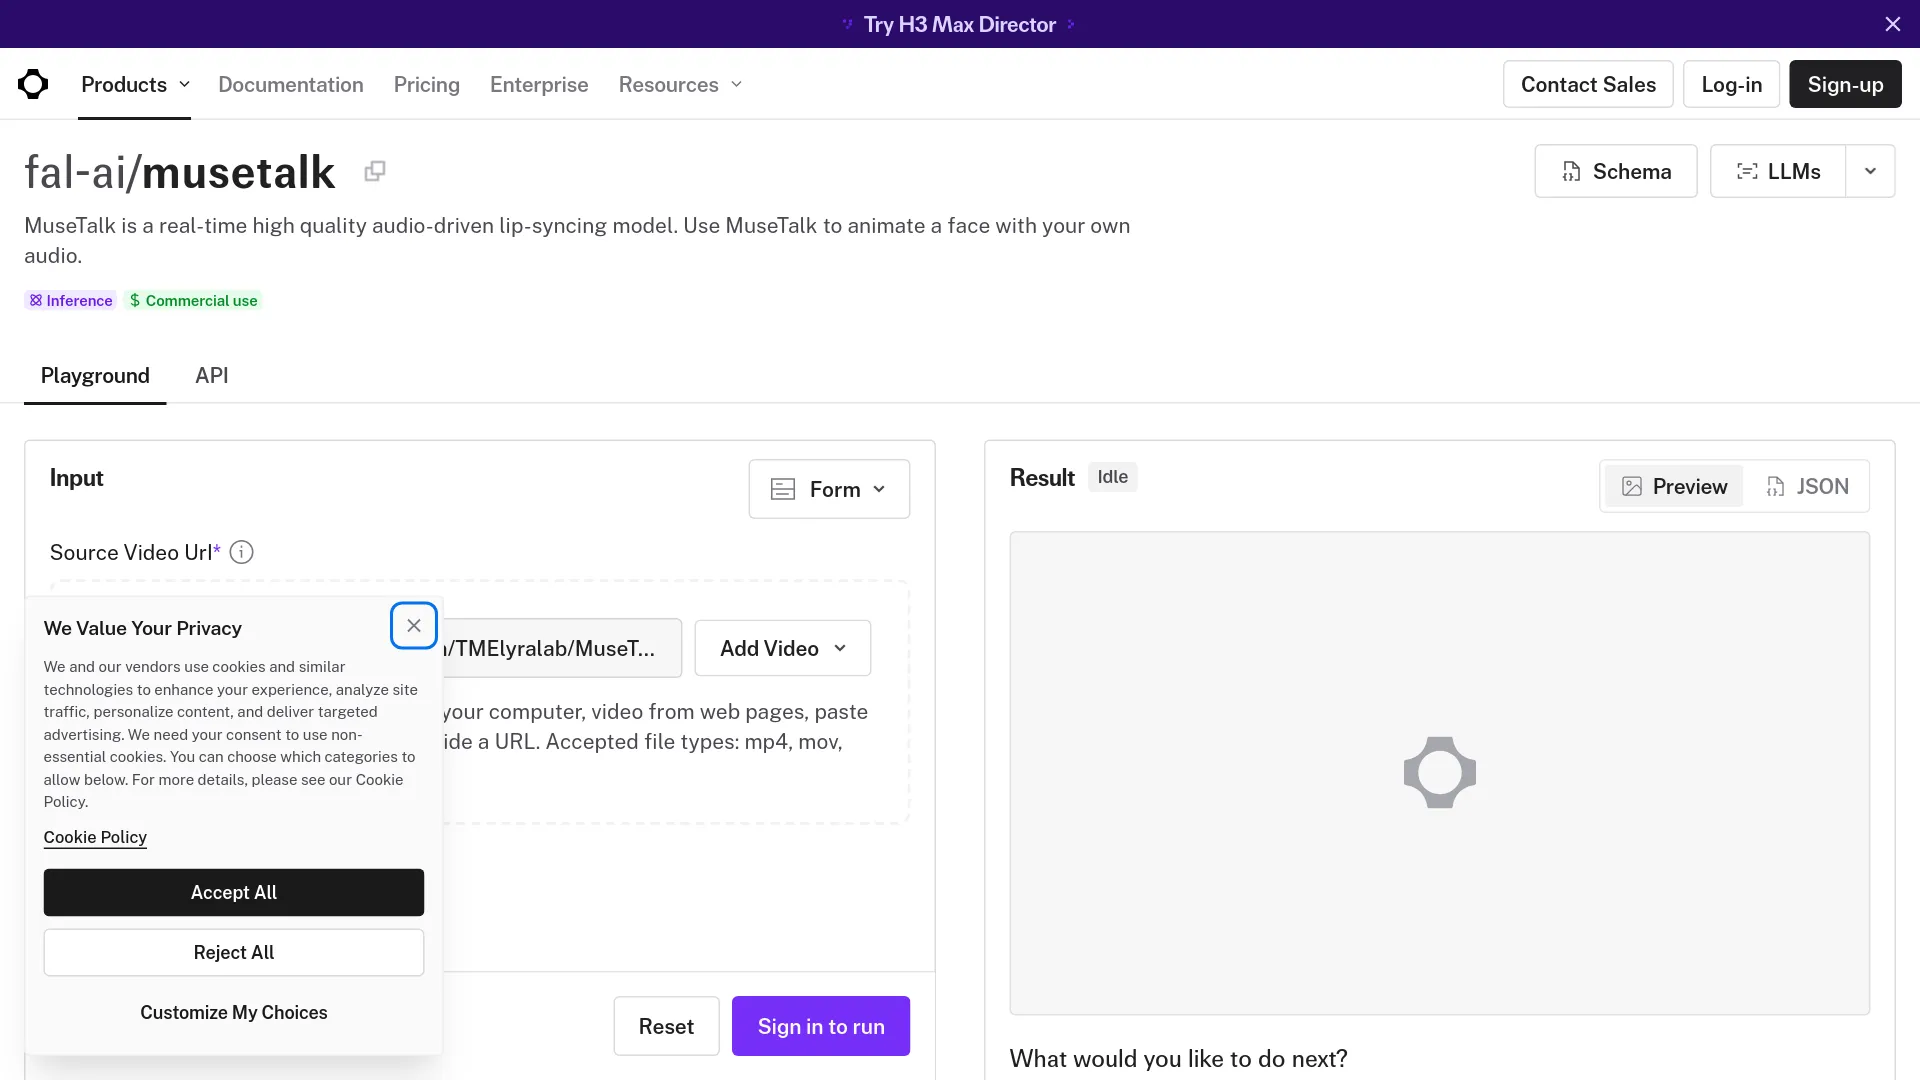
fal.aiのMuseTalkページを見ると、最後の項目に料金を払う意味がよく分かります。必要なのは動画URL、音声URL、それだけです。conda環境も、CUDAのバージョン固定も、重みファイルの配置も必要ありません。
依存関係に悩まずMuseTalkを動かす
実際にこのモデルを動かした人から繰り返し聞かれる不満は、出力品質とは関係ありません。問題はOpenMMLabの依存関係です。r/StableDiffusionでリップシンクモデルを比較したユーザーは、MuseTalkとLatentSyncを試した後、次のように率直に書いています。
「LatentSyncとMusetalkは動くし、性能も似ている……ただ、MusetalkはOpenMMLabのライブラリに依存しているのでセットアップが面倒だ。」— u/Traditional_Tap1708、r/StableDiffusion
READMEで指定されているバージョンは、通常のpipではなくmim経由でインストールしてください。
- 新しいconda環境にPython 3.10を用意し、PyTorch 2.0.1、torchvision 0.15.2、torchaudio 2.0.2を入れます。
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0"を実行します。mmdetのインポートエラーは、新しいmmcvを入れてしまったことが原因になるケースがよくあります。- FFmpegを
PATHに追加し、ffmpeg -versionで確認します。Windowsでは--ffmpeg_pathで明示的に指定することもできます。 sh download_weights.shで必要なファイル一式を取得します。UNetだけでは足りません。このスクリプトはsd-vae-ft-mse、Whisper、DWPoseのdw-ll_ucoco_384.pth、BiSeNetの顔パース用重みも取得します。ファイルが1つ欠けていても、分かりやすいエラーではなく、顔検出や合成の失敗として表面化しがちです。ffmpeg -i input.mp4 -r 25 output.mp4で入力素材を25 fpsに変換します。リポジトリが25 fps入力を推奨しているのは、そのフレームレートでモデルが学習されているためです。タイミングのずれは、入力フレームレートの不一致が原因になることが多いです。configs/inference/test.yamlで動画と音声を指定し、python -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15を実行します。
同じ顔に対して何度も生成するなら、まずconfigs/inference/realtime.yamlでpreparation: trueに設定します。results/v15/avatars/以下にcoords.pkl、latents.pt、マスク一式がキャッシュされたら、falseに戻します。--skip_save_imagesの追加も重要です。PNGをディスクに書き出す処理が、モデル本体より大きなボトルネックになることがあります。
MuseTalk 1.5と1.0、ダウンロードすべき重みはどちらか
1.5を使いましょう。リポジトリでは、2025年3月28日付の最新リリースとして掲載されています。知覚損失、GAN損失、同期損失を組み合わせ、2段階学習も取り入れたことで、明瞭さ、人物同一性、唇と音声の一致が改善されたと説明されています。
1.0を残しておく理由があるとすれば、bbox_shiftが使えることです。この機能は1.0にのみ適用され、マスク境界を上下に動かします。正の値では口が大きく開き、負の値では閉じます。
まずデフォルト設定で1回実行すると、スクリプトがその動画で調整可能な範囲を表示します。READMEの例では[-9, 9]となり、最終的に-7を選んでいます。得られた範囲の中で再レンダリングし、口の開きが大きすぎるなら負の方向へ、ほとんど開かないなら正の方向へ動かします。
遭遇しやすい失敗と、設定で直せる範囲
| 症状 | 原因 | 修正可能か |
|---|---|---|
| 処理が中断され、顔が検出されない | 横向き、遮蔽、または顔が映っていないフレームが1つある | 可能。該当部分をクロップまたはカットする |
| 口がほとんど動かない | 音楽に音声が埋もれている、またはマスク境界が高すぎる | 可能。声だけを分離し、v1.0ではbbox_shiftを正にする |
| 途中から唇が音声とずれる | 素材が25 fpsではない | 可能。処理前に変換する |
| シャープな顔に対して口元だけぼやける | 256x256の領域に対して画面内の顔が小さすぎる | 一部可能。クロップを寄せ、fp16を外し、顔補正を追加する |
| 継ぎ目が見える、口ひげが維持されない | 顔の下半分を生成し直すため、人物固有のディテールが置き換わる | 不可。モデルの制約として記載されている |
| フレーム間で揺れる | 各フレームが個別に生成される | 一部可能。リポジトリではv1.5の2段階学習による一貫性向上をうたっている |
| 漫画や stylised な顔で失敗する | 学習データが実写の顔を中心としている | 不可 |
| 静止した話者に対して勢いのある音声を合わせる | MuseTalkは頭の動きや表情を変更しない | 不可。元映像を撮り直すか、素材自体を差し替える |
VRAMの少ない環境でテストしたユーザーは、MuseTalkについて「7秒の音声に171秒」と報告し、「リアルな画像でしか動かない」とも書いています(u/Bartholomheow、r/StableDiffusion)。一方、「リアルタイム」という触れ込みは、アバターの準備後に出せる継続的な処理速度を指しており、最初から最後までの遅延ではありません。r/LocalLLaMAでトーキングヘッドを開発しているユーザーも、MuseTalkについて「準備時間が長すぎる」と報告しており、インタラクティブ用途では問題になったとしています(u/lonyPorgrammer)。
用途別に選ぶリップシンクの方式
| 方式 | 向いているケース | 主なトレードオフ |
|---|---|---|
| セルフホストのMuseTalk | 大量処理と扱いやすい素材。ローカライズの下書き、1つの顔を何千もの音声クリップで使い回すインタラクティブアバター、社内研修動画 | セットアップは数分ではなく数時間単位。処理速度は借りるGPUに左右される |
| ホスティング型MuseTalk(Replicate、fal.ai) | 少数のクリップを処理したい場合や、導入を決める前に手元の素材で品質を試したい場合 | 256x256の上限は変わらず、どちらのエンドポイント仕様にもアバターキャッシュ用フラグはなく、実行単位で課金される |
| 有料リップシンクモデル(sync-3、lipsync-2-pro) | 顧客向けの映像、大きなクローズアップ、横顔、遮蔽物、複数話者、4K納品 | 1分あたり4~8ドル。映像が自社インフラの外に出る |
公式の処理速度を再現するならV100を、ライブ配信を行うなら4090をレンタルするのがよいでしょう。ホスティング型エンドポイントについては、両プラットフォームをReplicateのレビューとfal.aiのレビューで詳しく取り上げています。
MuseTalkリップシンク FAQ
MuseTalkは6 GBや8 GBのGPUで動きますか?
動きます。READMEには、4 GBのRTX 3050 TiノートPC向けGPUをFP16でテストした記録があります。基本的な推論は限られたVRAMでも収まりますが、実用上の制約になるのは処理速度です。
256x256が出力解像度ですか?
違います。256x256は編集対象となる顔領域のサイズです。元動画の解像度とフレームレートを維持した映像に、その領域を合成して戻します。
MuseTalkは漫画やアニメの顔にも使えますか?
安定して使えるとは言えません。モデルは実写のトーキングヘッド映像で学習されており、 stylised な入力を試したユーザーからも結果にばらつきがあると報告されています。
「30 fpsのリアルタイム」という数字に前処理は含まれますか?
含まれません。これはアバターの準備が終わった後、Tesla V100上で生成できる処理速度です。顔検出、潜在表現のエンコード、初回のキャッシュ作成はその前に行われます。
MuseTalkとLatentSync、どちらを選ぶべきですか?
プロジェクトで遅延と処理量が重視されるならMuseTalkです。1ステップ推論とアバターのキャッシュによって、クリップごとのコストを抑えられます。上で紹介したr/StableDiffusionのユーザーは両方を実行し、性能は似ていると説明していました。そうなると、決め手は画質よりも処理速度になります。
MuseTalkは商用利用できますか?
リポジトリのコードはMITライセンスですが、依存関係のライセンスは統一されていません。Whisper、VAE、DWPose、BiSeNetの顔パース、SyncNetはそれぞれ独自の条件で提供されています。サンプルデータにも別途制限があるとリポジトリに記載されています。製品として出荷する前に、各ライセンスを確認してください。
この価格でも解消されていないトレードオフ
MuseTalkは、ほとんどコストをかけずに必要なところまで連れていってくれます。ただし、人物の同一性を厳密に保つことには弱さが残ります。口ひげ、唇の正確な形、画面いっぱいに映る顔、話しながら頭を横に向ける話者。こうした条件では限界が見えてきます。
多くのチームにとって、答えは1つのツールに絞ることではありません。大量処理にはMuseTalkを使い、フルスクリーンで見られる重要なカットには有料モデルを使う。この組み合わせが現実的です。
関連記事
- Higgsfield AIのレビューとAPI利用との料金比較
- Kokoro 82MのローカルTTSセットアップガイド。MuseTalkが使用する音声トラックの生成方法
- Wan 2.2 Animateガイド