 AIREITER
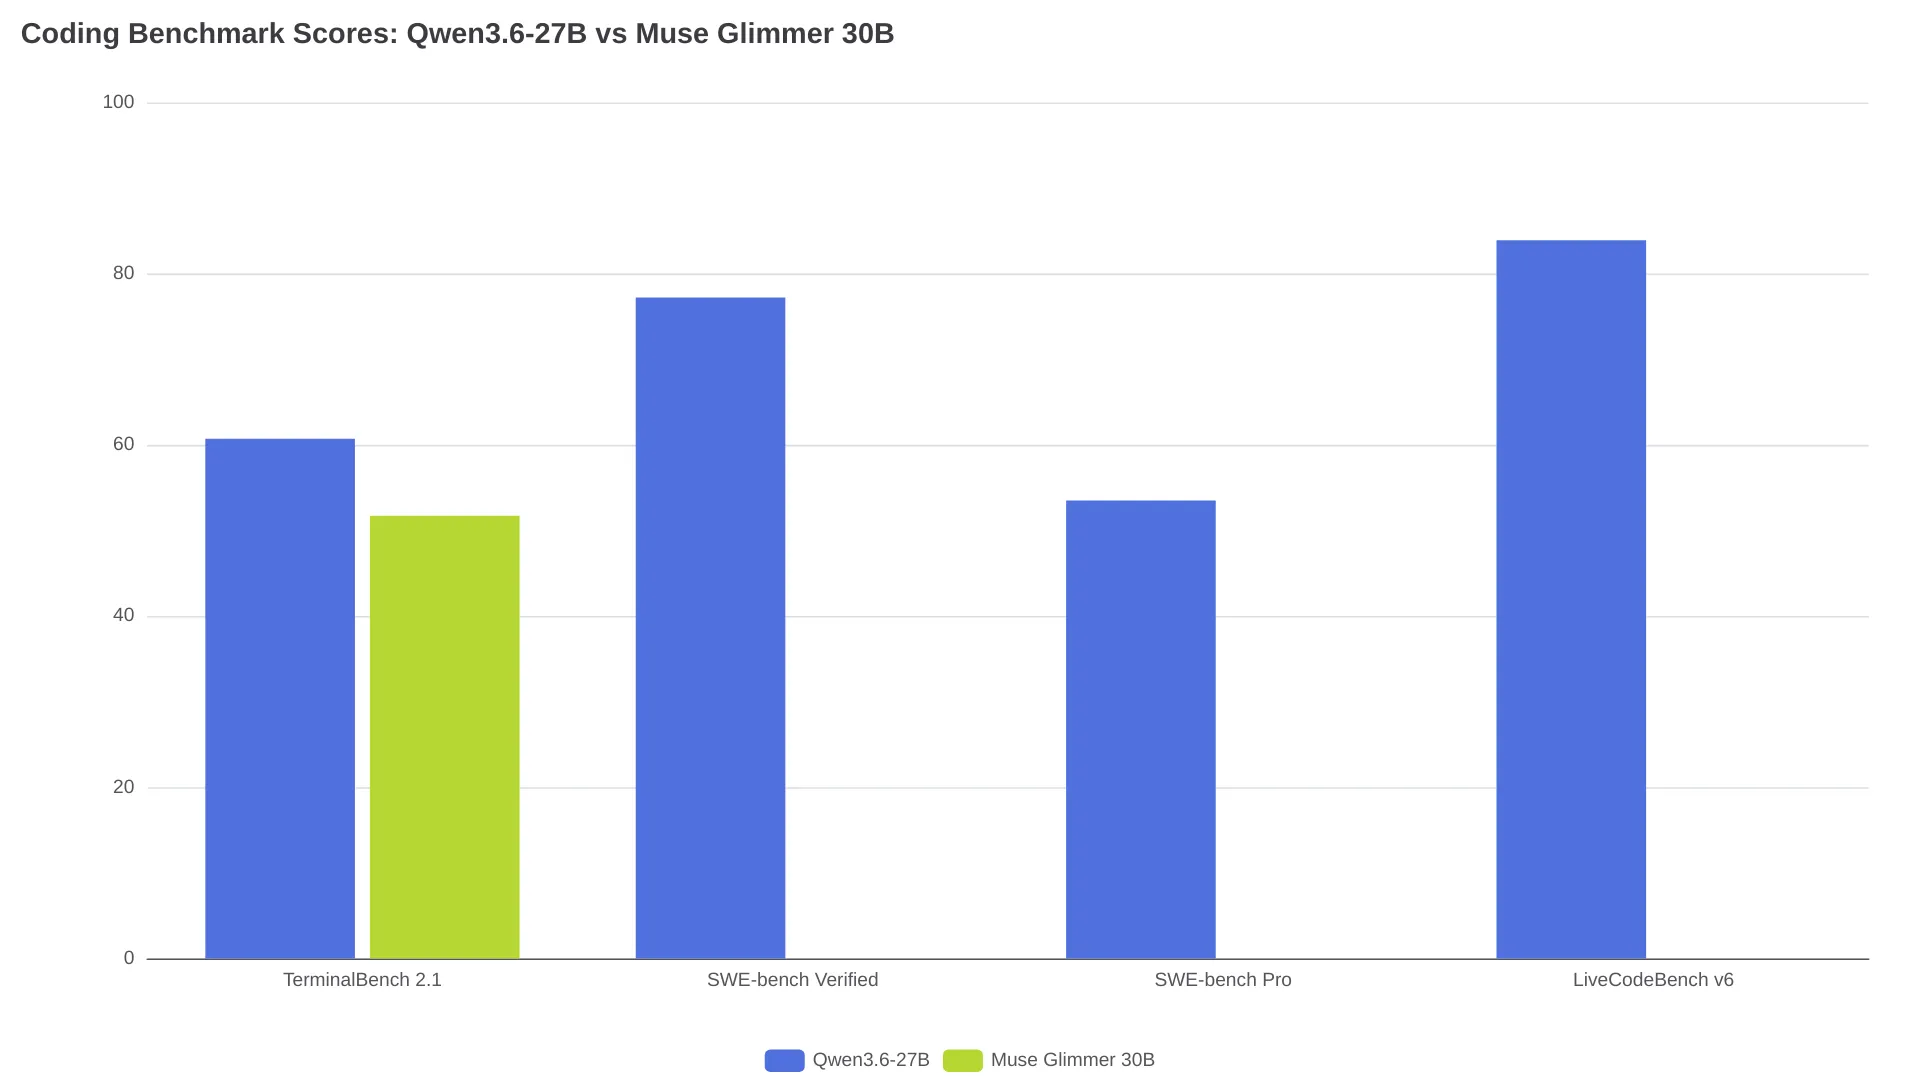
ローカル環境でコーディング用LLMを選ぶなら、ベンチマークの強さだけでは決められません。Qwen3.6-27BはTerminalBench 2.1で60.7、Muse Glimmer 30Bは51.7と、エージェント型コーディングの数値ではQwenが優勢です。Qwenの公式SWE-bench Verifiedスコアも77.2に達しています。ただし、RTX 3090 1枚で使う場合は話が変わります。Muse Glimmerは大幅に長いコンテキストをVRAM内に収められ、手元のGPUで何を実行できるかという観点では明確な利点があります。
TerminalBench 2.1ではQwenが9ポイント先行
TerminalBenchは、ツール呼び出しや長時間のコンテキスト維持を含む、複数ステップのターミナルエージェントとしての信頼性を測るベンチマークです。リンク先のコミュニティ議論では、直接比較できるコーディングエージェントの結果としてTerminalBench 2.1が頻繁に参照されています。
2026年8月10日から11日にかけてのr/LocalLLaMAの議論で共有された、コミュニティ報告ベースのTerminalBench 2.1スコアは以下のとおりです。
| モデル | TerminalBench 2.1 | 情報源 |
|---|---|---|
| Qwen3.6-27B | 60.7 | コミュニティ報告 |
| Muse Glimmer 30B | 51.7 | コミュニティ報告 |
| Gemma 4 31B | 43.4 | コミュニティ報告 |
注意したいのは、TerminalBenchが評価するのはモデル単体ではなく、モデルとハーネスを組み合わせた結果だという点です。Qwen3.6-27Bの公式カードでは、Harbor/Terminus-2ハーネス、3時間のタイムアウト、32 CPU、48 GB RAM、最大出力80K、コンテキスト256K、5回実行の平均という条件が明記されています。Glimmer側は異なる、あるいは最適化が十分でないハーネス設定だった可能性があります。そのため、この9ポイント差は実際に使うエージェント環境によって縮まることも、広がることもあり得ます。
公開済みのコーディング指標ではQwenが優位。Glimmerの公式値は未公表
Qwen3.6-27Bはモデルカード上で公式ベンチマーク結果を公開しています。一方、この比較で確認したリンク先の情報源では、2026年8月時点でMuse Glimmerの公式SWE-bench、LiveCodeBench、または同等のエージェント型コーディングベンチマークは見つかりませんでした。公開根拠の厚みではQwenが上ですが、公式条件を揃えた直接対決はまだ存在しません。
Qwenが公式に公開しているコーディングベンチマークは以下です。
| ベンチマーク | Qwen3.6-27B(公式) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
これらはベンダー公表値です。モデルカードによれば、SWE-benchの評価にはQwen独自のbash/file-edit scaffoldを使用し、temperature 1.0、top-p 0.95、コンテキストウィンドウ200Kという設定です。またSWE-bench Proは、Qwenが問題のある項目を修正した精査済みタスクセットで算出されています。そのため、公開リーダーボードの数値と単純に横並びで比較できるとは限りません。morphllmの第三者解説も、Qwen独自のエージェントscaffoldへの依存と、独立再現の少なさを指摘しています。
ローカル検証で見えた実際の使い勝手
M5 Pro+OpenCodeでのQ4テスト
ある開発者は、48 GB RAM搭載のM5 Proで、Q4量子化版のMuse Glimmer(Unsloth build)をOpenCode経由でテストしました。使用メモリは約20 GB、生成速度は17トークン/秒でした。結論は次のようなものです。
「総合的にはQwen3.6 27Bより下」 - u/curiousily_
フロントエンド、バックエンドともに、生成されたコードの評価はQwenを下回りました。ただし、テスト中にツール呼び出しの失敗が一度もなかった点はプラスとして挙げられています。この検証では推論ループや拡張思考を設定しておらず、それがGlimmerの性能を抑えた可能性もあります。
max_tokens不足で性能を見誤る問題
r/LocalLLMの別のテスターは、出力トークン予算が小さすぎるとMuse Glimmerが実力以上に悪く見えることを発見しました。このモデルは可視出力を生成する前の推論でトークン予算を使い切ることがあり、空の回答や途中で切れた回答になります。max_tokensを引き上げたところ、モデル自体を変更せずにテストハーネスの通過タスク数が13件中6件から13件中11件へ向上し、通過率はほぼ2倍になりました。デフォルトの出力制限でGlimmerを試すと、モデルではなく設定を測っている可能性があります。
Hermesで起きたターミナル操作のループ
別のユーザーは、Hermesエージェントフレームワークと組み合わせた際、Muse Glimmerが過剰なターミナルコマンドを繰り返して停止すると報告しています。同じ環境でQwen3.6-27Bを使ったときには見られなかった挙動です。この逸話はTerminalBenchで見られる差と方向性としては一致しますが、モデル固有の問題とHermesの設定を切り分けたものではありません。
トークン効率は有望だが、まだ定性的な評価
u/NoFaithlessness951によるベンチマークギャラリー投稿では、効率面に着目した意見も出ています。
「Qwenより少し賢さでは劣るが、タスク当たりのトークン数はかなり少ない」 - u/NoFaithlessness951
ただし、これはコミュニティによる定性的な観察であり、成功タスク当たりのトークン数を統制条件で比較した測定ではありません。同一タスク、成功率、レイテンシーを揃えてGlimmerとQwenのトークン効率を比較した研究はまだありません。この効率面の主張は、確立した事実ではなく、今後検証すべき有望な手がかりとして扱うべきでしょう。
VRAMとコンテキストではGlimmerが大きくリード
ここはMuse Glimmerが明確に優位な領域です。r/LocalLLaMAのテスターは、Q4_K_XLのMuse Glimmer 30BにDFlash speculative decoding、マルチモーダルprojector、フルF16 KV cacheを組み合わせても、RTX 3090 1枚の約22~23 GBに収まり、262,144トークンのコンテキストウィンドウを設定できることを実証しました。
同じRTX 3090、同じQ4_K_XL量子化での比較です。
| モデル | F16 KVのコンテキスト | Q8 KVのコンテキスト | 使用VRAM |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | 24 GBに収まる |
| Gemma 4 31B | 52,000 | 81,000 | 24 GBに収まる |
この検証者は、大規模リポジトリのコンテキストをプロンプトへ読み込むワークフローでは、Qwenの70K F16コンテキストは「実用性の境界線上」にあると表現しています。
同RTX 3090環境で報告されたMuse Glimmerのスループットは次のとおりです。
- 生成速度:64~124トークン/秒(コードか文章かで変動)
- プロンプト処理:約1,400トークン/秒
- 長文コンテキスト検索:約150Kトークンのtwo-needle haystackテストを初回で通過
同じハードウェアでQwen3.6-27Bに長いコンテキストを持たせるには、Q8 KV cache圧縮によって出力忠実度をコンテキスト長と引き換えにするか、より高性能なマシンへオフロードする必要があります。このテスターはフルコンテキストが必要な場合、Qwenを大幅に高価なDGX Sparkへ移していると報告しています。
上位ハードウェアでは、DGX Spark上のQwen3.6-27B NVFP4 buildが、最大128Kのコンテキストで単一セッションあたり28~33トークン/秒に達したとkie.aiのベンチマーク分析は報告しています。また、RTX 5090上のUnsloth Muse Glimmer Q5_K_M buildは、パッチ適用済みのllama.cpp DFlashパス経由のコードパッチ生成で、220~253トークン/秒に達したとされています。
結局、どちらを選ぶべきか
| 用途 | 選択 | 理由 |
|---|---|---|
| コーディング専用の一発生成 | Qwen3.6-27B | 公開済みのコーディングベンチマーク根拠がより強く、利用可能なTerminalBench 2.1のコミュニティ比較でも先行 |
| 24 GB GPU 1枚での大規模コンテキストを使うエージェント型コーディング | Muse Glimmer 30B | 同一ハードウェアのQ4_K_XL/DFlash構成で、Qwenの70Kに対して262KのF16コンテキスト |
| 長時間にわたるターミナルタスク | Qwen3.6-27B | TerminalBench 2.1で60.7対51.7。Glimmerではエージェントフレームワークのループもコミュニティ報告あり |
| 大量処理でコストを重視する用途 | Muse Glimmer 30B(可能性あり) | タスク当たりのトークン数が少ないというコミュニティ報告があるが、成功当たりのコストを揃えた比較はない |
| 大きなコンテキストを使うリポジトリ単位のコーディング | Muse Glimmer 30B(VRAMが限られる場合) | 24 GB環境で大きなコンテキストを使うには、QwenはQ8 KV圧縮またはマルチGPUを必要とする |
| ハードウェア制約なしで最大のコーディング精度を求める場合 | Qwen3.6-27B | より強力な公開ベンチマークと公式スコア |
FAQ
Muse Glimmerに公式SWE-benchスコアはある?
ありません。この比較で調査した情報源では、2026年8月時点でMuse Glimmer 30Bの公式SWE-bench、LiveCodeBench、TerminalBenchスコアは見つかりませんでした。TerminalBench 2.1の51.7は、Meta公式の評価ではなくRedditスレッドでのコミュニティテストによる数値です。
どちらもRTX 3090 1枚で動かせる?
はい。Muse Glimmer 30BはQ4_K_XLで、262KコンテキストとフルF16 KV cacheを約22~23 GBに収められます。Qwen3.6-27BもQ4_K_XLで動作しますが、同じGPUではF16 KVで70K、Q8 KV cache圧縮では125Kのコンテキストに制限されます。
Muse Glimmerはコーディング用途で検閲される?
あるユーザーは、Muse GlimmerがPythonのマウス制御コードのデバッグ支援を拒否し、セキュリティ上の懸念として扱ったと報告しています。ただし、これはsystem promptや設定が明示されていない単一の逸話です。この挙動がモデル自体によるものか、推論環境によるものかを判断するには不十分です。
エージェント型コーディングにはどちらが向く?
TerminalBenchスコアとコミュニティ報告を見る限り、長時間にわたるターミナルエージェントのタスクではQwen3.6-27Bのほうが信頼性は高めです。Muse Glimmer 30BはVRAM効率に優れるため、限られたハードウェアではより現実的な選択肢になります。また、タスク当たりのトークン数を抑えられる可能性があり、大量のエージェントループではコストとレイテンシーを減らせるかもしれません。ただし、これを定量化した統制比較はまだありません。
Muse Glimmerでコーディングする場合、max_tokensはどれくらいにすべき?
出力予算は余裕を持って設定してください。あるテスターは、厳しいmax_tokens制限により、Glimmerが可視出力を作る前の推論で予算を使い切り、失敗に見える空の回答や途中で切れた回答になることを確認しました。上限を引き上げると、テストハーネスの通過タスク数は13件中6件から13件中11件へ改善しました。Qwen3.6-27Bのモデルカードは、一般的な問い合わせには32,768トークン、難しいベンチマークタスクには81,920トークンを推奨しています。Metaが独自の指針を公開するまで、Glimmerでも同じ出力予算を出発点にするのが妥当です。