 AIREITER
検索精度を少しでも押し上げたいなら、マルチベクトル埋め込みは魅力的に映る。ただし、その代償はかなり大きい。2026年8月18日に発表されたSentence Transformers 6.0では、dense・sparse・rerankerに並ぶモデル種別としてMultiVectorEncoderが加わった。Hugging Faceのローンチ時ベンチマークを見る限り、期待値は冷静に置くべきだ。late interactionは同一条件のdenseモデルに対しNanoBEIRの13データセット中9つで勝ったものの、平均差は約1 NDCG@10ポイントにとどまる。一方、作例の生インデックスは384次元のMiniLMベースライン比で42倍、同規模のdenseモデル比でも21倍だ。この交換条件を受け入れる価値があるかは、ほぼ完全にクエリの性質で決まる。
Multi-Vector(Late Interaction)は何が違うのか
マルチベクトル埋め込みでは、文書全体を1本のプーリング済みベクトルに潰さず、トークンごとにベクトルを保持する。Hugging Faceが対応するモデルでは、トークンベクトルは慣例的に128次元だ。一般的なdense埋め込みの384、768、1,024次元より短いが、文書中のトークン数ぶん生成される。スコアリング時にはMaxSim演算子を使い、各クエリトークンについて文書内の全トークンからドット積が最大のものを取り、その最大値を合計する。式で書けばMaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ)となる。これらのモデルはL2正規化されているため、各項は[-1, 1]に収まり、最終スコアはクエリ長に応じて大きくなる。
位置付けとしては、late interactionは次の2方式の中間にある。
| アーキテクチャ | 文書側 | スコアリング | コスト特性 |
|---|---|---|---|
| Dense bi-encoder | 事前計算したプーリング済みベクトル1本 | ドット積1回 | 検索は最速だが、プーリングでトークンの詳細が失われる |
| Late interaction | 事前計算したトークンごとのベクトル | トークン対に対するMaxSim | 表現力の高い照合ができる一方、インデックスは文書長に比例して増える |
| Cross-encoder | 事前計算なし | クエリ・文書ペアごとに完全なforward pass | Hugging Faceのローンチ記事ではペア単位で最も高精度。ただし第1段検索には高コストすぎる |
この考え方は、元祖であるColBERTの論文で「contextualized late interaction」として定式化された。
利点はトークン単位の対応に現れる。Hugging Faceのlightonai/mLateOnの例では、クエリ中の「live」と文書中の「inhabit」が0.94の類似度で対応した。語句自体は一切重なっていなくても、意味的な対応を拾えている。
マルチベクトルが効く検索パターン
短いパッセージ中心のベンチマークだけでは、この方式が本領を発揮するケースを捉えきれない。この記事で比較した5つの情報源、Hugging Faceのローンチ記事、TopK、Qdrantの技術解説、Data AI Hubの本番運用ガイド、そしてSuhas Bhairavのプロダクション検索比較に共通して現れるのは、次のような用途だ。
- 意味検索の中に厳密な識別子がある場合。製品コード、関数名、姓、エラー文字列、条項番号など。プーリング済みベクトルでは曖昧になりやすい情報も、トークン単位なら個別に照合できる。
- 複数条件を含むクエリ。「YとZを備えたX」のような検索だ。各クエリトークンが、それぞれを裏付ける文書トークンを独立して見つけられるため、条件が平均化されて消えにくい。
- 答えが文書の一部にしかない長文。多言語長文書ベンチマークMLDRでは、マルチベクトルの
mLateOnが77.92、mDenseOnが51.59だった。短文パッセージの平均差より一桁大きい開きである。 - PDF、表、スキャンされたページ。ColPali系モデルは、ページ画像をテキストクエリで直接インデックス化でき、OCRを省略できる。Hugging Faceのローンチ記事は視覚文書検索をlate interactionの最先端領域と位置付けている。TopKの分析では、コンパクトなマルチベクトル検索器が、80倍のサイズを持つ単一ベクトルモデルをViDoRe v3でリコール+34%上回った。産業文書のリコールは約42%から76%へ伸びたという。
- 学習分布外の語彙。Hugging Faceのローンチ記事では、denseモデルの学習済み圧縮が本番クエリに必要な細部を捨ててしまう可能性がある領域外データでの改善が報告されている。
視覚検索と相性がよい理由は、Hugging Faceの数値からも見える。レンダリング済みページではcolqwen2.5-v0.2が約755本のトークンベクトルを出力するのに対し、平均的なテキストパッセージは約125本だ。グラフ、レイアウト、表が入り混じるページほど、1本のプーリング済みベクトルでは捨てる情報が増える。
精度向上は本物。ただし過大評価は禁物
最も素直な比較材料はLightOnの対応モデルだ。LateOnとDenseOnは、149MパラメータのModernBERTバックボーンと学習データが同一で、異なるのはヘッドだけである。前者は128次元のトークンベクトル、後者は768次元の文書ベクトルを使う。
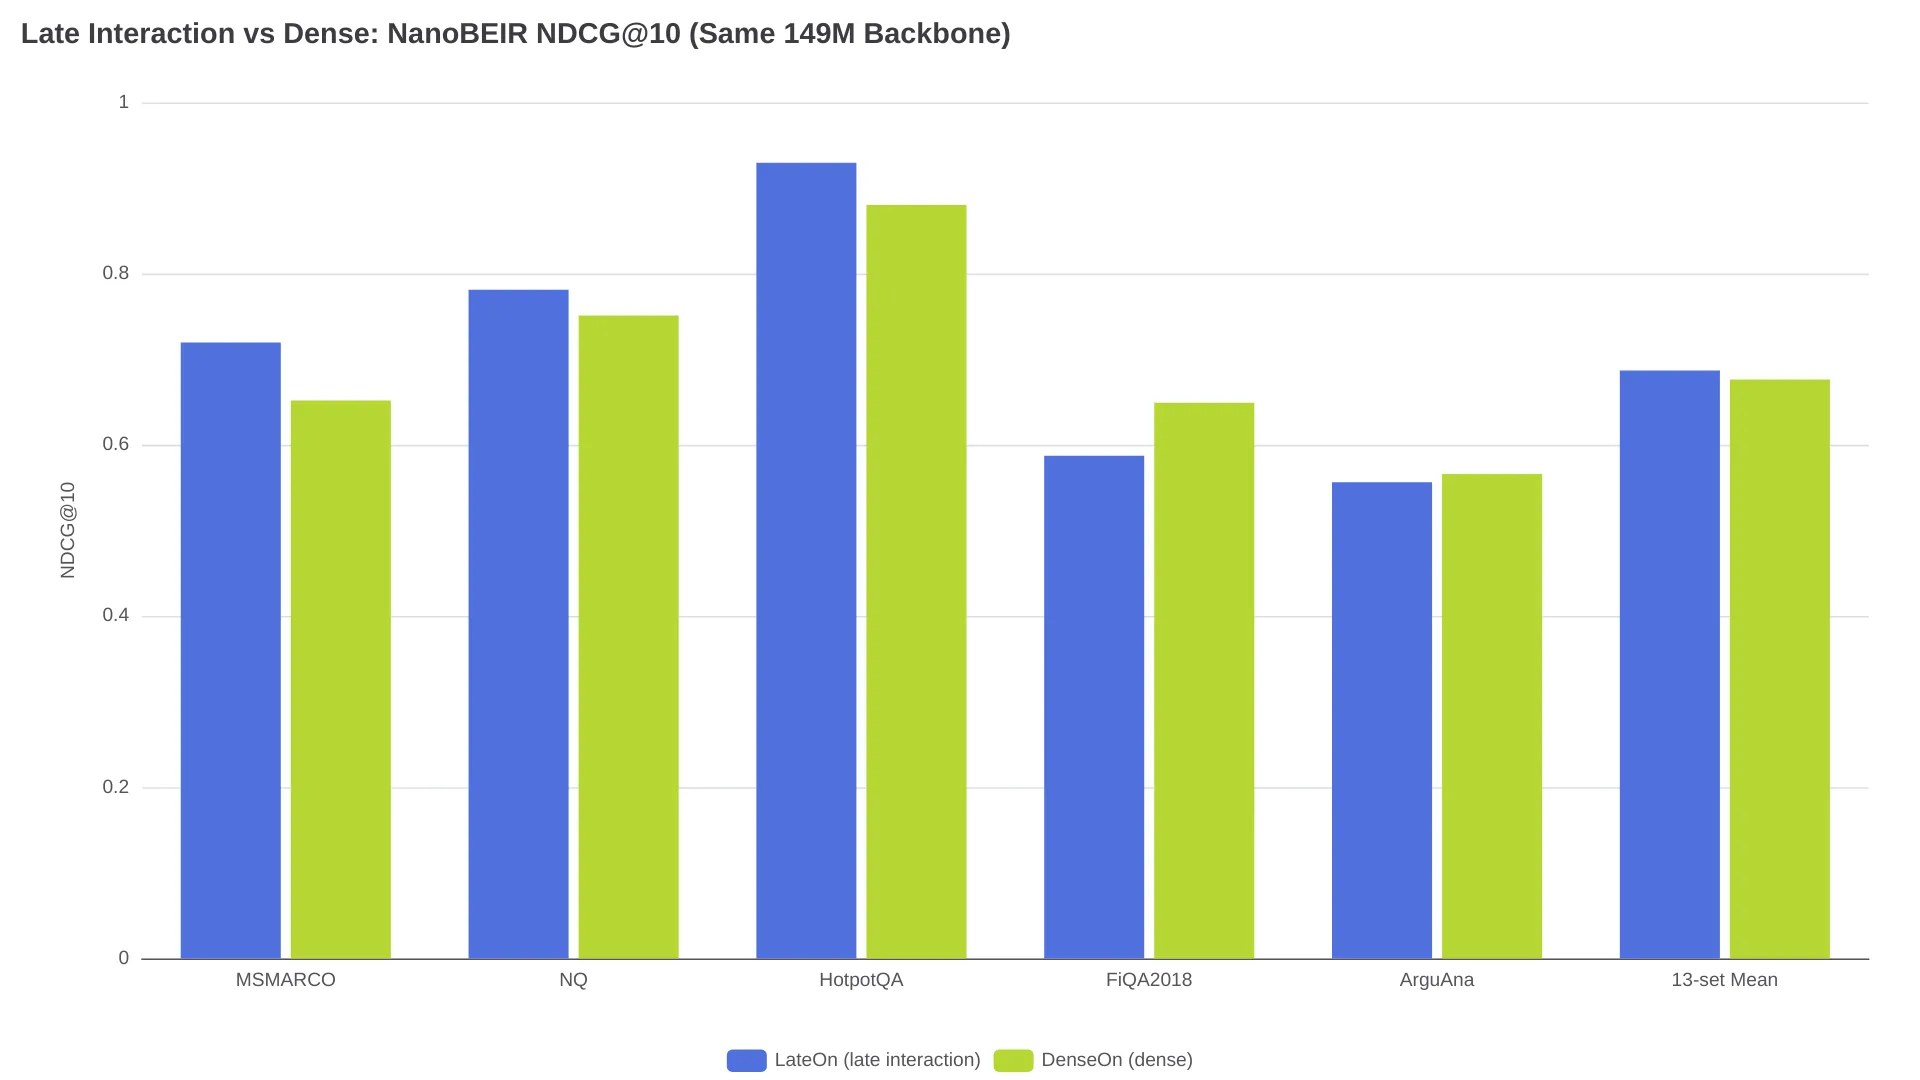
LateOnはNanoBEIRの13データセット中9つで勝ち、平均NDCG@10は0.6868対0.6764だった。15データセットのBEIR全体では57.22対56.20である。とはいえ、ArguAna、FiQA2018、SCIDOCS、SciFactではDenseOnが明確に上回った。モデルサイズを揃えた上で意味のある平均改善はあるが、別カテゴリの性能差と呼べるほどではない、というのが実態だ。
メンテナーのTom Aarsenがv6.0を発表した後、開発者の@saen_devは実務者が繰り返していた問いを投げかけた。「ドメイン固有コーパスではbi-encoderと比べてどうベンチマークされるのか?」(スレッド)。率直な答えは、平均で約1ポイント、長文で大きく伸びる場合がある、となる。Hugging Face自身も、改善幅はデータセットごとに異なるため、自分の検索タスクで評価するよう勧めている。
圧縮前のストレージは42倍
Hugging Faceの作例では、4,874件のNatural Questionsパッセージでインデックスサイズを測っている。lightonai/LateOnが生成したのは608,414本のトークンベクトルで、1パッセージあたり平均124.8本となる。
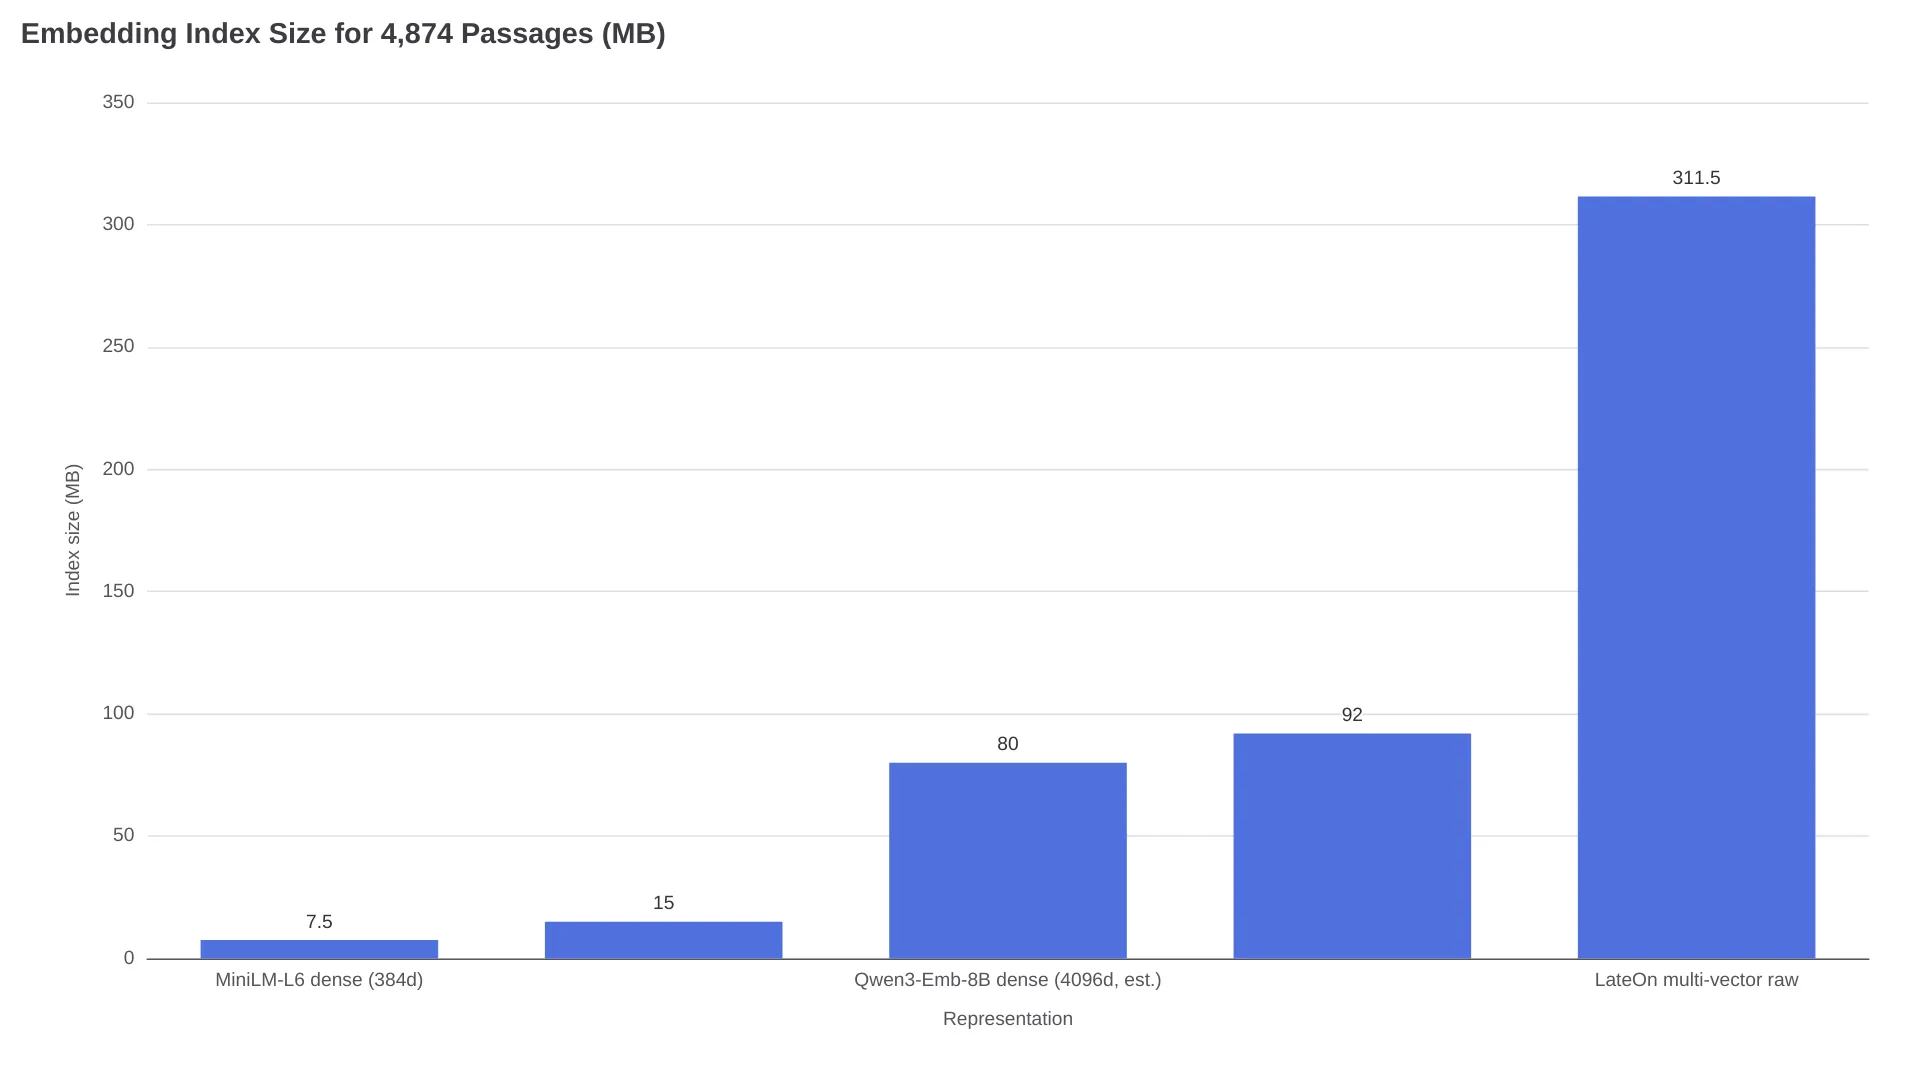
float32の生マルチベクトルインデックスは311.5 MB。同じパッセージをall-MiniLM-L6-v2のdenseで保存すると7.5 MBで、42倍の差がある。パッセージあたりでは62 KiBだ。同クラスの768次元denseモデルであるgte-modernbert-baseと比べても、15 MBに対して21倍となる。TopKは文書長と精度に応じて10~100倍のレンジを挙げ、クエリあたりのスコアリング計算量は単一ベクトル比較の数千倍に達すると見積もっている。
リリース当日、ある開発者は本番運用での懸念をこう端的に表現した。
トークンプーリングこそ、これを出荷できるかどうかを決める部分だ。late interactionは精度ではなく、たいていインデックスサイズとメモリで止まる。 - Xの@JudeJobs
規模感の比較として、同じコーパスに対する4,096次元のQwen3-Embedding-8Bのdenseインデックスは約80 MBで、後述する圧縮済みlate interactionインデックスの92 MBに近い。
インデックスを小さくする3つの手段
1. トークンプーリング。Sentence Transformers v6.0にはHierarchicalTokenPoolingが含まれる。これはコサイン距離に対するWard linkageで文書トークンベクトルをクラスタリングし、各クラスタを平均ベクトルに置き換える仕組みだ。クエリは短く歪みに敏感なため、デフォルトでは文書側だけをプーリングする。608,414ベクトルのコーパスでは、次の結果になった。
| プール係数 | トークンベクトル数 | float32インデックス | 報告された検索品質の維持率 |
|---|---|---|---|
| 1(なし) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | 約98%の傾向 |
コーパス全体のプーリング処理は約6秒だった。LightOnの正則化バリアントは、Hugging Faceの記事で5倍圧縮時に99.4%の品質を報告している。ただしHugging Faceによれば、v6.0リリース時点では、その正則化を使う学習はまだライブラリに統合されていない。
2. 圧縮インデックス。同一ベクトルをfast-plaid(Rust PLAID)でインデックス化すると、サイズは92 MBになる。構築は5秒、RTX 3090 + i7-13700Kでは11 msで応答した。近似検索のため、Hugging Faceのテストでは上位スコアが11.92から11.88へわずかに変動したが、順位は維持された。WeaviateのMUVERAでは、取り込みが3倍、クエリが1.8倍高速化された一方、テストコーパスでは正解の1件がtop 50から落ちた。
3. 量子化と推論チューニング。Qdrantがトークン埋め込みにuint8スカラー量子化を適用した実験では、メモリを4分の1にしながら、SciFactのNDCG@10は0.70724から0.70297への変化にとどまった。Hugging Faceは、fp16とFlash Attentionの組み合わせで、測定上の品質低下なしにfp32比2.44倍のエンコードスループットを報告している。CPU上のint8では精度コストが約0.4%となる。
係数2~3のプーリングに圧縮インデックスを重ねれば、denseに対する実効的な差は42倍から一桁台まで縮められる。ただし、そのぶん調整すべきパラメータが2つ増える。
基本構成は「第1段検索+reranker」
全4,874文書を総当たりMaxSimで採点すると、RTX 3090 1枚で98 ms、エンドツーエンドでは122.7 msだった。数千文書なら十分実用的だが、数百万文書に対しては線形コストが致命的になる。ここで比較した3つのデプロイメントガイドは、いずれも同じ構成に収束している。まず安価なdenseまたはsparseで候補を取り、late interactionで再ランキングする形だ。
- Hugging Faceの例。denseでtop 50を取得してからMaxSimで再ランキングする。文書は一度だけバッチでエンコードし、行列積で採点できるため、ペアごとにforward passするcross-encoderより大幅に安い。
- Qdrant。v1.10からネイティブのマルチベクトル対応を提供しており、全件走査ではなく数百候補の再ランキングを主用途として勧めている。
- Data AI Hubの本番運用ガイド。ハイブリッド検索でtop 150を取り、late interactionで20件まで再ランキングし、必要なら最終的にLLMへ渡す5件にcross-encoderをかける構成を推奨している。
ただし、rerank専用パターンには明確な上限がある。第1段で取りこぼした文書を回収することはできない。また、その周辺パイプラインにも万能解はない。
普遍的に優れたチャンク分割、検索、再ランキング戦略はほとんど存在しない。 - u/gamerx88、r/MachineLearning
対応するベクトルDBと実力
Hugging Faceのローンチ記事では、主要エンジンを同じ4,874パッセージのコーパスで比較している。以下はベンダーの宣伝値ではなく、同記事のテスト結果だ。
| エンジン | ネイティブマルチベクトル対応開始 | 取り込み / クエリ(同テスト) | 注意点 |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | 正確なMAX_SIM。サーバー利用を推奨 |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERAは高速だが正解1件を落とした。Windowsではembedded modeなし |
| Vespa | 「for years」 | 約80 s / ウォーム時75 ms | MaxSimはtensor expressionで実装。デフォルトの第2段は100候補だけを再ランキングし、正解top 3のうち2件を取り逃した |
fast-plaid | - | 5 s / 11 ms | サーバーなし。近似スコアだが順位は維持 |
| LanceDB | v0.15.0 | ベンチマークなし | ネイティブMaxSim |
| Milvus | v2.6.4 | ベンチマークなし | array-of-structsストレージ |
| VectorChord | - | ベンチマークなし | PostgreSQL向けMaxSim演算子 |
| Elasticsearch / OpenSearch | - | - | rescore専用。ES機能はEnterprise tierのtechnical preview |
Hugging Faceの比較表では、turbopufferのlate interactionインデックスはprivate betaとして掲載されていた。
Sentence Transformers v6.0で変わったこと
2026年8月18日以前、ColBERT系モデルを動かすにはPyLate、Stanford ColBERTリポジトリ、colpali-engineといった別フレームワークが必要だった。v6.0ではMultiVectorEncoderがライブラリで4つ目の主要モデル種別となり、学習、推論、解釈性機能を組み込んでいる。Sentence Transformers、PyLate、Stanford ColBERT、ColPaliのチェックポイントを読み込める。素のtransformerもロード可能だが、その場合は学習が必要なランダム射影となる。要件はtransformers v5.x、torch 2.2+、huggingface-hub v1.xだ。
ローンチドキュメントで注意したい落とし穴は3つある。
- クエリと文書は非対称。
encode_query()とencode_document()では、プロンプト、長さ上限、スコアリングマスクが異なる。両方に汎用のencode()を使うと、気付かないまま結果を劣化させる最短ルートになる。 - 切り詰めは黙って起きる。662トークンのパッセージをLateOnの文書上限300トークンに通すと、生成されたのは273ベクトルで、残りは破棄された。上限を512に上げることは可能だが、学習時の分布から外れ、インデックスも大きくなる。
- Flash Attentionには例外がある。
colbert-ir/colbertv2.0やanswerai-colbert-small-v1を含む、non-attend query expansionを使うモデルでは、代わりに"sdpa"が必要になる。
Hugging Faceの公開スコアによれば、対応モデルは2桁の規模差にまたがる。
| 層 | モデル例(パラメータ数) | スコア(平均NDCG@10) |
|---|---|---|
| エッジ向けテキスト | mxbai-edge-colbert-v0-17m(17M) | 0.6407 NanoBEIR |
| 小型テキスト | answerai-colbert-small-v1(33M) | 0.6550 NanoBEIR |
| テキスト上位 | LateOnファミリー(149M) | 0.6868~0.6897 NanoBEIR |
| 視覚文書 | colqwen2.5-v0.2(3.8B) / webAI-ColVec1.1-8b(8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Denseの単一ベクトルを選ぶべきケース
避けるべきなのは、必要のないワークロードにマルチベクトルを持ち込むことだ。「サプライチェーンに関する記事」のような広くトピック指向のクエリ、タイトル・FAQペア・ツイートのような短いテキスト、あるいはクラスタリング、重複排除、推薦といったアイテム全体の類似度が必要なタスクでは、採用する理由が薄い。dense+rerankerのパイプラインがすでにリコールSLOを満たし、制約がコストにある場合も同様だ。Data AI Hubのガイドはさらに、英語中心のColBERTチェックポイントは、多言語コーパスでは多言語bi-encoder+reranker構成を下回る可能性があると指摘する。更新頻度が高くリアルタイム性が求められるコーパスも、トークン単位インデックスには向かない。
数字で答えるよくある質問
通常のdenseモデルをマルチベクトルとして使える?
場合によっては、驚くほど機能する。Qdrantの実験では、33MのdenseモデルBAAI/bge-small-enの出力トークン埋め込みを取り出し、MaxSimで採点した。その結果、SciFactで0.73696のNDCG@10となり、colbert-ir/colbertv2.0の0.69579と、bge-small自身のプーリング済みベクトルの0.68213を上回った。ArguAnaでは順位が逆転し、プーリング済みdenseが勝っている。新モデルを導入せずreranking段を追加するための有効な手法ではあるが、性能を保証するものではない。
圧縮済みマルチベクトルインデックスはどれだけ速い?
4,874パッセージのコーパスでは、総当たりMaxSimが98 ms、fast-plaidが11 msだった。サイズは311.5 MBから92 MBになる。
マルチベクトルモデルはcross-encoder rerankerを置き換える?
コスト面では置き換えられる。文書表現は事前計算済みで、クエリ・文書ペアごとのforward passではなく行列積で採点するためだ。ただし、Hugging Faceのローンチ記事はペア単位の最も高精度な選択肢として依然cross-encoderを挙げている。そのため厳しい要件のパイプラインでは、最終top 5~20にcross-encoderを残している。
RAGでlate interactionを使う価値はある?
ハイブリッドまたはdenseで取得した候補に対するreranking段としてならある。上で取り上げた3つのデプロイメントガイドも、すべてこの構成を推奨している。第1段の検索器として使うのは、測定した第1段リコールが実際の失敗要因であり、かつトークンベクトルインデックスが予算に収まる場合に限るべきだ。
用途別の判断表
| ワークロード | 推奨 |
|---|---|
| 識別子が多いクエリ、複数条件クエリ、長文書、法務・技術文書 | マルチベクトル検索またはreranking。+26ポイントのMLDR領域に当たる |
| PDF、スキャンページ、表、グラフをページ画像として扱う | ColPali系マルチベクトル。OCRパイプラインは不要 |
| 広いトピック検索、短文、クラスタリング・重複排除・推薦 | Dense単一ベクトル。ここではプーリング損失は問題にならない |
| 品質はあと少し、予算は厳しい | denseの第1段を維持し、top 50~150にMaxSim rerankingを追加 |
| 数百万文書でコストが制約 | Dense+cross-encoder reranker、または測定後に圧縮late interaction(プール係数2~3+fast-plaid) |
@JudeJobsが指摘した未解決のトレードオフも残る。圧縮後の品質維持率はベンチマークで測られたものであり、雑多な本番コーパスでの保証ではない。まず係数2でプールし、自分のデータで測ったリコールを基準に、どこまで圧縮曲線を下げられるか決めるのがよい。