 AIREITER
r/codexで繰り返し見かけるのが、「GPT-5.5のextra-highを使っていたなら、SolとTerraのどちらが相当するのか?」という問いです。先に結論を言えば、GPT-5.6 SolのAPI定価はGPT-5.5と完全に同じです。しかもエージェント系ベンチマークでは上回るため、長時間動くエージェントやブラウジング用途では、アップグレードはほぼ追加料金なしで行えます。
ただし、「同じ価格」という表現には見落としやすいコストが2つあります。SolではGPT-5.5になかったキャッシュ書き込み料金がかかり、さらに推論時間も長くなります。料金表が変わらなくても、タスク単位の支出は大きく膨らむ可能性があります。
定価は同じ、実際の請求額は別物
GPT-5.6 SolとGPT-5.5の通常API料金は同一です。入力100万トークンあたり$5.00、出力100万トークンあたり$30.00、キャッシュ済み入力は$0.50。2026年7月29日にOpenAIの料金ページで両モデルの掲載内容を確認しました。
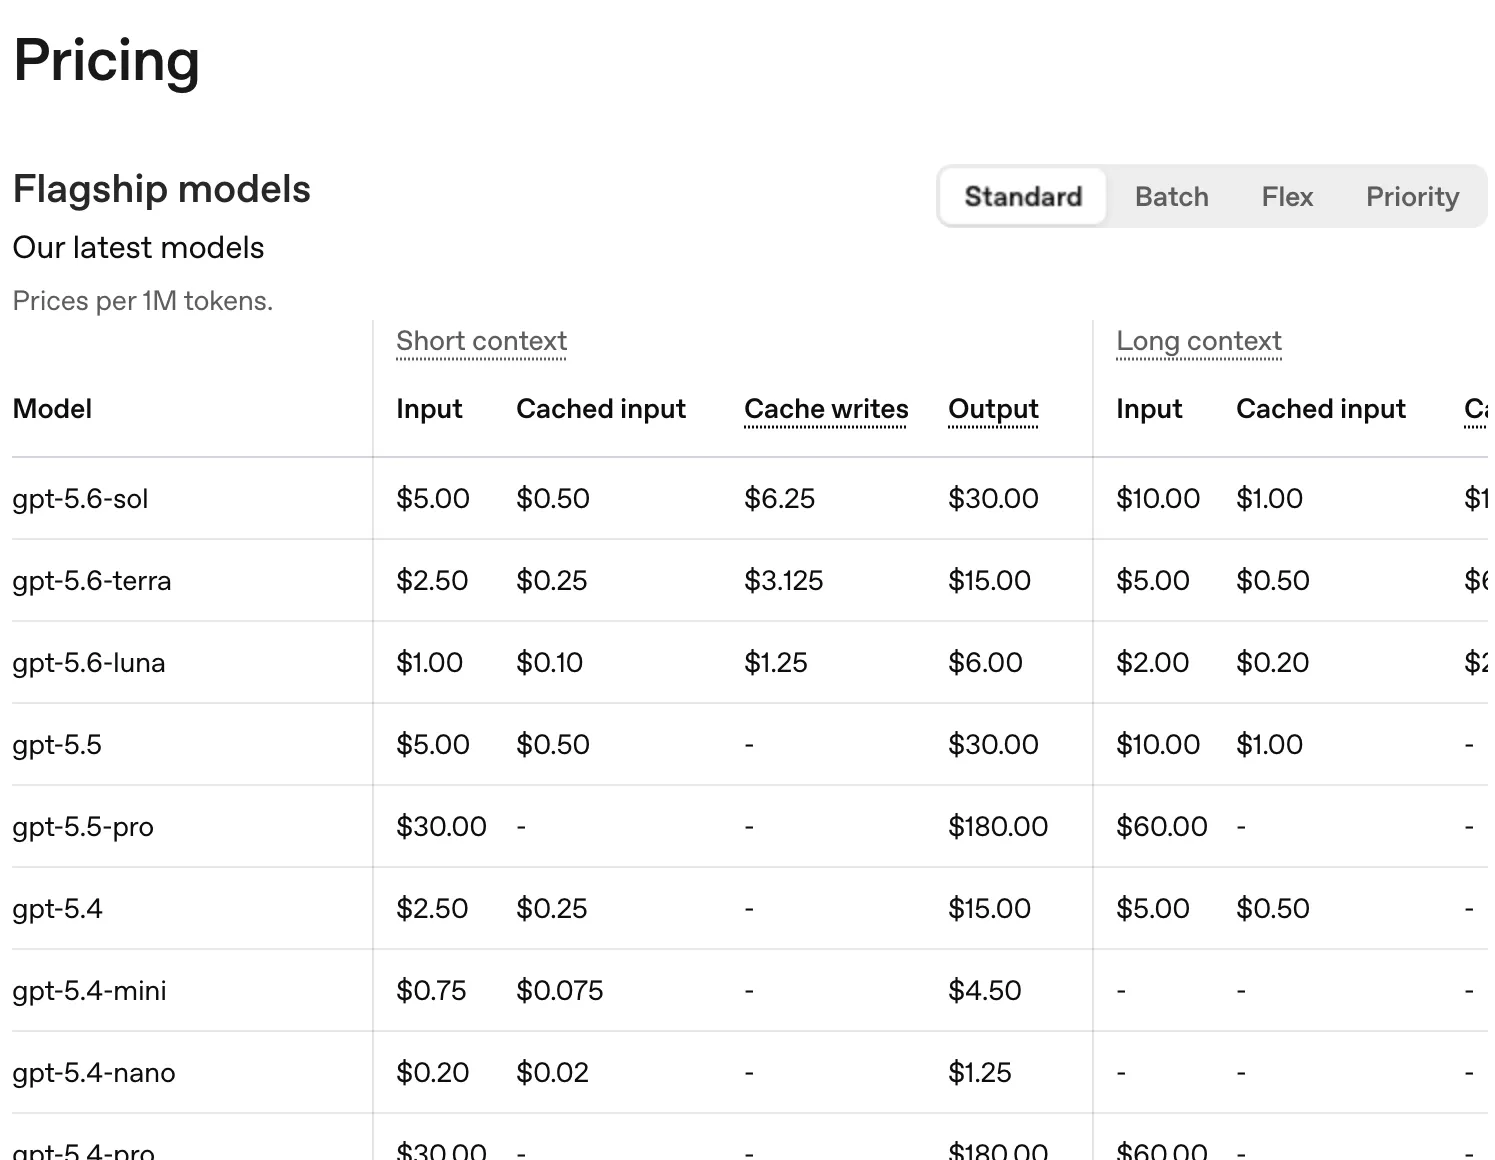
ただし、料金表には両モデルを分ける項目が3つあります。
| 項目 | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| 入力 / 出力(100万トークンあたり) | $5.00 / $30.00 | $5.00 / $30.00 |
| キャッシュ済み入力 | $0.50 | $0.50 |
| キャッシュ書き込み | $6.25 | 無料 |
| 長大コンテキスト(>272K)の入力 / 出力 | $10.00 / $45.00 | $10.00 / $45.00 |
移行時に効いてくるのは、キャッシュ書き込みの行です。GPT-5.6では、最低保持時間30分の明示的なキャッシュブレークポイントが導入されています(仕組みはVellumの解説が詳しい)。書き込みはキャッシュなし入力料金の1.25倍、読み出しは90%割引のままです。上の料金表に当てはめると、キャッシュ区間は書き込みに$6.25、読み出しごとに$0.50。一方、キャッシュせず再送する場合は$5.00です。つまりキャッシュは2回目の再利用から元が取れますが、読み出しより書き込みが多いパイプラインでは、GPT-5.5にはなかった料金が発生します。
もう1つは時間に伴って増えるコストです。Solは回答前により長く推論し、その推論トークンは出力として課金されます。Codexへ移行したユーザーは、この影響を率直に報告しています。
「5.6 sol médiumは5.5-xhighの3倍高いのに、コード品質は同じだった(少なくとも5.5リリース時点では)。」 — r/codex、「GPT 5.5 and 5.6 conversion table」
料金単価は同じでも、到達までに使うトークンが3倍なら、タスクごとのコストも3倍になります。一方で、OpenAIのGPT-5.6発表では、社内比較においてGPT-5.5より入力トークンが22%、出力トークンが23%少なかったとしています。両者は矛盾しません。思考1単位あたりの効率は上がっていても、高いeffort設定ではモデル自体が大幅に長く考えるためです。実際のコストは、選ぶeffortレベルに左右されます。
ベンチマークで見える進化ポイント
純粋な知能スコアだけを見ると、独立評価ではGPT-5.6 SolとGPT-5.5はほぼ横並びです。Artificial AnalysisのIntelligence Index v4.1では、Sol(medium)が54、GPT-5.5(high)が53。混合コストはいずれも100万トークンあたり$4.35です。差が大きいのは別のところにあります。
- 初回トークンまでの遅延:Solは4.13秒、GPT-5.5(high)は16.67秒で、約4倍の差があります。対話型ツールや、連続した呼び出しを何十回も行うエージェントループでは、日常的に最も体感しやすい改善です。
- エージェント系ベンチマーク:SolはTerminal-Bench 2.1で88.8%、BrowseCompで92.2%を記録。このリリースで最大の伸びが見られるのは、長期的なツール利用です。
- コンテキスト:Solは100万トークンで、GPT-5.5の922Kを上回ります。さらに会話ターンをまたいで推論を維持できます(前出のVellum分析にも記載されています)。
- 出力速度:唯一の後退点です。Solは毎秒65トークン、GPT-5.5は77.3トークン。大量生成ジョブは速くなるどころか、遅くなります。
CodeRabbitの長期コーディングスイートでは、5言語・100件超のタスクでSolの合格率は63.7%でした。コードレビューのベンチマークでは、ベースライン統合と比べて7.4ポイント改善しています。ただしレビュー精度は31.6%で、実際の問題をより多く見つける一方、ノイズも増えます。同じテスターは、単純な変更で誤った方針に入り込み、Solが8ラウンドを消費したケースも記録しています。マラソン向きだからといって、袋小路に陥らないわけではありません。
同じ3つのプロンプトで比較した結果
ベンチマークは長期タスクに有利ですが、API呼び出しの大半は短時間で完結します。そこで2026年7月29日、gpt-5.6-solとgpt-5.5に同一の3プロンプトを送信しました。Pythonの日付処理バグ修正、正解がちょうど2つある制約論理パズル、そして年が欠けた日付をルールどおり推測せずnullにしなければならない罠を含む、厳密なJSON抽出です。各タスクにつきAPI呼び出しは1回、推論effortはデフォルト、ツールなし、再試行なし。サンプル数は少なく、ベンチマークではありません。
結果は両モデルとも3問中3問正解でした。GPT-5.5はcalendar.monthrangeで12月にクラッシュするバグを修正し、Solは正しいうるう年判定表を自前で実装しました。どちらも有効なデプロイ順序を正確に2通り見つけ、抽出ではバイト単位で同一のJSONを返し、「the 14th of July」に年を勝手に補うこともありませんでした。
ただし、トークン消費と速度には差が出ました。
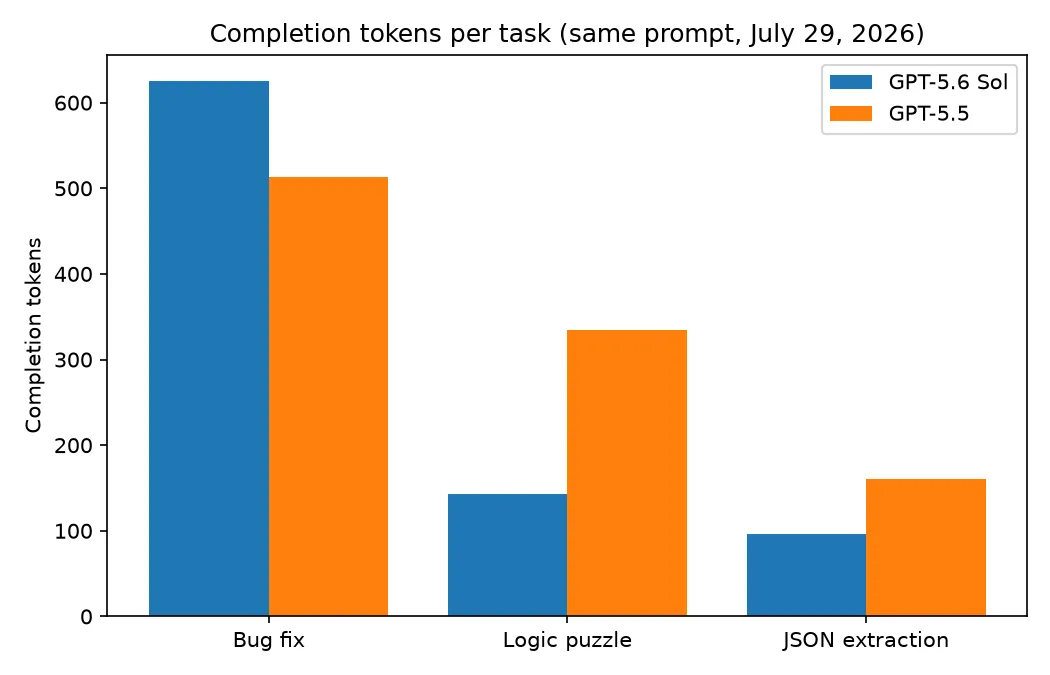
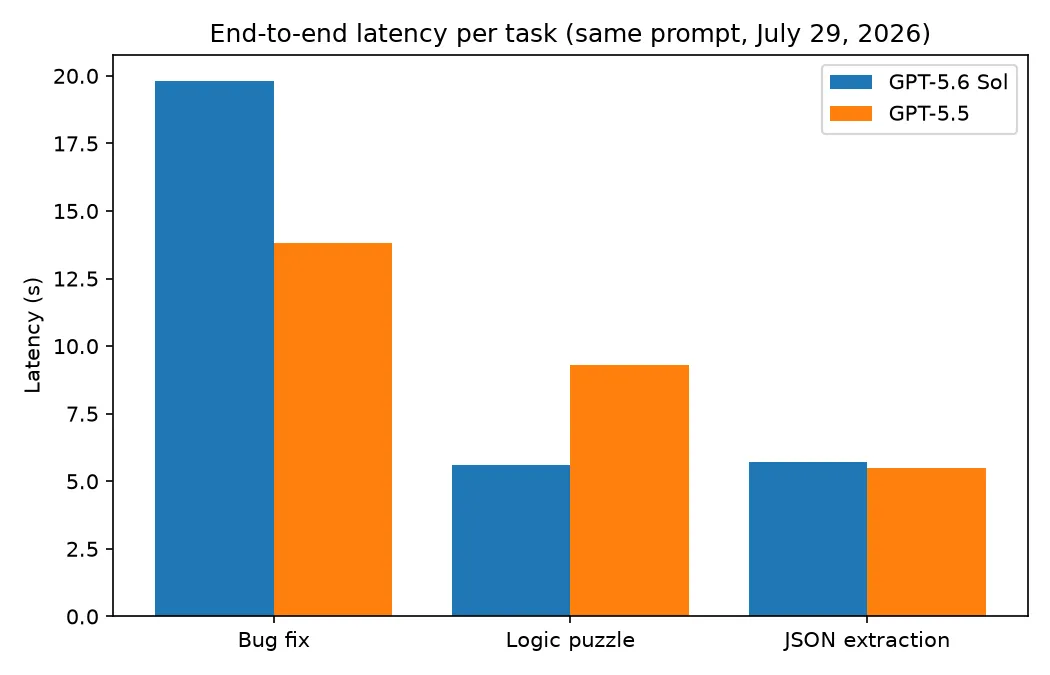
Solの完了トークン総数は864で、GPT-5.5の1,007より少なくなりました。ただしコード修正ではSolのほうが遅く、出力も多めでした。Solは19.8秒・625トークン、GPT-5.5は13.8秒・513トークンです。論理パズルでは逆転し、Solは143トークンで5.6秒、GPT-5.5は334トークンで9.3秒かかりました。両者を見比べた印象として、短く仕様が明確なタスクでは両モデルは交換可能です。このテストだけで移行を正当化できる材料はありません。アップグレードの根拠になるのは、前節で触れたエージェントおよび長大コンテキスト作業です。
GPT-5.5のeffort設定を5.6へ対応付ける
前出のVellum解説によると、モデルIDとしてgpt-5.6だけを指定すると、デフォルトではgpt-5.6-solにルーティングされます。単にエイリアスを差し替えてアップグレードすると、意図せず最上位ティアとその請求額を選ぶことになります。計画的に移行するなら、次の3点を基準にするとよいでしょう。
- GPT-5.5 xhigh → Sol medium:これがコミュニティでの暫定的な対応関係です。前述したr/codexの報告では、5.5と同等の品質で、リリース直後はタスク単価がおよそ3倍と測定されました。ただし、これは保証ではありません。まず自分のプロンプトで検証すべき仮説です。GPT-5.5 highをコスト重視で使っていたワークロードなら、料金が$2.50/$15でSolの半額となるGPT-5.6 Terraのほうが近い選択肢です。
- 最上位では思考時間が膨らむ:ChatGPT Proユーザーの報告では、5.5 Proが5〜10分で処理したタスクに対し、GPT-5.6は20〜50分を費やしています。これはChatGPT上での観察ですが、同じ推論スタックはAPIでは出力トークンとして課金されます。
reasoning.mode: "pro"は5.6の3ティアすべてで利用できるため、この上限は明示的に選択した場合にのみ有効です。 - 古いプロンプトが新モデルの足を引っ張る:Every.toのテストチームは、旧モデル向けに書いた防御的な指示を削除して初めて、Solの出力が大幅に改善したと報告しています。たとえば「常にXを二重確認せよ」のようなルールは、Solに過剰な検証や実装をさせます。モデルを移行したらシステムプロンプトも監査し直しましょう。GPT-5.5で必要だった過剰防御は、今ではコスト要因になり得ます。
Solへ移るべきケース、GPT-5.5に残るべきケース
マルチステップのツール利用、ブラウジング調査、リポジトリ規模のコーディングセッションといったエージェント型ワークロードなら、GPT-5.6 Solへ移行する価値があります。Terminal-Bench 88.8%、BrowseComp 92.2%というスコアが意味を持つのはこの領域です。また、初回トークンまでの遅延が4分の1になる効果は、ループの反復ごとに積み重なります。料金表は同じ$5/$30なので、追加の推論トークンやキャッシュ書き込みで差額を食い尽くさない限り、能力向上に追加料金はかかりません。100万トークンのコンテキストとターン間での推論維持により、5.5のパイプラインで必要だった2つの回避策も不要になります。
一方、抽出、分類、単発のコード修正、大量生成のような、短く要件が明確な呼び出しが中心なら、ひとまずGPT-5.5に留まるのが妥当です。同一プロンプトの3件テストでは、まさにこの形のタスクで両者は同等でした。さらにSolのストリーミングは毎秒65トークンで、GPT-5.5の77.3トークンより遅いため、大量ジョブでは明確に不利です。プロンプトキャッシュの書き込みが多いパイプラインは、移行前に$6.25の項目を計算してください。似た品質で請求額を下げたいなら、選ぶべきはSolではなくTerraです。
今回の直接比較にはAIReiterを使いました。gpt-5.6-solとgpt-5.5を1つのAPIキーで利用できるため、モデル文字列を入れ替えるだけでA/Bテストを行えます。自分の実トラフィックで、成功率、エンドツーエンド遅延、タスクごとの完了トークン数を比較してください。
FAQ
GPT-5.6 SolはGPT-5.5より優れていますか?
エージェントタスクでは明確に優れています。Terminal-Bench 2.1で88.8%、BrowseCompで92.2%、初回トークンまでの遅延は4分の1です。短い単発タスクでは、独立スコアの差は1ポイントにすぎません(Artificial Analysisで54対53)。同一プロンプトによる私のテストでも、正確性の差は見られませんでした。
GPT-5.6 SolはGPT-5.5より高いですか?
定価は同一です。100万トークンあたり入力$5、出力$30です。ただしSolには、GPT-5.5にはなかった$6.25のキャッシュ書き込み料金があります。また、高いeffort設定ではタスクごとにより多くの推論トークンを使います。r/codexユーザーは、5.5 xhighと同等の品質でタスク単価がおよそ3倍と測定しています。
GPT-5.5 xhighに相当するGPT-5.6の設定は?
Solのmedium effortが、コード品質では近い結果を出しますが、タスク単価は約3倍です。能力の上限よりコスト同等性を重視するなら、経済面ではTerraのほうが近い選択です。
アップグレード後もGPT-5.5を使えますか?
はい。GPT-5.5は現在もOpenAIの料金ページに変更前と同じ料金で掲載されています(2026年7月29日に確認。上のスクリーンショットを参照)。現時点で移行を強制するものはありません。
判断を1表にまとめると
| ワークロード | 選択肢 | 判断材料 |
|---|---|---|
| マルチステップエージェント、ブラウジング、リポジトリ規模のコーディング | GPT-5.6 Sol | Terminal-Bench 88.8%、初回トークン遅延は4分の1、料金表は同じ |
| 短い抽出 / 分類 / 単発修正 | GPT-5.5(当面) | 同一プロンプトテストで同等。5.5のストリーミングは19%高速 |
| プロンプトキャッシュの書き込みが多い | GPT-5.5、または先に設計を見直す | Solでは$6.25/100万トークンのキャッシュ書き込み料金が新設 |
| 同等品質で請求額を下げたい | GPT-5.6 Terra | $2.50/$15でSolの半額。上記のTerra対5.5比較を参照 |
| 最大限の思考深度 | reasoning.mode: "pro"を指定したSol | 5.5が5〜10分だった場面で20〜50分の熟考 |