 AIREITER
Codexを使っていると、GPT-5.6 Solの利用枠やAPI料金が想定より早く減っていくと感じるかもしれません。1,715セッションでの平均使用量は1セッション当たり1,645万トークンで、比較可能な1,667セッションにおけるGPT-5.5の平均730万トークンの2.25倍です。単価は同じでも、消費トークンは2倍超。さらにResponses APIでは、Solの請求対象となるoutput_tokensが6倍以上に膨らむ可能性がある不具合も報告されています。GPT-5.6の請求額に違和感があるなら、その感覚は正しい可能性があります。
GPT-5.6 Solは実際にどれだけトークンを使うのか
開発者のVincent Schmalbach氏は、Codex利用の14日間を2期間に分け、ほぼ同数のセッションでGPT-5.5 xhighとGPT-5.6 Sol xhighのトークン消費量を追跡しました。
| 指標 | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| セッション数 | 1,667 | 1,715 |
| 総トークン数 | 12.17B | 28.22B |
| 1セッション当たりのトークン数 | 7.30M | 16.45M |
セッション数の増加は2.9%にとどまる一方、1セッション当たりのトークン数は125%増加しました。おおむね同程度の作業量で、総消費量は121.7億から282.2億トークンへと増え、2.32倍になっています。
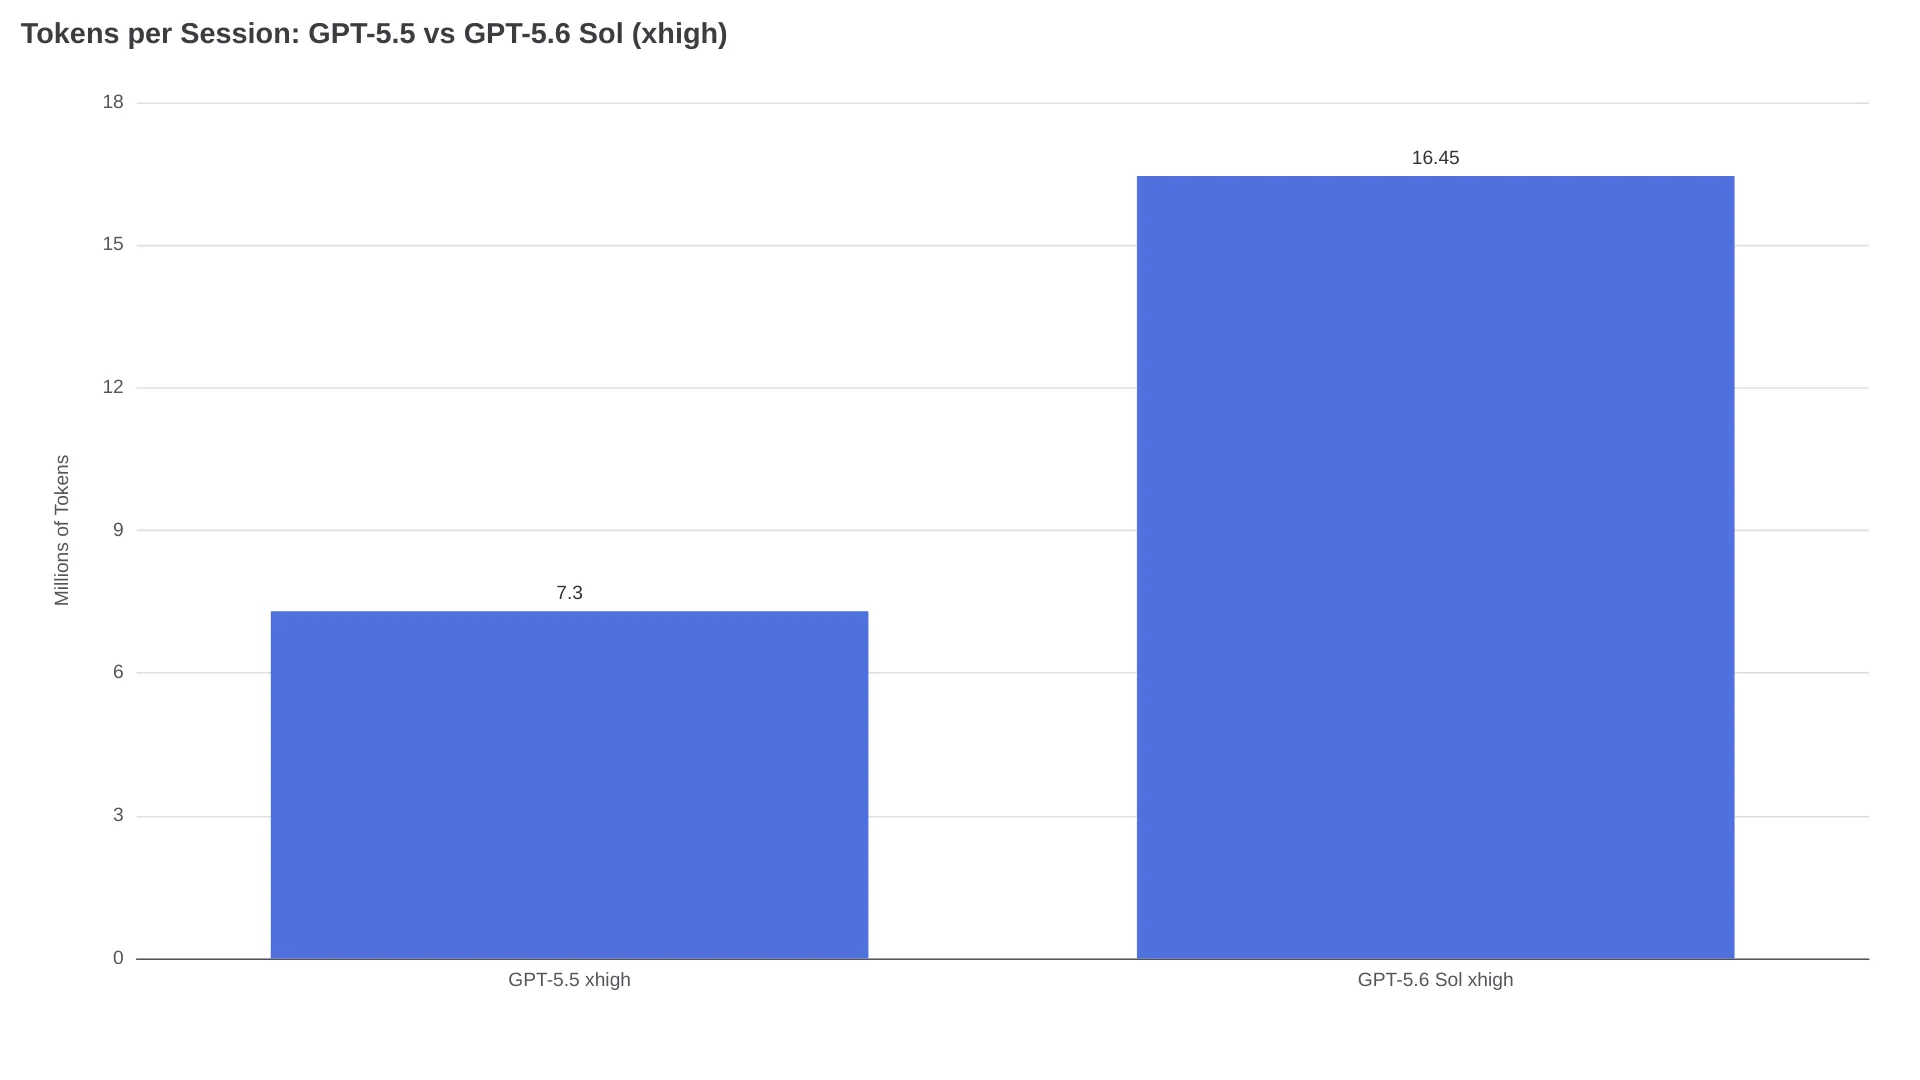
OpenAIの料金ページでは、GPT-5.6 Solは入力100万トークン当たり$5、出力100万トークン当たり$30で、GPT-5.5と同額です。同じ単価でトークン数が2.25倍なら、タスク当たりのコストもおよそ2.25倍になります。またGPT-5.6 Solには、GPT-5.5にはなかったキャッシュ書き込み料金も導入されており、入力単価の1.25倍がかかります。
「GPT 5.6 Solはトークンを燃やす炉のようだ。mediumでもhighでも、Solはトークンをどんどん食う。5.6を使うのは複雑な計画立案か厄介なバグだけになりそうだ。」— r/codexユーザー
Schmalbach氏が利用している3つのサブスクリプションは、以前なら高負荷の作業を1週間続けられたのに、現在はmediumで使っても約1日で尽きるようになったといいます。
Solのトークン消費が多い理由
ベンチマークのスコア当たりで見れば、Solは競合より効率的です。Artificial Analysis Coding Agent Indexでは、同等のスコアを出すClaude Fable 5より少ない出力トークンで動作します。ただし実際のセッションでは、Solはより積極的に推論します。計画を立て、戻って検討し、検証し、代替案も探ります。そのため、1トークンが生む有用な仕事量は多くても、タスクごとのトークン消費は大きくなります。
出力トークン数を水増しする可能性がある請求不具合
実際の消費量が多いことに加え、Responses APIには、output_tokensフィールドを膨らませ、しかも請求額がその値を基に算出されるように見える会計上の不具合が報告されています。OpenAIは調査中ですが、原因はまだ公表していません。
ある開発者は、710回のGPT-5.6呼び出しと計22,922回のreasoning呼び出しを対象にこの問題を記録しました。GPT-5.6は、1レスポンス内に複数のreasoningアイテムを出力する初のモデルファミリーです。中央値のkはSolが9、Terraが4です。API内のアキュムレータが、生成中にreasoningアイテムごとに累積推論トークンを加算しており、本来の最終カウントに上乗せされているとされています。
式で表すと次のとおりです。
output_tokens ≈ R × (k + 3) / 2Rは実際の推論トークン数、kはreasoningアイテム数です。中央値がk=9のSolでは、請求対象のカウントはおよそ6倍に膨らみます。k=4のTerraでは、およそ3.6倍です。
実際の請求で起きること
記録された最も極端な例では、4文字の回答(d1d4)を返した1回のGPT-5.6 Terra呼び出しに対し、実際の推論トークンは21,064だったにもかかわらず、466,818出力トークンが請求されました。
| APIが報告した項目 | 値 |
|---|---|
output_tokens(請求対象) | 466,818 |
reasoning_tokens(実数) | 21,064 |
| 表示された出力 | d1d4(4文字) |
| Reasoningアイテム数(k) | 41 |
k=41なら、式の予測値はR × (41+3)/2 = 21,064 × 22 = 463,408となり、請求額の基になった値との差は0.7%以内です。報告者はこれを請求ダッシュボードでも検証し、APIのoutput_tokensを合計して公開料金を適用すると、ダッシュボード上の請求額を0.1セント単位まで再現できたとしています。そのGPT-5.6呼び出し全体では、約$320の請求のうち約$284が過剰請求でした。
この不具合はGPT-5.6以前から存在する
k=1、つまりGPT-5.6以前のモデルが出力する1つのreasoningアイテムの場合、式はR × 4/2 = 2Rとなり、一律2倍の過剰請求になります。報告者は、2026年5月のOpenAI自身の利用量エクスポートでもこれを確認しました。
| モデル | 請求対象の出力トークン | 実際のカウント | 比率 |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini(対照) | 12,054,680 | 9,160,567 | 1.01x |
つまり、GPT-5.6が不具合を新たに導入したわけではありません。GPT-5.6は推論を多数のアイテムに分割する最初のモデルであり、それまで目立たなかった2倍の問題を、はるかに大きな倍率へと増幅させました。reasoningは約512トークン単位のチャンクで出力されるため、k ≈ ceil(R/512)となります。これを式に代入するとoutput_tokens ≈ R²/1024 + 3R/2です。つまり過剰請求は推論の長さに対して二次的に増えます。思考量が2倍になれば、請求額はおよそ4倍になります。
本稿執筆時点の2026年8月では、OpenAIスタッフは不具合報告に返信し、追加データを求めています。ただし、修正や請求額の調整はまだ公に確認されていません。
7月30日の値下げ後におけるGPT-5.6の料金
2026年7月30日、OpenAIはLunaを80%、Terraを20%値下げしました。Solの料金は据え置きです。OpenAIの料金ページに記載されている現在の単価は以下のとおりです。
| モデル | 入力(短文) | キャッシュ済み入力 | キャッシュ書き込み | 出力(短文) | 出力(長文) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
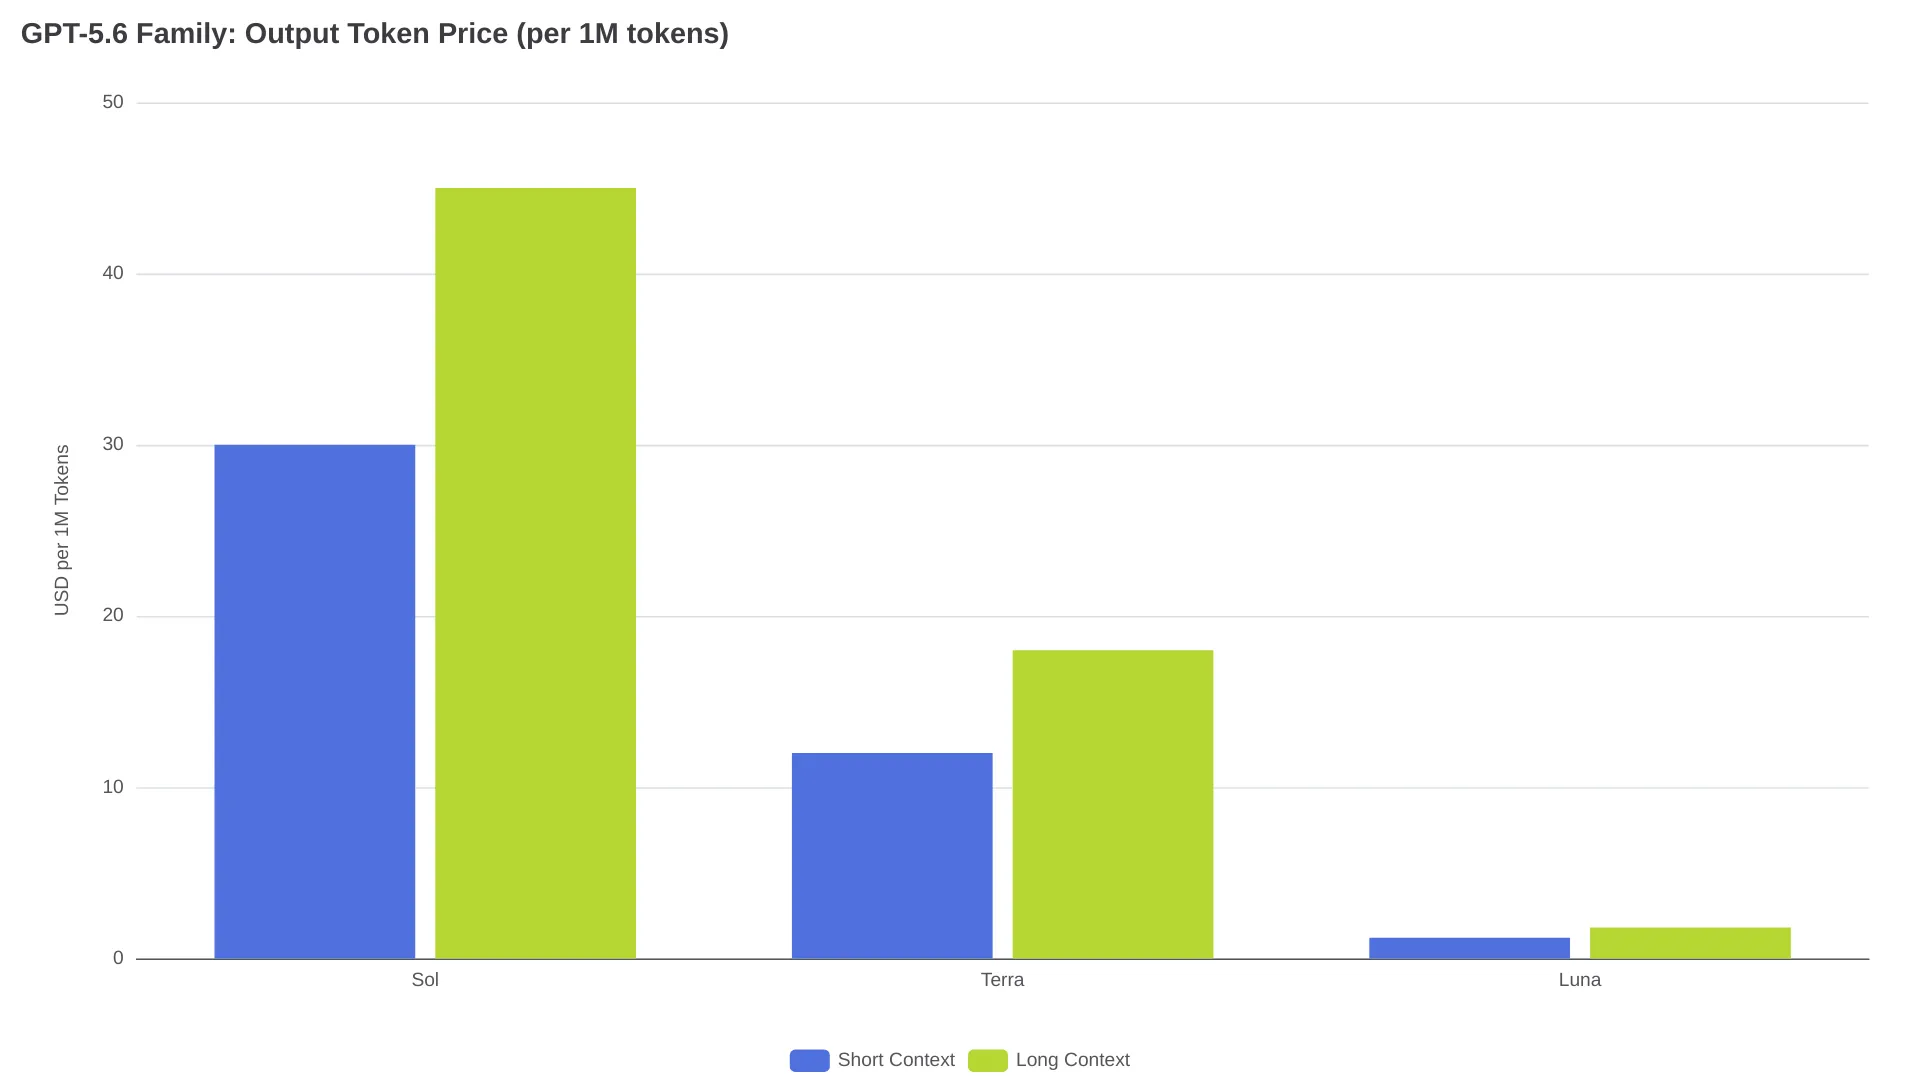
Solのトークン単価はGPT-5.5と同じです。ただしタスク当たりのトークン使用量は2.25倍なので、実質的なタスク単価はおよそ2倍になります。
キャッシュ書き込みは新たな課金項目です。GPT-5.6ではキャッシュ書き込みに入力単価の1.25倍がかかります。Solなら100万トークン当たり$6.25です。GPT-5.5にはキャッシュ書き込み料金がありませんでした。キャッシュヒット率が低いワークロードでは、従来にはなかった入力コストの25%分の上乗せが発生します。
LunaはGPT-5.4 nanoより安くなりました。値下げ後のLunaは$0.20/$1.20で、nanoの$0.20/$1.25を下回ります。OpenAIのラインアップで最も安価なモデルです。
GPT-5.6のトークン料金を抑える3つの方法
定型的な作業はTerraに切り替える
Terraの出力料金は100万トークン当たり$12で、Solの$30より60%安くなっています。Artificial Analysis Coding Agent Indexでは、TerraのスコアはClaude Fable 5をわずかに上回ります。7月の20%値下げ後、Terraの$2.00/$12.00は従来のGPT-5.5料金も下回ります。
それでもSolが適するのはどんな場面でしょうか。大規模コードベースをまたぐアーキテクチャ設計、複数ステップのデバッグ、セキュリティ分析です。こうしたタスクは長い推論連鎖の恩恵を受けます。一方、一般的なコーディング、分析、コンテンツ生成なら、Terraはトークン消費を大幅に抑えながら近い結果を出せます。
推論努力度を下げる
reasoning.effortパラメータはモデルが生成する推論トークン数を制御します。報告されている請求不具合はreasoningアイテム数(k)に直接比例して拡大します。mediumでは、Solが出力するreasoningアイテム数はxhighより少なくなるため、請求額の水増しも比例して小さくなります。
「Terra Ultraを使っているが、トークン使用量はGPT 5.5より実際かなり効率的に見える。」— r/codexユーザー
トークンを大量消費する傾向は、高い努力度に設定したSolへ集中しています。xhighやmaxではなく、reasoning.effortをmediumまたはhighにすることが、最も効果の大きい変更です。
キャッシュヒット率を最大化する
GPT-5.6では、明示的なキャッシュブレークポイントと、最低30分のキャッシュ保持期間が導入されました。キャッシュ読み取りには90%の割引が適用され、Solの入力コストは100万トークン当たり$5.00から$0.50になります。ただしキャッシュ書き込みは入力単価の1.25倍で、Solでは100万トークン当たり$6.25です。
システムメッセージや固定コンテキストを、キャッシュブレークポイントより前に置くようプロンプトを構成してください。損益分岐点はワークロードによって異なります。キャッシュ書き込みの割増は入力単価の25%ですが、キャッシュ読み取りによる節約は90%なので、読み取りの節約額が書き込みの追加料金を上回るヒット率が必要です。大半のリクエストで長いシステムプロンプトを共有するワークロードなら、早い段階で有利になります。
FAQ
OpenAIは請求不具合を認めているのか?
OpenAIスタッフのMark G.氏は、2026年7月12日にコミュニティフォーラムの報告へ返信し、調査のためリクエストIDとタイムスタンプの提供を求めました。2026年8月時点で、修正や過去分の請求調整は公表されていません。
自分のアカウントがこの請求不具合の影響を受けているか確認するには?
複数のreasoningアイテムを含むレスポンスでは、usage.output_tokens_details.reasoning_tokensに表示上の完了トークンを加算してください。usage.output_tokensがその合計を数%を超えて上回る場合、フォーラム報告で示された累積再加算の挙動が請求に影響している可能性があります。OpenAIダッシュボードから利用量CSVをダウンロードし、モデルごとに確認しましょう。
SolからTerraへ切り替えるべきか?
大半のAPIワークロードでは、Terraのほうが安く、コーディングベンチマークでも競争力のあるスコアを示しています。Solの優位性が出るのは最も難しいタスクです。OpenAI自身のベンチマークでも、長い思考時間の効果が最も大きい複数ステップの推論やセキュリティリサーチで、SolはTerraを大きく上回っています。