 AIREITER
GLM-5.3-Flashは入力100万トークンあたり$0.15から使えるものの、実運用のコストはそれだけでは決まりません。キャッシュヒットの割合、出力トークン数、強制される推論、そして約320Bパラメータのチェックポイントをどう扱うかによって、APIとオープンウェイトのどちらが配備に合うかは変わります。
現在適用されているGLM-5.3-Flashの料金
Z.AIの公式料金ページでは、GLM-5.3-Flashの料金は入力100万トークンあたり$0.15、キャッシュ済み入力100万トークンあたり$0.03、出力100万トークンあたり$0.50です。UTC+8(シンガポール時間)の2026年9月9日24:00まで、有効期限付きの50%割引も表示されています。
| GLM-5.3-Flashの課金項目 | 通常料金 / 100万トークン | キャンペーン料金 / 100万トークン |
|---|---|---|
| 新規入力 | $0.15 | $0.075 |
| キャッシュ済み入力 | $0.03 | $0.015 |
| 出力 | $0.50 | $0.25 |
| キャッシュ済み入力の保存 | 期間限定で無料 | 期間限定で無料 |
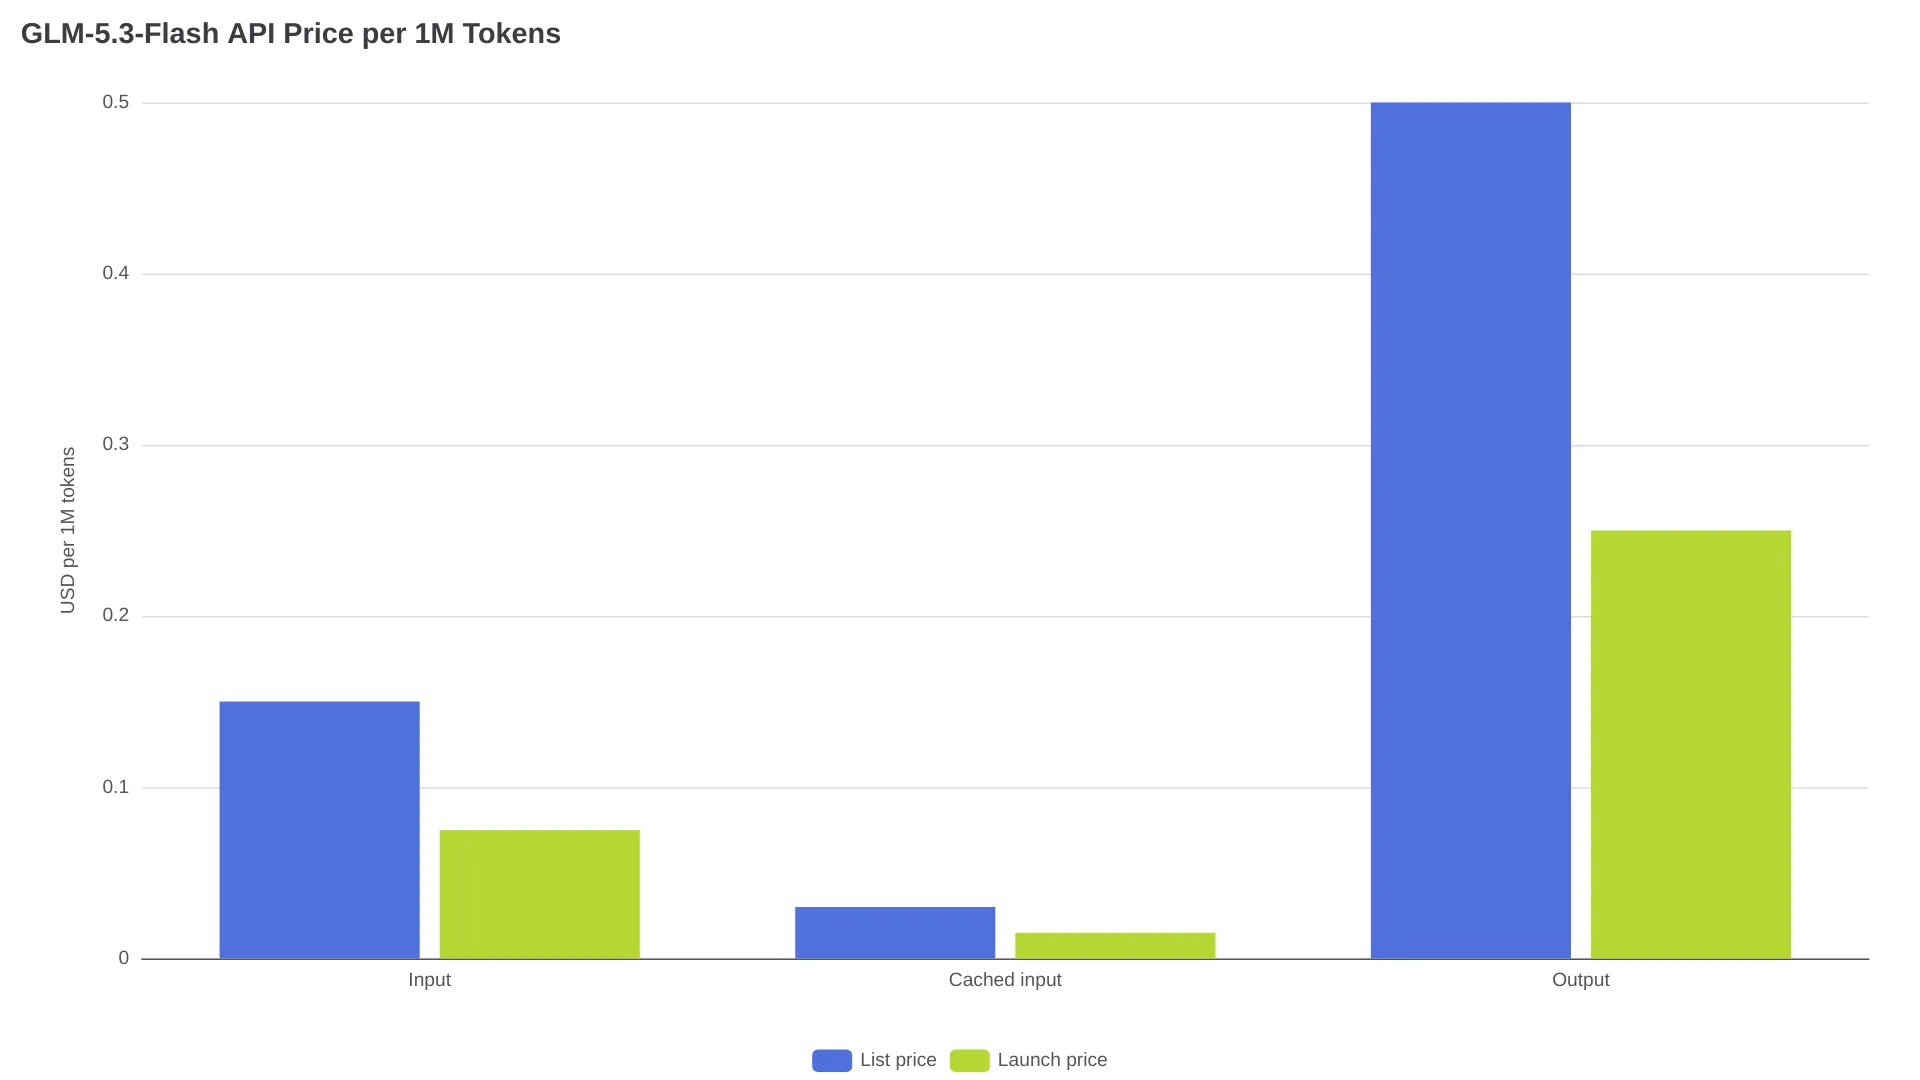
50%引きは本番予算の前提ではなく、あくまで期間限定のキャンペーン価格として扱うべきです。Z.AIのリリース告知によれば、ox-alphaは先行プレビュー時の識別名です。
同じ公式料金表では、標準版GLM-5.3は入力$1.40、キャッシュ済み入力$0.26、出力$4.40(いずれも100万トークンあたり)とされています。通常料金で比べると、Flashは入力・出力ともに約89%安価です。ただし、これは料金の比較であり、両モデルの品質、レイテンシ、運用上の挙動が同一だという意味ではありません。
購入するのは小型ローカルモデルではなくAPIアクセス
GLM-5.3-Flashは、総パラメータ数320B、トークンあたりのアクティブパラメータ数18Bを持つ、MITライセンスのオープンウェイト・マルチモーダルモデルです。公式Hugging Faceモデルカードには公開チェックポイントzai-org/GLM-5.3-Flashとローカルサービングの手順が掲載されています。Z.AIのリリース資料では、コンテキストウィンドウは100万トークンで、テキスト、画像、動画の入力に対応すると説明されています。
「18B active」は、選択されたエキスパートが行う計算量を指す値であり、必要な総メモリ量ではありません。ローカル運用の現実性は、フルウェイト、KVキャッシュ、ランタイムのオーバーヘッド、マルチモーダル処理、コンテキスト長にも左右されます。
| 利用方法 | 得られるもの | 主な制約 |
|---|---|---|
| Z.AI API | 入力、キャッシュ済み入力、出力トークンに応じて課金されるホステッド推論 | アカウント制限と推論レイテンシ |
| 公式チェックポイント | セルフホストや追加適応に利用できるMITライセンスのウェイト | 精度形式や量子化に応じた大容量メモリのインフラ |
| コミュニティ製量子化ビルド | 一部のローカルランタイム向けに小さくしたファイル | ビルド品質、モダリティ対応、速度、互換性にばらつきがある |
トークン単価が低いことと、ホスティング費用が低いことは別の話です。突発的な利用ならAPIはトラフィック発生時だけ支払えばよい一方、セルフホストではアイドル時もサービング容量を確保し続けます。
実ワークロードで見るAPI課金
GLM-5.3-Flashのコストは、新規入力、キャッシュとして認識された入力、生成出力の内訳で決まります。
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
通常料金では、新規入力1,000万トークンと出力200万トークンで$2.50です。内訳は入力$1.50、出力$1.00です。キャンペーン期間中なら、同じ利用量は$1.25になります。
| ワークロード | 通常料金での計算 | 通常料金の合計 | キャンペーン料金の合計 |
|---|---|---|---|
| 新規入力10M + 出力2M | $1.50 + $1.00 | $2.50 | $1.25 |
| 新規入力2M + キャッシュ済み入力8M + 出力2M | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 新規入力100K + 出力10K | $0.015 + $0.005 | $0.020 | $0.010 |
Artificial Analysisが示す100万トークンあたり$0.10のブレンド単価は、キャッシュヒット・入力・出力を7:2:1とした定義済みの比率に基づくものです。比較可能なワークロードの指標としては便利ですが、GLM-5.3-Flashの一律料金ではありません。
キャッシュ割引が適用されるのは、実際にキャッシュヒットした場合だけです。Z.AIのChat Completionレスポンススキーマにはusage.prompt_tokens_details.cached_tokensが含まれるため、本番の原価計算では、このフィールドを記録するべきです。見た目が似たプロンプトを繰り返せば自動的に割引される、と仮定してはいけません。r/opencodeCLIのあるユーザーは、ローンチ時の経済性を次のように評しています。
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, Reddit discussion
割引終了日はZ.AIの料金表で確認できますが、比較や利用感はこのコメント投稿者の意見です。安定した繰り返しコンテキストはキャッシュ再利用率の向上につながる可能性がある一方、出力、リトライ、ツール利用、アカウント制限のコストまではなくなりません。
コンパクトな予算シートの作り方
見積もりでは、新規入力、キャッシュ済み入力、出力、有料ツールを別々の行として管理します。Z.AIはWeb Searchを1回あたり$0.01と案内しているため、エージェントが検索を繰り返すと、トークンだけで見積もった額を上回る場合があります。
| 月間利用量の想定 | 通常料金での計算式 | 月額 |
|---|---|---|
| 新規入力100M + 出力20M | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 新規入力20M + キャッシュ済み入力80M + 出力20M | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| Web Search 100回 | 100 × $0.01 | $1.00 |
ここで挙げた数値は算術例であり、利用上限ではありません。リトライや途中で放棄されたエージェント実行分は別途加算してください。出力量が多いなら、小さなプロンプト接頭辞を詰めるよりも、現実的なmax_tokensを設定し、適した場面ではreasoning_effortを下げるほうが影響は大きくなり得ます。
移行前に確認したいZ.AI APIの制約
公式のZ.AI APIでは、一般的なベースURLとしてhttps://api.z.ai/api/paas/v4/を、チャット補完用としてhttps://api.z.ai/api/paas/v4/chat/completionsを使用します。認証はBearer APIキー方式です。Z.AIのAPI introductionでは、カスタムベースURLを使ったOpenAI互換のPython、Node.js、Javaクライアントパターンが案内されています。
現行のChat Completionリファレンスでは、thinkingとreasoningの説明にGLM-5.3-FLASHが登場しますが、レンダリングされるモデルenumにはglm-5.3-flashが表示されません。一方、公式料金ページとリリース資料にはFlash SKUが掲載されています。本番トラフィックを切り替える前に、小規模なリクエストで正確なホステッドモデルIDを試してください。
| 統合時の確認項目 | 確認済みの制約 |
|---|---|
| 試すべきホステッドモデルID | glm-5.3-flash。実際に受け付けられるかはライブのアカウントスキーマで確認する |
| ホステッドエンドポイント | https://api.z.ai/api/paas/v4/chat/completions |
| 認証 | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASHではthinkingが有効で、深さはreasoning_effortで制御する |
| Reasoning effort | low、high、またはmax |
最大max_tokens | 現行パラメータリファレンスでは131,072 |
| Coding Plan | キー、エンドポイント、クレジット体系は別。一般APIの残高ではない。Z.AI’s Coding Plan quick startを参照 |
Z.AIではmaxがデフォルトのreasoning effortです。努力レベルによってトークン単価は変わりませんが、推論は出力使用量と待ち時間を変える可能性があります。アカウント制限については、Z.AIはアカウントごとのrate-limit dashboardを案内しています。公開ガイドには、すべてのAPIアカウントに共通する数値上限は記載されていません。
オープンウェイトとホステッドAPI、どちらを選ぶか
公式モデルカードにはTransformers、vLLM、SGLang、TokenSpeed、KTransformers向けのローカルサービング手順があります。ただし、これらのレシピが一般的なコンシューマーGPUでの実用的な運用を保証するわけではありません。
トラフィックが断続的な場合や、大容量メモリを備えた推論ハードウェアを用意できない場合は、ホステッドAPIが向いています。利用率が継続的に高い場合、またはデータ取り扱いの制御が運用コストを正当化する場合は、分散サービングやローカルサービングを検討できます。低精度のテキスト専用ビルドでは、公式のマルチモーダル構成を再現できない可能性があります。
セルフホストを検討する目安
GetDeployingの推定では、4ビットの配備にはGPUメモリが約192 GB、8ビットでは約384 GB、BF16では768 GB必要です。MI300X構成の料金は1時間あたり$2.90、連続稼働時の月額は約$2,088と見積もられており、入力対出力を5:1とした場合、APIとセルフホストの損益分岐は毎時約1,400万トークンとされています。
これらは第三者による推定であり、Z.AIが保証するハードウェア要件ではありません。4ビット・192 GBの構成は余裕が少ないとされています。KVキャッシュ、ランタイムのオーバーヘッド、マルチモーダル処理、バッチング、アイドル時間により、損益分岐点は変動します。ローカル推論を選ぶ前に、時間あたりのインフラ費用、利用率、実効トークン処理量、キャッシュヒット率、完了タスクあたりのコストを比較してください。
GLM-5.3-FlashとGLM-5.3の選び分け
Flashと標準GLM-5.3では、料金表も配備上の位置付けも異なります。
| 比較項目 | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| 通常の入力料金 | $0.15 / 1M | $1.40 / 1M |
| 通常のキャッシュ済み入力料金 | $0.03 / 1M | $0.26 / 1M |
| 通常の出力料金 | $0.50 / 1M | $4.40 / 1M |
| 期間限定キャンペーン | 2026年9月9日までUTC+8で50%オフ | Flashと同等のキャンペーンは表示されていない |
| オープンウェイトのチェックポイント | 公式のMITチェックポイントが掲載されている | 別個のモデル掲載。ウェイトが同一だと推測してはいけない |
| マルチモーダルの位置付け | ネイティブマルチモーダル。Z.AIは画像・動画入力を説明 | 標準GLM-5.3の対応範囲は別途確認する |
| ローカル配備 | 大規模なチェックポイントであり、大容量メモリのサービングが必要 | 同モデル固有の配備ドキュメントを使う |
トークンコスト、マルチモーダル入力、オープンウェイトという選択肢を重視し、強制される推論とプロバイダー側の制約を許容できるなら、まずFlashを選ぶのがよいでしょう。標準GLM-5.3を選ぶのは、その高い料金で得られる機能や信頼性の差がアプリケーションにとって重要かどうかを測定してからです。
FAQ
GLM-5.3-Flash APIの現在の料金は?
公式の通常料金は、入力が100万トークンあたり$0.15、キャッシュ済み入力が$0.03、出力が$0.50です。一時的な50%引き料金は上の料金表を確認してください。
キャッシュ済み入力には$0.03の料金が適用されますか?
はい。Z.AIが対象トークンをキャッシュ済みと認識した場合に適用されます。キャッシュ済み入力の保存は別途「期間限定で無料」とされているため、保存状況とキャッシュヒット時の課金を混同しないでください。
GLM-5.3-Flashはオープンソースですか?
正確には、MITライセンスのオープンウェイト・チェックポイントです。ライセンスは幅広い利用を許可していますが、総パラメータ数320Bのモデルには、依然として大きなメモリ、互換性のあるソフトウェア、サービング容量が必要です。
GLM-5.3-Flashを普通のノートPCで動かせますか?
フル精度で実用的に配備することはできません。第三者による4ビット時の見積もりでもGPUメモリは約192 GBであり、アクティブパラメータが18Bであっても、フルチェックポイントの保存・実行コストはなくなりません。
GLM-5.3-FlashはGLM-5.3より高速ですか?
「Flash」が裏付けるのはコストとアクティブ計算量の位置付けであり、あらゆる条件でのレイテンシ保証ではありません。Artificial Analysis reportsでは、測定環境においてZ.AI経由で出力毎秒48.7トークン、最初の回答トークンまで42.57秒と報告されています。体感応答時間は推論時間やワークロードの形状に大きく左右されます。
Coding Planは同じAPI残高を提供しますか?
いいえ。Z.AI’s Coding Plan quick startには、Coding Plan用の個別キー、別エンドポイント、公式対応ツールおよび製品に限定されたアクセスが記載されています。Coding Planのサブスクリプションを、公開APIにおけるドル建て・トークン単価の予算へ直接換算することはできません。
トラフィックが断続的で、ハードウェア費用をすでに負担していないなら、低リスクな選択肢はAPIです。ローカルサービングは、継続的な利用率、メモリ、データ制御の要件で判断すべき別の経済的選択となります。