 AIREITER
Gemini 4 Carbonをわざわざ使う価値があるのは、数時間では終わらず、一晩かけて走らせるような仕事だ。たとえばマルチエージェントによるリファクタリング、200ビュー規模のドキュメントからの構築、脆弱性の検証からパッチ作成までを繰り返すループなどである。Google自身も、大半のソフトウェアエンジニアリングとナレッジワークにはGemini 4 Argonが理想的だとしている。Carbonはトークン消費を増やしてでも、特に難度の高い課題を処理するモデルだ。
Gemini 4 Carbonは、Gemini 4 Argonをベースにした最先端の推論モデルである。Googleは2026年10月28日にCarbonを発表し、2026年11月10日から一般提供を開始した。DeepMindのモデルカードによれば、知識カットオフは2026年3月。入力と出力を合わせて最大100万トークンまで扱え、テキスト、ドキュメント、画像、音声、動画を入力でき、出力はテキストとなる。
現時点でCarbonを使えるユーザー
Gemini 4 Carbonの提供範囲は利用チャネルごとに分かれており、コンシューマー向けが最も限定的だ。開発者はGoogle AI Studioの有料Gemini API階層に加え、Android StudioとGemini for businessで利用できる。一般ユーザーがGeminiアプリ、SearchのAI Mode、Google AntigravityでCarbonを使うには、Google AI Ultraが必要になる。科学者はAntigravityの最上位利用枠を6か月間無料で使えるよう申請でき、認証済みのディフェンダーはFairwind Program経由で申請可能だ。
Google AI Proの契約者は、コンシューマー向け画面ではCarbonを利用できない。この制限はr/GeminiAIのローンチスレッドでも繰り返し指摘されている。
「ULTRAで利用可能。ProのArgonは数プロンプトでなくなる。」— r/GeminiAIのu/Nodayssoff
リンク先のローンチ資料には、コンシューマー向けの固定クオータ、Pro階層での提供開始日、国ごとの提供状況は明記されていない。アクセススレッドおよびクオータスレッドでは、5時間枠や週次枠が数プロンプトで尽きた、ある画面では使えるキーがAntigravityではブロックされた、といった報告がある。初日にはAn internal error has occurredエラーも報告された。Ultraは無制限のCarbon利用枠ではなく、検証用の席として予算化しておくのがよい。
CarbonとArgonの違いを一覧で確認
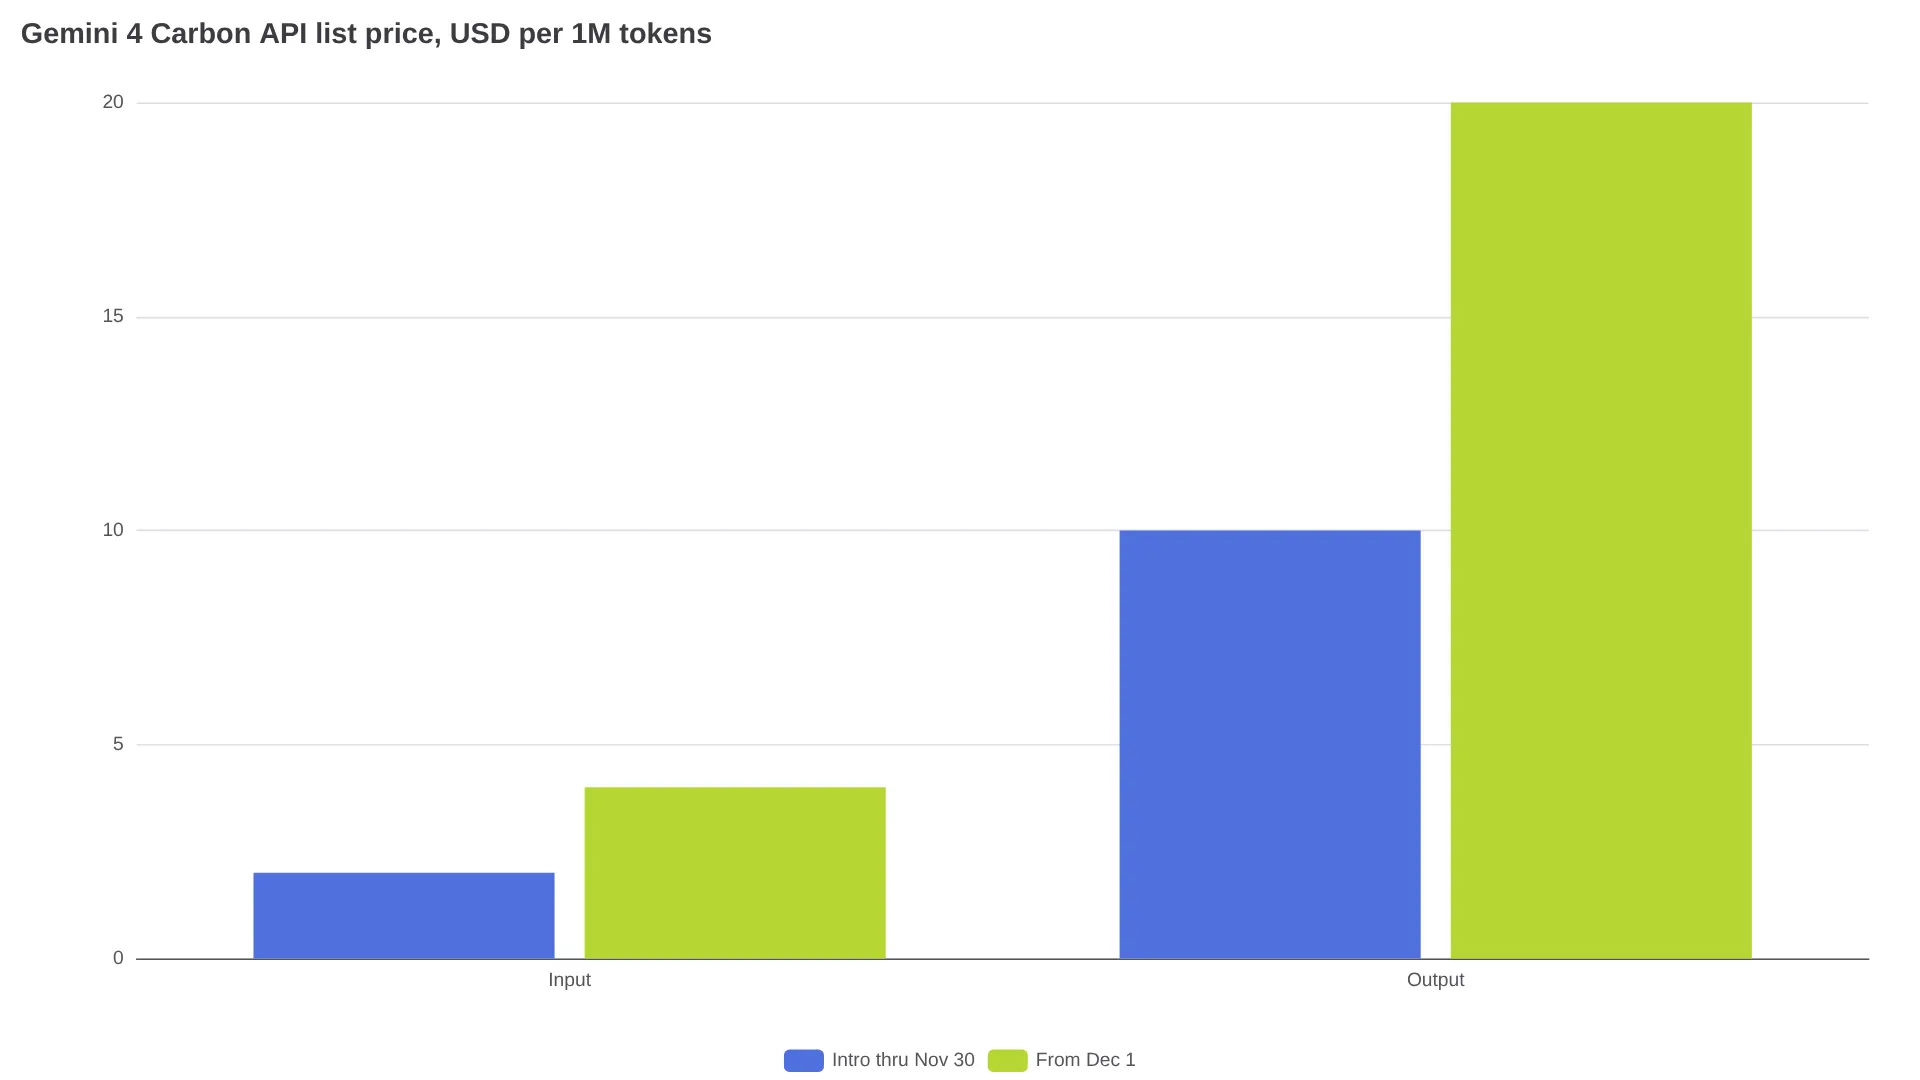
Gemini 4 CarbonとGemini 4 Argonは、APIの定価とコンテキストサイズを共有している。違いが出るのは、能力、レイテンシ、そしてトークン消費量だ。
| 項目 | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| 位置付け | Argonを基盤に、難しい長期タスク向けの推論を強化 | 基盤となる最先端モデル。通常のエンジニアリング向け既定モデル |
| 一般提供開始 | 2026年11月10日 | ToolColumnの比較によれば2026年10月13日 |
| APIモデルID | 呼び出し時にAI Studioで確認。ローンチ投稿には別個の固定IDなし | ToolColumnの比較によればgemini-4-argon |
| API定価、2026年11月30日までの導入価格 | 入力100万トークンあたり$2、出力$10、キャッシュ入力$0.10 | 入力100万トークンあたり$2、出力$10、キャッシュ入力$0.10 |
| API定価、2026年12月1日以降 | 入力100万トークンあたり$4、出力$20 | 入力100万トークンあたり$4、出力$20 |
| コンテキスト | 入力と出力の合計で最大100万トークン | ToolColumnの比較によれば1,048,576トークン |
| 入力モダリティ | テキスト、ドキュメント、画像、音声、動画 | Artificial Analysisによればテキスト、画像 |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| インデックスタスクあたりの加重コスト | $7.76 | $9.95 |
| 出力速度 | 82 tok/s | 68 tok/s |
| 最初の回答トークンまでの時間 | 67.54秒 | 40.02秒 |
| Thinkingレベル | 設定可能。高いレベルほどトークン消費が増える | ToolColumnの比較によればLow / Medium / High、既定はMedium |
価格はGoogleの提供開始アナウンスに基づく。速度、レイテンシ、タスク単価、モダリティの差はArtificial AnalysisのCarbon vs Argonによるものだ。キャッシュ入力は定価から95%引きであり、導入価格では100万トークンあたり$0.10となる。
定価は同じでも、実際のワークロード単価は同じではない。Artificial Analysisでは、Carbonの加重Intelligence Indexタスクあたりのコストは$7.76で、Argonの$9.95を下回った。Carbonはタスクあたりの平均出力トークンが約7,000多いにもかかわらず、である。加重タスクの完了時間はCarbonが24.9分、Argonが28.6分。ただし最初の回答トークンまでの待ち時間はCarbonが67.54秒で、Argonの40.02秒より長い。Carbonは継続的な処理では強いが、最初の応答は遅い。
Carbonが明確に強い領域、差が小さい領域
Googleは17件の評価結果を報告している。以下はCarbonとArgonを抜粋して比較したものだ。Gemini 4 Carbonは17項目すべてでGemini 4 Argonを上回り、5モデル全体との比較でも15項目で首位だった。ただし例外の2項目は重要である。FrontierSWE 2ではGPT-6 Astraが65.5%でCarbonの61.2%を上回り、OSWorld-2.1 offlineではClaude Opus 5.5が87.2%でCarbonの81.5%を上回った。
| 用途 | ベンチマーク | Carbon | Argon | 差 |
|---|---|---|---|---|
| エージェント型コーディング | SWE-sweep | 9.6% | 4.3% | +5.3 pp |
| エージェント型コーディング | Terminal-Bench 4.0 | 65.2% | 57.1% | +8.1 pp |
| エージェント型コーディング | FrontierSWE 2 | 61.2% | 55.0% | +6.2 pp、ただしAstraには届かない |
| コンピュータ操作 | Agents' Last Exam v1.1 | 77.4% | 69.0% | +8.4 pp |
| コンピュータ操作 | OSWorld-2.1 offline | 81.5% | 74.7% | +6.8 pp、ただしOpus 5.5には届かない |
| ナレッジワーク | AutomationBench, Zapier | 53.9% | 51.3% | +2.6 pp |
| ナレッジワーク | Vending-Bench 2 balance | $16,484 | $13,718 | シミュレーション残高で+$2,766 |
| 長文コンテキスト | GraphWalks 256K-1M BFS F1 | 96.2% | 84.2% | +12.0 pp |
| 科学 | Terminal-Bench-Science 0.1 | 64.8% | 52.9% | +11.9 pp |
| 科学 | RiemannBench | 80.0% | 76.0% | +4.0 pp |
| サイバー | ExploitGym | 54.8% | 42.0% | +12.8 pp |
| サイバー | SEC-bench Pro | 88.2% | 83.4% | +4.8 pp |
| サイバー | CWE-bench | 71.0% | 68.0% | +3.0 pp |
すべての行は、2026年10月版のDeepMindモデルカードの表に基づく。サイバー分野の行は、ガードレールなしのFairwindアクセスを反映したものであり、標準製品での挙動ではない。同じモデルカードには、Chartography(72.5% vs 71.6%)、Vals Index(70.4% vs 69.2%)、AA Index v5.0(59 vs 50)、Blueprint-Bench 2 similarity(58.6% vs 54.4%)も掲載されており、これで17項目がそろう。
- 最難関の技術ワークロード:Carbonの優位が最も大きいのは、エクスプロイト検証、256K〜1Mのグラフ検索、ターミナル上の科学タスク、複数ステップのターミナルコーディングだ。
- 日常的なナレッジワーク:グラフ読解、一般評価、オフィス自動化では差は1〜3ポイントまで縮まる。
- 誠実性と安全性:Googleは、Carbon紹介記事で、エージェントの誠実性評価における375タスクの通過率がCarbonは92%、Argonは70%だったと報告している。間接的なプロンプトインジェクションの成功率はCarbonが0.0%、Argonが0.7%で、根拠のない主張もおおむね半減した。
Artificial Analysisでは、CarbonはIntelligence Indexの9つの構成要素すべてで先行している。とくに物理推論や、FrontierCode 2.0でCarbonが40.6%、Argonが25.7%となったようなオープンリポジトリのエンジニアリングで差が大きい。Googleの提供開始投稿では別途、CursorBench 4.0、Perplexity WANDR、Zapier AutomationBenchで首位を獲得し、次点の外部モデルと比べてタスク単価は2分の1未満だとしている。
Carbonに任せる仕事、Argonに残す仕事
検証ループそのものが成果につながる仕事には、Gemini 4 Carbonを使いたい。Googleの提供開始投稿で紹介された、200件超のPDF図面ビューからThree.jsを10ループかけて一晩で再構築する作業や、マルチエージェントの/swarmによる物理シミュレーション構築がその例だ。以下のコミュニティ作品は、より小規模ながら同じパターンを示している。
「Gemini 4 Carbonで外に出る暇もない。ゲームエンジンも3Dライブラリも使わず、CUDAとC++だけでこの草原をゼロから作った。草と野花は5万2000本。最終的には風の音もC++で合成したので、同じ風が[音も動かしている]。」— Xの@GlitterPixely
日常的な作業はGemini 4 Argonに残してよい。Carbonの優位が最も小さいのはグラフ読解とオフィス自動化なので、単一ファイルの修正、標準的なCRUD、スキーマ固定のスプレッドシートはArgonから始めるのが合理的だ。Carbonより最初のトークンが速く、トークン消費も抑えられる。短いストーリー生成でHigh thinkingを使うとトークンを急速に消費し、あるOpenRouterの報告では、4,000文字の物語にHighで約6,000のthinkingトークンを使ったという。
実際の運用では、新しいエージェントはまずArgon Mediumで始め、プロンプト、クオータ、ツール権限を確認する。Carbonへ移すのは、うまくいかなかった長い尻尾の部分だけでよい。具体的には、パッケージをまたぐ移行、複数サブシステムにまたがる根本原因調査、図面や表を含む100Kトークン超のドキュメント群、Fortify型のスキャン・トリアージ・修正ループなどだ。Googleの提供開始投稿では、後者について社内でスキャン再現率100%、トリアージ精度95%を報告している。/swarmでは、Carbonにアーキテクト、コーディネーター、敵対的検証者の役割を与え、軽量モデルには並列ワークスペースを任せる。Carbonで内部エラーが繰り返される場合は、thinkingを上げる前に新しいセッションで再試行したい。初日のスレッドでは原因不明のエラーが報告されている。
12月1日以降のCarbon予算を考える
12月1日にAPI定価が2倍になると、リポジトリ、図面、ツール出力を再利用するための積極的な入力キャッシュが重要になる。キャッシュ入力は定価の95%引きだ。
予算を定価だけで判断してはいけない。Carbonは計測済みタスクあたりの出力トークンが多い。そのため、月間入力50M・出力5Mなら、どちらのモデルでも定価ベースでは導入価格の$150から導入期間後は$300へ倍増し、Carbonではさらにthinking分が加わる。それでもArtificial Analysisでは、完了した加重Intelligence IndexタスクあたりのコストはCarbonの方が低い。再試行が少なく、継続的な処理性能が高いため、トークン量の増加を相殺するからだ。使い分けは明快である。Carbonが8〜13ポイント先行するエクスプロイトチェーンやターミナル科学にはHigh thinkingを使い、差が1〜3ポイントのドキュメント作成やUIの仕上げにはMediumまたはLowを使う。
項目別の詳細な計算は、サイト内のGemini 4 Carbon API料金レビューを参照してほしい。
Gemini 4 Carbon FAQ
Google AI ProでもCarbonは使えるようになる?
リンク先の資料にはPro向けの提供開始日は記載されていない。Argonを使い続け、Ultraは短期的なCarbon検証用の席として考えるのがよい。
料金を左右するthinkingレベルは?
Mediumはプロンプト検証向け。8ポイント以上の差が出るエクスプロイトチェーンやターミナル科学にはHighを使う。
CarbonとArgonはクオータを共有する?
共有クオータを明記した確かな資料はない。利用画面ごとにアカウントの現在の上限を確認しよう。100万という数値はコンテキスト容量であり、利用クオータではない。
用途別の最終判断
| 仕事の内容 | 選択 | 理由 |
|---|---|---|
| 今週リリースする通常のコードとドキュメント | Argon Medium | 差は1〜3ポイントで、最初のトークンが速く、消費も少ない |
| 複数日にわたる移行、100K超トークンのリポジトリと図面 | Carbon。安定後はMediumへ下げる | ターミナルおよび長文コンテキストで+8〜12ポイント |
| オープンソース脆弱性のスキャン、トリアージ、パッチ作成 | Fairwind/API経由のCarbon | モデルカードでExploitGymは+12.8ポイント。セキュアコード率はArgonの2倍超 |
| グラフを含む金融・法務ドキュメントエージェント | まずArgon、争点となる数値だけCarbon | 提供開始投稿によれば、CarbonはMultimodal Knowledge Agentで2位、首位の6分の1のタスクコスト。ただしAutomationBenchではArgonとの差が小さい |
| 週次クオータが厳しいUltra契約者 | 日常はArgon、難しい1回だけCarbon | Carbonは数プロンプトで利用枠を消費するというユーザー報告がある |
Carbonは常用する既定モデルではなく、難題ごとに借りる専門家だ。日々のキューはArgonに任せる。検証ループとエクスプロイトからパッチまでの深さが結果を左右する場面でのみ、Carbonは12月以降の定価に見合う。