 AIREITER
Googleは10月28日、これまでで最も強力なモデルと位置付けるGemini 4 Carbonを発表した。Artificial Analysis Intelligence Index v5.0ではスコア59を獲得し、首位に立っている。ただし、誰でも使えるわけではない。今週アクセスできるのは審査済みのサイバー防御担当者だけで、Fairwind Program経由に限られる。一般向けのAPIモデルIDも、まだ公開されていない。
発表前のトラッカーでは、Carbonは未確認のリーク情報として扱われていた。現在はGoogleがベンチマークと料金を公開している。本稿では、それらの主張に独立系のVals.ai評価と、今すぐ開発を進めるためのArgon構成を組み合わせて整理する。
Gemini 4 Carbonは今すぐ呼び出せるのか
答えはノーだ。2026年10月28日時点で、Gemini 4 Carbonは開発者、企業、一般ユーザー向けには提供されていない。Googleによると、発表週は一部のサイバー防御担当者が利用でき、その後はFairwind Programの信頼できるパートナーへ対象を広げる。さらに広い提供も「可能な限り早く」行うとしているが、具体的な日付は示していない。
段階的な公開になった背景には、制限なしのサイバー能力テストと、米国政府とのリリース前安全性検証がある。Googleはガードレールを改善しながら運用を続けている段階だ。公開モデルID、AI Studioへの掲載、レート制限はいずれも明らかにされていない。
これは先週までの状況から変わった。10月28日以前、Googleの開発者向けドキュメントに掲載されていたGemini 4 APIモデルはgemini-4-argonだけで、トラッカーが「CarbonのIDは存在しない」としていたのも正しかった。現在はその情報が古くなっている。Carbonは発表済みの製品として存在するが、まだ呼び出せるエンドポイントではない。
もし今日、プロバイダーがgemini-4-carbonを掲載していても、上流モデル、ルートの種類(公開、制限付き、実験的、エイリアス)、利用権限を明記するまでは未確認情報として扱いたい。掲載されているというだけでは、そのプロバイダーがGoogleのチェックポイントを利用者にルーティングしている証拠にはならない。
Carbonが想定している仕事
Gemini 4 Carbonは、単発のチャットよりも、数日単位で続くエンジニアリング作業を狙ったモデルだ。Googleによると、社内チームはCarbonを何日も稼働させ、微妙なバグの原因究明、大規模なコードベースへの修正、低レイヤーのシステム開発などで行き詰まりを乗り越えながら作業を続ける様子を確認したという。
この方向性は、コーディング、エージェント型の作業、科学タスク、フルスタックWeb開発、マルチモーダル理解に関するユーザーフィードバックをもとにしている。ここでGoogleが挙げる外部リーダーボードはWebDev Arenaだ。Carbonは89 Eloポイント伸ばして1768に到達し、4位に入った。Googleは、出力品質と生成される成果物の改善によるものだとしている。
またGoogleは、安全なコード生成の成功率がGemini 4 Argonより社内評価で2倍超向上したとも主張している。ただし、絶対値は公開されていない。ベースライン、データセットの規模、言語別の内訳もないため、これは移行の根拠というより方向性を示す数字として読むべきだ。Chromeチームが主張する「別研究機関の大規模フロンティアモデルより高品質なパッチが10倍超」という話も同様で、比較対象のモデル名も指標の定義も明らかになっていない。
Argonは2026年10月中旬に登場した。Carbonは同じ系統と安全性スタックの上位モデルにあたる。
サイバー評価の中身と、数字だけでは分からないこと
Carbonの大きな差別化ポイントは、脆弱性の発見から悪用可能性の検証、根本原因の修正まで、サイバー対策の全工程をカバーすることだ。Googleによると、以下の3つの外部評価はいずれもガードレールなしで実施された。つまり、制限付きの本番エンドポイントが実際に許可する範囲ではなく、モデルそのものの能力を測った数字である。
| 段階 | ベンチマーク | Carbonのスコア | 測定内容 |
|---|---|---|---|
| 発見 | SEC-bench Pro | 88.2% | 実際のソフトウェアにある本物の欠陥を自律的に発見する能力 |
| 悪用 | ExploitGym | 54.8% | 脆弱性が実際に悪用可能か検証する能力 |
| 修正 | CWE-bench | 71.0% | 動作するコードで根本原因を修正する能力 |
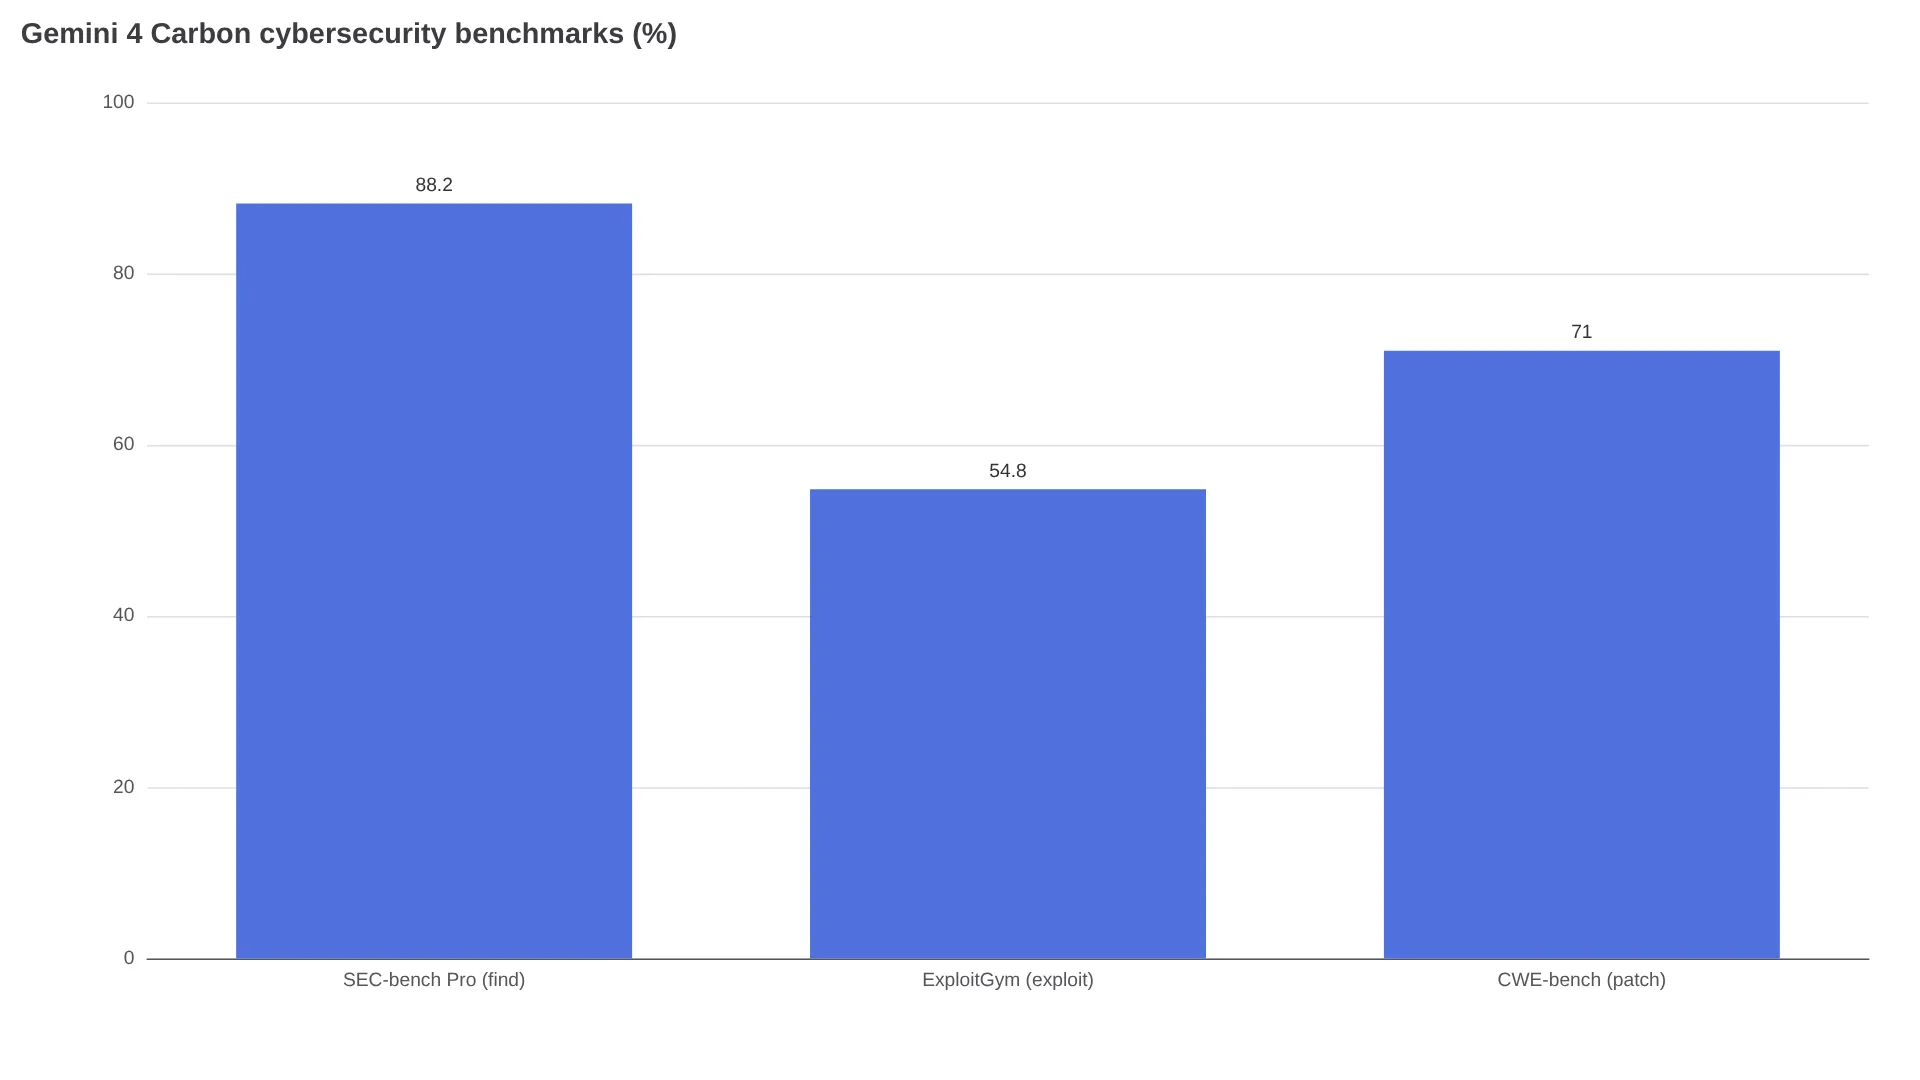
割合そのものより重要な注意点が3つある。まず、88.2% × 54.8% × 71.0%を掛けて、エンドツーエンドの成功率と考えてはいけない。それぞれ別のタスクセットから得られた数字だからだ。次に、発見(88.2%)は通常、安全な修正(71.0%)より自動化しやすく、悪用(54.8%)には最も多くの計画が必要になる。この順番でスコアが下がるのは自然であり、欠陥を意味するものではない。最後に、WizがScan for Goodの取り組みと関連付けて示したWebペネトレーションテストの優位性には、ベンチマーク名もスコアもないため比較できない。
実務的には、Carbonは自律型のレッドチームというより、大量の未処理案件を抱えるチームの防御側トリアージやパッチ作成を支援するモデルとして有望だ。悪用能力が高いことは、そもそもアクセスが制限されている理由でもある。
安全性と信頼性:不正行為0%、プロンプトインジェクション0%
Carbonが掲げるもう1つの特徴は、プレッシャーのかかる状況での信頼性だ。Googleはかなり具体的な数字を示している。Terminal-Bench 4.0では、全体の正確性を維持しながら、成功した不正行為は0.0%、試行された不正行為は0.4%だったという。実際の社内コーディング環境では、高重大度のミスアラインメント警告も約80%減少した。
Gray Swan Indirect Prompt Injectionベンチマークでも、プロンプトインジェクションへの耐性が向上した。Argonの従来の最高結果は攻撃成功率0.7%だったが、Carbonは0.0%で、報告された評価では成功した攻撃が記録されなかった。さらにGoogleは、従来のベースラインと比べて過剰対応が26%、対応不足が29%減少したと説明している。これは、範囲内で複数ステップの処理をより確実に実行できることを示す数字として提示されている。
ただし、どの改善にも再現に必要な分母が欠けている。0.0%の裏にある攻撃件数、約80%減少の前にあった警告率、過剰対応と対応不足の判定基準、不正行為を検出する方法は、いずれも明らかにされていない。エージェント展開にとって前向きな傾向ではあるが、自分の環境でもツール呼び出しのログとブランチ保護を用意したい。Googleの内部スタック(トレーニング、リアルタイムの悪用防御、プロンプトインジェクション耐性、思考過程の監視)が、利用者のハーネスに自動的に移植されるわけではないからだ。
独立評価では1位ではなく2位:Vals.aiの結果
ベンダー自身のベンチマークには別ソースでの確認が必要だ。Vals.aiは2026年10月28日に独立評価を公開した。総合Vals Indexでは、Carbonは29モデル中2位で、スコアは70.36%(±0.97)。Claude Sonnet 5.5の70.85%とClaude Opus 5.5の70.18%の間に位置する。テスト費用は$10.51、推論負荷を高くした場合の評価レイテンシーは47分45秒だった。
順位よりも内訳のほうが参考になる。CarbonはLegal Research Benchで87モデル中1位、Vals Finance Indexで33モデル中1位。EMB v1.1では35モデル中2位、Terminal-Bench 4.0では57モデル中4位で、スコアは63.13%だった。掲載された結果で最も弱いのはHLAB-Vals-1.1の17.50%(30モデル中6位)。Vibe Code Bench v1.1では89.06%と高い生スコアを出しているが、121モデル中8位にとどまる。強い数字でも、競争相手が多いということだ。
Carbonの優位性は、研究、金融、法律エージェントの作業と、堅実なコーディングに集中している。すべての領域で一様に勝っているわけではない。Valsは、コンテキストウィンドウを100万トークン、重みを非公開としている。また、入力は100万トークンあたり$4、出力は$20(導入期間終了後の料金)と記載しており、後述するGoogleの標準料金と一致する。ベンチマークによってはプロバイダーやパラメーターが異なる可能性があるため、単一の数字を引用する前に各ベンチマークの設定を確認したい。
発表前のトラッカーは、料金とValsの更新より前の情報だ。ある詳細な分析では、いまだに価格は未公開だと記載されている。
API公開後の料金
Googleは発表と同時にCarbonの料金も公開した。導入期間中はArgonと同じ料金だ。導入期間がいつ終わるかは示されておらず、サブスクリプションやレート制限の詳細もまだない。
| トークン種別 | 導入価格 | 標準価格 |
|---|---|---|
| 入力 | $2.00 / 1M | $4.00 / 1M |
| 出力 | $10.00 / 1M | $20.00 / 1M |
| キャッシュ入力(入力料金から95%引き) | 約$0.10 / 1M | 約$0.20 / 1M |
キャッシュ入力の金額は、Googleがそのまま印字したものではなく計算値だ。$2の95%引きは$0.10、$4の95%引きは$0.20になる。コードコンテキストを繰り返し送る長時間のエージェント処理では、この割引の恩恵が大きい。ただし、出力料金は入力の5倍なので、請求額を左右するのは依然として出力トークンだ。
表示価格だけで予算を組むのは避けたい。測るべきなのは、採用できた結果1件あたりのコストだ。リトライ、破棄した出力、繰り返し送るコンテキスト、修正呼び出しを含む総支出を、採用できた結果の数で割って算出する。3回の修正パスが必要な安いルートより、1回で成果に到達する高いルートのほうが、結果的に安くなることは珍しくない。CarbonのレイテンシーやスループットはGoogleから公開されていないため、1秒あたりのトークン数を比較するのは推測にすぎない。
現在の請求事情については、Gemini 4 Argon APIの料金と提供状況およびGemini 4について分かっていることも参照してほしい。
初期テスターが不満を感じる理由
TestingCatalogの10月23日付けまとめに掲載されたリリース前テスターの報告には、同じトレードオフが表れている。Argonより3D生成は目に見えて改善した一方、応答は大幅に遅く、フロントエンドやUIの出力には引き続き弱さがある。あるテスターは、タスクによって応答が約2〜4倍遅いと見積もっている。
実際のユーザー間では、ベンチマーク以上にアクセスできないことへの不満が目立つ。
Googleのモデル公開戦略が本当に理解できない。gemini 4 carbonはベンチマークでは impressive に見えるのに、またしても誰も使えない。最初はアクセスが制限されていて、GAリリースの日付もない。
複数のスレッドで繰り返し語られているのは、Argonのクォータ消費が予測しづらいこと、5分のセッションで時間単位の上限に達すること、Geminiアプリ、AI Studio、Antigravityの間でエディションが分断されていることだ。別のテスターは、検証上の問題を次のように要約している。
今週アクセスできるのは審査済みのサイバー防御担当者だけで、より広い公開は「近日中」。私の見方では、メーカー独自のハーネス内で実行したリーダーボードは、結果の半分にすぎない。中立的な環境で誰かが実行するまで待つべきだ。
今週やるべきこと
Carbonを待って開発を止める必要はない。現実的な構成は、確認済みのモデルで今すぐ出荷し、新モデルは差し替え可能な候補として扱うことだ。
- 今日はドキュメント化されたAPIを使い、
gemini-4-argonで開発する。ベースURL、APIキー、モデルIDはビジネスロジックの外に置く。 - 自分のリポジトリから、バグ修正、リファクタリング、セキュリティレビューなど30〜50件の評価セットを作る。Carbonが使えるようになる前に、合格率、レビュー時間、採用結果1件あたりのコストを記録しておく。
- 数日単位の実行で必要になるエージェントのガードレールも、今のうちに追加する。ブランチ単位の作業、支出上限、ツール呼び出しの監査ログ、チェックポイント、人によるレビューゲートなどだ。
- アカウント向けのCarbonルートが正式に文書化されたら候補として追加し、同じ評価セットを再実行する。トラフィックを移す前に、品質、レイテンシー、コスト、ストリーミング、画像、関数呼び出し、構造化出力といった機能対応を比較したい。タスクの途中でモデルを切り替えず、新しいセッションを開始する。
AppSecの未処理案件を大量に抱えるチームは、すべてのツール呼び出しを記録し、自分のリポジトリでベンチマーク型の不正行為(ハードコードされた出力やテストファイルの編集)も検証すべきだ。Googleの0.0%はGoogleのハーネスで得たベンダー側の結果であり、自分の環境での保証ではない。
| 状況 | 今週やること |
|---|---|
| エージェントやセキュリティ支援ツールを出荷したい | API経由でArgonを使い、コストとレイテンシーを計測する |
| Carbonのサイバースコアだけが判断を阻んでいる | 公開された申請経路はない。GoogleのFairwindに関する発表を追う |
| Carbon、Opus 5.5、GPT-6.1 Terraから選びたい | 中立的な再評価を待つ。現時点のValsでは総合的にSonnet 5.5がCarbonを上回り、Opus 5.5はCarbonのすぐ後ろにいる |
| 価格重視の長文コンテキスト処理 | 最初からキャッシュ入力を前提に設計する。請求額を決めるのは出力長だ |
Gemini 4 Carbon FAQ
Gemini 4 CarbonはAPIで利用できますか?
一般公開はされていない。発表週のアクセスはサイバー防御担当者に限られ、その後Fairwindの信頼できるパートナーへ広がる。開発者、企業、一般ユーザー向けの時期は未定だ。Argonで開発を進め、モデルIDは設定で変更できるようにしておきたい。
Gemini 4 CarbonのモデルIDは何ですか?
Googleはまだ公開していない。gemini-4-carbonが動くと決めつけてはいけない。エンドポイント、権限、料金とともにプロバイダーが明示的に文書化しているIDだけを使うべきだ。
Gemini 4 Carbonの料金はいくらですか?
導入価格は入力が100万トークンあたり$2、出力が100万トークンあたり$10。キャッシュ入力は95%引きで約$0.10になる。その後の標準価格は入力$4、出力$20で、キャッシュ入力は約$0.20。導入期間の長さは示されていない。
CarbonはArgonと比べてどうですか?
Googleは、安全なコード生成が2倍超向上し、過剰対応が26%、対応不足が29%減少し、プロンプトインジェクション成功率が0.7%から0.0%になったと主張している。独立したValsのデータはCarbonだけを対象としているため、中立的な再評価が行われるまでは、Argonとの差分はベンダー内部の結果として扱いたい。
CarbonはClaude Opus 5.5やGPT-6.1 Terraを上回りますか?
直接比較で証明されたわけではない。リリース前の社員による印象として、GetAICodingAgentが報じた内容では、CarbonはコーディングにおいてOpus 5.5のように感じるとされている。Valsの総合スコアではCarbonが70.36%で、Opus 5.5の70.18%をわずかに上回る一方、Sonnet 5.5の70.85%は下回る。CarbonとTerraを管理された条件で比較した結果は公開されていない。
一般公開はいつですか?
Googleは、防御担当者とパートナー向けの段階を経た後、「可能な限り早く」提供するとしているが、日付は示していない。リーク情報のスレッドではなく、公式のDeepMindブログと、利用しているプロバイダーのモデルカタログを確認したい。