 AIREITER
カフェのメニューに価格を4つ入れるだけなら、簡単な作業に思えるかもしれない。ところが画像生成モデルは、そのうち1つを別の数字に変えてしまうことがある。MOSS Imageは、サイズから想像する以上にこうした文字を正しく再現する。ただし、構造化した指示を与え、デザイナーのように最後の校正を行うことが前提だ。
今回検証するのは、Apache 2.0で公開されたパラメーター数5Bのテキスト・画像モデルだ。最大4,096トークンのプロンプトを受け付け、テキストやオブジェクトの配置をJSON形式のバウンディングボックスで指定できる。OpenMOSSチームが2026年10月16日にBaseとSFTのチェックポイントを公開し、MOSIプラットフォームのホステッドAPIは10月20日に提供開始された。ポスター、メニュー、ラベル、インフォグラフィックなど、文言を正確に入れたい用途なら試す価値がある。一方、キャラクターの一貫性や写真編集が目的なら、クローズドモデルを選んだほうがいい。
最初の出力で方向性が見える:文字は残るが、美しさは保証されない
MOSS Imageの強みは、汎用的な美しさではなく、長く正確なテキストの描画にある。開発元によるLongLongTextBenchでは、全体の文字カバレッジが96.3 Mean-6。平均約1,340文字のタスク240件で、長文英語は97.1、長文中国語は92.4だった。GPT Image 2は99.0、Nano Banana Proは96.6と報告されている。ただし、これはベンダーが設計し、ベンダー自身が実施したベンチマークだ。保証ではなく、検証すべき主張として受け止めたい。
もう1つ注目すべき数字が、レイアウトへの追従性だ。本レビューで詳しく紹介している技術レポートによると、ボックス配置テスト7BenchでMOSS ImageはmIoU 0.88、Layout AUC 0.70を記録した。同じレポートではIdeogram 4が0.44と0.20、GPT Image 2が0.30と0.16で、MOSS Imageは大きく上回っている。RealLayoutArenaでは、ポスター、インフォグラフィック、UIを対象にしたブラインド評価61件で、プロンプト強化込みのMOSSシステムが1,698.70 Elo。GPT Image 2の1,844.35に次ぐ2位だった。すべての生成モデルに同じ強化済みプロンプトを与えた場合は、バックボーン単体が1位になる。こちらもベンダー実施の結果で、独立した再現検証はまだだ。
小規模な比較でも違いははっきりする。mossimage.runのチームは、同じ1024x1024のキャンバスと同じシードを使い、各プロンプトにつき1回だけMOSS Image SFTとFLUX.1 devを生成した。都合のよい結果だけを選ばず、失敗例も含めている。今回のレビューではMOSIのホステッドAPIのレイテンシーを再計測していない。以下の表は、同チームがfalのエンドポイント経由で得た初回出力をまとめたものだ。MOSI APIについてはドキュメントと無料期間中の課金状況を確認している。
| テスト | プロンプトの要求 | MOSS Image SFTの初回出力 | FLUX.1 devの初回出力 |
|---|---|---|---|
| カフェメニュー | MORNING MENUと、Espresso 3.50、Flat White 4.20、Butter Croissant 3.80、Avocado Toast 8.50を右揃えで配置 | 4項目と価格をすべて正しく再現 | レイアウトは明快だが、3.80が3.60になった |
| ハニーラベル | WILDFLOWER HONEY、Raw & Unfiltered、Net Wt. 12 oz (340 g)をラベルの曲線に沿って配置 | 3行とも正しく再現 | 見出しと重量は正しいが、中央の行がRaw & Unfilterelrdになった |
| バイリンガルポスター | 周末市集 / WEEKEND MARKET、Sat 10:00–18:00、Riverside Park、Free entry / 免费入场 | 中国語と英語の情報を正しく再現 | 構図は優秀だが、中国語が崩れ、10.00–178.00になった |
設定はMOSSが50ステップ、CFG 3、FLUXが28ステップ、guidance 3.5。使用したのはfal-ai/moss-imageとfal-ai/flux/devだ。3例だけで勝敗を決めることはできないと同ページも説明しているが、重要なのは失敗の種類である。見た目は説得力があるのに、価格や時刻が1つだけ変わっている画像は、明らかに破綻した画像より扱いにくい。
「5Bモデルとしては、MOSS Imageは構造化されたレイアウトと英語テキストをうまく処理できていた。細部まで毎回完璧ではないが、ようやく制御可能なワークフローになったと感じる」 — ポスター制作の一連の流れを動画で紹介した@Olaemmy1200
APIの中身は「小さな生成器」と「大きな読解器」
MOSS Imageは、ゼロから学習された42層のシングルストリーム拡散トランスフォーマーだ。5Bという数字は生成器だけの規模である。その周囲には、プロンプトを読み取る凍結済みのQwen3.5-9Bテキストエンコーダーと、画素を出力するFLUX.2 small-decoder VAEがある。長いバイリンガル文を理解できる理由は、5Bのデノイザーだけではなく、9Bの読解器にもある。強みと必要なハードウェアの大きさは、この分業から生まれている。
実用上の最大の武器はコンテキスト長だ。自然言語、タグ列、JSONレイアウトのすべてで最大4,096トークンを使えるため、ポスターの全文を短いキャプションに圧縮せず、1行ずつ指定できる。MOSI APIのドキュメントでは、ホステッド版の上限を文字描画対応の最大4,000文字の長文としている。ネガティブプロンプトとレイアウト生成にも対応する。出力は1~2メガピクセルが推奨で、512x512から2Kまで拡張でき、縦横のサイズは16の倍数にする必要がある。
結果を左右するチェックポイントは2つある。
- MOSS-Image-SFTは、厳選データで教師ありファインチューニングを施したBaseだ。OpenMOSSチームは直接生成にこちらを推奨しており、文字のまとまりが整い、レイアウトもきれいになりやすい。ホステッドAPIのデフォルトは
moss-image-sft-1.0で、再現性が必要な場合は固定スナップショットのmoss-image-sft-1.0-2026-10-09を使える。 - MOSS-Image-Baseは、ポストトレーニングとCFG蒸留を行わず、元の学習信号を保っている。公式ガイドはファインチューニング用途にこちらを案内し、テキストエンコーダーを凍結するよう推奨している。LoRAを学習したい場合や、異なるスタイル分布を試したい場合に選ぶモデルで、今日すぐポスターを作りたいときの第一候補ではない。
Hugging Faceのモデルカードと公式プロジェクトページによれば、両チェックポイントの重みと推論コード一式はApache License 2.0で公開されている。商用利用やファインチューニングは可能だが、キャンペーンで描画するすべてのキャラクター、ロゴ、人物の肖像まで許諾されるわけではない。商用案件ではライセンスファイルと正確なリビジョンを保存しておこう。コードはOpenMOSSのGitHubリポジトリにある。
このワークフローを試す価値はJSONレイアウトにある
自然言語だけでも生成できるが、デザイナーが注目する理由はレイアウト構文にある。構造化プロンプトでは、まずシーン全体を説明し、そのうえで各テキストやオブジェクトに個別のキャプションとボックスを割り当てる。ボックスは生成を誘導するもので、ベクターレイヤーでもピクセル単位の保証でもない。
最初につまずくのが座標のルールだ。bbox_coord_space: "abs_centralized"とbbox_format: "yxyx"を使う場合、各ボックスはキャンバス中央を基準にしたピクセル座標で、[y_min, x_min, y_max, x_max]の順に指定する。1024x1024の画像では、各軸が-512から+512までになる。通常の左上原点の座標や、コミュニティで使われる0~1000のレイアウトを、変換せずにこのスキーマへ貼り付けてはいけない。
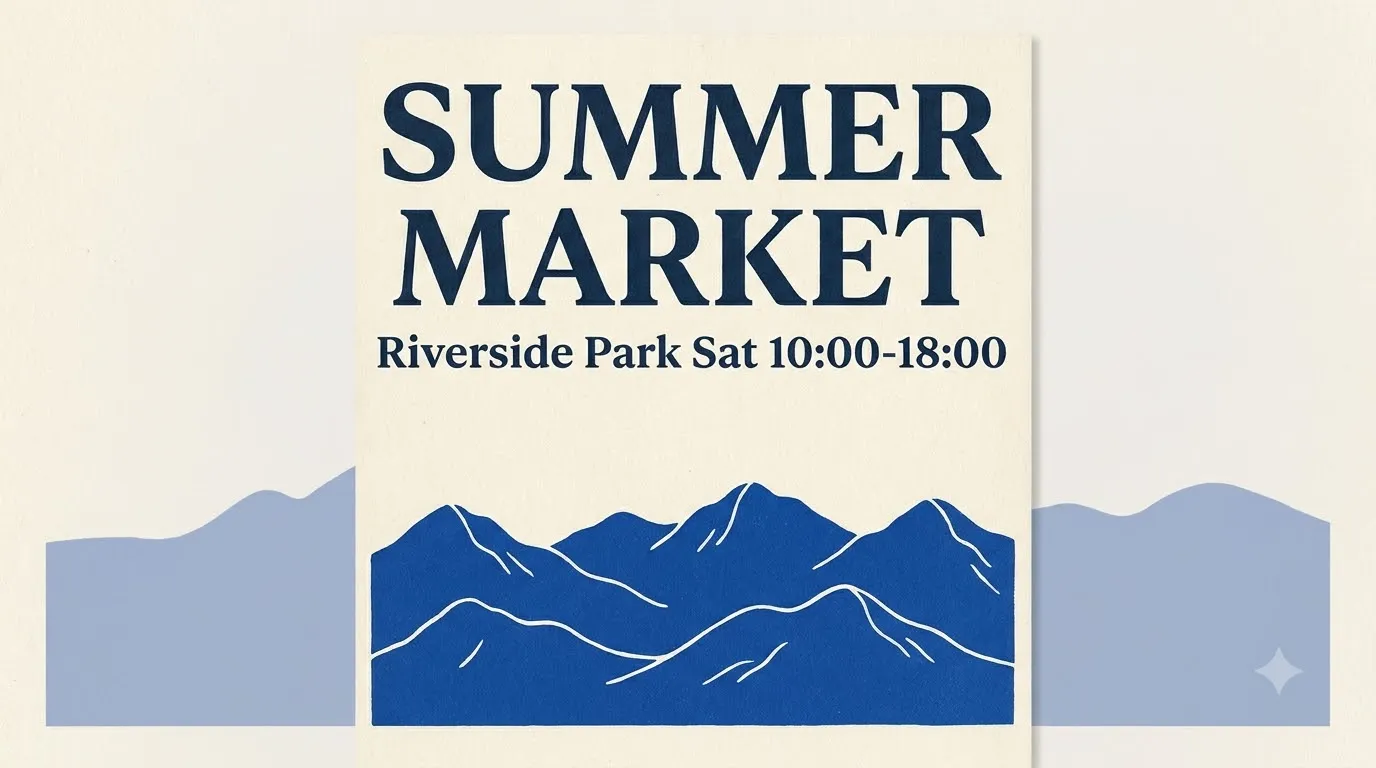
タイトルを上、イラストを下に置く最小構成は次のようになる。
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
要素20個のインフォグラフィックで、ボックスを人間が1つずつ手入力するのは現実的ではない。初期ユーザーが実践しているのは、画像を理解できるLLMにブリーフやスケッチからJSONを作らせ、生成前に座標を修正する方法だ。日本のテスターである@chimolog7も、bbox形式は人間には難しすぎるためOpusに生成させたと説明している。その結果、Krea 2ではまだ頻繁に誤字が出たのに対し、日本語の描画は体感でわずか1%程度の誤字だったという(投稿)。
もう1つのコツは、変更箇所を限定した再生成だ。MOSS Imageは画像入力に対応しないテキスト・画像モデルなので、写真をimg2imgにかけて維持することはできない。その代わり、1つのボックスの文言や位置だけを変更し、同じシードで再生成すれば、ほかのレイアウトをおおむね保ったまま修正できる。ユーザーの@li9292は、数千文字の中国語と20個のボックスを使った週次レポートの表紙で、同じシードのまま1つのボックスだけを編集し、残りのレイアウトを維持する様子を示した(投稿)。正確な文言を扱うなら、スタイルプリセットよりも、この「1ボックスだけ変更して同じシードで再生成」するループのほうが重要だ。
文字描画全般の比較については、2026年に文字描画に強い画像モデルの検証でも、なぜこの分野にレイアウト優先の選択肢が必要だったのかを確認できる。
呼び出し方と「無料」の実際のコスト
ホステッド版は1つのエンドポイントから利用する。MOSI APIのドキュメントでは、moss-image-sft-1.0向けにPOST /v1/images/generationsを提供している。入力はテキスト、出力は画像のみで、画像入力、音声や動画、ストリーミング、非同期タスクAPIには対応しない。プロンプト強化機能は組み込まれているがデフォルトでは無効で、prompt_enhance: trueにすると有効になる。強化器のバージョンはサーバー側で選択される。
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
}'ボックス単位で制御したい場合は、完全なJSONレイアウト文字列をpromptに渡す。上の自然言語形式は、もっとも簡単にコピー&ペーストできる呼び出し方だ。
確認時点の課金表示はFree for a limited time、つまり0 creditsで、終了後の料金についてはフルプライシングへのリンクが用意されていた。BaseとSFTの比較ガイドも同じ状況を伝えている。プレイグラウンドは10月20日から稼働しているが、画像1枚あたりの恒久的な価格は公開されていない。試作段階では無料期間を使い、その後はプロバイダー料金に加えて、誤字によるリテイク率も含めて予算を組むべきだ。
ローカル推論なら画像ごとの利用料はかからないが、ハードウェアコストは現実に発生する。10月20日に確認されたComfy-Orgのファイル一覧では、環境やキャッシュを除いてBF16の重みが合計約29.72 GB。内訳はバックボーン約10.16 GB、テキストエンコーダー約19.31 GB、小型VAE約0.25 GBだ。INT8 ConvRotを使うとトランスフォーマーの容量はおよそ半分になり、バックボーンは約5.41 GB、エンコーダーは約9.75 GB。W4A8 GPTQエンコーダーなら約7.34 GBという選択肢もある。
| 構成 | ダウンロードするもの | 実用上の注意 |
|---|---|---|
| フルBF16 | 29.72 GBの重み+作業用メモリ | オフロードなしでは32 GBでも厳しい。システムRAMとプロンプト長も影響する |
| INT8量子化 | 約15 GBクラス+オフロード | 約1 MP、1バッチ1画像で動く12 GB構成が文書化されている(本レビューで引用したコミュニティテストではピーク約9.7 GB)。8~12 GBのGPUならまずはこちらから |
| コミュニティ製8ステップDMD / 4ステップ | アダプター+対応ワークフロー | 同じ1 MP・RTX 3060の報告では約24秒対約137秒。ただし初期アダプターは細部を失っていたため、まず50ステップの基準値を確認したい |
公式のサンプリング基準は、1024x1024でEuler、50ステップ、CFG 3.0、shift 5.0、22層目のskip-layer guidanceだ。ComfyUIのネイティブ対応は10月16日にマージされた(告知)。ComfyUIを更新し、テンプレートでMOSS-Imageを検索しよう。プラグインのグラフとネイティブローダーを混在させず、Comfy-Orgのファイルに対応したBaseまたはSFTのワークフローを使うことが重要だ。
プロバイダー料金を広く比較したい場合は、最安の画像生成APIの解説も、GPU時間とリテイクを含めたコスト計算の基準になる。
それでもクローズドモデルが上回る領域
この構成に作品制作を任せる前に、明示されている制限を理解しておきたい。公開版はテキスト・画像生成専用で、画像編集にも参照画像入力にも対応していない。参照画像ベースの生成は今後の課題として挙げられている。アップロードした写真を保持したり、複数カットで同じキャラクターを維持したりする必要があるなら、制作向けの編集機能を備えたQwen Image 2.1のようなモデルを選ぶべきだ。
人物表現と仕上がりの好みも弱点になる。5B規模では顔が generic に見えたり、プロポーションが崩れたりしやすく、手もおなじみの破綻を繰り返す。
「キャラクターのプロポーションもうまく扱えない。典型的な『手がおかしい』問題なども、決して得意ではない」 — @SlipperyGem
紹介した実地テストから、公開前に確認すべき項目も見えてくる。短いプロンプト、固有名を持つキャラクター、アーティストタグ、厳密な制約は安定しない。小さな文字には校正工程が必要で、英語と中国語以外の言語は手動チェックが欠かせない。公式の50ステップ設定は控えめなハードウェアには重く、高速アダプターは速度と引き換えにライティングのニュアンスや制約への追従性を失う。採用する画像ごとに、チェックポイント、エンコーダー、VAE、精度、プロンプト、シード、エンコードを含む所要時間を記録しておこう。
速度を重視したローカル運用の測定結果も、ハードウェア面で同じことを示している。Luceboxの測定では、独自カーネルを使ったRadeon AI PRO R9700で、CFG 1・8ステップ・1024x1024の生成が2.7秒。DGX Spark上のComfyUIよりエンドツーエンドで1.8倍高速だった。ただし目視確認では、CFG 1で8枚中4枚が形状不良。CFG 2.5では8枚中1枚に減ったものの、所要時間は5.2秒になった。速ければ自動的に使いやすい、というわけではない。
MOSS Image API FAQ
MOSS Imageは商用利用できますか?
重みと同梱コードはApache 2.0で公開されており、ライセンス料なしで商用利用とファインチューニングができる。ホステッドエンドポイントの料金とコンテンツルールは各サービスが定め、第三者が提供する量子化版やLoRAにはそれぞれの条件が適用される。
BaseとSFTでは、APIにどちらを使うべきですか?
ホステッドAPIが提供するのはSFT(moss-image-sft-1.0)で、生成向けにチームが推奨しているファインチューニング済みチェックポイントだ。今すぐポスターや情報グラフィックを作るならSFT、ファインチューニングやLoRAの学習ならBaseを選ぶ。
12 GBのVRAMで動きますか?
量子化ワークフローとCPUオフロードを使い、約1 MP・1バッチ1画像という条件なら、12 GB構成で動作することが文書化されている。
写真を編集したり、キャラクターを完全に同じに保ったりできますか?
できない。公開されているバックボーンは参照画像を条件として受け取らない。同じシードでJSONを編集して再生成することはできるが、アップロードした写真を保持したり、人物の同一性を保証したりする機能ではない。
MOSS Imageを次に試すべき人
| 用途 | MOSS Imageを選ぶケース | 別のモデルを選ぶケース |
|---|---|---|
| 正確な文言を含むポスター、メニュー、スライド、UIモック | 写実的な人物よりも、長いバイリンガルテキストとボックス単位の配置が重要 | 短いキャッチコピーだけなら、プロンプトを作りやすいクローズドモデルのほうが速い |
| ECや編集の制作パイプライン | LLMからJSONを作る工程と校正工程を追加でき、Apache 2.0の重みをセルフホストまたはファインチューニングしたい | 今すぐimg2img、インペイント、参照画像で固定したキャラクターが必要 |
| 予算を抑えたいローカル開発 | 量子化込みの12 GB構成を許容できる、またはMOSIの無料期間で試作できる | 処理量、ストリーミング、非同期タスクを保証したい。現時点でホステッドAPIはどれにも対応していない |
レイアウトを指定できる文字中心のデザインなら、MOSS Imageは制約システムそのものが製品になっている珍しいオープンモデルだ。一方、同じ顔を同じ顔として維持する必要がある作業では、置き換えではなく、クローズド画像モデルと組み合わせるタイポグラフィエンジンとして扱うのが現実的だ。