 AIREITER
Eleven v3は2026年2月2日にアルファ版を終え、GAへ移行しました。ElevenLabs APIで指定するモデルIDはeleven_v3です。料金はElevenLabsとfal.aiのどちらも1,000文字あたり$0.10。単価だけでは選べず、課金形態、並行実行数、利用できる音声が判断材料になります。GAによって実用面も改善されました。GA発表によると、27カテゴリ・8言語のベンチマークで構造化テキストのエラー率は15.3%から4.9%へ低下しています。ただし、1リクエスト5,000文字という上限と、ElevenLabs自身がリアルタイム用途には不向きとしている点は、設計時に押さえておくべき制約です。
ElevenLabs Eleven v3 APIでできること
Eleven v3 APIには、通常の音声生成とストリーミング音声生成に加え、複数話者向けのcreate-dialogue/stream-dialogueエンドポイントがあります。70以上の言語に対応し、テキスト中へオーディオタグを埋め込めば、感情や話し方も指示できます。GA時点では安定性も上がっており、ElevenLabsの社内テストでは72%のケースでアルファ版より好まれる結果でした。
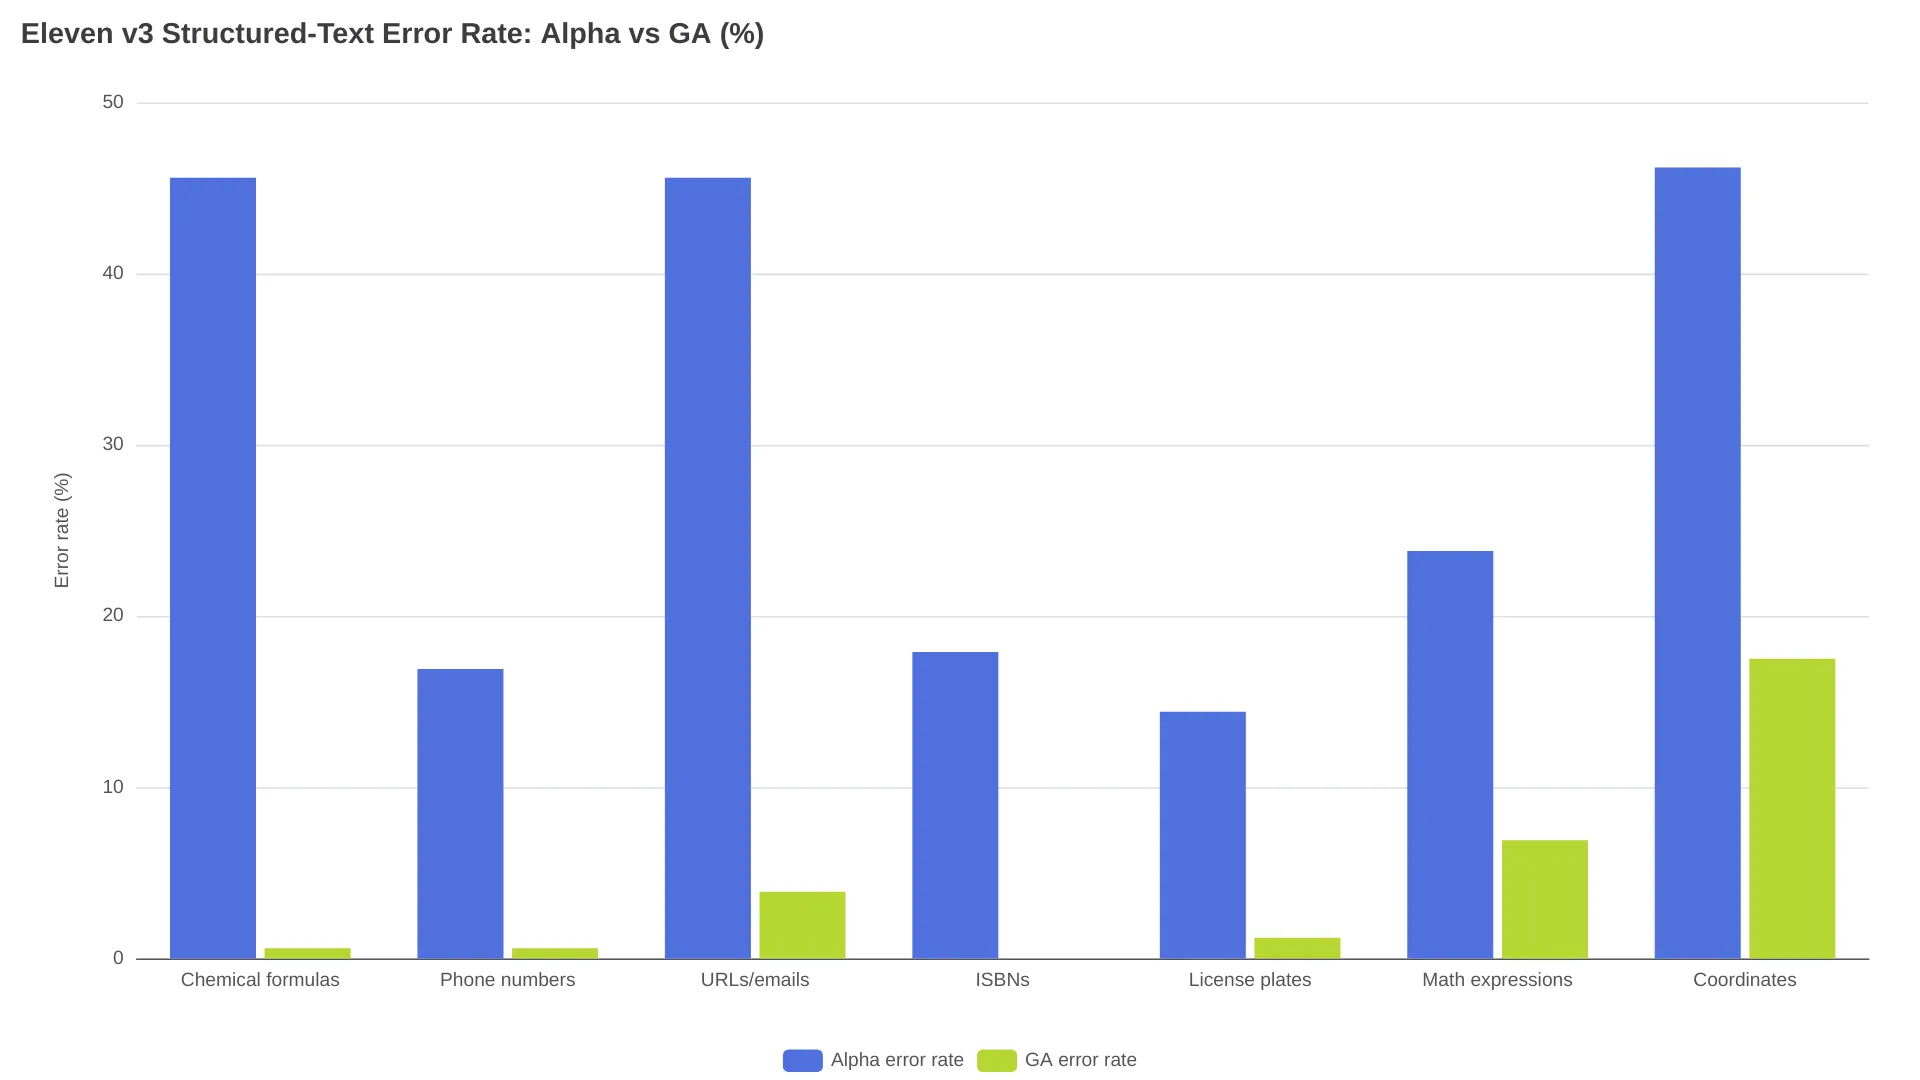
構造化テキストを扱うなら、ベンチマークのカテゴリ別結果も確認しておきたいところです。化学式はエラー率45.6%から0.6%へ、電話番号は16.9%から0.6%へ改善し、ISBNはエラー率ゼロになりました。一方で地理座標は17.5%と依然として弱く、数式も6.9%です。通常のナレーションなら十分でも、座標を多く含むコンテンツにはリスクがあります。
公式モデルリファレンスに基づくと、Eleven v3と近いモデルの位置付けは次のとおりです。
| モデル | モデルID | 対応言語 | 1リクエストの最大文字数 | 公称レイテンシ | 1,000文字あたりの料金 |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5,000(約5分) | 約250〜300 ms(ティア別) | $0.10 |
| Eleven v3 Conversational | Text-to-Dialogue WebSocket経由 | 70+ | 該当なし | 約280 ms | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10,000(約10分) | 約250〜300 ms | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40,000(約40分) | 約75 ms | $0.05 |
ドキュメントには注意すべき食い違いがあります。料金ページでは「Multilingual v2/v3」が40,000文字のティア上限としてまとめられていますが、モデルリファレンスではEleven v3固有の上限を5,000文字としています。v3ではモデル別の値である5,000文字を正として扱うべきです。40,000文字を前提にした長文パイプラインは失敗します。
料金比較:公式ElevenLabsとfal.ai
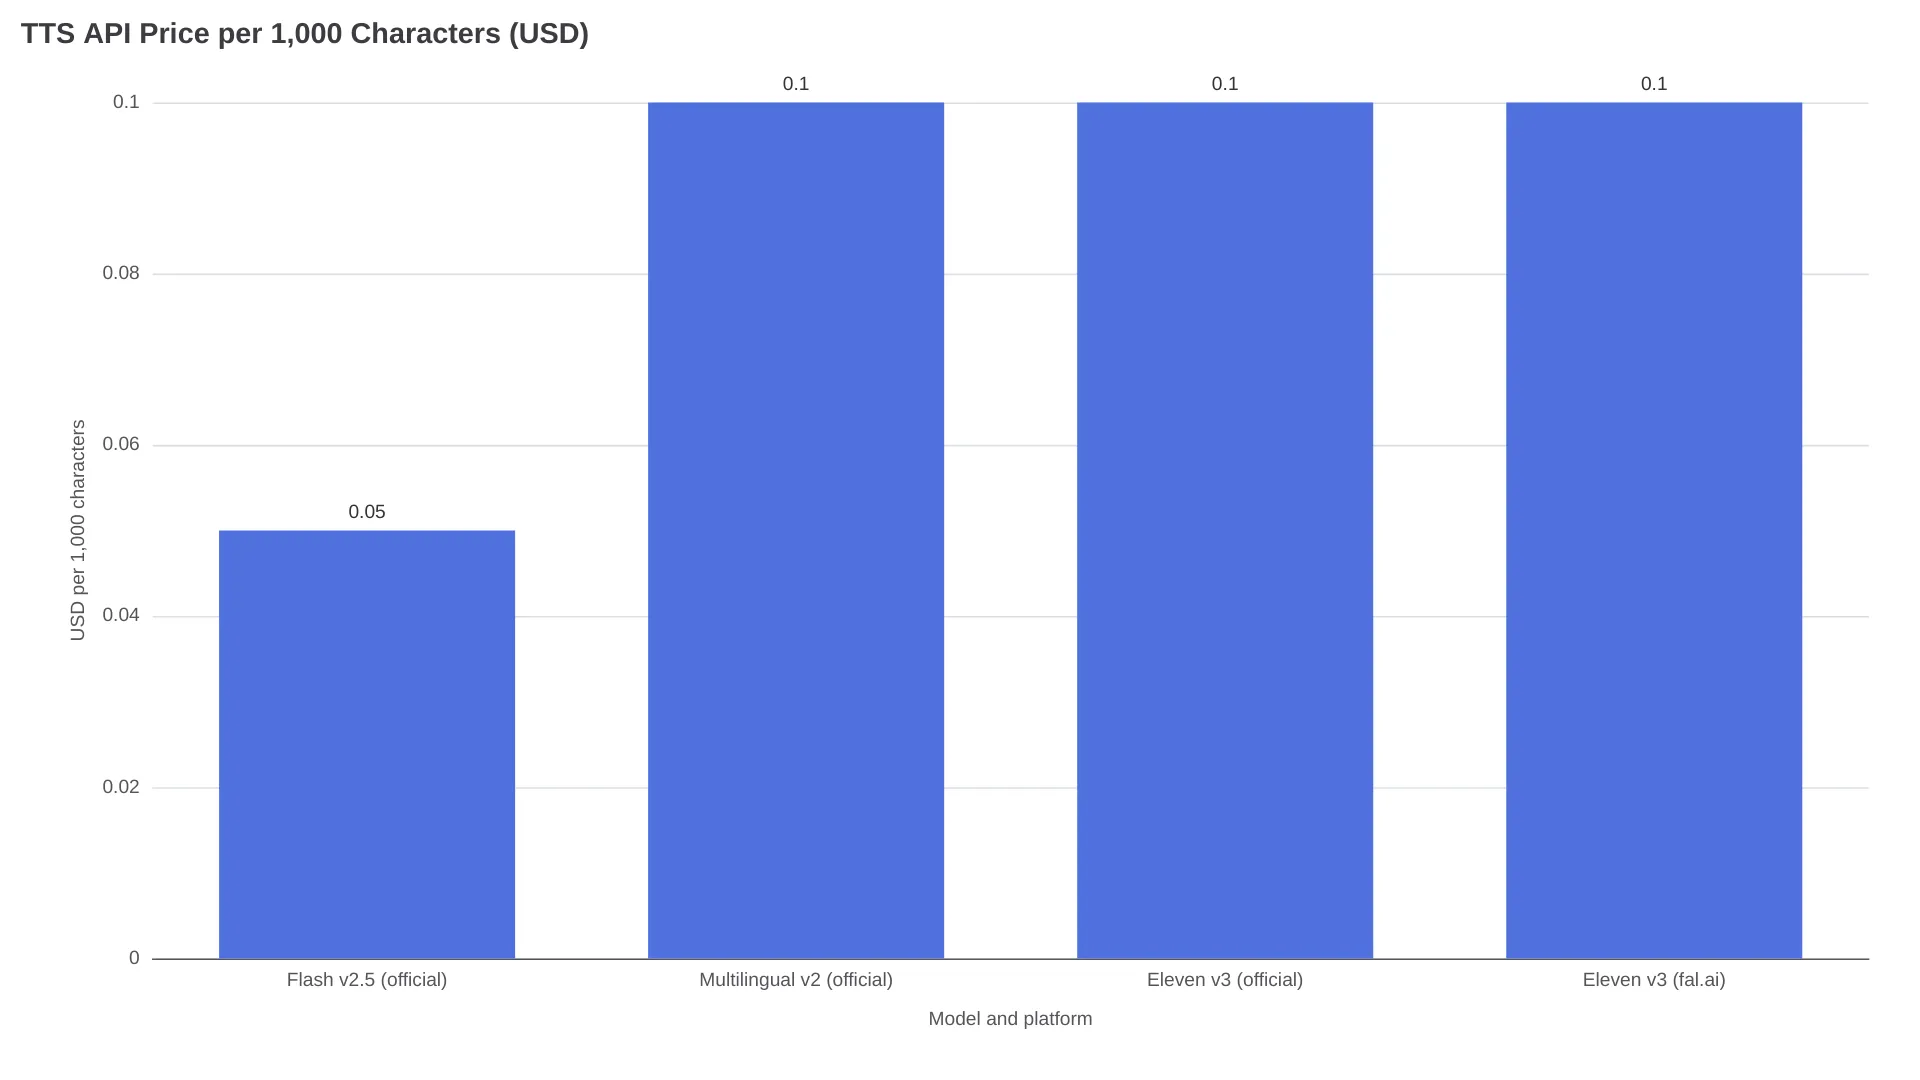
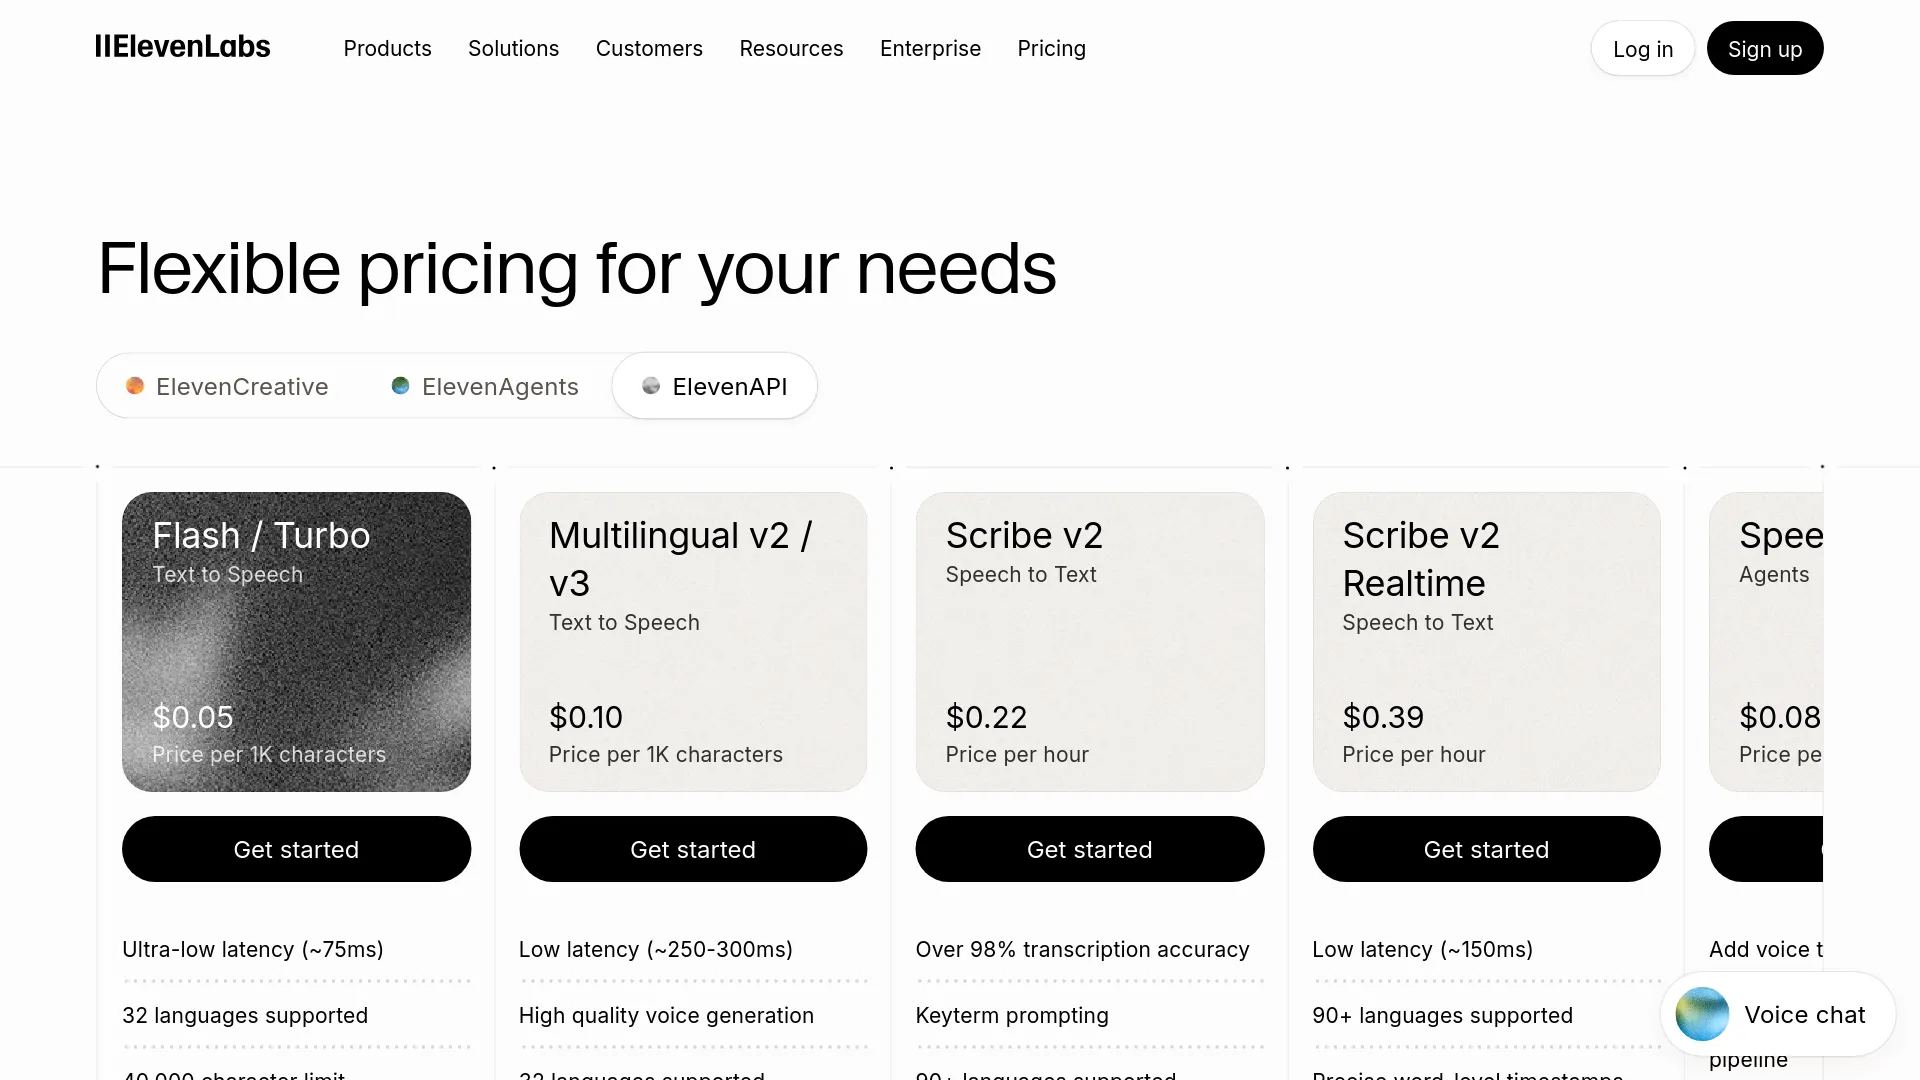
Eleven v3の単価は両者とも1,000文字あたり$0.10です。同じファミリーで安いのは、$0.05/1,000文字のFlash v2.5のみ。違いが出るのは、請求方式と並行実行の仕組みです。
| ElevenLabs公式 | fal.ai | |
|---|---|---|
| 単価(Eleven v3) | $0.10 / 1,000文字 | $0.10 / 1,000文字 |
| 課金方式 | クレジット込みのサブスクリプション、または従量課金 | 完全従量課金。「シートライセンス、サブスクリプション、最低利用額なし」 |
| 無料枠 | 月10k Multilingual文字(Flashは20k) | モデルページに記載なし |
| プラン例 | Creator:月額$22(初月$11)、220k Multilingual文字 | 該当なし |
| 最上位プラン | Business:月額$990、9.9M Multilingual文字 | 該当なし |
| 並行実行数 | プラン連動。FreeはMultilingual同時2リクエスト、Scale/Businessは15〜30、Enterpriseは個別設定 | サーバーレスキュー方式。モデルページにはアカウント単位の上限記載なし |
| キュー待ち時の影響 | 上限超過分はキューに入り、「通常」約50 ms追加 | バッチ処理用のWebhook対応Queue API |
| 指定可能な項目(文書化されたスキーマおよびユーザー報告) | IDで音声を指定。stabilityはv3で3段階とのユーザー報告あり | 音声、stability、similarity_boost、speed、language_code、apply_text_normalization、seed、timestamps、output_format |
| スタートアッププログラム | 12か月無料、33M文字、より高い並行実行数 | 該当なし |
公式APIでは、プランティアによって並行実行数が決まります。Freeキーでv3を並列実行すると同時リクエストは2件までとなり、バッチ処理では大きなボトルネックです。falはこの用途を意識したサーバーレスキューとWebhookコールバックを提供しています。なお、空白や角括弧のオーディオタグが課金文字数に含まれるかどうかは、どちらの料金ドキュメントにも明記されていません。予算は含まれる前提で見積もるのが無難です。
v3をたまに使う程度で、すでにfal上でほかのモデルも動かしているなら、プラットフォームとしての判断材料はfal.aiレビューでも確認できます。
オーディオタグで感情と演技を指示する
オーディオタグは、テキスト内に角括弧で挿入する指示です。読み上げる文字ではなく、演技指示としてモデルに解釈されます。falのモデルページにある最小例は以下です。
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| カテゴリ | 使える例 |
|---|---|
| 感情 | [happy]、[sad]、[excited]、[angry]、[sarcastically]、[nervous]、[happily] |
| 話し方 | [whispers]、[shouting]、[shouts]、[slowly]、[quickly]、[softly] |
| 非言語音 | [laughs]、[chuckles]、[sighs]、[gasps]、[coughs]、[gulps]、[clears throat]、[applause] |
| アクセント | [british accent]、[southern accent]、[strong canadian accent] |
公式のプロンプティングガイドでは、タグの挙動について3点が示されています。第一に、正式なタグ一覧はありません。タグは自然言語による演技指示であり、公開例以外にも有効な表現があるため、暗記よりテストが重要です。第二に、SSMLのbreakタグはサポートされません。間は句読点、三点リーダー、改行で作ります。第三に、効果は音声と文脈によって変わります。実際に問題が起こりやすいのも、この最後の点です。
「V3 is amazing, certainly the most human sounding」 「it still feels like a Beta release to me」 — u/ConcertNeat8147、同一投稿からの2つのコメント、r/ElevenLabsのv3使用レポート
同じスレッドでは、ソフトウェアエンジニアとして20年の経験を持つu/poundingCodeが、感情タグを加えると話者のアクセントがまったく別のものに変わる場合があると報告しています。ElevenLabsのスタッフアカウントは「これらはすべて現在対応を進めている」と返答しました。
同スレッドでクリエイターが共有していた対処法です。公式ガイダンスではなく、コミュニティでの使用経験として捉えてください。
- ウォームアップ用の一文を置く。 トーンと声の高さを決める捨て文を冒頭に追加し、後処理でカットします。生成開始から数秒で声が「落ち着く」ことが多いようです。
- 末尾に
end.を足す。 本文の後に改行とend.を追加し、語尾が切れるのを防ぎます。音声からは後でトリミングします。 - 文末を三点リーダーで閉じる。 文末を「...」にすると、単語の終わりで切れる問題が減るという報告があります。
- stabilityを最大にする。 v3のstabilityは3段階で、最大設定にすると生成冒頭の声質ドリフトが抑えられます。
統合設計に効く制約
- 最大の制約は5,000文字上限。 1リクエストで出せる音声は約5分までです。オーディオブックや長尺コンテンツではテキストを分割する必要があります。節の途中ではなく、文または段落の境界で分け、タグは指示対象と同じチャンクに入れてください。より大きな単位で呼び出したいなら、Multilingual v2は10,000文字まで対応します。
- 公式APIの並行実行数はプラン依存。 モデルリファレンスによれば、FreeキーではMultilingualティアで同時2リクエスト、Flashでは4リクエストです。ScaleとBusinessは15〜30、Enterpriseは個別交渉となります。上限を超えたリクエストはキューに入り、「通常」約50 msが追加されます。同ページにはElevenLabsの容量目安もあり、会話型ワークロードでは並行実行数5でおよそ100件の同時音声配信を支えられるとしています。1リクエストあたりのペナルティは小さくても、バッチ規模ではキャパシティ不足が大きな痛手になります。
- falは最大入力サイズを記載していない。 Eleven v3のページにはエンドポイント、パラメータ、出力形式はありますが、入力上限、キュー保持期間、リトライ動作は明記されていません。長文を送信すること自体は止められませんが、処理が保証されるわけでもありません。
- タイムスタンプ対応はプラットフォームで異なる。 falの入力スキーマには、単語単位のアラインメントデータを返す
timestampsブール値があります。字幕やリップシンクに便利です。公式APIでは、v3のダイアログ出力にタイムスタンプがありません。この点は開発者からも公開で指摘されています(r/ElevenLabs: 「v3 API, no timestamps?」)。現時点でアラインメントデータを得る文書化された経路はfalのパラメータです。
- リアルタイム用途はまだ対象外。 ElevenLabsは、レイテンシが高く一貫性も変動するため、v3はリアルタイムおよび会話用途に適さないとしています。認可された選択肢は、エージェント向けのFlash v2.5(約75 ms)、または表現力を対話コンテキストでも維持したい場合のEleven v3 Conversational(WebSocket経由、約280 ms)です。リアルタイム版v3は「開発中」とロードマップで示されていますが、GA発表時点では提供されていません。
- 商用利用。 アルファ期間中はv3の出力を商用利用できるか、開発者から公開で質問がありました。GA発表では全プラットフォームへの展開が案内され、falもエンドポイントを商用利用向けと明示しています。
最初のリクエスト:公式SDKとfalクライアント
まずは公式クイックスタートの手順です。
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # または ELEVENLABS_API_KEY 環境変数
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)falでは、fal.runエンドポイントに対してfal-clientを使用します。
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # デフォルト音声
"stability": 0.5, # 0〜1。低いほど表現の揺らぎが大きい
"timestamps": True, # 単語単位のアラインメントデータ
},
)
print(result["audio"]["url"]) # ホスト済みMP3のURLどちらのプラットフォームも、クライアントサイドコードにAPIキーを埋め込まないよう明示的に警告しています。リクエストは自分のサーバー経由でプロキシしてください。ストリーミングについては、公式APIにstream-speechエンドポイントがあり、falではfal.streamを利用できます。falはバッチ処理用にWebhook対応のQueue APIも提供します。
どのエンドポイントを使うべきか
| 状況 | 選ぶべき呼び出し先 |
|---|---|
| 自分でクローンした音声(PVC/IVC)や、ID指定のデザイン音声が必要 | 公式API:カスタム音声はワークスペース内のIDで参照します。falのページで文書化されているのはプリセット音声名のみです |
| すでにクレジット込みのElevenLabsプランを契約している | 公式API:含まれる文字数はすでに支払済みであり、falでは呼び出すたびに新たな費用が発生します |
| サブスクリプションなしで、オーディオブックや吹き替えをバッチ処理し、完了Webhookも欲しい | fal:従量課金のキューとWebhookフローはこの用途に適しています |
| 画像、動画、TTSを同じスタック・同じAPIキーで扱いたい | fal:v3もほかのfalモデルと同じクライアントで実行できます |
| 音声エージェントなど、レイテンシが重要な用途 | どちらのv3 TTSエンドポイントも不向き:Flash v2.5(約75 ms)またはEleven v3 Conversational(約280 ms)を使います |
| Enterprise要件(SOC 2、HIPAA BAA、カスタムレート制限、IP許可リスト)がある | 公式API:料金ページにEnterpriseプランの機能が記載されています。falのモデルページでは、どの認証がこのエンドポイントに適用されるか明記されていません |
FAQ
Eleven v3のモデルIDは?
eleven_v3です。標準のテキスト読み上げエンドポイントではmodel_idとして渡します。複数話者のダイアログではモデルパラメータではなく、専用のText-to-Dialogueエンドポイントを使用します。
Eleven v3 APIはストリーミングに対応している?
対応しています。公式APIには生成中の音声を返すstream-speechエンドポイントがあり、falも同モデル向けにfal.streamを提供します。ただし、ストリーミングを使ってもv3がリアルタイム用途向けになるわけではありません。公式ガイダンスでは、会話用途にはFlash v2.5またはEleven v3 Conversationalが案内されています。
Eleven v3の文字数上限は?
公式モデルリファレンスでは、1リクエスト5,000文字、音声にして約5分です。料金ページの40,000文字という数値はMultilingualティアのグループに対するもので、v3個別の上限ではありません。
Eleven v3 APIの料金はいくら?
どちらの経路も1,000文字あたり$0.10です。10,000文字のストーリーなら$1.00、100万文字のオーディオブックなら$100になります。公式ではプランのクレジットで相殺できます。Creatorは月額$22で220k Multilingual文字を含みます。一方、falにサブスクリプションはありません。
Eleven v3でクローン音声は使える?
公式APIでは利用できます。プロフェッショナル音声、クローン音声、デザイン音声はいずれもvoice IDで参照します。ただし実用上の互換性には差があります。r/ElevenLabsでは、既存のProfessional Voice Cloneがv3では別人のように聞こえるケースが報告されている一方、作成者がV3互換と明記したPVCは比較的安定しやすいとされています。falのスキーマは音声名またはIDを受け付けますが、文書化されているのはプリセット音声だけです。そのため、非公開のElevenLabs音声IDをfalで使うのは未文書化の領域です。
Eleven v3はリアルタイム音声エージェントに向いている?
いいえ。ElevenLabsは、レイテンシが高く一貫性が変動するため、v3をリアルタイムおよび会話用途には不適と明記しています。Flash v2.5(約75 ms、32言語)またはEleven v3 Conversational(約280 ms、70以上の言語、オーディオタグ制御)を使ってください。
API経由のEleven v3がWebサイト上の音声と違って聞こえるのはなぜ?
音声プレビューは、自分のテキストを入力した際の出力を必ずしも代表しません。これはr/ElevenLabsの使用レポートで繰り返し挙がっている不満です。また、v3の出力は生成ごとの差も目立ちます。採用を決める前に、候補となる各音声を実際のスクリプト断片と本番のstability設定でテストしてください。
関連記事:Qwen Audio 3 TTS APIガイド · Replicateの料金と代替サービス · fal.aiレビュー 2026