 AIREITER
1450億パラメータのモデルをノートPC上で毎秒80トークン――Edge0-145Bが掲げる数字はかなり強烈です。重み自体は公開されていますが、実際に動かすにはCUDA 13対応のNVIDIAデスクトップGPUと、約105GBのSSD容量が必要になります。
この記事では、公式ローンチブログ、モデルドキュメント、Q3_Kのモデルカード、さらに初期のコミュニティ報告を突き合わせます。ダウンロードする前に、ローカル実行が向いているのか、それともAPIを使うべきなのか判断できるように、発表内容と実際の必要スペックを整理します。
11月12日に公開されたもの:重み、推論エンジン、制約
Edge0は2026年11月12日、Edge0-145BとEdge0-120Bを公開しました。重みはEdge0-145B-q3kとEdge0-145B-NVFP4で配布され、推論エンジンのedge0-strataはEdge0-AI/Edge0にあります。
Edge0-145Bはテキスト専用の潜在Mixture-of-Expertsモデルで、コンテキスト長は256K。Qwen3.8-Flash-Nextをベースに、4ビットでネイティブ学習されています。1トークンあたり実際に有効化されるパラメータは約101.2億なので、総パラメータ数が1450億あっても、1450億すべてをVRAMに載せる必要はありません。
内訳は、約846億のエキスパートパラメータ、SSDからメモリーマップして使う512億パラメータのPLE n-gramテーブル、投機的デコーディング用の12.6億パラメータのドラフトヘッド、そして6GBのスケルトンです。Q3_Kは40.81GiBの重みを含み、リポジトリ全体は105.4GB。NVFP4は47.79GiBの重みで、リポジトリ全体は112.9GBあります。ルーティングされるエキスパートは、汎用的なGGUFではなく、独自形式のexperts.binパックに収められています。
「29GBで動く」は、29GBだけで済むという意味ではない
公式ブログには、ピーク時の使用量として29GBと書かれた箇所と、28GBと書かれた箇所があります。そこでは、プリフィルが毎秒1,100トークン以上、デコードが毎秒80トークン以上、消費電力が120Wとも説明されています。一方、Q3_Kのモデルカードでは、RTX 5090 D上でVRAM 23.14GiBに加えてホストRAM 31.28GiB、NVFP4ではVRAM 23.25GiBとRAM 38.27GiBが必要とされています。エキスパートライブラリはRAM上で約40GBを使い、約48GBの語彙データをSSDからストリーミングします。
よく使うエキスパートはVRAMに常駐し、次に使うエキスパートはRAMに置かれます。51.2GBのPLEテーブルは必要に応じてSSDから読み込まれます。狭い意味でのアクティブな常駐量は29GB前後に収まるとしても、保存領域とストリーミングのために、リポジトリ全体を用意しなければなりません。
| その数値が示すもの | 容量 | 保存場所 |
|---|---|---|
| ブログ記載のピークメモリ | 28~29GB | アクティブ常駐量。測定方法は未記載 |
| Q3_Kのダウンロード容量 | 105.4GB | NVMe SSD、PLE 51.2GB + experts.bin 40.1GB |
| NVFP4のダウンロード容量 | 112.9GB | NVMe SSD、PLE 51.2GB + experts.bin 47.6GB |
| 5090 Dで測定したQ3_Kの常駐量 | VRAM 23.14GiB + RAM 31.28GiB | 推論中のVRAMとシステムRAM |
| 5090 Dで測定したNVFP4の常駐量 | VRAM 23.25GiB + RAM 38.27GiB | 推論中のVRAMとシステムRAM |
Edge0-145Bを動かすために実際に必要なもの
Edge0-145Bは、edge0-inferを使い、NVIDIA GPUとCUDA 13を搭載したLinuxまたはWindows環境で動作します。公開ファイルには、標準のllama.cpp、Ollama、LM Studioから読み込むための経路がありません。スケルトンGGUFにはルーティングされたエキスパートの重みが含まれず、Edge0が案内しているのもedge0-inferだけです(詳しくはリポジトリの手順を参照)。そのため、llama.cpp v1.0ガイドの手順はそのまま使えません。
公式ブログでは初日からmacOSとMacBook Proに対応するとしていますが、プラットフォーム表でEdge0-145BとEdge0-120B向けに記載されているのは、CUDA 13を使うLinuxとWindowsだけです。
テスト済みの最低構成は、VRAM 16GiBとRAM 20GiB。Q3_Kでエージェントデコード毎秒44.9トークンでした。推奨構成は、24GBのNVIDIA製カード、32GBのシステムRAM(48GBあればより余裕あり)、空き120GBのNVMe、そしてCUDA 13、CMake、Ninja、uvです。ビルドとサーバー起動はリポジトリの手順に従います。
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B" # :8000Windowsユーザーは、GitHub ReleasesからEdge0 Chat app v0.2.0を入手できます。AMD環境は手動対応が必要です。u/UghrUghrは、Windows 11上のRX 7900 XTXでビルドとランタイムに約35行の変更が必要だったとr/LocalLLaMAのスレッドで報告しています。CUDA向けに融合されたカーネルが使えないため、より遅いフォールバックが動作します。
Q3_KとNVFP4、どちらをダウンロードするべきか
標準として考えやすいのは105.4GBのQ3_Kです。Edge0の表では、5090 D上でエージェントデコード毎秒121.2トークンとなっています。NVFP4は112.9GBで、同じカードではBlackwell向けの最適化により毎秒98.3トークンを狙う構成です。Blackwell世代のハードウェアを持っていないなら、まずはQ3_Kから試すのが無難です。
実際のGPUではどの程度の速度が出るのか
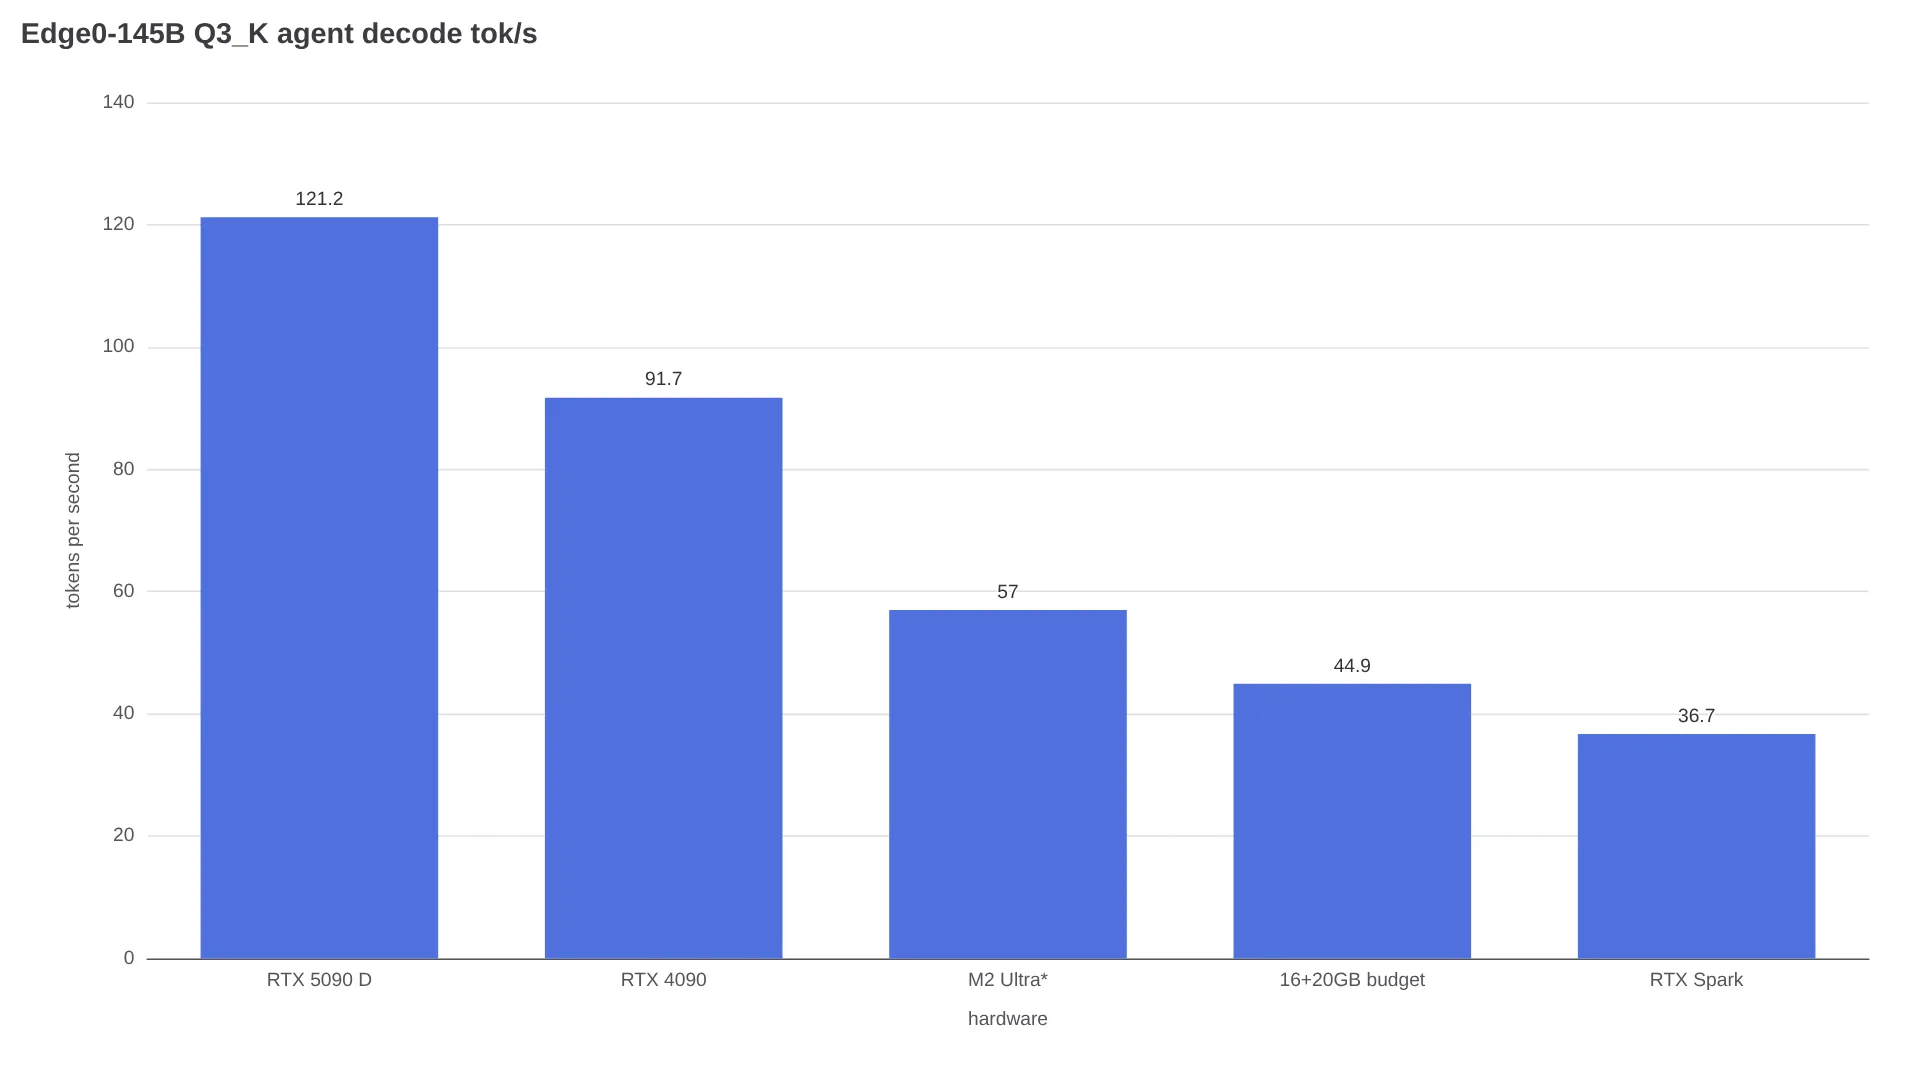
以下は、特記がない限りEdge0が公表したQ3_Kの数値で、プリフィル長は16Kです。M2 Ultraの行はMetalで測定された値であり、macOS版のリリースを示すものではありません。
| ハードウェア | チャットデコード | エージェントデコード | 16Kプリフィル |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| VRAM 16GiB + RAM 20GiB構成 Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
RTX 3090のユーザーからは、Q3_Kで初回トークンまで20.1秒、プリフィル毎秒1,583トークン、デコード毎秒56.2トークンという報告があります。フラッグシップGPUよりは遅いペースになりそうです。
3090環境で試してみたところ、Edge0-145B Q3_KはTTFT 20.1秒、プリフィル毎秒1583トークン、デコード毎秒56.2トークンでした。
— u/LightBrightLeftRight、r/LocalLLMのスレッド
先ほどのAMD環境では、u/UghrUghrがデコード毎秒約40、ROUTE_TAIL_SKIP=7とROUTE_PRIOR=1.5を指定した場合は約54、プロンプト処理は約320と報告しています。いずれも単一ユーザーでのスナップショットで、管理された再現テストではありません。速度は5090 Dの約半分から3分の2程度です。
ベンチマーク:2項目では勝利、ただし注意点は4つ
Edge0の表には、Edge0、Qwen、DeepSeek、Claudeの内部測定と、その他のモデルの第三者測定値が混在しています。これはモデルドキュメントにも記載されています。Edge0-145Bはコーディングエージェント向けの2テストでは首位ですが、知識・指示追従系のテストではベースモデルのQwenを下回ります。2026年11月13日時点で、リンク付きの独立した再現テストは確認できませんでした。また、ここに示されるスコアは量子化版のダウンロードファイルではなく、フルモデルを対象にしたものです。
| ベンチマーク | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
Edge0の計算では、平均スコアはEdge0-145Bが72.8、Qwen3.8-Flash-Nextが71.7、DeepSeek-V4-Flashが70.1でした。120Bは68.9です。両サイズでピーク時の必要量が似ているという前提なら、ディスク容量に余裕がない場合を除き、145Bを選ぶのが私の結論です。
ライセンス:オープンウェイトでもオープンソースとは限らない
フレームワークはApache 2.0、Strataのベース部分はMITです。しかし、重みにはEdge0 Community Model License 1.0が適用され、Qwenの規約も同時に適用されます。個人利用、研究利用、社内利用、出力結果の商用利用は認められています。一方、モデルの販売や同梱、有料サービスの提供、商用のコーディングアシスタントやオフィスアシスタントの提供には、別途書面による許可が必要です。
ダウンロードすべきか、それともAPIを使うべきか
必要なハードウェアがあり、コードをデバイス内にとどめたいならダウンロードを検討できます。一度試すだけなら、ハードウェアを購入する前にホステッドAPIの料金と比較したほうがよいでしょう。ホステッド推論を比較している開発者は、105GBのディスクを確保する前にDeepSeek V4.1 Flash APIのページも確認できます。
| 状況 | 選択肢 |
|---|---|
| 24GB NVIDIA + RAM 32~48GB + 120GB NVMe、Linux/Windows | Q3_Kをダウンロードし、edge0-inferで起動 |
| Blackwellカードを持ち、NVFP4を使いたい | NVFP4版をダウンロード |
| Macのみ、8~16GBのノートPC、またはOllama/LM Studioが必要 | まだダウンロードしない。ホステッドAPIを使う |
| 重みを使った有料APIやアシスタントを提供する | 書面によるライセンス許可が出るまで保留し、APIを使う |
| 運用の手間をかけずにスコアだけ利用したい | Qwen系またはフロンティアモデルのAPIを使い、再現テストを待つ |
このモデルのポイントは、出所の明確さと実用性のトレードオフです。エキスパートのストリーミングによって1000億パラメータ超のモデルでもVRAMのハードルは下がりますが、ノートPC対応、macOS対応、29GBという説明は、公開済みコードの実態より先行しています。また、Edge0が公開した表には、Q3_Kの品質スコアは別途示されていません。
FAQ
Edge0-145BはノートPCで動きますか?
CUDA 13対応のLinuxまたはWindows上で、VRAM約24GB、RAM 32GB以上、NVMe 120GBほどを備えたハイエンドNVIDIAノートPCに限れば可能です。8GBまたは16GBの薄型ノートPCでは145B版を動かせません。ダウンロード容量は105.4GB、VRAM常駐量は23GiB以上必要です。
Edge0-145BはMacで動きますか?
2026年11月13日時点で、プラットフォーム表にmacOSのサポート版は掲載されていません。M2 Ultraの数値はMetalでの測定結果にすぎません。
Ollama、llama.cpp、LM Studioで動きますか?
動きません。標準ビルドでは独自形式のexperts.binパックを読み込めず、スケルトンGGUFにもルーティングされたエキスパートの重みがありません。edge0-infer serveか、Windows向けのChatアプリを使ってください。
Edge0-145BはQwen3.8-Flash-Nextより優れていますか?
Edge0のテストでは、DeepSWEが64.6対58.7、Terminal-Benchが86.52対83.3で上回っています。一方、HLEは35.4対35.9、GPQA-Diamondは90.4対91.7で下回ります。独立したテスト結果はまだ出ていません。
Edge0-145Bは商用利用できますか?
出力結果の商用利用は可能です。ただし、コミュニティライセンスでは、モデルの販売、有料サービスの提供、商用コーディングアシスタントやオフィスアシスタントの提供に別途書面による許可が必要です。Qwenの規約も同時に適用されます。