 AIREITER
元祖の facebookresearch/demucs リポジトリは、2025年1月1日以降読み取り専用になっている。それでもDemucsは、自分のマシンで動かせる無料ツールとして今なおトップクラスだ。ただし、v4.1.0をリリースしたフォークから導入すること、そして最初に限界が見えるのはギターとピアノだという点は覚えておきたい。
アーカイブ版ではなく、メンテナンス中のDemucsリポジトリから始める
同じREADMEを掲げるGitHubリポジトリが2つあるが、修正が続いているのは片方だけだ。facebookresearch/demucs はアーカイブ済みで読み取り専用。README自身も別のリポジトリを案内している。現在の公式メンテナンス先は adefossez/demucs で、作者のAlexandre Défossezは「Metaを離れてKyutaiに加わった今、ここが公式にメンテナンスされているDemucsだ」と説明している。ただし、「返信は遅く、当面は新機能もないと思ってほしい」とも書いている。
この違いはURLだけの話ではない。インストール方法そのものが変わる。
v4.1.0で変わったこと
11/07/2026 付けのリリースノートでは、Demucs v4.1.0について「パッケージングの現代化、推論時の依存関係の軽量化、多数の修正、Hugging Faceでホストされた事前学習済みモデル」を挙げている。実際に影響する点をまとめると、次のとおりだ。
| 項目 | アーカイブ版リポジトリ | メンテナンス版リポジトリ(v4.1.0) |
|---|---|---|
| 必要なPythonの最低バージョン | 3.8 | 3.10 |
| 最短で実行する方法 | pip install -U demucs | uvx demucs MY_TRACK.mp3(インストール不要) |
| 恒久的にインストールする方法 | pip install -U demucs | uv tool install demucs(pipも利用可能) |
| ffmpeg | 必須 | 任意。ただしFLAC出力と、sphnでデコードできない形式には必要 |
| 量子化モデル | 同梱 | 追加指定が必要:uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| 重みのホスティング先 | dl.fbaipublicfiles.com | Hugging Face |
バグ報告の前に知っておきたい落とし穴もある。PyTorchはバージョン2.2以降、Intel Macのサポートを打ち切った。そのためIntel MacユーザーはPython 3.12までに制限され、uvx --python 3.12 demucs を実行するよう案内されている。
モデル選び:htdemucs、htdemucs_ft、htdemucs_6s、mdx
-n フラグでモデルを選べるが、デフォルトが常に最適とは限らない。Demucsには、ドラム・ベース・その他・ボーカルに分ける4ソースモデル、6ソースの実験モデル、そして古いMDXチャレンジモデルが用意されている。
| モデル | ソース数 | 速度 | 公式の注意点 | 向いている用途 |
|---|---|---|---|---|
htdemucs | 4 | 基準(デフォルト) | 特になし | まず試すとき、バッチ処理、処理速度を優先したいとき |
htdemucs_ft | 4 | 約4倍遅い | 「少し良くなるかもしれない」 | 大切な曲の最終書き出し |
htdemucs_6s | 6 | 2つの中間 | ギターは「まあまあ」、ピアノは「うまく機能していない」。「かなりの漏れとアーティファクト」が出る | ギターステムが必要で、多少の乱れを許容できるとき |
hdemucs_mmi | 4 | 基準 | v3アーキテクチャを再学習 | v4の結果が特定のミックスで不自然なときのA/B比較 |
mdx / mdx_extra | 4 | 基準 | mdx_extra はMUSDBのテストセットを含むデータで学習 | 古い素材、またはv4のアーティファクトが気になるとき |
mdx_q / mdx_extra_q | 4 | 最速・最小 | 「品質がわずかに落ちる可能性がある」 | ストレージの少ないマシン、クイックプレビュー |
htdemucs_ft の説明にある含みには注意したい。品質向上は、作者自身が「可能性がある」と表現している程度なのに、計算量は4倍になる。CPUではこの差がかなり重く、実際にユーザーからも同じ声が出ている。
9.00 dBと9.20 dBのSDR値が示しているもの
同じREADMEの段落に登場する2つの数値だが、意味は同じではない。Hybrid Transformer Demucsが達成するのは、MUSDB HQテストセットで9.00 dB SDR。より高い9.20 dBという結果には、スパースアテンションカーネルとソースごとのファインチューニングが必要だ。しかも、そのスパースモデルは「リリースの準備が整っていないカスタムCUDAコードを必要とするため提供されていない」とされている。
つまり、ダウンロードして使えるモデルで9.20 dBを再現することはできない。READMEの比較表では、提供されているファインチューン済みv4の総合SDRは9.0で、1.7kミックスで学習したBand-Split RNNと同じ位置にある。
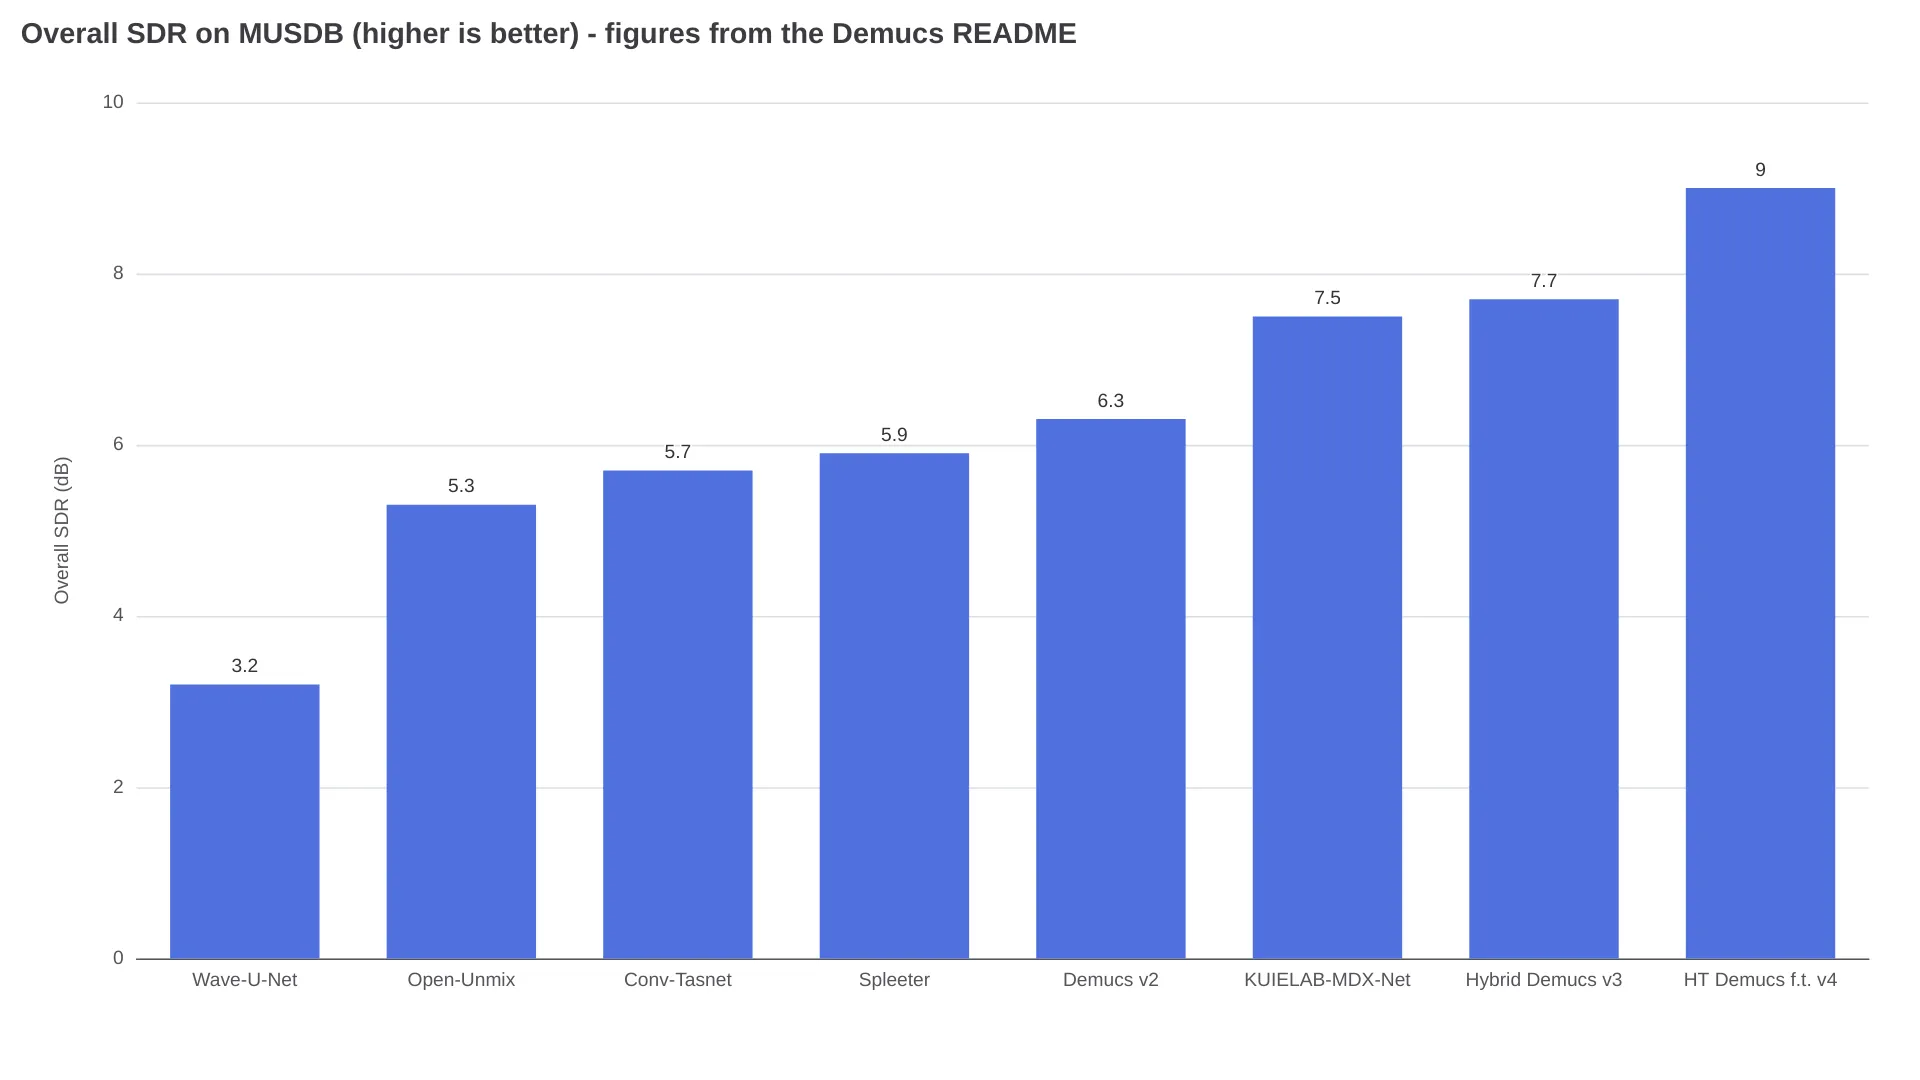
同じ表では、25k曲で学習したSpleeterが5.9 dBにとどまっている。ファインチューン済みv4との差は、およそ3 dBだ。
出力結果を左右するフラグ
Demucsを実行するときに決めることは、ほとんどの場合3つ。何ステムに分けるか、どこまで計算量をかけるか、そしてどの形式で保存するかだ。
--two-stems=vocalsはカラオケ向けのモードで、vocals.wavとno_vocals.wavを生成する。最初にフルミックスを分離してからミックスダウンする仕組みなので、通常の実行より速くなるわけでも、メモリ使用量が減るわけでもない。--shifts=Nは、入力をランダムにずらしてN回推論し、その結果を平均する。予測時間はN倍になる。READMEの助言は「GPUがないなら使わないこと」だ。論文では10シフトを使っているが、Replicateのホスト版デフォルトは1だ。--overlapのデフォルト値は0.25。0.1まで下げれば、少しだけ高速化できる。--segment Nは、メモリ不足を回避するためのつまみだ。ただし、コピペしたコマンドでひそかに問題になりやすい点がある。Hybrid Transformerモデルの最大セグメント長は7.8秒 なので、長い--segment値が効くのは非HTモデルだけだ。- 出力関連のフラグ には、
--mp3(デフォルト320 kbps)、--flac(ffmpegが必要)、--int24、--float32がある。デフォルトでは、44.1 kHzのint16 WAVとしてseparated/MODEL_NAME/TRACK_NAMEに保存される。 --clip-modeは見た目以上に重要だ。Demucsはデフォルトでクリッピングを避けるためにステムをリスケールするが、その処理によってステム間の相対的な音量バランスが崩れることがある。一方、clampはハードリミットをかける。
同じドキュメントにあるハードウェア要件は、GPUメモリ最低3 GB、デフォルト引数では約7 GB。3 GB以下の場合は --segment 8 と PYTORCH_NO_CUDA_MEMORY_CACHING=1 を使う。CPUでは「処理時間は曲の長さの約1.5倍になるはず」とされている。ただし、htdemucs_ft を使ったユーザーの報告と比べると、かなり楽観的な数字だ。
Demucsで漏れが出る場所と、ユーザーが使う2段階処理
何度も報告される不満が、音の漏れだ。特にボーカルと主旋律の楽器が同じ音域を共有していると、目立って発生する。Ryan Herr(@rrherr)は、抽出を試したあとにこう率直に書いている。
demucs let a lot of sax bleed into the 'vocals' track.
経験のあるユーザーがたどり着く対策は、フラグの追加ではない。別のモデルをもう1つ使うことだ。日本のプロデューサー夜凪P(@yonagip、145いいね)は、まずUVR5でMelBand Roformerを使ってボーカルとインストゥルメンタルを分け、その後インストゥルメンタルだけを htdemucs_ft に渡してドラム、ベース、その他を分離する手順を紹介している。
Demucs単体だとVoが他に漏れるんだけど (with Demucs alone, the vocals leak into the other stems)
同じ方向を示すユーザー報告はほかにもある。あるプロデューサーは htdemucs_ft のほうがベースの輪郭が良くなるとしつつ、CPU処理は4倍遅いと報告している(@hachi_vm)。別のユーザーはギター抽出の比較を投稿し、htdemucs-6s がBS-RoFormerモデルに目に見えて負ける結果を示した(@junon_12)。いずれもベンチマークではなく個別の報告だが、公式の説明とは一致している。Défossezは2022年12月に6ソースモデルを発表した際、「いくらかの漏れとアーティファクト」が見られたと書いている。
実用上のルール:素材にサックス、リードギター、あるいは旋律を奏でるピアノが含まれているなら、Demucsの1回処理は完成品ではなく出発点だと考えたい。もう1段処理が必要なら、Roformer系の代替モデルをUVR5から利用できる。
インストールせず、APIとしてDemucsを呼び出す
Python環境を用意せずにステムを得たいなら、広く使われているホスト版として Replicateのcjwbw/demucs がある。Nvidia T4上でおよそ150万回実行されており、ページに掲載された見積もりは1回約$0.020(1ドルで約50回)。通常、予測は90秒以内に完了する。
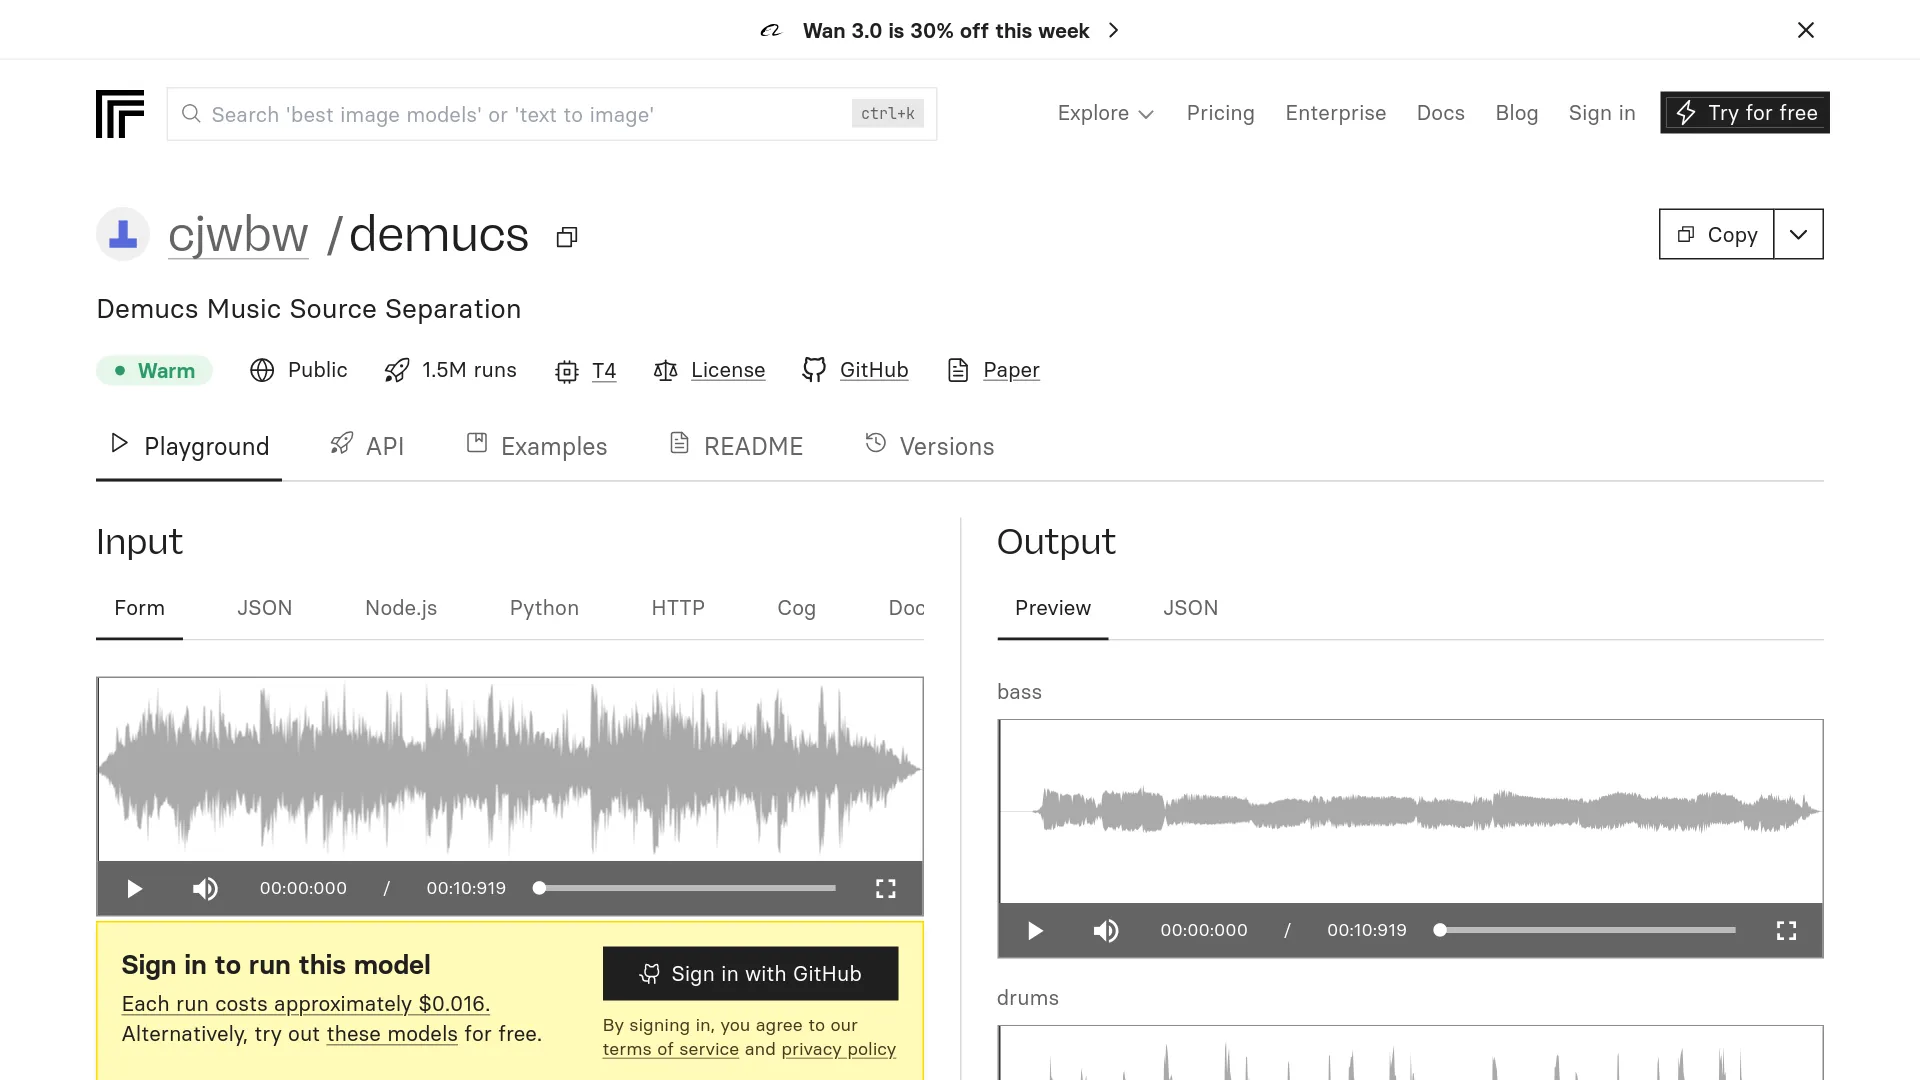
入力スキーマはCLIとほぼ同じだ。model_name(デフォルト htdemucs)、stem、shifts(デフォルト1)、overlap(0.25)、clip_mode(rescale)、mp3_bitrate(320)、float32、output_format(mp3)を指定できる。
ただし、ページが教えてくれない注意点が1つある。最新バージョンの日付はおよそ3年前で、ホストされたエンドポイントは特定のスナップショットに固定されている。つまり呼び出しているのは、そのビルドであって、2026年7月のv4.1.0で行われたパッケージングや依存関係の改善ではない。実行時間も見出しの数字ほど安定していない。同じモデルの公開例では、予測に6分18秒かかったケースもある。
4分の曲を実際に処理するといくらかかるのか
ワークフローを決めるのは、1曲あたりのコストだ。そして、その計算には多くの人が契約後に知ることになる課金上の細部が関わってくる。
LALAL.AI は、使用量をファイルの長さ × 選択したステム分離タイプの数で計算する。4分の曲を4ステムに分ける場合、消費するのは4分ではなく16分だ。
同じ料金ページには、1回限りの追加購入も掲載されている(2026年9月25日確認)。Fast Queueの750分が$50、3,000分が$190、5,000分が$300だ。この料金で4分の曲を4ステムに分けると、1曲あたりのコストは$0.96〜$1.07になる。
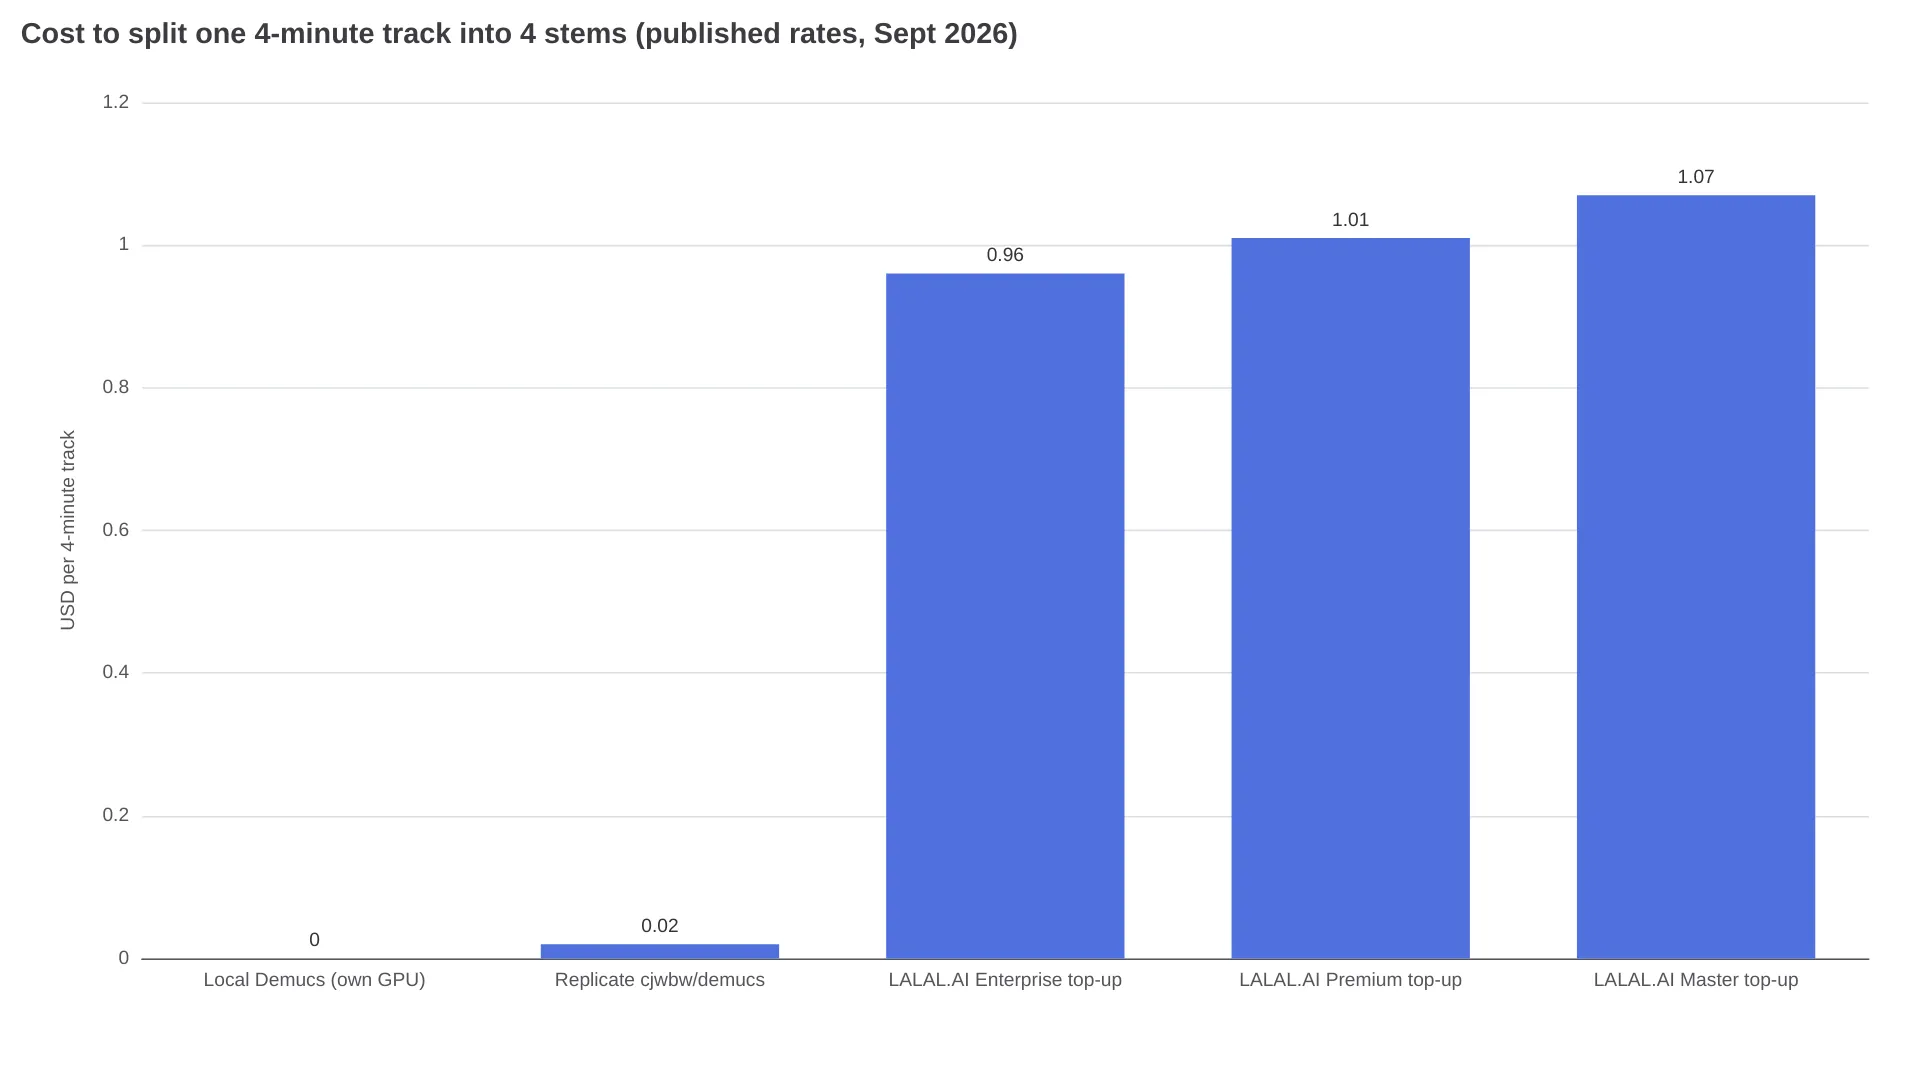
このグラフを見るときは、1点だけ補足が必要だ。LALAL.AIの金額は優先処理の料金である。有料プランにはRelaxed Queueの分数が無制限で含まれており、同社は両方のキューについて「分離品質は同一」と説明している。Fast Queueで買えるのは、待ち時間の短さだけだ。
| プラン | 料金 | 含まれるもの | 主な制限 |
|---|---|---|---|
| LALAL.AI Starter | 無料 | Relaxed Queue 10分 | アップロード上限200 MB |
| LALAL.AI Lite | 月額€6.75、年払い€81 | Relaxed無制限、Fast 90分 | バッチ、VST、API非対応。分数の繰り越し不可 |
| LALAL.AI Pro | 月額€13.50、年払い€162 | Relaxed無制限、Fast 250分 | APIアクセス、VSTプラグイン、バッチ処理を利用できる唯一のプラン |
| Moises | 一般公開なし | 月間アップロード数に制限のある無料プラン | 料金表はログイン後に表示。27種類のステムに対応すると主張 |
Replicate cjwbw/demucs | 1回約$0.020 | T4、通常90秒以内 | バージョンはおよそ3年前の状態に固定 |
| ローカルDemucs | 無料(MITライセンス) | 無制限、オフライン | GPUの処理時間とセットアップの手間 |
LiteプランのFast Queue 90分で処理できるのは、4ステムの曲なら月に約5曲。これを超えるとRelaxed Queueに移る。週に数曲を超えるペースで処理するなら、分単位の課金はすぐに割高になる。まさにその程度の量から、Demucsを導入するための午後の作業時間が元を取れるようになる。
用途別に選ぶべき方法
| 状況 | おすすめ | 理由 |
|---|---|---|
| たまに分離するだけ。GPUもターミナルもない | LALAL.AI Starter、続いてLite | 10分の無料枠で、料金を払う前に品質を試せる |
| 曲の練習、モバイル中心の利用 | Moises | 27種類のステムに加えてテンポやコードの機能もある。料金はログイン後に確認 |
| 大量処理、自分のGPUがある | uvx demucs と htdemucs | 追加コストゼロ、実行回数無制限、データがマシンの外に出ない |
| 重要な曲の最終書き出し | htdemucs_ft、GPUで --shifts 2 | 計算量4倍で、最後のわずかな品質向上を狙える |
| ギターステムが必要 | まず htdemucs_6s、その後UVR5でRoformer系モデルと比較 | 公式ドキュメントも6ソースモデルの漏れを認めている |
| 未公開素材やNDA対象の素材 | ローカルDemucsのみ | アップロード不要、MITライセンス、オフライン処理 |
| アプリのバックエンド、運用予算はかけられない | Replicate cjwbw/demucs | 1回約$0.020で、GPUインフラの管理も不要 |
Demucsステム分離 FAQ
ボーカルに最適なDemucsモデルは?
提供されている4ソースモデルの中では、htdemucs_ft がボーカル分離に最も強い。ただし、htdemucs の約4倍の処理時間がかかる。難しいミックスでは、まずRoformer系モデルでボーカルを分離し、その後Demucsでインストゥルメンタルを分解する2段階処理のほうが良いという報告がある。
Demucsでギターやピアノを分離できる?
htdemucs_6s を使えば可能だ。公式READMEでは、簡単なテストでギターの品質は「まあまあ」、ピアノのソースは「うまく機能していない」と説明されており、「かなりの漏れとアーティファクト」が発生するとしている。
Demucsの実行にNVIDIA GPUは必要?
必要ない。-d cpu でCPU実行でき、ドキュメントでは処理時間を曲の長さの約1.5倍と見積もっている。Apple Siliconでは -d mps を指定できる。GPUアクセラレーションには最低3 GBのVRAMが必要で、デフォルト引数では約7 GBを使う。
分離したステムを合成しても元のミックスに戻らないのはなぜ?
Demucsは、分離時に生じるアーティファクトによるクリッピングを防ぐため、各ステムをリスケールする。その結果、ステム間の相対的な音量が崩れることがある。代わりにハードクリップを使うなら --clip-mode clamp を指定するか、処理前に入力ミックスの音量を下げるとよい。
Demucsのステムはどこに保存される?
separated/MODEL_NAME/TRACK_NAME/ に、44.1 kHz・int16のステレオWAVとして保存される。ファイル名は通常、drums.wav、bass.wav、other.wav、vocals.wav。MP3、FLAC、int24、float32を指定した場合は、その形式で出力される。
CUDAのメモリ不足エラーはどう解消する?
--segment の値を下げる(3 GBのカードでは、ドキュメント上の下限は8)。PYTORCH_NO_CUDA_MEMORY_CACHING=1 を設定するか、-d cpu でCPUに切り替える方法もある。Hybrid Transformerモデルのセグメント長は7.8秒が上限なので、それを超える値にしても効果はない。