 AIREITER
「Sonnet 5 は Opus 4.8 に近いが、より安価である」は Anthropic 自身の売り文句です。私たちは、それがどこまで本当なのかを確かめたかったので、Claude Code CLI を介して同一の4つのタスクを両方のモデルに実行させ、各 API レスポンスから実際のコスト、所要時間、ツール呼び出し回数を記録しました。最も重要だったのは、Sonnet 5 を xhigh の effort に引き上げて、Opus 4.8 がデフォルトで行うことに合わせると、私たちが測定した価格差はほぼなくなった一方で、Opus 4.8 はおよそ半分の時間で完了したことです。
Sonnet 5 と Opus 4.8 の比較概要
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
リリース日 | 2026年6月30日 | |
コンテキストウィンドウ | 1M tokens | 1M tokens |
最大出力 | 128K tokens | 128K tokens |
価格(1M tokensあたりの入力/出力) | $5/$25 | |
高速モード | サポートされていません | サポートあり(研究プレビュー)、プレミアム価格で最大約2.5倍の出力速度 |
努力レベル | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
位置づけ | より安価で、エージェント重視のSonnet系モデル | Anthropicの旗艦、最高精度の選択肢 |
コンテキストウィンドウと最大出力は同一であり、ここでは差別化要因ではありません。異なる点が1つあります。Sonnet 5 は新しいトークナイザーで動作しており、Anthropic によれば、同じテキストに対して Sonnet 4.6 より「約30%多くのトークン」を生成します。そのため、Sonnet 4.6 から引き継いだ max_tokens の予算やコスト見積もりは、そのままでは直接適用できません。
公式ベンチマーク比較
Anthropic自身の開示情報と、llm-stats.comによる第三者分析を合わせて見ると、傾向は一貫しています。Sonnet 5はベンチマークのいくつかで勝利するか同点となり、Opus 4.8はそれ以外の大半でリードしており、通常は1桁台の差です。
ベンチマーク | Sonnet 5 | Opus 4.8 | 差 |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | ほぼ同率 |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
際立っている点は2つあります。Opus 4.8の最大の優位性は、コーディングではなく難しい数学(USAMO)にあります。コーディングの差(SWE-bench、Terminal-Bench)はいずれも一桁台で、Sonnet 5はそのうち1つで実際に完全に上回っています。ツールを併用した一般的な推論(HLE with tools)では、両者は拮抗しており、引き分けと言ってよいでしょう。
これは能力ベンチマークではないものの、注目しておくべき安全性の数値もあります。同じ開示によれば、追加の保護策なしでブラウザを使うシナリオにおける Sonnet 5 の測定済みプロンプトインジェクション攻撃成功率は 0.93% で、Opus 4.8 の 31.5% に対して大幅に低いものでした。Anthropic は、この特定の差について詳細な説明を公表していません。公開ウェブを無監督で閲覧するエージェント的なものを構築しているなら、旗艦モデルが自動的により安全なデフォルトだと決めつけるのではなく、自分自身の保護策をテストする価値があります。
私たちは独自に4つの直接比較テストを実施しました
現在出回っているもののほとんどは、上記の公式ベンチマーク表をまとめたものか、主観的な単一モデルの印象を共有したものです。私たちは、統制された同一プロンプトでのコストとレイテンシの比較を見つけられなかったため、自分たちで実施しました。
方法論: 2026-07-01 に実行した 4 つのタスクで、Claude Code CLI(claude -p --model <id> --effort <level> --output-format json)を介して毎回同じプロンプトを claude-sonnet-5 と claude-opus-4-8 に送信しました。コスト、所要時間、ターン数は、トークン数からの推定ではなく、各実行の API 応答から直接読み取っています。各モデル/effort の構成はタスクごとに 1 回ずつ実行しており、統計的に平均化されたサンプルではなく、1 回の実行から得られた実測値です。各ギャップの大きさは厳密な値ではなく方向性として扱ってください。方向は、実施したすべてのテストで一貫していました。
テスト1: コスト反転チェック
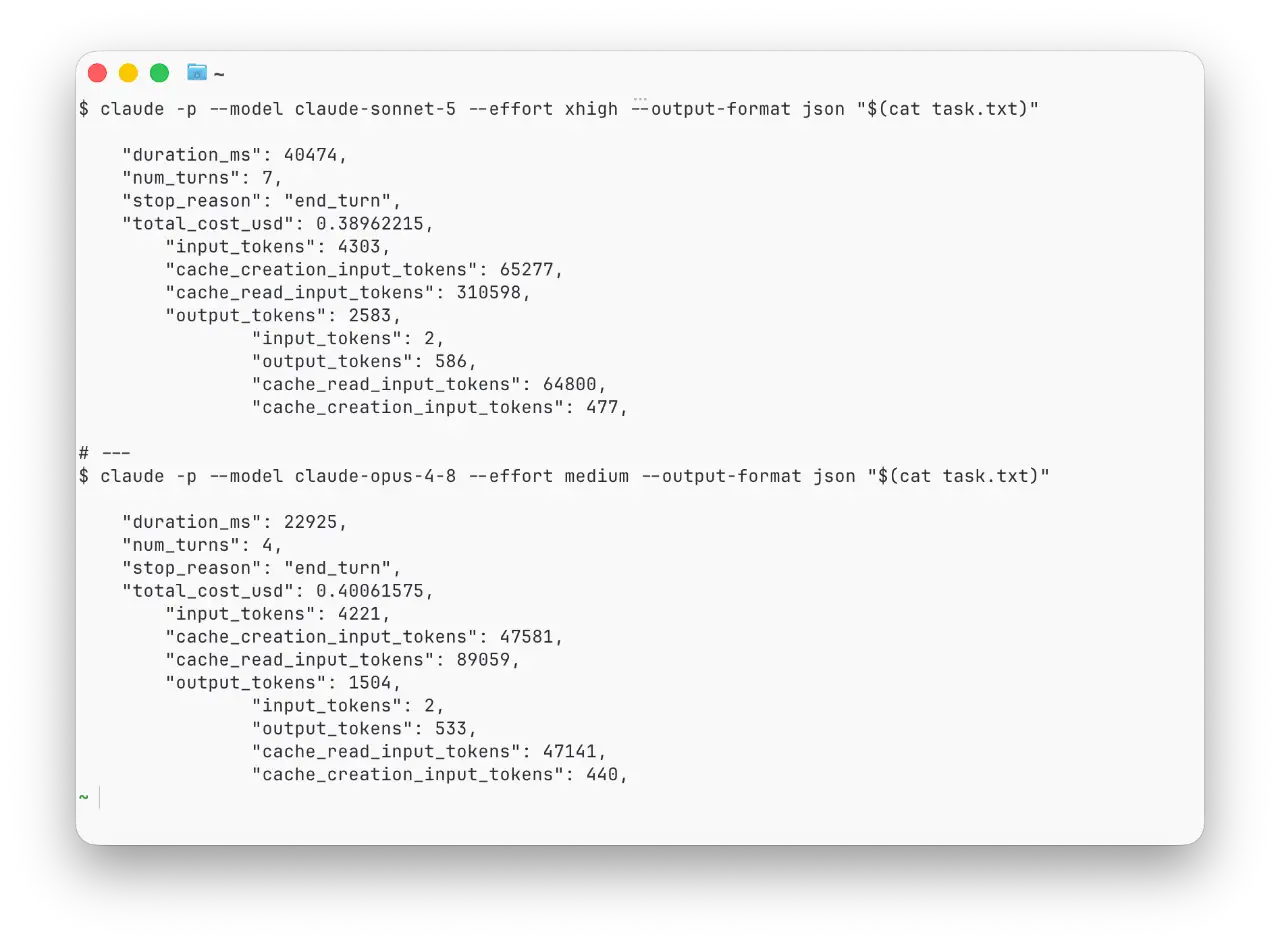
私たちが最も答えたかった疑問は、より難しいタスクに対応するために effort level を上げた場合でも、Sonnet 5 は依然として安価なままなのか、ということです。私たちは Test 2(下記)と同じ coding task を、Sonnet 5 xhigh と Opus 4.8 medium で実行しました。
設定 | コスト | 所要時間 | ターン数 | 結果 |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
3%のコスト差――実質的には互角――で、Opus 4.8は 低い 努力設定で、ほぼ半分のターン数を使い、時間は57%で完了しました。どちらも正しく動作するコードを生成しました。これは、人々がすでに Hacker Newsで指摘していることとも一致しています。そこではあるコメント投稿者が、同等の作業に対して、Opus 4.8はmedium reasoningでおよそ$0.45、Sonnet 5はxhigh/maxでおよそ$0.52かかると見積もっていました。
テスト 2: 同等の労力でのコーディングタスク
同じプロンプトで、両方のモデルを high effortに設定: 効率的な最長回文部分文字列関数を作成し、エッジケースを網羅するテストケースを生成し、それらを実行し、失敗した箇所を修正する。
設定 | コスト | 所要時間 | ターン数 | 結果 |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
どちらも同じ center を起点に広げるアプローチにたどり着き、最初の実行で全テストに合格しました。Opus 4.8 はそれにより早く、少ないターン数で到達し、費用は約 16% 高くなりました。品質が同じなら、これは速度だけで Opus の勝ちです。
テスト3: ライティング / ナレッジワーク
正解が一つではない経営判断のプロンプト:シリーズAのクローズの6週間前に、12人規模のSaaS企業に対し、災害復旧のために第2のAWSリージョンへ移行するために3〜4週間を費やすべきかどうかを助言してください。
設定 | コスト | 所要時間 | ターン数 |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
どちらも本質的には同じ提案をしました — フル移行は見送り、代わりに軽量なバックアップ/ランブックを出荷する — そして理由付けの質も同程度でした。Sonnet 5 は所要時間が約3分の2で、コストも14%低く済みました。これは、「Sonnet 5 は知識労働で十分通用する」ということが明確に示された唯一のテストでした。
テスト 4: エージェント型ルックアップ — Sonnet 5 は本当に「考えすぎる」のか?
いくつかのRedditスレッドでは、Sonnet 5はOpus 4.8よりも単純なリクエストを過度に考えすぎる傾向があると説明されています。そこで、私たちは本当に単純な課題をテストしました。それは、ディレクトリツリー内のすべての .py ファイルのバイトサイズ合計を求め、どのサブディレクトリにそれらが最も多く含まれているかを報告することです。
設定 | コスト | 所要時間 | ターン数 |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
どちらも同じ正解にたどり着きました。コスト差は四捨五入すれば誤差の範囲でしたが、Sonnet 5 はツール呼び出しのターンが1回多く、所要時間も約50%長くかかりました。これは、「考えすぎる」という批判に対する、ささやかではあるものの実際のデータポイントです。そして Test 1 とも一致しています。Sonnet 5 は、同じ結論に至るまでにより多くのステップを踏む傾向があります。
では、実際にはどちらを使うべきでしょうか?
Opus 4.8 を選ぶ のは、速度が重要なコーディング作業、ツール呼び出しが多いエージェント型ワークフロー、または Sonnet 5 の effort を
highより先へ押し上げて出力を信頼したくなるようなケースです。まさにその状況では、Sonnet 5 のコスト上の優位性が消えてしまいます。Sonnet 5 を選ぶ のは、大量処理で予算に敏感な作業や、一般的な知識・執筆タスクです。ただし、
mediumまたはhighの effort にしておいてください。念のためという理由で反射的にxhighまで上げないでください。そこでは価格面の話が崩れます。どちらでも可 なのは、単純な検索や単発のリクエストです。私たちが測定した実用上の差は、1ターン余計にかかることと数秒程度で、誤答ではありませんでした。
よくある質問
Claude Sonnet 5 は実際に Opus 4.8 より安いのですか?
同じ努力レベルなら、はい — かなりそうです。ただし、より難しいタスクに対応するために Sonnet 5 を xhigh まで上げると、差は数パーセントまで縮むことがあり、一方で低い努力設定の Opus 4.8 のほうがより速く完了します。お金を節約できていると思い込む前に、実際にどの努力レベルで実行しているか確認してください。Haiku、Sonnet、Opus 全体の完全な価格表は、こちらの Claude API pricing guideをご覧ください。
Claude Sonnet 5 と Sonnet 4.6 の違いは?
世代的なアップグレードであって、モデル階層の選択ではありません。そしてコストも同じ方向には動きません。Sonnet 5 は Terminal-Bench で Sonnet 4.6 を2桁差で上回りますが、私たち独自の直接比較コストテストでは、Sonnet 5 は試したすべての作業強度レベルで Sonnet 4.6 より 高コストでした。主な理由は、新しい tokenizer にあります。完全なテスト結果と数値は Sonnet 5 vs Sonnet 4.6: Is It Actually Cheaper? をご覧ください
Claude Sonnet 5 と Opus 4.6 の比較は公平ですか?
そうではありません — Opus 4.6 は Opus 4.8 より1世代前です。今日どれを使うかを判断しているなら、前世代ではなく Opus 4.8 と比較してください。
2つの間でコンテキストウィンドウは異なりますか?
いいえ — どちらも1Mトークンのコンテキストウィンドウと128Kの最大出力を提供します。
なぜ Opus 4.8 のプロンプトインジェクション率はブラウザ使用時にこれほど高いのですか?
Anthropicの開示によると、追加の安全対策がない場合は31.5%で、Sonnet 5の0.93%と比べて高く、特に監督なしのbrowser-useシナリオではその差が顕著です。Anthropicは詳細な説明を公表していません。これを、主力モデルが自動的により安全なデフォルトだと考えるのではなく、あなたの具体的な安全対策をテストする理由として捉えてください。
付録: 正確なプロンプトと生の出力
これを再現したい方のために、各テストで送信した正確なプロンプトを以下に示します(テスト1とテスト2では同じコーディング用プロンプトを使用しましたが、異なる effort level でした)。
テスト 1 & 2 — コーディング用プロンプト:
Python関数 `longest_palindromic_substring(s: str) -> str` を作成し、s の最長回文部分文字列を返すようにしてください。総当たりの O(n^3) より効率的な方法(例: expand-around-center または Manacher のアルゴリズム)を使ってください。これを solution.py に保存してください。

次に、test_solution.py を作成し、少なくとも6件のテストケースを含めてください。対象は: 空文字列、単一文字、すべて同じ文字、長さ1より長い回文がないケース、偶数長の回文、奇数長の回文です。

pytest でテストを実行し、すべて通ることを確認してください。失敗があれば、コードを修正して、すべて通るまで再実行してください。最終的な pytest の出力を報告してください。
テスト 3 — ライティング/知識労働プロンプト:
あなたは、シリーズAの資金調達(6週間後にクロージング予定)を控えた小規模SaaS企業(従業員12名、月間経常収益 $80k、現在は単一のAWSリージョンで運用中)に対して、災害復旧のために第2のAWSリージョンへ拡張すべきかどうかを助言しています。

エンジニアリング部門の見積もりでは、移行には3〜4週間かかり、その期間中はチームのキャパシティの大半を消費し、顧客から要望のあった2つの機能の提供が遅れるとのことです。

約350語の経営向け提言を書いてください。今すぐ実施すべきか、延期すべきか、それとも中間案を取るべきか? トレードオフを踏まえて正当化してください。前置きは不要で、提言のみを示してください。
テスト 4 — agentic ルックアッププロンプト:
現在のディレクトリツリーで、.py拡張子を持つすべてのファイルを見つけ、それらの合計サイズをバイト単位で計算し、さらに作業ディレクトリの直下にある各サブディレクトリのうち、.pyファイルの数が最も多い単一のサブディレクトリがどれかを教えてください。答えは2つの数値/回答だけでよく、新しいファイルを書く必要はありません。
これは、Test 1 の Sonnet 5 (xhigh) 実行に対する実際の API レスポンスで、コストと時間に関連するフィールドだけを抜粋したものです:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
それが、その実行に対してClaude Code CLIが返した未編集の total_cost_usd、 duration_ms、およびトークン数です。上のTest 1の表にある数値は、こうしたフィールドから直接取得したもので、実行ごとに1つのJSONレスポンスがあります。