 AIREITER
Nel file di configurazione del modello Baidu, max_position_embeddings è fissato a 32.768. È qui che il nome Unlimited OCR smette di essere letterale, ed è il dato più importante da considerare prima di pianificarne il deployment: il modello trasforma il tradizionale OCR pagina per pagina in un unico forward pass, ma solo per documenti che rientrano in un budget di 32K token e con scansioni ragionevolmente pulite.
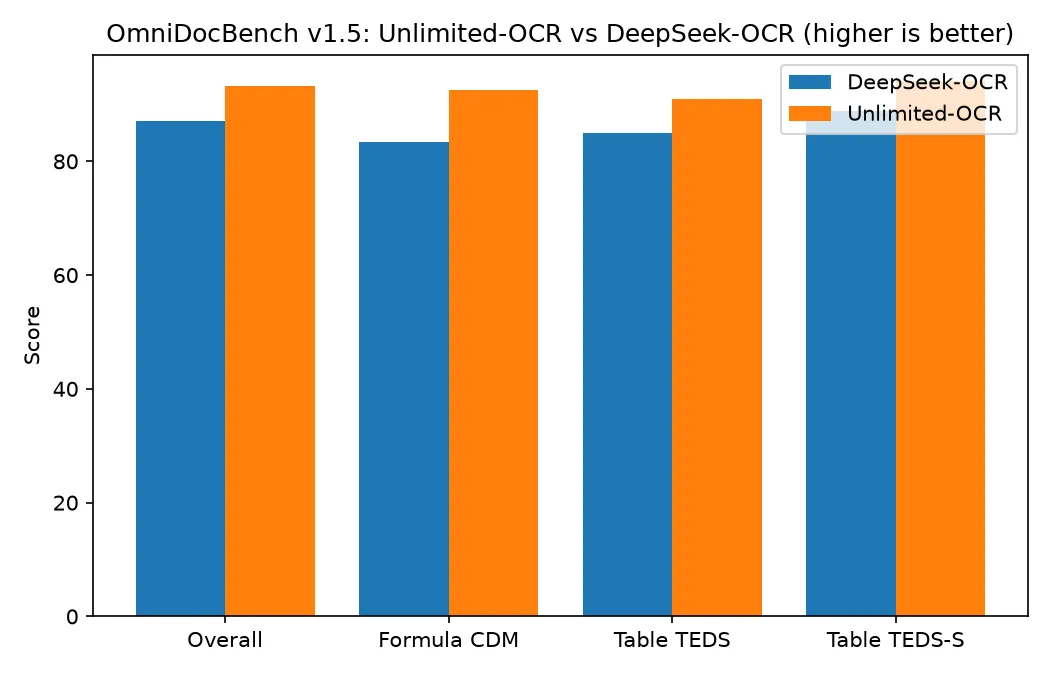
Al di là di questo limite, il rilascio è piuttosto solido. I pesi sono distribuiti con licenza MIT, i metadati safetensors indicano 3.336.106.240 parametri in BF16 e il modello ottiene 93,23 complessivi su OmniDocBench v1.5, contro gli 87,01 della baseline DeepSeek-OCR da cui deriva. Il 2026-07-29, la pagina su Hugging Face riportava 2.694.935 download negli ultimi 30 giorni e 3.389 like.
“Unlimited” ha comunque un confine
Nel flusso multi-pagina, ogni pagina viene codificata a 1024×1024 e compressa di 16 volte, fino a circa 256 token visivi. Prima ancora di scrivere codice, si può quindi stimare il numero di pagine gestibili.
| Pagine in un passaggio | Token visivi (prefill) | Token disponibili per l'output | Budget per pagina |
|---|---|---|---|
| 10 | ~2.560 | ~30.200 | ~3.020 |
| 20 | ~5.120 | ~27.600 | ~1.380 |
| 40 | ~10.240 | ~22.500 | ~560 |
Una presentazione o un contratto poco denso possono stare comodamente entro 40 pagine. Una pagina di giornale fitta, a due colonne, può però superare da sola i 560 token markdown: in casi simili il limite pratico scende ben sotto le 40 pagine. Il paper lo afferma apertamente: con una finestra di contesto finita, il parsing non può essere davvero illimitato, perché il prefill cresce comunque con il numero di pagine. Nella roadmap Baidu indica una versione con contesto da 128K e un "prefill pool" per recuperare blocchi di pagine su richiesta. Il nome si riferisce a una lunghezza di decoding illimitata rispetto alla cache, non a un numero illimitato di pagine.
R-SWA: cosa migliora rispetto a DeepSeek-OCR
Rispetto a DeepSeek-OCR, cambiano due elementi. Lo stack visivo DeepEncoder, una cascata SAM-ViT-B più CLIP-L, è stato mantenuto e congelato durante il training. Tutti i layer di attenzione del decoder sono invece passati a Reference Sliding Window Attention: ogni token generato può attendere a tutti i token di riferimento, cioè token visivi più prompt, ma soltanto agli ultimi 128 token di output. Il file config.json lo conferma: sliding_window_size: 128, 12 layer del decoder, 64 expert instradati e 6 attivi per token.
I miglioramenti sono distribuiti su più aspetti, non concentrati in una sola metrica, e riguardano le parti della pagina che beneficiano di generazioni più lunghe: su OmniDocBench v1.5, formula CDM passa da 83,37 a 92,61 e table TEDS da 84,97 a 90,93; la distanza di editing dell'ordine di lettura si dimezza da 0,086 a 0,045. Poiché l'encoder non è stato riaddestrato, queste differenze derivano dal decoder e non da uno stack visivo più potente.
Di conseguenza, il modello conserva anche i limiti dell'encoder. Una generazione più lunga non migliora il riconoscimento dei caratteri su un fax sbiadito.
Il vantaggio di velocità emerge solo con output lunghi
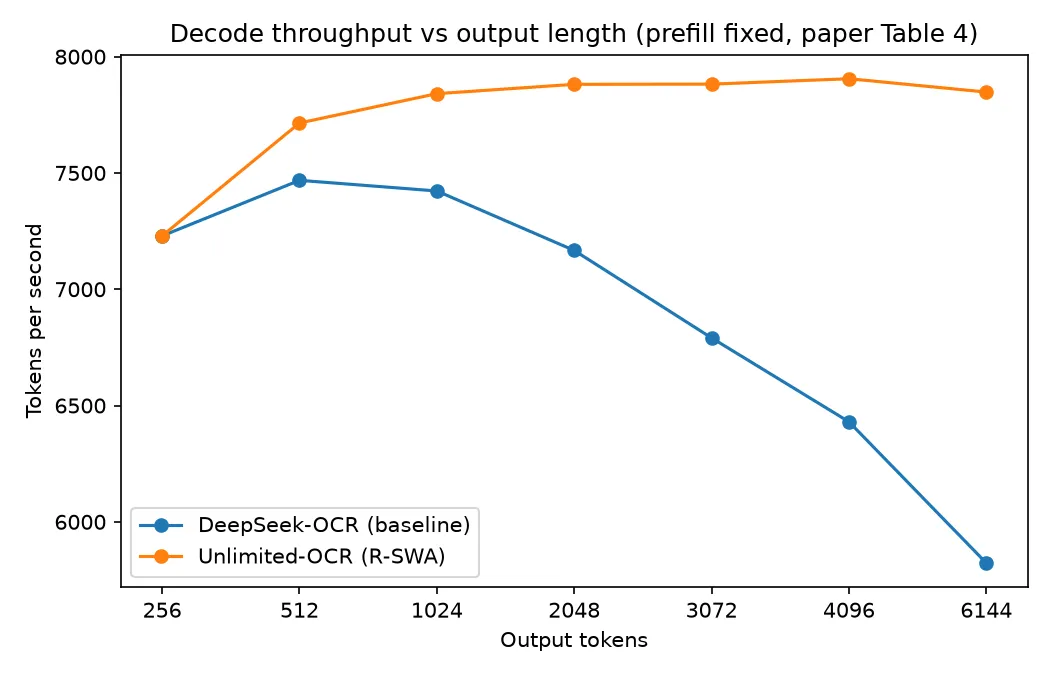
Con 256 token in output, i due modelli sono sostanzialmente identici: 7.229,52 contro 7.229,32 token al secondo. Il distacco arriva proseguendo la generazione: a 6.144 token, la baseline scende a 5.822,87, mentre Unlimited OCR rimane a 7.847,71, circa il 35% più veloce.
Nell'esecuzione completa di OmniDocBench in modalità base, con concorrenza 512, il vantaggio si riduce al 12,7%: 5.580 contro 4.951 token al secondo. Il batching nasconde già buona parte del costo di attenzione per step. Per l'elaborazione di fatture a pagina singola con alta concorrenza, R-SWA porta quindi guadagni quasi nulli.
L'accuratezza regge fino a 40 pagine, poi cala
Il paper riporta la distanza di editing in funzione del numero di pagine elaborate in un singolo passaggio, e la curva non rimane piatta.
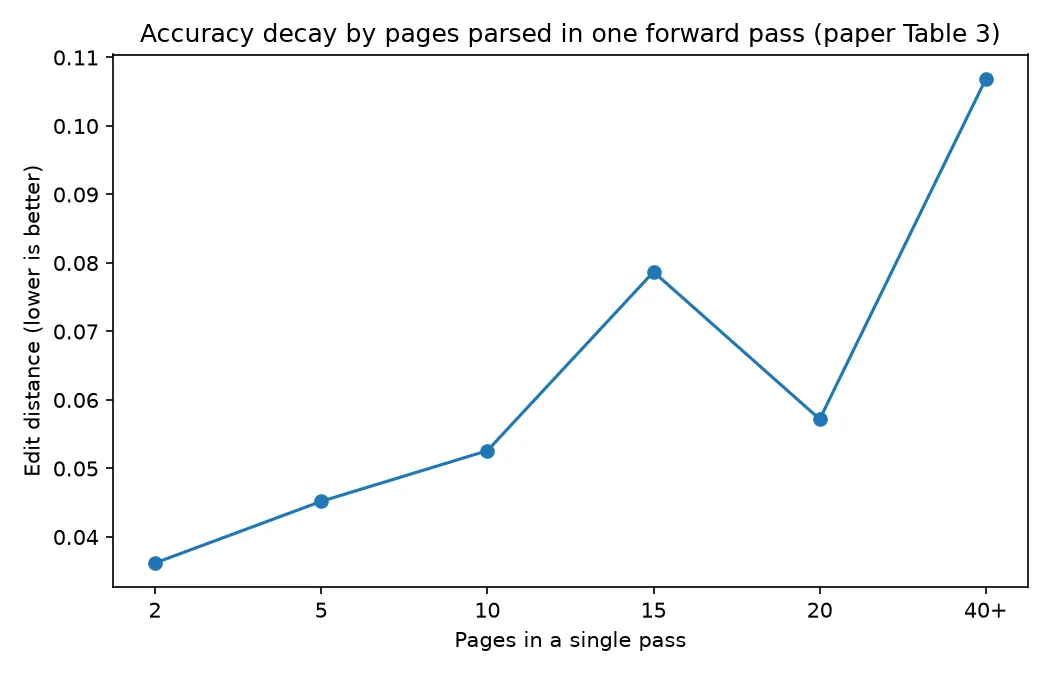
Con due pagine il valore è 0,0362; con dieci pagine arriva a 0,0526. Da 40 pagine in poi raggiunge 0,1069, mentre Distinct-35 cala da circa 99,9% a 96,90%: nell'output iniziano quindi a comparire n-gram ripetuti. La misurazione a 15 pagine, pari a 0,0787, è peggiore di quella a 20 pagine, 0,0572; meglio leggere la curva come una tendenza, non come una garanzia pagina per pagina. Baidu attribuisce i problemi di ripetizione soprattutto al testo piccolo alla risoluzione base di 1024×1024, non a una deriva dell'attenzione. È coerente con il compromesso del modello: gli input multi-pagina e PDF non possono usare la modalità crop ad alto dettaglio disponibile per le immagini singole.
Perché “8 GB bastano” non racconta tutta la storia della VRAM
La ricetta vLLM afferma che per l'inferenza BF16 è sufficiente una singola GPU con almeno 8 GB. Le segnalazioni della community non coincidono con questa indicazione, e la configurazione del modello spiega perché.
L'unico file safetensors pesa 6,673 GB. Sul lato cache contano quattro campi di config.json: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128, insieme a use_mla: false. Avere lo stesso numero di head query e key/value significa usare MHA puro, senza condivisione GQA o MQA che riduca il calcolo. La cache per token è quindi 2, K e V, × 12 layer × 10 head × 128 dimensioni × 2 byte = 61.440 byte, ovvero 60 KiB. Da qui derivano tre numeri:
- Prefill completo da 32K: 32.768 × 60 KiB = 1,875 GiB di cache
- Lato decode con R-SWA, limitato da
sliding_window_size: 128: 7,5 MiB, costanti - Lo stesso decoder senza R-SWA a 6.144 token di output: 360 MiB, in crescita lineare
Si tratta di dimensioni teoriche della cache, non dell'allocazione di picco: sopra si aggiungono le attivazioni del vision encoder, la frammentazione dell'allocator e il blocco cache preallocato dall'engine. Ecco perché pesi più prefill lungo saturano facilmente una scheda da 8 GB. Un'esecuzione locale con SGLang su una RTX 4070 Ti Super da 16 GB ha segnalato un utilizzo di circa 12 GB, dato coerente con questa aritmetica ma non dimostrazione definitiva. Gli 8 GB vanno quindi letti come soglia minima per una singola pagina breve, non come requisito per il caso da 40 pagine.
Questi valori chiariscono anche cosa porta davvero R-SWA: a queste dimensioni di modello, limitare la cache di decoding risparmia centinaia di megabyte, non gigabyte. Il beneficio pratico è che il costo di attenzione per step smette di crescere, esattamente ciò che misura la curva del throughput.
Nessuna API ufficiale: come si esegue davvero
La pagina Hugging Face indica: "This model isn't deployed by any Inference Provider." Non esiste un endpoint first-party né una pagina Baidu con prezzi di hosting. Per servirlo in autonomia ci sono tre strade: Transformers con trust_remote_code, SGLang oppure la ricetta vLLM. Quest'ultima richiede vLLM 0.25.0 o successivo, dal container dedicato vllm/vllm-openai:unlimited-ocr, perché l'architettura non è ancora inclusa in una wheel pip stabile.
Quattro impostazioni determinano se il modello produrrà output oppure no:
- Registrare il processor logits n-gram (
NGramPerReqLogitsProcessor). Senza, i documenti lunghi entrano in loop sui token di coordinate<|det|>. - Impostare
ngram_size: 35conwindow_size: 128per le immagini singole e1024per input multi-pagina o PDF. - Iniziare il contenuto testuale con il token letterale
<image>, come in<image>Multi page parsing.Il modello non include alcun chat template. - Passare
skip_special_tokens: False. Lasciando il valore predefinito, vengono restituite stringhe vuote.
Le generazioni raw includono markup di grounding. Per ottenere markdown pulito, mantenere il testo compreso in <|ref|> ed eliminare i bounding box <|det|>. Anche i confini tra pagine non vengono emessi in modo nativo: se servono per la tracciabilità, occorre richiedere etichette di pagina nel prompt.
Server e richiesta sicuramente funzionanti, secondo la ricetta, sono questi:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Sulle schede Hopper va usato il tag immagine unlimited-ocr-cu129. Inoltre, più immagini nella stessa richiesta attivano il fallback alla modalità base non-crop: è proprio il caso in cui serve window_size: 1024.
Costo ogni 1.000 pagine: self-hosting contro API gestite
I pesi open sono gratuiti, ma l'esecuzione non lo è. Uno dei pochi dati pratici di throughput pubblicati arriva da un utilizzatore nel thread di Hacker News: con Transformers su RTX 4090, ha convertito circa 200 pagine all'ora di un PDF di grammatica giapponese. Confrontiamo il dato con il noleggio hardware alla tariffa Community di RunPod, pari a $0,34 all'ora per una 4090.
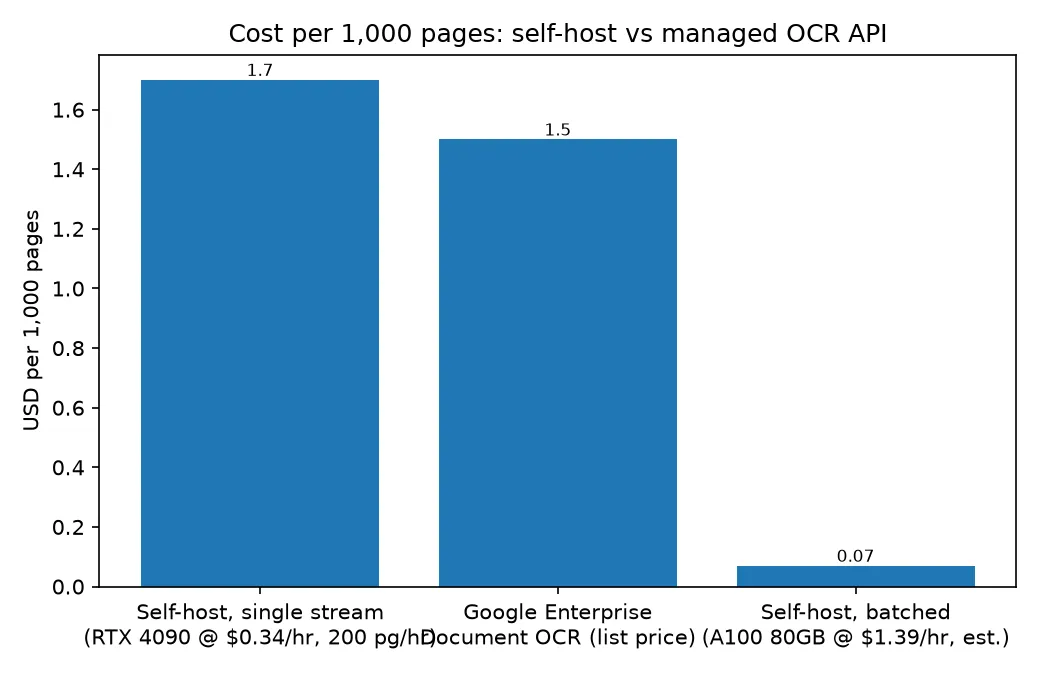
| Opzione | Costo per 1.000 pagine |
|---|---|
| Self-hosting, stream singolo (4090 a $0,34/ora, 200 pagine/ora) | ~$1,70 |
| Google Enterprise Document OCR, da 1K a 5M pagine/mese | $1,50 (listino) |
| Google Layout Parser, stesso volume di pagine | $10,00 (listino) |
| Self-hosting, soglia minima con batch saturi (A100 80GB a $1,39/ora, modello stimato) | ~$0,07 |
Prezzi di listino al 2026-07-29. Le prime 1.000 pagine mensili di Google sono gratuite, mentre la tariffa scende a $0,60 oltre 5 milioni di pagine. L'ultima riga è una soglia stimata, non una misurazione, e varia con la lunghezza dell'output: ai 5.580 token al secondo del paper con concorrenza 512, 700 token di output per pagina equivalgono a circa 28.700 pagine l'ora ($0,05 per 1.000), 1.000 token a circa 20.000 ($0,07), mentre una pagina densa da 2.000 token porta a circa 10.000 ($0,14). Quel throughput è stato misurato sul cluster di valutazione Baidu, non su una A100 a noleggio: la riga combina quindi un benchmark con un prezzo di rental. Le implementazioni reali superano tutti e tre i valori una volta considerate capacità inattiva, ritentativi sulle pagine fallite, preprocessing e storage.
Un deployment single-stream su una GPU consumer costa più o meno quanto l'OCR gestito di Google. Il self-hosting vince quindi per concorrenza e residenza dei dati, non per il costo della licenza. E il parsing è soltanto metà del lavoro: trasformare quel markdown in campi strutturati richiede ancora una chiamata a un modello testuale long-context, tornando a una fatturazione per token anziché per pagina, sia su infrastruttura propria sia attraverso un servizio come la GPT-5.6 API.
Dove fallisce
Le modalità di errore riportate dagli utenti sono quelle prevedibili con un encoder congelato. La stessa esecuzione su 4070 Ti Super ha prodotto testo corrotto, aree mancanti e deriva della struttura su ricevute, scrittura a mano e scansioni complesse, mentre le pagine stampate pulite venivano elaborate correttamente. Nel thread di Hacker News, alcuni utilizzatori descrivono il tipo di errore VLM-OCR più critico per lavori soggetti a compliance: parole straniere tradotte silenziosamente in inglese e un nome scritto a mano "corretto" nella variante più probabile. Si tratta di due aneddoti isolati, quindi vanno considerati aspetti da testare, non tassi misurati.
Conta anche il posizionamento del modello. Unlimited OCR non è in cima alle classifiche di accuratezza. Nelle liste aggregate di OmniDocBench, PaddleOCR-VL-1.6 raggiunge 96,33, valore auto-riportato dal vendor, contro 93,92 su v1.6; inoltre il modello non compare affatto su olmOCR-Bench. L'accuratezza per pagina non è il terreno su cui compete.
Conviene usarlo?
È una buona scelta se la pipeline attuale elabora le pagine in loop e ricompone il testo in seguito, se i documenti sono nativi digitali o scansionati bene e se strutture cross-page, come tabelle spezzate da un cambio pagina, compromettono l'output corrente.
È una scelta meno adatta se si gestiscono migliaia di fatture di una sola pagina al giorno, perché le pipeline per pagina gestiscono meglio il batching e costano meno; anche se scrittura a mano o ricevute fotografate sono una quota rilevante dell'input, oppure se serve oggi stesso un SLA e una pista di audit, anziché una GPU e un container tag.
In ogni caso, meglio testare prima di impegnarsi. Un minimo praticabile: 50 documenti del proprio corpus, divisi per lunghezza, da 1 a 5 pagine, da 6 a 20, 20 o più, e per qualità dell'input, nativi digitali, scansioni pulite, fotografie; ground truth trascritto manualmente per 10 di essi; poi misurare separatamente character error rate, distanza di editing dell'ordine di lettura e table TEDS, invece di mediarli, registrando anche i secondi reali per pagina sulla GPU che si intende noleggiare. Il confronto va fatto con la soluzione attuale sugli stessi 50 file, fissando la soglia nel punto in cui si rompe davvero lo step downstream: nell'estrazione di campi, in genere, è la struttura della tabella a contare più del CER grezzo. Come riferimento sulla variazione ottenibile con l'ottimizzazione, un team che gestisce volumi PDF su scala enterprise ha riportato uno character error rate dello 0,94% dopo aver riscritto il layer di inferenza in Rust.
FAQ
Unlimited OCR è gratuito?
I pesi hanno licenza MIT e si possono scaricare gratuitamente da Hugging Face o GitHub, anche per uso commerciale. L'inferenza non è gratuita: il budget è di circa $0,07-$1,70 ogni 1.000 pagine, in base all'efficienza del batching, più il tempo di engineering.
Esiste un'API ufficiale per Unlimited OCR?
No. La pagina del modello non mostra deployment presso Inference Provider; qualunque endpoint disponibile è quindi di terze parti, serve i pesi open e applica prezzi e rate limit decisi dal relativo vendor, non da Baidu.
Unlimited OCR è oggi il miglior modello OCR?
Non nelle classifiche di accuratezza: PaddleOCR-VL-1.6 dichiara 96,33 su OmniDocBench contro 93,92 di Baidu su v1.6, e il modello non ha ancora una voce su olmOCR-Bench, quindi la coerenza tra benchmark non è dimostrata. Il suo vantaggio misurato è il passaggio singolo su 40 pagine con distanza di editing pari a 0,1069.
Posso eseguire Unlimited OCR in Ollama?
La scheda ufficiale documenta soltanto Transformers, vLLM e SGLang, mentre l'architettura custom richiede trust_remote_code. Esistono quantizzazioni della community su Hugging Face, ma qualsiasi build per Ollama va considerata non verificata finché l'output non è stato confrontato con il percorso di riferimento sui propri file.