 AIREITER
Alibaba ha acceso il conto alla rovescia per Qwen3.8-Flash-Next il 25 agosto 2026, pubblicando la pagina dedicata su ModelScope. Il modello introduce la nuova architettura prima ancora che la famiglia di prodotti a cui appartiene, Qwen4, sia disponibile. Al momento della stesura, il rilascio dei pesi era previsto per il 26 agosto alle 23:00 UTC+8. L'obiettivo è dare all'ecosistema open source il tempo di preparare kernel, quantizzazioni e supporto per il serving prima dell'arrivo di Qwen4.
Qwen3.8-Flash-Next: cos'è davvero e cosa non è
Qwen3.8-Flash-Next è un modello multimodale Mixture-of-Experts (MoE) basato sull'architettura prevista per la futura famiglia Qwen4. Non è Qwen4. È più corretto considerarlo un dimostratore tecnologico: un modello funzionante che rende visibili i nuovi meccanismi di attenzione, la struttura dei layer e i pattern di sparsità, così che i framework di inferenza possano aggiungere il supporto prima del lancio completo di Qwen4.
La pagina del team Qwen su Hugging Face lo indica come "Upcoming release" e "A Preview of the Qwen4 Architecture". La pagina del conto alla rovescia su ModelScope usa invece lo slogan "Onward to the Next-Gen — Lightning-Fast." Sono entrambi canali ufficiali di Qwen: il rilascio è quindi confermato, anche se al momento della stesura non era ancora completo.
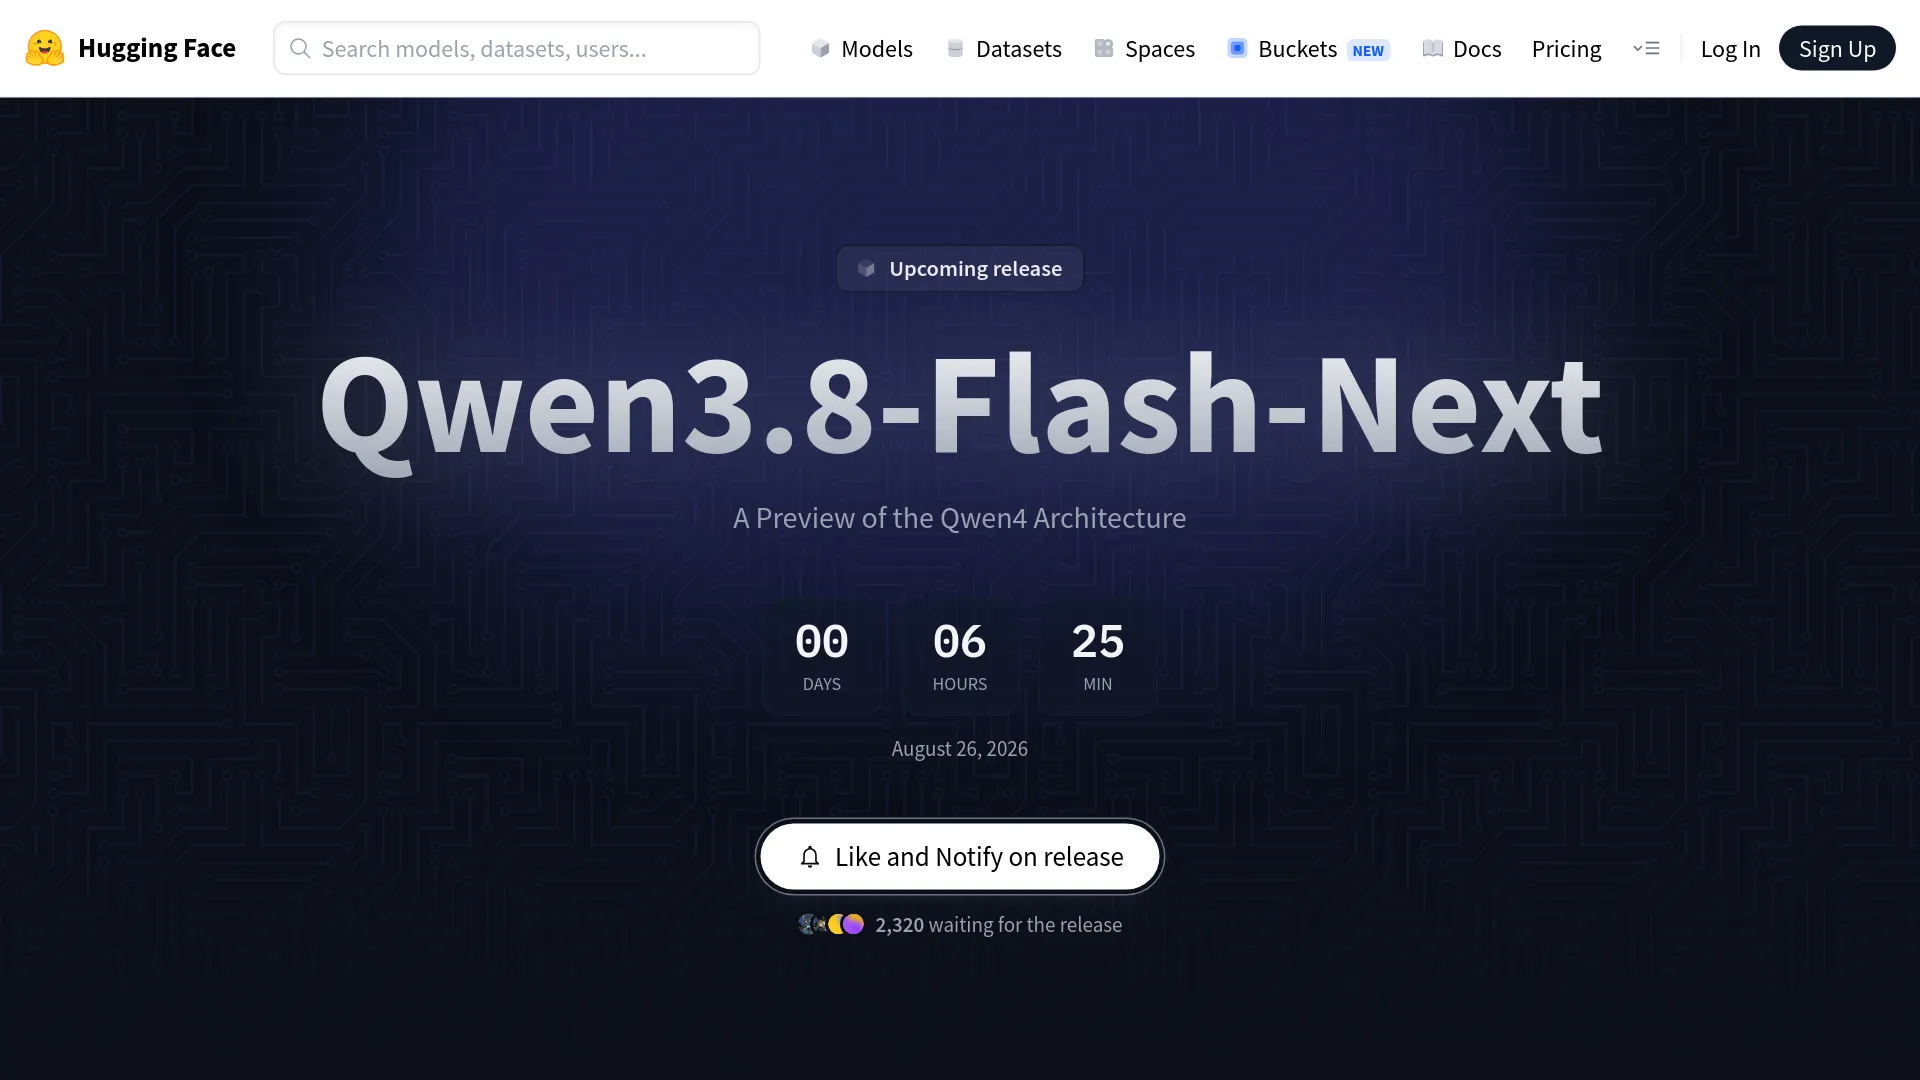
Ecco la distinzione tra ciò che è confermato e ciò che resta ancora nel campo delle ipotesi della community:
| Confermato dai canali ufficiali | Ancora non confermato |
|---|---|
| Rilascio dei pesi open su ModelScope e Hugging Face | Conteggio finale dei parametri (125B/6B/51B) |
| Multimodalità (visione + testo) | Licenza (probabilmente Apache 2.0, sulla base dei precedenti) |
| Architettura ibrida GDN e Qwen Sparse Attention | Qualsiasi risultato di benchmark |
Variante FP8 (Qwen/Qwen3.8-Flash-Next-FP8) | Prezzi o disponibilità via API |
| Anteprima dell'architettura Qwen4 | Lunghezza del contesto (si ipotizzano 256K nativi, estendibili fino a 1M) |
I numeri che circolano più spesso — 125B di parametri totali, 6B attivi per token e 51B di embedding n-gram — provengono da una scheda ModelScope mostrata brevemente e poi ridimensionata dal team Qwen. Sono plausibili e coerenti tra le osservazioni di diverse fonti indipendenti, ma non fanno parte di una documentazione ufficiale stabile. Come ha scritto ghosty, fondatore di SaaSCity:
"Chiunque pubblichi oggi un grafico di benchmark per questo modello se lo è inventato."
Un'architettura che obbliga i framework di inferenza a cambiare approccio
Tre elementi architetturali rendono Qwen3.8-Flash-Next molto diverso dagli attuali modelli della famiglia Qwen. Per ciascuno servirà nuovo codice nei kernel dei framework di inferenza, non una semplice modifica alla configurazione.
Layer GDN: stato ricorrente a dimensione fissa e meno memoria sui contesti lunghi
La Gated Delta Network (GDN) sostituisce l'attenzione standard nella maggior parte dei layer. Nei transformer tradizionali, la KV cache cresce insieme alla lunghezza della sequenza; GDN utilizza invece uno stato ricorrente di dimensione fissa. Nei layer GDN la memoria resta costante indipendentemente dalla lunghezza del contesto e il costo computazionale cresce linearmente anziché quadraticamente. I layer con attenzione completa dell'architettura ibrida continuano comunque a usare una KV cache per il recupero preciso delle informazioni.
La conseguenza pratica è importante: i carichi di lavoro con contesti lunghi diventano molto più economici. Una conversazione da 100K token non richiede una KV cache capace di contenere altri 100K token. Secondo l'analisi della community sulla scheda ModelScope rimasta visibile per poco, la configurazione dell'architettura Qwen3.8 prevede 69 layer GDN e 23 layer con attenzione completa, con un rapporto di circa 3:1. I layer full-attention preservano la qualità del recupero globale, mentre GDN gestisce la maggior parte dell'elaborazione della sequenza.
Per Qwen non è una novità assoluta. Qwen3-Next (settembre 2025) aveva introdotto Gated DeltaNet con 80B di parametri totali e 3B attivi, mentre secondo diverse ricostruzioni le famiglie Qwen3.5/3.6/3.7 hanno mantenuto un pattern ibrido simile. La novità di Flash-Next è la scala: 125B di parametri totali con questa architettura, a cui si aggiungono i due componenti descritti di seguito.
QSA: attenzione sparsa, ma i dettagli sono ancora un mistero
La Qwen Sparse Attention (QSA) compare nella scheda, ma non viene spiegata. L'ipotesi prevalente nella community è che sostituisca l'attenzione densa con uno schema sparso: ogni token presterebbe attenzione solo a un sottoinsieme degli altri token, invece che all'intera sequenza. Non è però chiaro se QSA utilizzi sparsità appresa, block sparsity, finestre scorrevoli o una combinazione di queste tecniche. Il technical report dirà se si tratta di un miglioramento incrementale o di una primitiva di attenzione realmente nuova.
La tabella n-gram da 51B: decoding speculativo senza un modello draft
L'elemento più insolito è una tabella di embedding n-gram da 51B di parametri. L'ipotesi di lavoro della community è che funzioni come un sistema rapido di lookup dei token, una sorta di modello draft integrato per il decoding speculativo. Invece di eseguire un piccolo modello separato per prevedere i token successivi e verificarli poi con il modello principale, la tabella n-gram fornirebbe direttamente candidati economici per il token successivo.
Le domande aperte non sono poche: la tabella deve risiedere nella VRAM o può essere mappata in memoria? Come si comporta dopo la quantizzazione? È già inclusa nel dato complessivo di 125B o va considerata separatamente? Finché il technical report o i primi benchmark della community non daranno una risposta, è meglio trattare il numero 51B come una variabile per la pianificazione del deployment, non come un costo fisso.
Dove si colloca Flash-Next nella famiglia Qwen
Flash-Next segue un percorso parallelo, non una progressione lineare:
| Modello | Rilascio | Parametri totali | Parametri attivi | Ruolo |
|---|---|---|---|---|
| Qwen3-Next | Set 2025 | 80B | 3B | Primo test dell'architettura GDN |
| Qwen3.8-27B | Ago 2026 | 27B (denso) | 27B | Modello denso tuttofare di fascia media |
| Qwen3.8-Max | Ago 2026 | ~2.4T | ~95B | Modello di punta, con pesi open |
| Qwen3.8-Flash-Next | 26 ago 2026 | ~125B | ~6B | Anteprima dell'architettura Qwen4 |
| Qwen4 | TBD (mesi) | Sconosciuti | Sconosciuti | Famiglia next-gen completa |
La regola empirica adottata dalla community è questa: sqrt(125B x 6B) = 27B. Se l'approssimazione regge, Flash-Next potrebbe offrire una qualità paragonabile a quella di un modello denso da 27B, con un costo computazionale in inferenza più vicino a quello di un modello da 6B. Come ha osservato Lucas Souza di Beer And Code, si tratta di una regola pratica, non di un teorema: qualità del routing, qualità dei dati e contributo della tabella n-gram non sono ancora stati misurati.
La strategia, descritta in diverse analisi della community come una "platform play, not a benchmark play", consiste nel permettere a framework di inferenza come llama.cpp, vLLM e SGLang di aggiungere il supporto ai kernel prima dell'arrivo di Qwen4. Unsloth ha annunciato di essere al lavoro sul supporto dal day zero.
Si può davvero eseguire? Il punto sull'hardware necessario
| Formato | Memoria approssimativa per i pesi |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4-bit | ~65–70 GB |
Si tratta della memoria occupata dai soli pesi, senza contesto, KV cache né overhead del runtime. Un modello quantizzato in Q4 richiederebbe circa 65–70 GB solo per i pesi principali, a cui va aggiunto lo spazio necessario alla tabella n-gram da 51B. Se la tabella deve restare nella VRAM, il totale supera le capacità della maggior parte delle configurazioni a macchina singola. Se invece può essere mappata nella RAM di sistema, potrebbe essere sufficiente una macchina con almeno 128GB di memoria unificata — Mac Studio (M2 Ultra / M3 Ultra al massimo della configurazione), AMD Strix Halo, NVIDIA DGX Spark. Una singola RTX 4090 o 5090 non basta.
Su Reddit, u/KURD_1_STAN ha contestato la definizione di modello "adatto all'esecuzione locale": "Con i prezzi della RAM così alti, come fai a chiamarlo adatto all'uso locale?" La distanza tra il messaggio promozionale dei "6B attivi" e i 250GB di memoria necessari è concreta. Su X, @Dicklong1999 ha osservato che il pattern di attivazione sparsa potrebbe garantire una velocità di generazione ragionevole a chi dispone dell'hardware, ma "125B, per la gente comune è praticamente impossibile eseguirlo in locale".
Disponibilità e prezzi via API: cosa aspettarsi
Al momento della pubblicazione, prezzi e disponibilità via API di Qwen3.8-Flash-Next non erano stati annunciati. Qwen3.8-Max costa $2.00/M per gli input e $6.00/M per gli output, secondo la pagina ufficiale dei prezzi di Qwen; con 6B di parametri attivi, Flash-Next dovrebbe essere molto più economico. La variante FP8 dimezza la memoria necessaria per i pesi rispetto a BF16, diventando quindi un formato naturale per il serving via API. La disponibilità dipenderà dal supporto dei framework di inferenza: conviene controllare i cataloghi dei provider dopo il rilascio dei pesi.
Cosa preparare prima del rilascio dei pesi
Se sei uno sviluppatore o un ricercatore e vuoi capire se Qwen3.8-Flash-Next può avere un ruolo nel tuo stack, questa è la checklist da seguire:
1. Controlla l'hardware. Se intendi eseguirlo in locale, assicurati di avere almeno 128GB di memoria unificata oppure una configurazione multi-GPU. In caso contrario, dovrai puntare sull'accesso via API.
2. Tieni d'occhio il repository su Hugging Face. La model card sarà la prima fonte attendibile per specifiche effettive, licenza e lunghezza del contesto. Salva huggingface.co/Qwen/Qwen3.8-Flash-Next.
3. Prepara la pipeline di valutazione. Predisponi prompt, benchmark e script di valutazione prima del rilascio dei pesi. Le prime 24 ore di test della community diranno più di qualsiasi numero ufficiale.
4. Non spostare i carichi di produzione. Non esistono ancora benchmark indipendenti. L'architettura è nuova, il supporto runtime è acerbo e la licenza non è confermata. Usalo per le valutazioni, non per attività la cui interruzione avrebbe un costo.
5. Se mantieni strumenti di inferenza, comincia subito. La combinazione GDN + QSA richiede lavoro sui kernel, non semplici modifiche di configurazione. Prima comprenderai l'architettura, prima potrai distribuire il supporto.
FAQ
Quando saranno disponibili i pesi?
Il conto alla rovescia di ModelScope indicava il 26 agosto 2026, intorno alle 23:00 UTC+8. I mirror su Hugging Face compaiono in genere entro poche ore dal rilascio su ModelScope. Il team Qwen ha confermato la tempistica attraverso i canali ufficiali: @Alibaba_Qwen ha anticipato "what surprise we're dropping tonight" e @QwenDevs ha nominato direttamente il modello.
È Qwen4?
No. È un'anteprima dell'architettura Qwen4 che utilizza la convenzione di denominazione Qwen3.8. Qwen4 dovrebbe arrivare tra mesi, non tra settimane. Flash-Next serve a preparare il supporto runtime dell'ecosistema prima dell'arrivo della famiglia completa.
Quale licenza utilizza?
Non è confermato. I recenti modelli Qwen open-weight, Qwen3.8-27B e Qwen3.8-Max, hanno utilizzato Apache 2.0, che resta l'esito più probabile. La verifica definitiva andrà fatta sulla model card quando i pesi saranno disponibili.
Posso eseguirlo su una RTX 4090?
No. Anche con la quantizzazione Q4, i soli pesi principali richiedono circa 65–70 GB. Una singola RTX 4090 dispone di 24 GB. Serve un sistema con almeno 128GB di memoria unificata, come Mac Studio o Strix Halo, oppure più GPU con molta VRAM.
È più potente di Qwen3.8-27B?
Non si sa. Non esistono benchmark. L'euristica sqrt(125B x 6B) = 27B suggerisce una qualità paragonabile a quella di un modello denso da 27B, ma si tratta di una stima, non di una misurazione. Bisogna aspettare valutazioni indipendenti sul proprio caso d'uso.
Quanto sarà veloce?
Il dato di 6B di parametri attivi per token fa pensare a una velocità di generazione più vicina a quella di un modello piccolo che a quella di un colosso da 125B. Restano però da chiarire il pattern di accesso alla memoria della tabella n-gram e l'efficienza dei kernel GDN. Saranno i primi benchmark della community a fornire una risposta.
Sarà disponibile sulle piattaforme API?
Quasi certamente. La variante FP8 sembra pensata proprio per il serving via API. AIReiter e altre piattaforme aggiungono in genere i modelli Qwen entro pochi giorni dal rilascio dei pesi. Il collo di bottiglia sarà il supporto dei framework ai nuovi meccanismi di attenzione.
Che fine ha fatto Qwen3-Next dell'anno scorso?
Qwen3-Next è stato lanciato a settembre 2025 con 80B di parametri totali e 3B attivi, introducendo Gated DeltaNet. Era un test dell'architettura su scala più contenuta e ha dimostrato che l'approccio ibrido GDN funzionava. Flash-Next ne è il seguito su scala maggiore. Un utente su X, @LufzzLiz, ha osservato che la serie Next dello scorso anno "was a letdown": proprio per questo, questa volta conviene aspettare i benchmark.