 AIREITER
Il 26 agosto 2026 non è lontano, e l'errore più rischioso è considerare il passaggio da Assistants API a Responses API un semplice cambio di nomi. OpenAI ha annunciato il ritiro di Assistants API con un anno di anticipo, nella comunicazione di deprecazione del 26 agosto 2025. Sulla carta le corrispondenze tra oggetti sono lineari; l'orchestrazione che ci sta sotto, molto meno. Anche alcuni sviluppatori che hanno seguito la guida ufficiale hanno introdotto regressioni in produzione. Vediamo cosa smette di funzionare, cosa nascondono le mappature e come muoversi in base al margine di tempo disponibile.
Dal 26 agosto 2026 cosa si interrompe e cosa resta disponibile
Dopo la scadenza, tutte le famiglie di endpoint Assistants restituiranno errori. La dismissione riguarda /v1/assistants, /v1/threads, i messaggi dei thread, run e run step, compreso qualunque flusso che invii ancora l'header OpenAI-Beta: assistants=v2. Configurazioni degli Assistant e cronologia dei thread non saranno più accessibili via API.
Non tutto ciò che fa parte di un'integrazione Assistants viene però eliminato:
| Non disponibile dal 26 agosto 2026 | Resta disponibile |
|---|---|
Endpoint CRUD /v1/assistants | Vector store e file caricati, riutilizzabili con il file search di Responses |
/v1/threads, messaggi dei thread | Chat Completions API, non coinvolta dalla dismissione |
| Run e run step | Responses API e Conversations API |
Workflow con OpenAI-Beta: assistants=v2 | Realtime API |
Nel proprio tracker delle deprecazioni, OpenAI indica Responses e Conversations come sostituti designati:
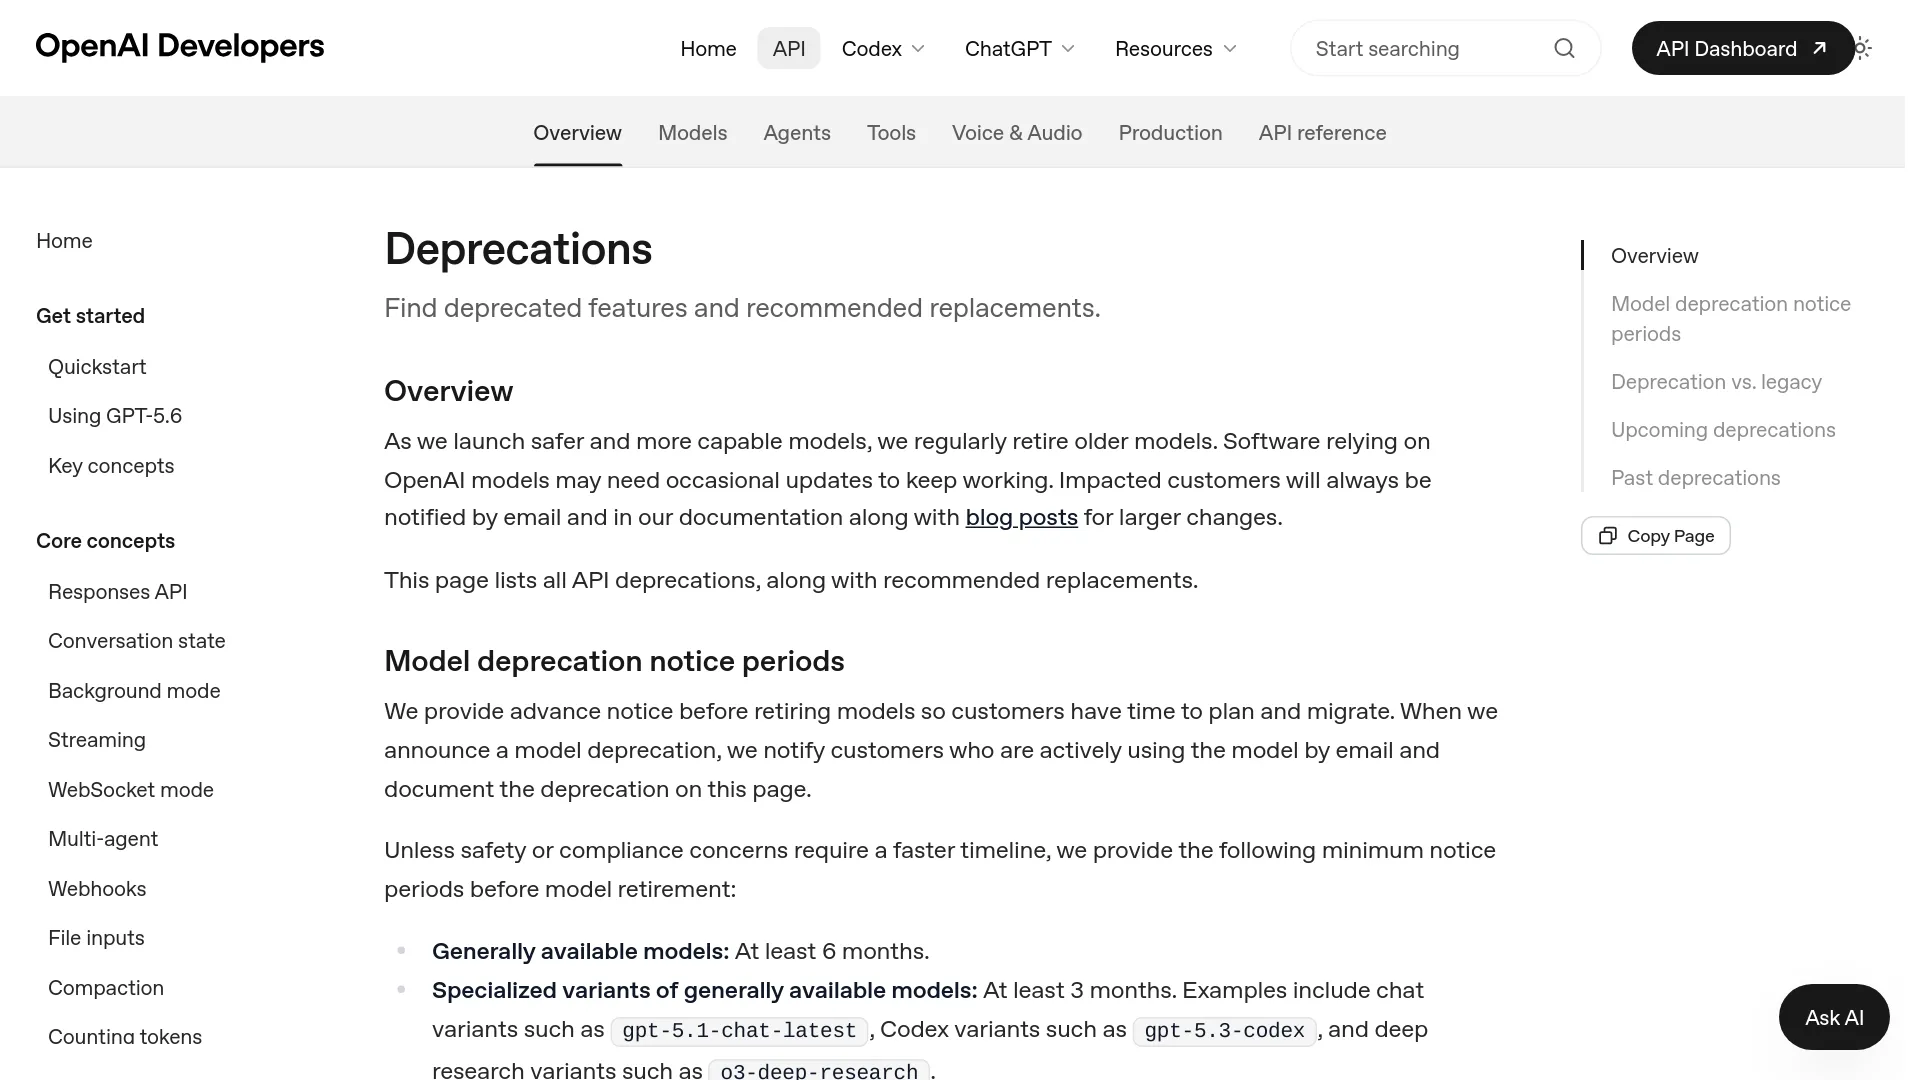
Dagli oggetti Assistants a Responses: le due differenze che contano davvero
La guida alla migrazione di OpenAI associa quattro concetti di Assistants ai rispettivi equivalenti nell'ecosistema Responses:
| Assistants API | Sostituto | Cosa cambia davvero |
|---|---|---|
Assistants | Prompts | La configurazione passa a un oggetto versionato, creato dalla dashboard |
Threads | Conversations | Conserva item generici, inclusi messaggi, chiamate di tool e output dei tool, non soltanto messaggi |
Runs | Responses | Il ciclo create-run-poll-retrieve diventa una singola chiamata responses.create |
Run steps | Items | Un union type che comprende messaggi, function call e risultati |
Il cambiamento del ciclo è evidente negli esempi ufficiali: un run completato su gpt-4.1 riporta 34 token di prompt e 130 token di completamento, mentre una response completata su gpt-5.5 indica 17 token di input e 150 token di output. Il carico di lavoro ha una forma analoga, ma i campi hanno nomi diversi.
Ed è qui che arriva la prima nota importante. Dashboard di fatturazione e parser dei payload basati sui vecchi campi di utilizzo possono smettere di funzionare senza segnalazioni esplicite:
| Campo Assistants | Campo Responses |
|---|---|
usage.prompt_tokens | usage.input_tokens |
usage.completion_tokens | usage.output_tokens |
max_completion_tokens / max_prompt_tokens | max_output_tokens |
truncation_strategy | truncation |
object: "thread.run" | object: "response" |
La seconda nota riguarda l'architettura. I Prompts si possono creare solo dalla dashboard, non tramite API: un limite che rompe i sistemi in cui viene creato dinamicamente un Assistant per cliente, workspace o set di documenti. La stessa guida ufficiale consiglia di verificare la timeline di deprecazione dei prompt prima di adottare questi oggetti in integrazioni destinate a durare, perché anche gli oggetti prompt riutilizzabili comportano un proprio rischio di sunset. Il modello più solido consiste nel mantenere istruzioni, schemi dei tool e scelta del modello nel proprio source control, inviandoli a ogni richiesta. Sulla cronologia dei thread, la posizione di OpenAI è esplicita: "We will not provide an automated tool for migrating Threads to Conversations."
Come spostare i tre tool integrati
Ogni tool di Assistants ha una destinazione precisa in Responses, ma una parte del lavoro passa all'applicazione:
| Tool Assistants | Equivalente in Responses | Nuova responsabilità dell'applicazione |
|---|---|---|
| File search | I vector store restano disponibili; nella definizione del tool va passato vector_store_ids a ogni richiesta | Risolvere gli ID degli store corretti prima di ogni chiamata |
| Code interpreter | Container configurato con type: "auto" | Ciclo di vita del container |
| Functions | Rimosso il livello annidato function; name, description e parameters salgono di un livello | Il ciclo del tool: eseguire la chiamata, restituire il risultato con il relativo call_id, decidere se proseguire il ciclo |
Per le applicazioni multi-tenant, il punto apparentemente marginale è il file search. Prima l'associazione tra tenant e vector store poteva essere configurata una volta sull'oggetto Assistant; ora il tenant proprietario della sessione in arrivo deve essere risolto negli ID degli store corretti prima di inviare la richiesta.
Gli intoppi incontrati da chi ha già completato la migrazione
Secondo OpenAI, Responses ha raggiunto la feature parity. Le esperienze di migrazione mostrano però una parità a livello di oggetti, accompagnata da un refactoring concreto sotto la superficie. Il responsabile di un chatbot SaaS multi-tenant ha documentato su r/aiagents una migrazione di due settimane, in cui i problemi sono emersi nonostante un'applicazione fedele della guida ufficiale:
Ho dovuto adattare ogni campo opzionale come
["type", "null"], e sembra un espediente per aggirare il sistema di tipi. — u/aidenclarke_12
Gli schemi rigidi dei tool richiedono che le proprietà opzionali siano dichiarate nullable e inserite comunque in required. Gli schemi quindi crescono, e ogni handler che interpretava l'assenza di un campo come assenza effettiva va riesaminato. Lo stesso sviluppatore ha individuato il punto in cui si concentra il cambiamento più profondo:
Il cambiamento nell'infrastruttura dei vector store è il vero passaggio architetturale. — u/aidenclarke_12
Lo streaming è il secondo elemento che può rompersi senza essere subito evidente. Lo streaming dei run Assistants non si adatta automaticamente a Responses: va riscritto sui server-sent event tipizzati, come response.created, response.output_text.delta, response.completed e response.function_call_arguments.delta / .done. Ci sono eventi di completamento espliciti e nuove strutture per gli eventi delle tool call; i nomi degli eventi sono raccolti nella copertura della migrazione. Vanno aggiornati sia i proxy SSE sia gli handler client, compresa la logica di riconnessione.
Il terzo ostacolo non dipende direttamente dall'API, ma dal ritardo dell'ecosistema:
La Responses API esiste da tempo, ma molti framework e SDK ancora non la supportano. — u/zhlmmc
Se lo stack poggia su un framework per agenti che continua a dare per scontato il modello Threads/Runs, come nel caso riportato da u/zhlmmc, bisogna prevedere tempo anche per quel livello, non solo per il codice di integrazione interno.
Gestire il contesto: chain, Conversations o replay manuale
In Responses ci sono tre modi per mantenere il contesto nelle conversazioni multi-turn, e non sono equivalenti:
| Strategia | Ideale per | Attenzione a |
|---|---|---|
previous_response_id | Chain più semplice, con modifiche minime | Il contesto precedente resta input fatturabile |
| Conversations API | L'equivalente più vicino a Threads; cronologia lato server | Il backfill va costruito internamente; non esiste uno strumento del fornitore |
Replay manuale, store: false | ZDR e requisiti rigorosi di conservazione | Tutto lo stato resta a carico dell'applicazione; i reasoning item devono essere inoltrati |
Per convertire la cronologia di un vecchio thread, OpenAI raccomanda questa sequenza:
- Elencare i messaggi del thread in ordine crescente.
- Convertire ogni messaggio testuale dell'utente in
input_text. - Convertire ogni messaggio testuale dell'assistente in
output_text. - Convertire i contenuti con URL immagine in
input_image, preservandoimage_urledetail. - Creare la Conversation con gli
itemsconvertiti.
Una mappatura errata dei ruoli produce un problema molto specifico: il modello interpreta le proprie risposte passate come nuove istruzioni dell'utente. Le response archiviate hanno un TTL predefinito di 30 giorni, salvo il passaggio di store: false. Le conversation restano invece fuori da quel TTL e, alla fine di luglio 2026, non risultava pubblicata una durata distinta, secondo la copertura sulla migrazione che ne ha seguito l'evoluzione. È un dettaglio rilevante se le informative promettono una finestra di cancellazione precisa.
L'impatto della migrazione sul costo dei token
Sul fronte della fatturazione, contano due aspetti.
Il primo: previous_response_id è una comodità, non uno sconto. La guida di migrazione a Responses di OpenAI chiarisce che gli input token precedenti nella catena di response vengono comunque fatturati come input token. Senza potatura del contesto, le conversazioni lunghe crescono quindi linearmente.
Il secondo: l'input in cache costa molto meno dell'input non in cache, circa un decimo della tariffa input nelle fasce GPT-5.x elencate a luglio 2026. Inoltre, nei test interni riportati da OpenAI, Responses ha ottenuto un utilizzo della cache migliore del 40–80% rispetto a Chat Completions, secondo la copertura raccolta. Considerate questa percentuale come un dato del fornitore finché le vostre dashboard non la confermano. Il confronto davvero utile è il conteggio token per sessione, prima e dopo il cutover.
Se la migrazione è anche l'occasione per rivedere il prezzo del carico di lavoro GPT-5.x, la guida ai prezzi di GPT-5.6 spiega il calcolo per token; endpoint compatibili con OpenAI come la pagina API di GPT-5.6 eseguono gli stessi workload in stile Responses, permettendo un confronto diretto.
Un piano di migrazione proporzionato al tempo rimasto
Restano 1–6 giorni. Partite dal backup: elencate assistant e vector store con limit=100, recuperate i file e serializzate gli oggetti SDK con model_dump(). Le guide che mettono il backup al primo posto segnalano un limite netto: non esiste un endpoint list-threads, quindi potete esportare soltanto gli ID dei thread già conservati dalla vostra applicazione. Poi eseguite il cutover dietro un flag: le nuove sessioni passano subito a Responses, mentre il backfill dei vecchi thread avviene in modo lazy solo quando un utente li riapre.
Resta almeno una settimana. Prima di intervenire sul resto, convertite end-to-end un flusso a basso rischio. Ricostruite il ciclo dei tool e verificate che ogni risultato di funzione riporti il corrispondente call_id; sostituite la gestione dello stream con logica basata sul tipo di evento; quindi confrontate comportamento, latenza, utilizzo dei token e tassi di errore con la baseline di Assistants, prima di estendere il traffico.
La scadenza è passata. Gli endpoint restituiscono errori e le configurazioni degli assistant non sono più disponibili dal lato API. Il recupero significa ricostruire da ciò che resta nel database applicativo e nei backup, mentre vector store e file rimangono accessibili tramite file search.
Resta un compromesso da valutare: si sostituisce un ciclo di vita gestito dal server, con polling, troncamento e tool loop, con un modello a chiamata singola in cui l'orchestrazione è visibile e testabile. Uno sviluppatore che ha rilasciato prodotti con entrambi gli approcci ha sintetizzato così il risultato:
Responses API è il compromesso ideale: gestisce il lavoro pesante, ma resta abbastanza flessibile da consentire la gestione delle funzionalità personalizzate. — u/landongarrison
FAQ sulla dismissione di OpenAI Assistants API
Verrà dismessa anche Chat Completions API?
No. Chat Completions non rientra nella dismissione del 26 agosto 2026. Le indicazioni di OpenAI la trattano come migrabile verso Responses un flusso alla volta, senza una scadenza obbligatoria.
OpenAI migrerà automaticamente i thread esistenti?
No. La guida ufficiale afferma chiaramente: "We will not provide an automated tool for migrating Threads to Conversations." Il backfill va implementato nel codice applicativo, seguendo la sequenza di conversione degli item riportata sopra.
Posso continuare a usare Assistants API dopo il 26 agosto 2026?
No. Assistant, thread, messaggi, run e run step restituiranno tutti errori dopo quella data, inclusi i workflow assistants=v2. Esportate tutto ciò che vi serve prima della scadenza.
Le response archiviate scadono?
Sì. Le response archiviate hanno per impostazione predefinita una finestra di conservazione di 30 giorni, salvo l'uso di store: false; secondo quanto riportato a luglio 2026, le conversation restano fuori da questo TTL.
Devo trasferire la configurazione del mio assistant nei Prompts?
No; per assistant generati dinamicamente, non dovreste farlo. I Prompts si creano solo dalla dashboard e la guida ufficiale stessa invita a verificare la deprecazione degli oggetti prompt riutilizzabili. Conservare istruzioni e schemi dei tool nel source control, inviandoli a ogni richiesta, è l'approccio più duraturo.