 AIREITER
Su OpenRouter, Muse Spark 1.3 è attualmente indicato a 1,25 dollari per milione di token in input e 4,25 dollari per milione di token in output. Il prezzo, però, è solo una parte della valutazione. Il modello sembra particolarmente adatto al coding con contesti estesi e ai workflow con agenti; il lancio è ancora recente, il livello di reasoning max non era disponibile all’esordio e la latenza al primo token può essere elevata.
Muse Spark 1.3: cos’è e cosa significa davvero “disponibile”
Muse Spark 1.3 è il modello proprietario di Meta pensato per attività agentiche di lunga durata, programmazione e scenari multimodali. Meta lo ha annunciato il 2 settembre 2026, spiegando che la distribuzione sarebbe partita da Muse Code e dalla Meta Model API. Le modalità di reasoning già esistenti erano disponibili per prime, mentre il reasoning max richiedeva ulteriori test di sicurezza. (L’annuncio di Meta AI Research)
La grafica del lancio include risultati ottenuti con il livello max, ma poiché il reasoning max era ancora sottoposto a ulteriori verifiche di sicurezza, non bisogna dare per scontato che quei risultati fossero riproducibili fin dal primo giorno.
Secondo Meta, Muse Spark 1.3 conserva meglio i vincoli durante i task lunghi, gestisce le interruzioni all’interno dello stesso thread, pone domande di chiarimento, chiede conferma prima di compiere azioni importanti e riconosce più facilmente quando è bloccato. L’azienda dichiara inoltre circa il 20% in meno di chiamate agli strumenti e il 25% in meno di token rispetto a Muse Spark 1.2 nei propri confronti interni sul coding. Sono però dati forniti dal produttore, senza un set di task riproducibile né intervalli di errore.
Il post di lancio presenta i pesi open source come un obiettivo futuro della roadmap. Le fonti consultate per questa analisi descrivono Muse Spark 1.3 come un modello disponibile esclusivamente tramite hosting/API e non documentano un checkpoint scaricabile, una licenza confermata, il numero di parametri o i requisiti hardware.
Il listino API è chiaro, ma il costo reale dipende dal workflow
Il listino pubblico più chiaro è quello della pagina OpenRouter di Muse Spark 1.3, non il post di lancio di Meta. OpenRouter indica tariffe standard di 1,25 e 4,25 dollari per milione di token in input e output, oltre a costi separati per la lettura della cache e le ricerche web.
| Utilizzo | Prezzo indicato | Cosa considerare |
|---|---|---|
| Input | 1,25 $ / 1M token | Token nuovi del prompt e del contesto |
| Output | 4,25 $ / 1M token | Circa 3,4 volte la tariffa dell’input |
| Lettura cache | 0,15 $ / 1M token | Utile per il contesto ripetuto degli agenti |
| Ricerca web | 2,50 $ / 1.000 chiamate | Separata dai costi dei token |
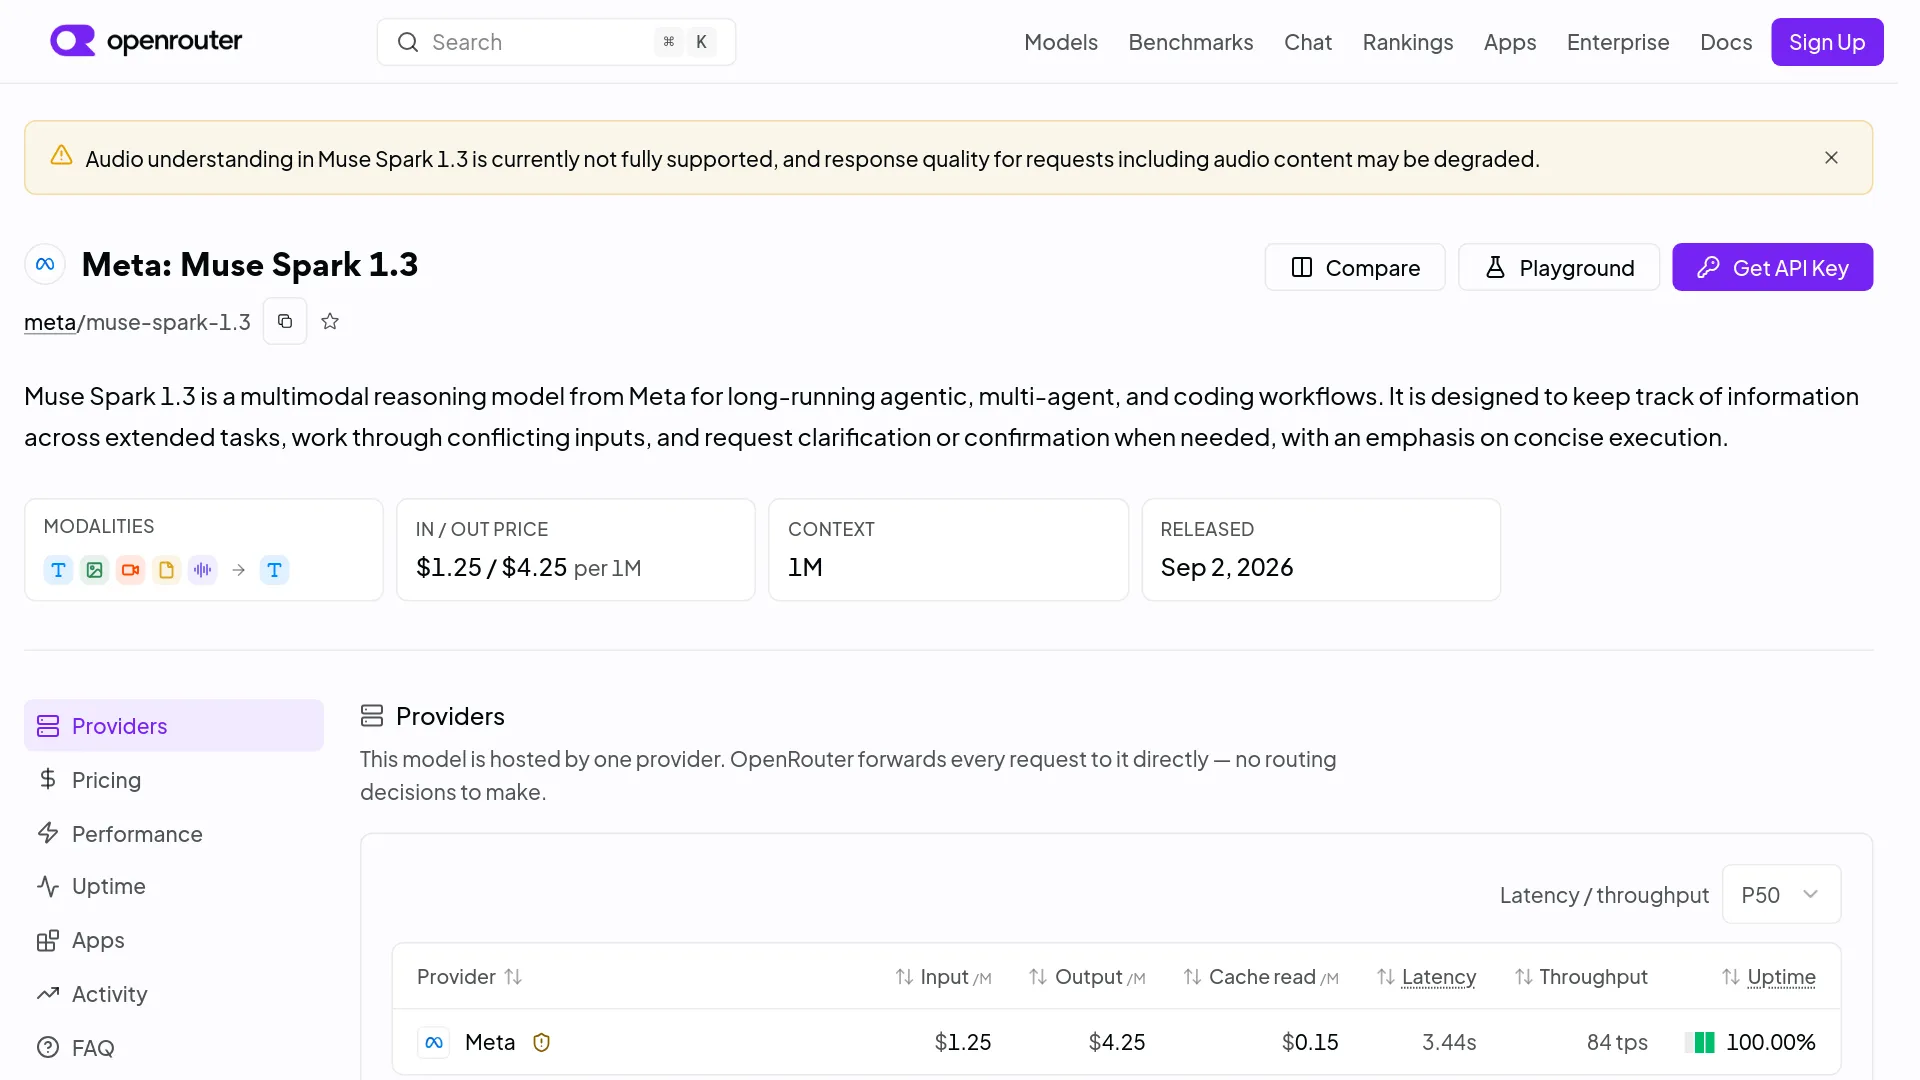
Una richiesta con 100.000 token freschi in input e 20.000 token in output costa circa 0,21 dollari, prima degli eventuali costi di cache o ricerca web: 0,125 dollari per l’input più 0,085 dollari per l’output. I loop degli agenti, i tentativi ripetuti e il contesto reinviato fanno aumentare il costo complessivo del task.
Artificial Analysis riporta un prezzo medio di 0,78 dollari per milione di token, calcolato su una combinazione con rapporto 7:2:1 tra cache hit, input e output. I workflow basati su contesto sempre nuovo o con molto output costeranno di più: questo valore va quindi letto come una stima di scenario, non come una tariffa universale.
Non trasferire automaticamente su Muse Spark 1.3 le ipotesi relative al piano Contributor della guida ai prezzi dell’API Muse Spark 1.2. Il listino pubblico della versione 1.3 conferma la tariffa standard indicata sopra, ma le fonti consultate non definiscono un contratto Contributor completo per la 1.3, con dettagli su utilizzo dei dati, limiti di frequenza o disponibilità regionale. Fino a diversa conferma del provider, conviene fare il budget sulla tariffa standard.
I dati parlano di un ottimo modello per il coding, non di un vincitore assoluto
Le evidenze disponibili sostengono l’idea di Muse Spark 1.3 come modello forte nel coding e nella gestione di contesti lunghi, non come leader universale. La tabella usa i punteggi della metodologia di valutazione collegata da Meta; le scale dei benchmark sono diverse e un numero più alto è confrontabile solo all’interno della propria riga.
| Valutazione | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | Più alto tra quelli mostrati |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
Il caso più convincente per Muse Spark 1.3 è il coding con contesti lunghi: il risultato max raggiunge 98.1 in MRCR con contesto 512K–1M e 75.4 in DeepSWE, contro rispettivamente 55.5 e 55.0 di Muse Spark 1.2 xhigh. La stessa tabella mostra però alternative più forti in alcune valutazioni legate al lavoro professionale, all’uso del computer e alla navigazione web.
La metodologia di Meta specifica che i dati possono provenire dalle valutazioni di Meta, da una leaderboard ufficiale oppure da risultati dichiarati autonomamente da un provider. I test di coding sono stati eseguiti con strumenti limitati e senza accesso a Internet esterno: sono quindi segnali utili, non il risultato di un confronto indipendente eseguito nuovamente da un unico soggetto.
Artificial Analysis riporta un punteggio Intelligence Index di 61, al numero 10 su 196 modelli comparabili, contro una mediana di 36 per la stessa categoria. ModelCap mostra un ModelCap Index di 81.7 e il quarto posto in classifica, ma assegna solo il 20% di supporto e una singola osservazione da benchmark pubblico. Sistemi così diversi portano alla stessa cautela: la base di evidenze è ancora limitata.
In un workflow reale, il primo test dovrebbe riguardare l’esplorazione di repository, gli agenti da terminale con task lunghi e le domande su una codebase. Non estendere automaticamente questi risultati a ogni attività di navigazione web o di utilizzo professionale del computer.
Il paradosso della velocità: rapido quando parte, lento prima di partire
Muse Spark 1.3 sembra veloce durante la generazione, ma la prima risposta visibile può richiedere molto più tempo. Il profilo è quindi più adatto ad attività prolungate o batch che a un ciclo di pair programming interattivo, dove ogni turno deve iniziare senza attese.
Artificial Analysis indica 181,7 token generati al secondo, contro una mediana di 68,1 per i modelli comparabili. Riporta inoltre 27,51 secondi prima del primo token, contro una mediana di 3,04 secondi, e stima 41,26 secondi per una risposta da 500 token nel proprio scenario di carico. La pagina del provider mostra un tempo di 38,51 secondi prima del primo token della risposta e un costo di 0,55 dollari per task dell’Intelligence Index.
OpenRouter mostra valori P50 diversi: 62 token al secondo e 1,83 secondi di latenza. Le metriche non sono direttamente intercambiabili, perché le pagine usano carichi di lavoro e definizioni differenti; inoltre Artificial Analysis include il tempo di reasoning nella metrica relativa alla prima risposta. Nel proprio ambiente di test conviene misurare sia il tempo al primo token sia la durata totale del task.
“Visto che qualcuno lo chiedeva, la mia prima impressione (lo sto usando ora) è che sembri meccanico (ottimo per lavorare, non so per la strategia) e molto capace. Sembra davvero veloce.” — u/NewYak4281, r/singularity
Questa prima impressione, non controllata, è coerente con il compromesso misurato: generazione rapida dopo un’attesa potenzialmente lunga e uno stile di interazione che può risultare meccanico. È un elemento di contesto, non un sostituto di un test controllato.
Funzioni API e limiti da verificare prima di usarlo in produzione
Muse Spark 1.3 offre le funzioni di integrazione attese da un moderno modello per agenti, ma diversi dettagli operativi restano dipendenti dal provider o non sono stati resi pubblici. Le indicazioni API più solide arrivano dalla pagina live del modello su OpenRouter e dal monitoraggio dei provider di Artificial Analysis, non da una specifica pubblica completa di Meta inclusa nel post di lancio.
| Funzione o limite | Evidenze attuali | Implicazioni per la produzione |
|---|---|---|
| Finestra di contesto | OpenRouter e ModelCap indicano 1.048.576 token | Confermare il limite effettivo dell’endpoint |
| Output massimo | ModelCap indica 944K token | I limiti di output del provider possono essere inferiori |
| Input | Testo, immagini, video e file; l’audio è indicato con un’avvertenza | Considerare incompleta la comprensione dell’audio |
| Output | Testo | Progettare un workflow mediato dal testo |
| Chiamate agli strumenti | Indicate come supportate | Testare gli schemi e la gestione degli errori degli strumenti nel proprio SDK |
| Output strutturato | È indicato il formato di risposta JSON-schema | Verificare i casi di errore con schema rigido |
| Copertura dei provider | Un solo provider Meta è visibile sulla pagina OpenRouter e nel tracker di Artificial Analysis | Non dare per scontata la ridondanza in caso di guasto |
| Pesi del modello | Solo API; non sono indicati pesi scaricabili | Non è stato definito un percorso per il self-hosting |
ModelCap avverte che un singolo provider può esporre un limite di contesto o di output inferiore al massimo pubblicato. Il pannello di disponibilità di OpenRouter mostra un uptime del 99,97% su tre giorni, ma valori inferiori nelle viste a 72 e 24 ore. Si tratta di metriche diverse della pagina: per instradare traffico di produzione è quindi meglio usare i dati di stato più recenti insieme ai propri log degli errori.
Nel post di lancio Meta non pubblica il numero di parametri, l’architettura, limiti API formali, condizioni di licenza o risultati dettagliati dei test di sicurezza. Afferma però che il modello resiste meglio agli attacchi di prompt injection e valuta meglio le azioni irreversibili, senza fornire percentuali di successo degli attacchi né un protocollo di red teaming riproducibile.
Conviene usare Muse Spark 1.3 adesso?
Muse Spark 1.3 merita un test immediato per il coding con contesti lunghi e per gli agenti che usano molti strumenti, soprattutto quando il basso costo dei token e la generazione prolungata contano più della rapidità della prima risposta. Non è ancora pronto per essere l’unico modello di produzione in sistemi sensibili alla latenza, fortemente basati sull’audio, soggetti a requisiti stringenti di privacy o dipendenti da una ridondanza critica.
| Situazione | Decisione |
|---|---|
| Repository di grandi dimensioni, domande sulla codebase, task lunghi da terminale | Testare prima Muse Spark 1.3 |
| Attività batch con agenti in cui conta la velocità dell’output | Buon candidato; misurare il costo totale del task |
| Pair programming interattivo | Usarlo solo se la latenza al primo token è accettabile |
| Workflow basato sull’audio | Aspettare oppure scegliere un modello con supporto audio confermato |
| Codice di clienti sensibili o dati regolamentati | Verificare prima il contratto relativo ai dati |
| Servizio mission-critical con necessità di failover | Mantenere un secondo modello e un percorso alternativo |
Un rollout a basso rischio è più utile dell’ennesimo screenshot di una leaderboard:
- Iniziare con un repository non sensibile e da cinque a dieci task fissi.
- Limitare shell, scrittura dei file, rete e strumenti distruttivi ai permessi minimi necessari.
- Registrare tasso di completamento, chiamate agli strumenti, latenza al primo token, durata, token utilizzati e costo fatturato.
- Confrontare gli stessi task con il modello di riferimento attuale e mantenere un fallback per timeout o modifiche a bassa confidenza.
Inserisci Muse Spark 1.3 dietro un flag di esperimento per gli agenti di coding e prendi la decisione sulla base del test con il repository, non della classifica del giorno del lancio. Il prezzo e i risultati sui contesti lunghi giustificano la prova; la risposta iniziale lenta, la disponibilità limitata dei provider, il supporto audio incompleto e la copertura ancora provvisoria dei benchmark sconsigliano invece un’adozione esclusiva.
FAQ su API e prezzi di Muse Spark 1.3
Muse Spark 1.3 è stato rilasciato ufficialmente?
Sì. Nell’annuncio del 2 settembre 2026, Meta afferma che Muse Spark 1.3 era in distribuzione su Muse Code e sulla Meta Model API. Il reasoning max era ancora in attesa di ulteriori test di sicurezza.
Dove posso accedere a Muse Spark 1.3?
Meta indica Muse Code e la Meta Model API. Anche OpenRouter elenca meta/muse-spark-1.3; l’accesso può variare in base al provider, all’account e alla regione.
Quanto costa Muse Spark 1.3?
Il listino OpenRouter indica 1,25 dollari per milione di token in input, 4,25 dollari per milione di token in output, 0,15 dollari per milione di token letti dalla cache e 2,50 dollari per 1.000 chiamate di ricerca web. Considerali come le tariffe OpenRouter citate, salvo che il provider diretto non confermi un proprio listino.
Muse Spark 1.3 ha una finestra di contesto da un milione di token?
OpenRouter e ModelCap indicano 1.048.576 token, mentre Artificial Analysis arrotonda a 1 milione. Verifica i limiti effettivi di contesto e output sull’endpoint che utilizzi.
Supporta immagini, video, strumenti e output JSON?
OpenRouter indica input testuali, immagini, video e file, oltre alle chiamate agli strumenti e agli output strutturati secondo JSON-schema. L’audio è inoltre elencato con un’avvertenza: il supporto alla comprensione non è completo.
Muse Spark 1.3 è open source o può essere eseguito in self-hosting?
Nelle fonti consultate non sono stati individuati pesi scaricabili né un pacchetto per il self-hosting. Meta descrive i pesi open source come un lavoro futuro della roadmap, non come un artefatto di Muse Spark 1.3 già disponibile.
Il reasoning max è disponibile?
Meta ha dichiarato che le modalità di reasoning esistenti sarebbero state disponibili per prime e che il reasoning max sarebbe arrivato dopo ulteriori test di sicurezza. L’annuncio non forniva una data precisa.
Posso dare per scontato che i prezzi Contributor di Muse Spark 1.2 valgano anche per la 1.3?
No. I termini Contributor della 1.2 sono documentati separatamente, ma le fonti consultate non definiscono un contratto Contributor completo per la 1.3. Fino a conferma di un tier diverso, di una policy sui dati e di un limite di frequenza specifico da parte del provider, fai il budget sulla tariffa standard della 1.3.
Esegui un piccolo benchmark su un repository non sensibile prima di passare alla produzione: confronta gli stessi task con il modello attuale e registra la latenza al primo token, le modifiche completate, le chiamate agli strumenti e il costo. È il modo più affidabile per decidere se adottarlo, molto più delle classifiche pubblicate il giorno del lancio.