 AIREITER
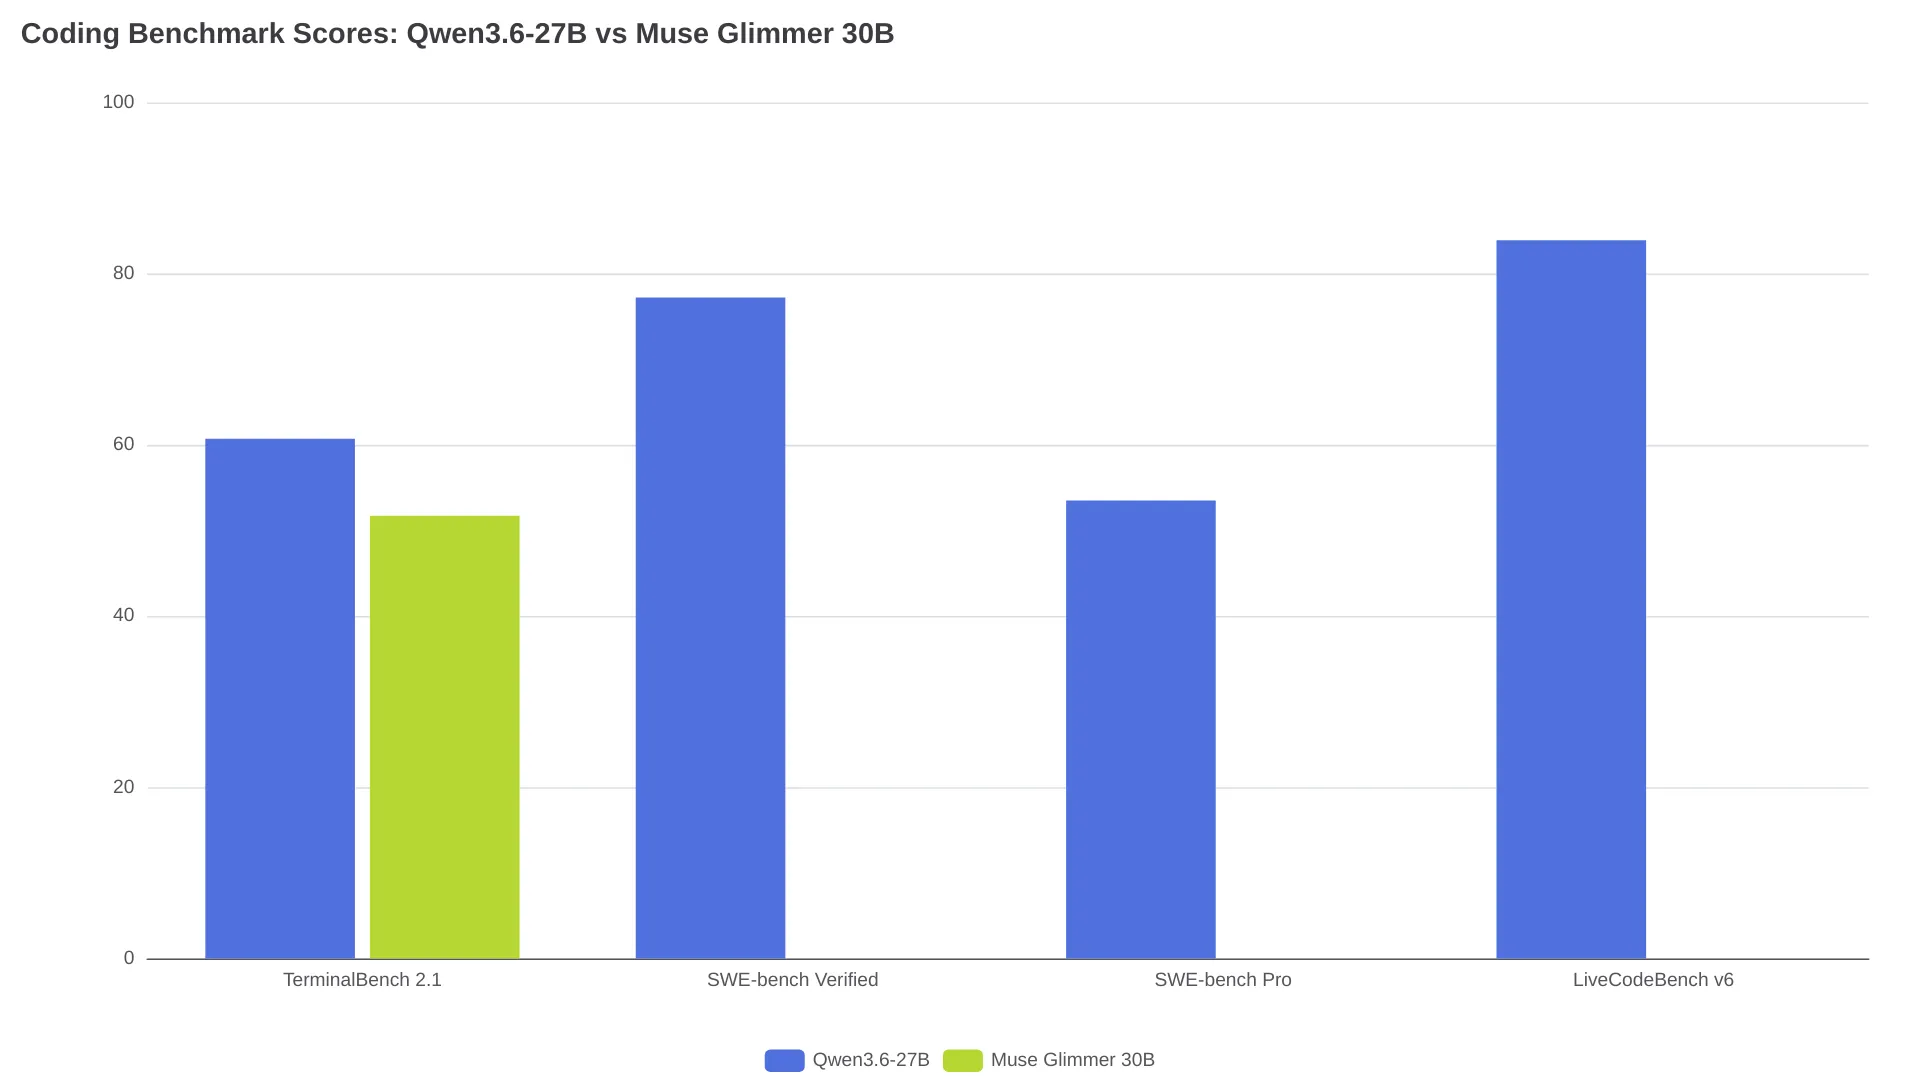
Nel confronto tra i due modelli open-weight per il coding, Qwen3.6-27B parte con numeri più convincenti: 60,7 su TerminalBench 2.1 contro 51,7 di Muse Glimmer 30B, oltre a un 77,2 ufficiale su SWE-bench Verified. Qwen3.6-27B è arrivato nell'aprile 2026 con una tabella benchmark completa nella sua model card su Hugging Face; Muse Glimmer 30B è seguito nell'agosto 2026 come rilascio Meta open-weight. Ma per chi esegue modelli in locale, le prestazioni pure non sono l'unico criterio: Glimmer offre un vantaggio VRAM che può fare la differenza su una singola GPU.
TerminalBench 2.1: Qwen avanti di 9 punti
TerminalBench valuta l'affidabilità degli agenti che operano da terminale attraverso più passaggi, compresi uso degli strumenti e mantenimento del contesto durante sessioni prolungate. Nelle discussioni della community collegate a questo confronto, TerminalBench 2.1 è il risultato di coding agent disponibile per il raffronto diretto.
Punteggi TerminalBench 2.1 riportati dalla community nelle discussioni r/LocalLLaMA del 10-11 agosto 2026:
| Modello | TerminalBench 2.1 | Tipo di fonte |
|---|---|---|
| Qwen3.6-27B | 60.7 | Riportato dalla community |
| Muse Glimmer 30B | 51.7 | Riportato dalla community |
| Gemma 4 31B | 43.4 | Riportato dalla community |
Va considerato un limite importante: TerminalBench misura la combinazione di modello e harness, non il solo modello base. La scheda ufficiale di Qwen3.6-27B indica un harness Harbor/Terminus-2 con timeout di 3 ore, 32 CPU, 48 GB di RAM, output massimo di 80K, contesto da 256K e media su cinque esecuzioni. Il punteggio di Glimmer potrebbe dipendere da un harness diverso o meno ottimizzato; il divario di 9 punti può quindi ridursi o ampliarsi in base alla configurazione del proprio agente.
Benchmark di coding pubblicati: Qwen ha dati, Glimmer non ancora
Qwen3.6-27B pubblica i propri benchmark ufficiali nella model card. Nelle fonti esaminate per questo confronto, ad agosto 2026 non emergono risultati ufficiali SWE-bench, LiveCodeBench o benchmark analoghi di coding agentico per Muse Glimmer. Qwen dispone quindi di evidenze pubblicate più solide, ma manca ancora uno scontro ufficiale diretto a parità di condizioni.
I benchmark ufficiali di Qwen per il coding:
| Benchmark | Qwen3.6-27B (ufficiale) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
Si tratta di risultati pubblicati dal fornitore. La model card precisa che le valutazioni SWE-bench usano lo scaffold interno bash/modifica file di Qwen, temperatura 1.0, top-p 0.95 e una finestra di contesto da 200K. I risultati SWE-bench Pro sono stati calcolati su un set di attività rivisto, nel quale Qwen ha corretto elementi problematici: il confronto diretto con i valori della classifica pubblica potrebbe quindi non essere omogeneo. L'analisi di terze parti di morphllm segnala inoltre che questi risultati si basano sullo scaffold agentico di Qwen e hanno ricevuto una riproduzione indipendente limitata.
Test di coding reali: cosa ha rilevato chi usa modelli locali
Test OpenCode Q4 su M5 Pro
Uno sviluppatore ha provato Muse Glimmer in quantizzazione Q4, build Unsloth, su un M5 Pro con 48 GB di RAM attraverso OpenCode. Il modello ha usato circa 20 GB di RAM e generato a 17 token al secondo. Il verdetto è stato:
"Nel complesso, è sotto Qwen3.6 27B" - u/curiousily_
L'output per frontend e backend è stato giudicato inferiore a Qwen, con un dato positivo: durante il test Muse Glimmer non ha fallito nessuna chiamata agli strumenti. Non erano stati configurati loop di ragionamento o thinking esteso, un fattore che potrebbe aver limitato le prestazioni di Glimmer.
L'insidia di max_tokens
Un altro tester su r/LocalLLM ha scoperto che Muse Glimmer può sembrare molto peggiore di quanto sia se il budget di token in output è troppo basso. Il modello consuma il budget nel ragionamento prima di produrre un output visibile, con risposte vuote o troncate. Aumentando max_tokens, il suo harness di test è passato da 6/13 a 11/13 attività superate, quasi raddoppiando il tasso di successo senza modificare il modello. Testare Glimmer con limiti di output predefiniti può quindi misurare la configurazione più del modello.
Loop nel terminale con Hermes
Un altro utente ha segnalato Muse Glimmer bloccato in un eccesso di comandi terminale con il framework agentico Hermes, un comportamento mai riscontrato con Qwen3.6-27B nella stessa configurazione. L'aneddoto è coerente, in termini generali, con il divario osservato su TerminalBench, ma non separa l'effetto del modello da quello della configurazione Hermes.
Efficienza token: vantaggio qualitativo
Il post con la galleria di benchmark di u/NoFaithlessness951 ha sollevato un altro aspetto, quello dell'efficienza:
"Un po' meno intelligente di Qwen, ma con molti meno token per attività." - u/NoFaithlessness951
È un'osservazione qualitativa della community, non una misurazione controllata dei token per attività completata con successo. Non esiste uno studio diretto che quantifichi il vantaggio di Glimmer sui token rispetto a Qwen usando attività, tassi di successo e dati di latenza equivalenti. Il dato va letto come uno spunto promettente, non come un fatto consolidato.
VRAM e contesto: il vantaggio hardware di Glimmer
È qui che Muse Glimmer prende nettamente il comando. Un tester su r/LocalLLaMA ha mostrato che Muse Glimmer 30B in Q4_K_XL, con decoding speculativo DFlash, proiettore multimodale e cache KV completa in F16, rientra in circa 22-23 GB su una sola RTX 3090, configurando una finestra di contesto da 262.144 token.
Stessa RTX 3090, stessa quantizzazione Q4_K_XL:
| Modello | Contesto KV F16 | Contesto KV Q8 | VRAM usata |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | Entra in 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | Entra in 24 GB |
L'autore ha definito i 70K di contesto F16 di Qwen "al limite dell'inutilizzabile" per flussi di lavoro che caricano nel prompt il contesto di repository di grandi dimensioni.
Prestazioni riportate per Muse Glimmer su quella configurazione RTX 3090:
- Generazione: 64-124 token al secondo, variabili tra codice e prosa
- Elaborazione del prompt: ~1.400 token al secondo
- Recupero in contesti lunghi: superato al primo tentativo un test haystack con due aghi a ~150K token
Sullo stesso hardware, Qwen3.6-27B richiede la compressione della cache KV in Q8, sacrificando fedeltà dell'output per lunghezza del contesto, oppure l'offload su una macchina più potente. Il tester riferisce di aver spostato Qwen sul proprio DGX Spark quando serviva il contesto completo, un dispositivo sensibilmente più costoso.
Su hardware di fascia più alta, una build NVFP4 di Qwen3.6-27B su DGX Spark ha raggiunto 28-33 token al secondo in sessione singola con contesti fino a 128K, secondo l'analisi benchmark di kie.ai. Una build Unsloth Muse Glimmer Q5_K_M su RTX 5090 avrebbe invece raggiunto 220-253 token al secondo per la generazione di patch di codice tramite un percorso DFlash di llama.cpp modificato.
Quale modello scegliere?
| Scenario | Scelta | Motivo |
|---|---|---|
| Solo coding, generazione one-shot | Qwen3.6-27B | Evidenze più forti nei benchmark di coding pubblicati; in testa nel confronto community disponibile su TerminalBench 2.1 |
| Coding agentico con contesto ampio su una sola GPU da 24 GB | Muse Glimmer 30B | 262K di contesto F16 contro 70K di Qwen sullo stesso hardware, con setup Q4_K_XL/DFlash |
| Attività terminali di lunga durata | Qwen3.6-27B | 60.7 contro 51.7 su TerminalBench 2.1; segnalazione della community di loop nel framework agentico per Glimmer |
| Carichi elevati sensibili ai costi | Muse Glimmer 30B (possibile) | Una segnalazione della community indica meno token per attività; manca un confronto omogeneo sul costo per successo |
| Coding a livello di repository con contesto ampio | Muse Glimmer 30B (con VRAM limitata) | Con 24 GB, Qwen richiede compressione KV Q8 o più GPU per gestire contesti grandi |
| Massima accuratezza nel coding, senza vincoli hardware | Qwen3.6-27B | Benchmark pubblicati più solidi e punteggi ufficiali |
FAQ
Muse Glimmer ha un punteggio SWE-bench ufficiale?
No. Nelle fonti esaminate per questo confronto, ad agosto 2026 non è stato trovato alcun punteggio ufficiale SWE-bench, LiveCodeBench o TerminalBench per Muse Glimmer 30B. Il 51.7 di TerminalBench 2.1 proviene da test della community nelle discussioni Reddit, non da una valutazione ufficiale Meta.
Entrambi i modelli possono girare su una singola RTX 3090?
Sì. Muse Glimmer 30B in Q4_K_XL entra in ~22-23 GB con contesto da 262K e cache KV F16 completa. Qwen3.6-27B in Q4_K_XL entra a sua volta, ma sulla stessa GPU è limitato a 70K di contesto F16 oppure a 125K con compressione della cache KV Q8.
Muse Glimmer è censurato per le attività di coding?
Un utente ha riferito che Muse Glimmer si è rifiutato di aiutare nel debug di codice Python per il controllo del mouse, presentandolo come un potenziale problema di sicurezza. Si tratta di un singolo resoconto aneddotico, con system prompt e configurazione non specificati. Non è sufficiente per stabilire se il comportamento derivi dal modello stesso o dal setup di inferenza.
Quale dei due è migliore per i flussi di coding agentico?
Per le attività terminali agentiche di lunga durata, Qwen3.6-27B appare più affidabile sulla base dei punteggi TerminalBench e delle segnalazioni della community. Muse Glimmer 30B è più pratico su hardware con risorse limitate grazie alla sua efficienza VRAM e potrebbe generare meno token per attività, riducendo potenzialmente costi e latenza nei loop agentici ad alto volume; manca però un confronto controllato che lo quantifichi.
Quale max_tokens usare per il coding con Muse Glimmer?
Imposta un budget di output generoso. Un tester ha rilevato che limiti stretti di max_tokens portavano Glimmer a esaurire il budget nel ragionamento prima di produrre output visibile, generando risposte vuote o troncate che sembravano fallimenti. Aumentando il limite, il suo harness di test è passato da 6/13 a 11/13 attività superate. La model card di Qwen3.6-27B consiglia 32,768 token per le query generiche e 81,920 per le attività benchmark difficili; fino a quando Meta non pubblicherà indicazioni proprie, lo stesso budget di output è un punto di partenza ragionevole per Glimmer.