 AIREITER
I modelli di embedding multi-vettore entrano ufficialmente tra i cittadini di prima classe di Sentence Transformers: la versione 6.0, annunciata il 18 agosto 2026, introduce MultiVectorEncoder accanto ai modelli dense, sparse e reranker. I benchmark di lancio di Hugging Face, però, raccontano una storia meno sensazionale dell'hype: la late interaction ha superato il gemello dense identico in 9 dei 13 dataset NanoBEIR, con un vantaggio medio di circa un punto NDCG@10. In compenso, nell'esempio pratico l'indice raw arriva a 42x la baseline MiniLM da 384 dimensioni e resta 21x più grande di un modello dense della stessa classe. Il punto non è quindi se sia migliore in assoluto, ma se il tipo di query giustifichi quel costo.
Come funzionano gli embedding multi-vettore e la late interaction
Un modello multi-vettore conserva un vettore per ogni token, invece di comprimere l'intero documento in un unico vettore aggregato. Nella gamma supportata da Hugging Face, i vettori dei token hanno convenzionalmente 128 dimensioni, contro le 384, 768 o 1.024 di un embedding dense tipico. Durante lo scoring, l'operatore MaxSim prende per ogni token della query il prodotto scalare più alto con uno qualsiasi dei token del documento, quindi somma questi massimi: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Poiché i modelli sono normalizzati L2, ciascun contributo ricade in [-1, 1] e il punteggio finale cresce con la lunghezza della query.
La late interaction si colloca quindi a metà strada fra le due architetture da cui prende ispirazione:
| Architettura | Lato documento | Scoring | Profilo dei costi |
|---|---|---|---|
| Bi-encoder dense | Un vettore aggregato, precalcolato | Un singolo prodotto scalare | Recupero più rapido; il pooling perde dettaglio a livello di token |
| Late interaction | Un vettore per token, precalcolato | MaxSim sulle coppie di token | Matching più ricco; l'indice cresce con la lunghezza del documento |
| Cross-encoder | Niente precalcolato | Forward pass completo per ogni coppia query-documento | Nel post di lancio di Hugging Face è il più accurato per singola coppia; troppo costoso come primo stadio |
Il paper originale su ColBERT ha formalizzato questo approccio con l'espressione "contextualized late interaction".
Il vantaggio emerge a livello di token. Nell'esempio di Hugging Face con lightonai/mLateOn, il token della query "live" trova una corrispondenza con il token del documento "inhabit" a 0.94 di similarità: un allineamento semantico senza alcuna sovrapposizione lessicale.
I casi in cui il multi-vettore fa davvero la differenza
I benchmark su passaggi brevi tendono a sottostimare gli scenari in cui questi modelli rendono di più. I casi forti ricorrono nelle cinque fonti confrontate per questo articolo: il post di lancio di Hugging Face, TopK, l'approfondimento tecnico di Qdrant, la guida alla produzione di Data AI Hub e il confronto sulla ricerca in produzione di Suhas Bhairav:
- Identificatori esatti in una ricerca semantica. Codici prodotto, nomi di funzioni, cognomi, stringhe di errore, numeri di clausola. Un vettore aggregato li sfuma; i vettori per token li mantengono individuabili.
- Query composte da più vincoli. "X con Y e Z": ogni token della query può trovare autonomamente il token del documento che lo supporta, senza che un vincolo venga diluito nella media.
- Documenti lunghi in cui la risposta è nascosta in un passaggio secondario. Nel benchmark multilingue MLDR sui documenti lunghi, il multi-vettore
mLateOnha ottenuto 77.92 contro 51.59 dimDenseOn: un divario di un ordine di grandezza superiore alle medie sui passaggi brevi. - PDF, tabelle e pagine scansionate. I modelli della famiglia ColPali indicizzano direttamente le immagini delle pagine usando query testuali, evitando l'OCR. Il post di lancio di Hugging Face definisce il retrieval visivo di documenti il territorio state of the art della late interaction; l'analisi di TopK riporta che un retriever multi-vettore compatto ha superato di +34% recall un modello a vettore singolo 80x più grande su ViDoRe v3, facendo salire il recall sui documenti industriali da circa 42% a 76%.
- Vocabolario fuori dominio. Il post di lancio di Hugging Face segnala miglioramenti sui dati out-of-domain, dove la compressione appresa da un modello dense può eliminare dettagli essenziali per le query in produzione.
I numeri di Hugging Face aiutano a capire perché il retrieval visivo sia così adatto: una pagina renderizzata genera circa 755 vettori token per colqwen2.5-v0.2, contro circa 125 per un passaggio testuale medio. Più una pagina è ricca di grafici, layout e tabelle, più informazioni un singolo vettore aggregato sarebbe costretto a scartare.
Il miglioramento qualitativo c'è, ma è meno ampio dell'hype
L'evidenza più pulita arriva dalla coppia comparabile di LightOn: LateOn e DenseOn condividono lo stesso backbone ModernBERT da 149M parametri e gli stessi dati di addestramento. Cambia solo la testa: vettori token da 128 dimensioni contro un unico vettore documento da 768 dimensioni.
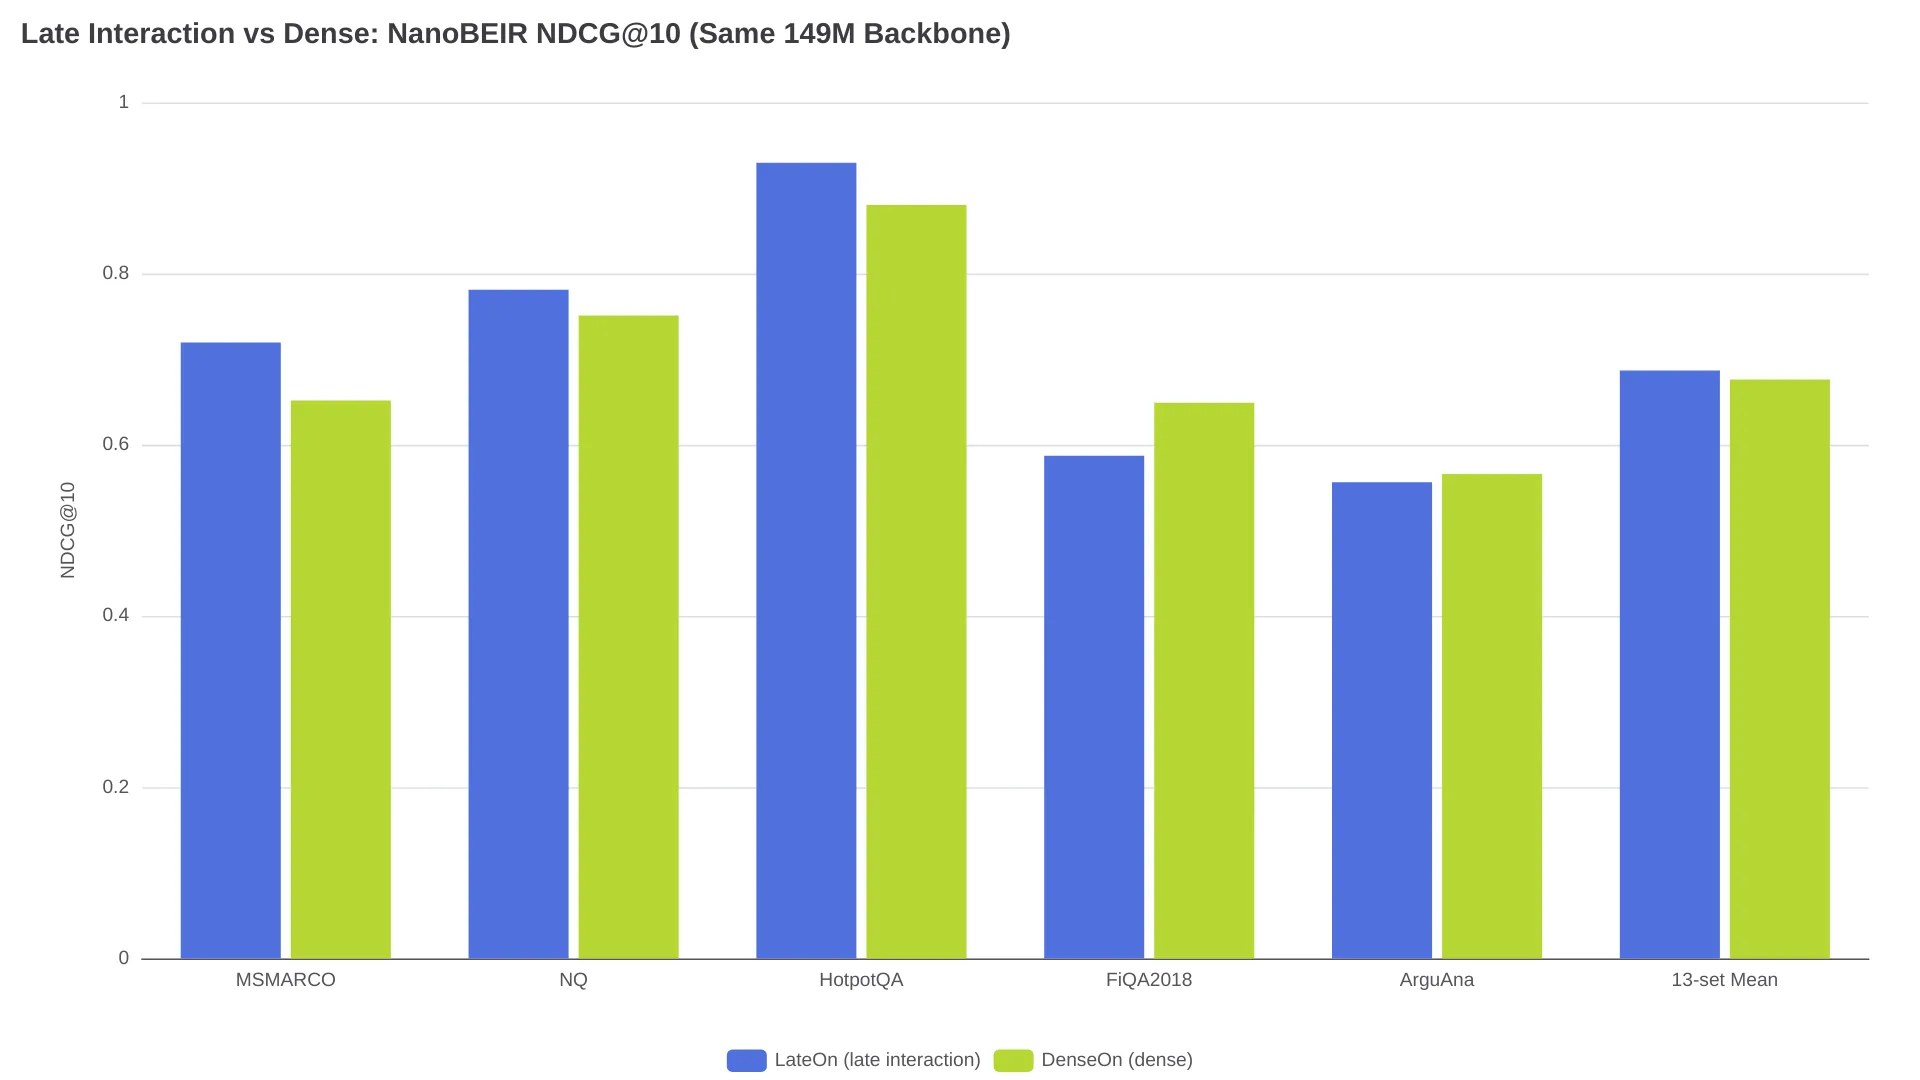
LateOn prevale in 9 dei 13 dataset NanoBEIR e anche sulla media: 0.6868 contro 0.6764 NDCG@10. Sui 15 dataset completi di BEIR, il risultato è 57.22 contro 56.20. DenseOn vince comunque in modo netto su ArguAna, FiQA2018, SCIDOCS e SciFact. Questa è la lettura corretta: un guadagno medio significativo a parità di dimensione del modello, non un salto di categoria.
Dopo l'annuncio della v6.0 da parte del maintainer Tom Aarsen, lo sviluppatore @saen_dev ha posto la domanda che molti practitioner continuavano a ripetere: "How does it benchmark against bi-encoders on domain-specific corpora?" (thread). La risposta onesta è circa un punto medio, con i guadagni maggiori concentrati sui documenti lunghi. Lo stesso post di lancio di Hugging Face invita a valutare il proprio task di retrieval, perché i miglioramenti variano da dataset a dataset.
Il conto dello storage: 42x prima della compressione
Nell'esempio di Hugging Face, l'indice copre 4.874 passaggi di Natural Questions. lightonai/LateOn genera 608.414 vettori token, ovvero 124.8 vettori per passaggio in media.
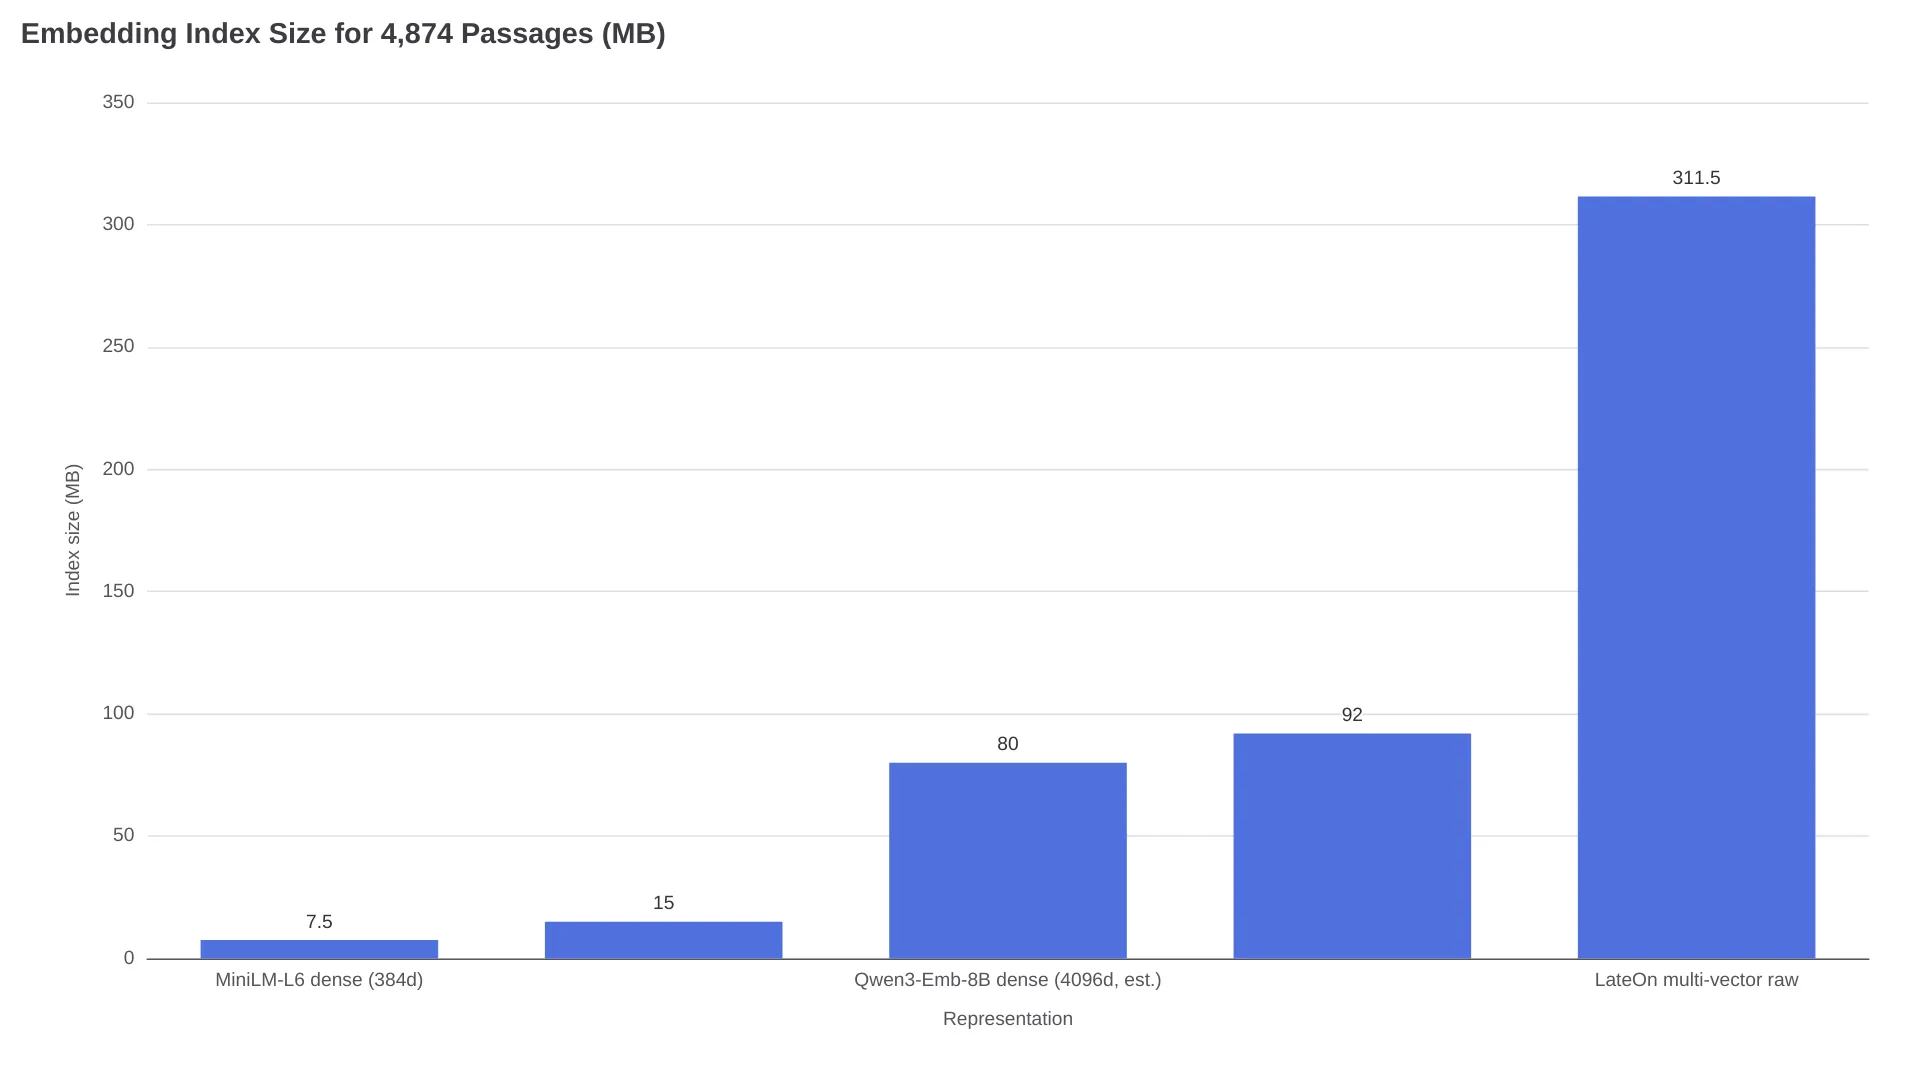
L'indice multi-vettore raw in float32 occupa 311.5 MB. Gli stessi passaggi, con il dense all-MiniLM-L6-v2, richiedono 7.5 MB: una differenza di 42x, pari a 62 KiB per passaggio. Rispetto a gte-modernbert-base, un modello dense da 768 dimensioni della stessa classe, il divario è 21x (15 MB). TopK indica un intervallo da 10–100x in base alla lunghezza dei documenti e alla precisione, e stima migliaia di volte più lavoro di scoring per query rispetto a un confronto a vettore singolo.
Il giorno del rilascio, uno sviluppatore ha sintetizzato così il problema della produzione:
Il token pooling è ciò che decide se questa soluzione arriva in produzione. La late interaction di solito muore per le dimensioni dell'indice e la memoria, non per l'accuratezza. - @JudeJobs on X
Per avere un riferimento: un indice dense Qwen3-Embedding-8B da 4.096 dimensioni sugli stessi dati occupa circa 80 MB, vicino ai 92 MB dell'indice late interaction compresso descritto sotto.
Tre leve per ridurre le dimensioni
1. Token pooling. Sentence Transformers v6.0 include HierarchicalTokenPooling, che raggruppa i vettori token dei documenti con Ward linkage sulla distanza coseno e sostituisce ciascun cluster con la sua media. Per impostazione predefinita il pooling si applica solo ai documenti, perché le query sono corte e sensibili alla distorsione. Sul corpus da 608.414 vettori:
| Fattore di pooling | Vettori token | Indice float32 | Retention di retrieval riportata |
|---|---|---|---|
| 1 (nessuno) | 608.414 | 311.5 MB | 100% |
| 2 | 305.438 | 156.4 MB | 100.6% |
| 3 | 204.407 | 104.7 MB | 99.0% |
| 4 | 153.936 | 78.8 MB | ~98% di tendenza |
Il pooling ha richiesto circa 6 secondi per l'intero corpus. La variante regolarizzata di LightOn riporta il 99.4% della qualità a 5x di compressione nel post di Hugging Face, anche se Hugging Face precisa che, alla release v6.0, l'addestramento con quel regolarizzatore non è ancora integrato nella libreria.
2. Indici compressi. Un indice fast-plaid (Rust PLAID) sugli stessi vettori occupa 92 MB, viene costruito in 5 secondi e risponde in 11 ms su una RTX 3090 + i7-13700K. È approssimato: nel test di Hugging Face i punteggi migliori sono passati da 11.92 a 11.88, ma l'ordinamento è rimasto invariato. MUVERA di Weaviate ha reso l'ingest 3x più rapido e le query 1.8x più veloci, pur perdendo un risultato corretto nella top 50 del loro corpus di test.
3. Quantizzazione e ottimizzazione dell'inferenza. Negli esperimenti di Qdrant, la quantizzazione scalare uint8 sugli embedding token ha ridotto la memoria di 4x, mentre SciFact NDCG@10 è passato da 0.70724 a 0.70297: una variazione trascurabile. Hugging Face riporta che fp16 più Flash Attention offre 2.44x il throughput di encoding in fp32 senza perdite misurate di qualità; int8 su CPU costa circa lo 0.4% di accuratezza.
Combinando pooling con fattore 2–3 e un indice compresso, il divario effettivo rispetto al dense scende da 42x a una singola cifra, al prezzo di due parametri in più da regolare.
L'architettura predefinita: prima il retrieval, poi il reranking
Il MaxSim esaustivo su tutti i 4.874 documenti ha richiesto 98 ms per lo scoring e 122.7 ms end-to-end su una singola RTX 3090: più che accettabile per poche migliaia di documenti, disastroso per costo lineare quando si passa ai milioni. Le tre guide di deployment qui confrontate convergono sulla stessa architettura: un primo stadio dense o sparse economico recupera i candidati, quindi la late interaction li riordina.
- L'esempio di Hugging Face. Recupera i primi 50 risultati dense e li riordina con MaxSim. I documenti vengono codificati una volta in batch e valutati con moltiplicazioni matriciali, molto meno costose di un forward pass per coppia query-documento di un cross-encoder.
- Qdrant. Con supporto multi-vettore nativo dalla v1.10, raccomanda la late interaction soprattutto per il reranking di qualche centinaio di candidati, non per scansioni complete.
- La guida di Data AI Hub. Suggerisce retrieval ibrido dei primi 150 risultati, reranking late interaction fino a 20 e, in modo opzionale, un cross-encoder per i 5 finali inviati all'LLM.
Il pattern basato solo sul reranking ha un limite netto: non può recuperare documenti mancati dal primo stadio. E il resto della pipeline è tutt'altro che risolto:
non esiste quasi mai una strategia di chunking, retrieval e re-ranking valida universalmente. - u/gamerx88, r/MachineLearning
Database compatibili: chi supporta il multi-vettore e con quali limiti
Il post di lancio di Hugging Face mette alla prova i principali motori sullo stesso corpus da 4.874 passaggi. I valori seguenti sono risultati del loro test, non marketing dei fornitori:
| Motore | Multi-vettore nativo da | Ingest / query (nel loro test) | Limiti e note |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | MAX_SIM esatto; server consigliato |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA più rapido ma ha perso un risultato corretto; nessuna modalità embedded su Windows |
| Vespa | "da anni" | ~80 s / 75 ms a caldo | MaxSim come espressione tensoriale; la seconda fase predefinita riordina solo 100 candidati e ha mancato 2 dei 3 risultati corretti migliori |
fast-plaid | - | 5 s / 11 ms | Nessun server; punteggi approssimati, ordinamento invariato |
| LanceDB | v0.15.0 | non testato | MaxSim nativo |
| Milvus | v2.6.4 | non testato | Storage array-of-structs |
| VectorChord | - | non testato | Operatore MaxSim per PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Solo rescore; la funzionalità ES è una technical preview nel tier Enterprise |
Nella tabella comparativa di Hugging Face, l'indicizzazione late interaction di turbopuffer risultava in private beta.
Cosa cambia con Sentence Transformers v6.0
Prima del 18 agosto 2026, usare modelli della famiglia ColBERT significava passare da framework separati: PyLate, il repository Stanford ColBERT o colpali-engine. La versione 6.0 rende MultiVectorEncoder il quarto tipo di modello di prima classe della libreria, con training, inferenza e strumenti di interpretabilità integrati. Carica checkpoint Sentence Transformers, PyLate, Stanford ColBERT e ColPali; può caricare anche un transformer senza testa, ma con una proiezione casuale che richiede addestramento. I requisiti sono transformers v5.x, torch 2.2+ e huggingface-hub v1.x.
Tre insidie evidenziate nella documentazione di lancio:
- Query e documenti non sono simmetrici.
encode_query()eencode_document()applicano prompt, limiti di lunghezza e maschere di scoring diversi. Chiamare il genericoencode()su entrambi è il modo più rapido per degradare silenziosamente i risultati. - Il troncamento non avvisa. Un passaggio di 662 token inviato al limite di 300 token documento di LateOn ha prodotto 273 vettori: il resto viene scartato. Portare il limite a 512 funziona, ma allontana il modello dalla distribuzione di training e ingrandisce l'indice.
- Flash Attention non vale per tutti. I modelli con query expansion non-attend, inclusi
colbert-ir/colbertv2.0eanswerai-colbert-small-v1, richiedono invece"sdpa".
Secondo i punteggi pubblicati da Hugging Face, il catalogo dei modelli supportati copre due ordini di grandezza:
| Fascia | Modello di esempio (parametri) | Punteggio (NDCG@10 medio) |
|---|---|---|
| Testo edge | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Testo piccolo | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Leader testuale | Famiglia LateOn (149M) | 0.6868–0.6897 NanoBEIR |
| Documento visivo | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Quando il dense a vettore singolo resta la scelta giusta
L'errore da evitare è adottare il multi-vettore per carichi di lavoro che non ne traggono beneficio. Meglio evitarlo con query ampie e tematiche ("articoli sulle catene di approvvigionamento"), testi brevi come titoli, coppie FAQ o tweet, e per clustering, deduplicazione o sistemi di raccomandazione: in generale, per tutto ciò che richiede similarità dell'elemento nel suo insieme. Vale lo stesso se una pipeline dense più reranker soddisfa già gli SLO di recall e il vero vincolo è il costo. La guida di Data AI Hub aggiunge che checkpoint ColBERT orientati all'inglese possono rendere meno di uno stack bi-encoder multilingue più reranker su corpus multilingue, mentre corpus con molte scritture e aggiornamenti in tempo reale si adattano male agli indici a livello di token.
Domande ricorrenti, con i numeri alla mano
Si può usare un normale modello dense come modello multi-vettore?
A volte, e con risultati sorprendentemente buoni. Gli esperimenti di Qdrant hanno preso gli embedding token in output da BAAI/bge-small-en, un modello dense da 33M, e li hanno valutati con MaxSim: 0.73696 NDCG@10 su SciFact, superiore a colbert-ir/colbertv2.0 con 0.69579 e al vettore aggregato di bge-small, fermo a 0.68213. Su ArguAna l'ordine si è ribaltato e ha vinto il dense aggregato. È un espediente legittimo per aggiungere un reranking senza introdurre un nuovo modello, non una garanzia.
Quanto è più veloce un indice multi-vettore compresso?
Sul corpus da 4.874 passaggi: MaxSim esaustivo in 98 ms contro 11 ms di fast-plaid, con 92 MB invece di 311.5 MB.
I modelli multi-vettore sostituiscono i reranker cross-encoder?
Dal punto di vista economico, sì: le rappresentazioni dei documenti sono precalcolate e valutate con moltiplicazioni matriciali, non con un forward pass per ogni coppia query-documento. Il post di lancio di Hugging Face continua però a considerare il cross-encoder l'opzione più accurata per coppia, motivo per cui le pipeline più esigenti ne mantengono uno per gli ultimi 5–20 risultati.
La late interaction vale la pena per il RAG?
Come stadio di reranking su candidati hybrid o dense, sì: è il modello raccomandato da tutte e tre le guide di deployment citate sopra. Come retriever di primo stadio, solo se il recall misurato nel primo stadio è il punto debole e l'indice di vettori token rientra nel budget.
Tabella decisionale
| Il tuo carico di lavoro | Raccomandazione |
|---|---|
| Query ricche di identificatori o composte da più vincoli, documenti lunghi, testi legali o tecnici | Retrieval o reranking multi-vettore: è il territorio del +26 punti su MLDR |
| PDF, pagine scansionate, tabelle e grafici come immagini di pagina | Multi-vettore della famiglia ColPali; non serve una pipeline OCR |
| Ricerca tematica ampia, testi brevi, clustering/deduplicazione/recsys | Vettori dense singoli; qui la perdita dovuta al pooling è irrilevante |
| Qualità quasi sufficiente, budget ridotto | Mantieni il primo stadio dense e aggiungi il reranking MaxSim sui primi 50–150 |
| Milioni di documenti, costo come vincolo principale | Dense + reranker cross-encoder, oppure late interaction compressa (pooling fattore 2–3 + fast-plaid) dopo aver misurato |
Resta aperto il compromesso segnalato da @JudeJobs: la retention della compressione viene misurata sui benchmark, non su corpus di produzione disordinati. Parti da pooling con fattore 2, poi lascia che il recall misurato sui tuoi dati stabilisca fin dove spingerti lungo la curva di compressione.