 AIREITER
Un contesto da un milione di token e un prezzo di 0,68 $ per l’input fanno sembrare Mistral Large 4 insolitamente economico per un modello da mille miliardi di parametri. Il punto è che si tratta ancora di una public preview: non c’è una data chiara per la fine del prezzo scontato, i limiti dei gateway non coincidono sempre con quelli dichiarati per il modello e la licenza dei pesi, che dovrebbero arrivare in futuro, non è ancora stata pubblicata.
La decisione in un minuto
Vale la pena provare subito Mistral Large 4 se serve un’API economica con contesto esteso per documenti, repository di codice o flussi di lavoro che usano strumenti. È invece troppo presto per considerare la preview un sostituto stabile per il self-hosting o un leader già affermato nei benchmark di coding.
| Esigenza | Decisione |
|---|---|
| Testare documenti lunghi o grandi codebase tramite API | Provalo subito, monitorando cache hit e costo dell’output |
| Serve un prezzo prevedibile nel lungo periodo | Attendi o prepara il budget per la tariffa più alta di 1,36 $ per l’input e 4,18 $ per l’output |
| Serve un deployment privato | Attendi pesi, licenza, quantizzazione e indicazioni per il serving |
| Serve il miglior punteggio nel coding | Non scegliere basandoti solo sui numeri del lancio; esegui lo stesso harness sui tuoi task |
Questa è una decisione sull’API in public preview, non un giudizio definitivo sul modello. Mistral ha annunciato la preview il 6 ottobre 2026 e nei materiali pubblici indica che i pesi sono previsti entro la fine di ottobre. (Annuncio di Mistral)
Cosa è davvero disponibile il 6 ottobre
Mistral Large 4 è disponibile come API in public preview tramite Mistral Studio. Mistral lo descrive come un modello nativamente multimodale basato su mixture of experts, con 1,05 trilioni di parametri totali e 49 miliardi di parametri attivi per token. L’annuncio ufficiale cita anche function calling, output strutturati, domande e risposte sui documenti, batching, agenti e strumenti integrati.
Il modello è inoltre disponibile con l’identificativo mistralai/mistral-large-4-0 su OpenRouter: l’accesso tramite OpenRouter non è più soltanto una voce del giorno del lancio. Limiti, latenza, fatturazione e criteri di fallback possono però cambiare a seconda del percorso utilizzato.
L’API è attiva, ma i pesi scaricabili e la licenza definitiva non sono ancora disponibili. L’espressione “open weight” non va interpretata come sinonimo di open source commerciale senza restrizioni finché Mistral non pubblicherà model card e condizioni d’uso.
Perché il prezzo compare in due versioni
Le tariffe attuali della preview indicate nella documentazione del modello di Mistral sono interessanti:
| Tipo di token | Tariffa preview | Possibile tariffa dopo la preview indicata nei materiali del lancio |
|---|---|---|
| Input | 0,68 $ / 1 milione di token | 1,36 $ / 1 milione di token |
| Input in cache | 0,07 $ / 1 milione di token | 0,14 $ / 1 milione di token |
| Output | 2,09 $ / 1 milione di token | 4,18 $ / 1 milione di token |
Le cifre più basse sono presentate come prezzo preview scontato del 50% nella scheda del gateway di Vercel e in altre pagine dedicate all’accesso al modello, ma non è indicata una data di scadenza. Considera quindi 0,68 $ e 2,09 $ come tariffe attuali, non come condizioni garantite per sempre.
Con un carico composto da 500.000 token di input non in cache e 100.000 token di output, il costo della preview è di circa 0,55 $: 0,34 $ per l’input più 0,209 $ per l’output. Se l’input è in cache, si scende a circa 0,244 $: 0,035 $ per l’input in cache più 0,209 $ per l’output. Prima di spostare il traffico di produzione, valuta il riutilizzo della cache, il volume dell’output e quanto sia sostenibile lo sconto.
Contesto e capacità cambiano in base all’endpoint
La documentazione del modello di Mistral indica una finestra di contesto da 1 milione di token. È un dato riferito al modello, ma non necessariamente il limite esposto da ogni gateway.
La pagina AI Gateway di Vercel indica al momento un contesto condiviso di 524K token e un output massimo di 262K token per il provider Mistral. Riporta inoltre 0,9 secondi di P50 time to first token, 38 token al secondo e un dato del 74% per i cache hit, calcolato sul traffico del gateway.
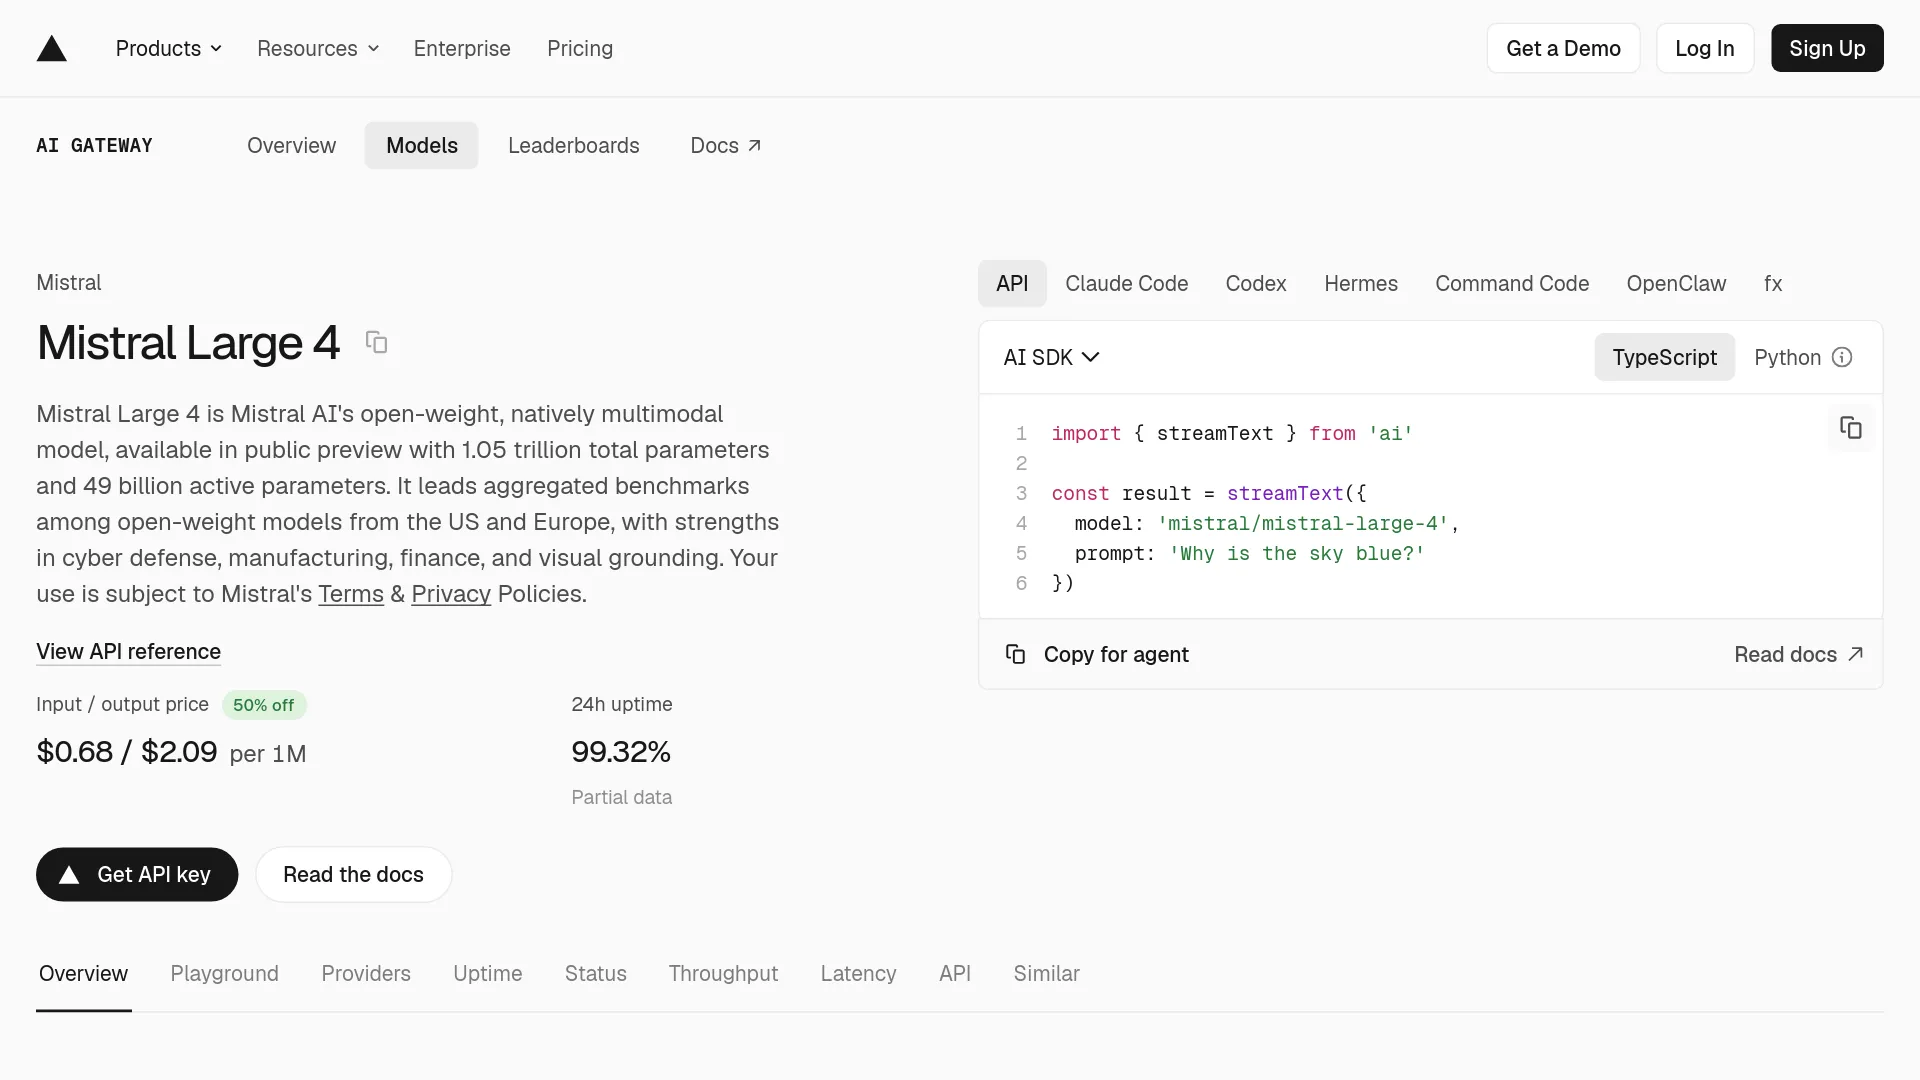
Si tratta di numeri specifici dell’endpoint, non di garanzie universali del modello. La pagina documenta input per immagini, tool calling, API Chat Completions e Responses compatibili con OpenAI e accesso Messages compatibile con Anthropic; l’ID del gateway è mistral/mistral-large-4, diverso da quello qualificato per il provider usato da OpenRouter.
Prima di integrare il modello, verifica il contesto condiviso dell’endpoint, il limite dell’output, il conteggio di immagini e token, il comportamento degli strumenti, la policy della cache, il routing tra provider e le regole di fallback. Il dato da 1 milione di token è utile per una prima selezione, ma non basta per dimensionare un’applicazione.
Cosa dimostrano davvero i benchmark
L’analisi del lancio di TechsCurrent riporta i dati di Mistral: 61,7% su DeepSWE v1.1, 28,3% su Terminal-Bench 4 e 59,9% su AutomationBench. Il confronto pubblicato da CellCog cita DeepSeek V4.1 Flash al 74,2 su DeepSWE e Mistral Large 4 al 61,7, mentre il dato di Mistral su AutomationBench è superiore a quello delle righe di confronto. Sono segnali riportati dai vendor o raccolti da fonti diverse, non risultati provenienti da una classifica standardizzata unica.
Prima di usare il modello in agenti di produzione, esegui una valutazione fissa:
- Usa lo stesso repository, lo stesso prompt, gli stessi strumenti e lo stesso timeout per Mistral Large 4 e per il modello attualmente in uso.
- Misura completamento dei task, errori negli argomenti delle chiamate agli strumenti, retry, latenza, token di output e costo.
- Aggiungi casi di retrieval su contesti lunghi in cui la risposta si trova al centro e verso la fine dell’input.
- Ripeti il test con contesto in cache e senza cache.
- Tieni separati i risultati della preview da quelli che otterrai dopo il rilascio dei pesi.
Chi dovrebbe usarlo subito
Team API-first con molto contesto ricorrente: prova Mistral Large 4 già ora. La tariffa di 0,07 $ per l’input in cache può fare la differenza quando un agente invia ripetutamente lo stesso prefisso con policy, repository o documenti. Imposta un tetto di spesa per l’esperimento, perché la tariffa più alta resta possibile.
Team che sviluppano flussi documentali con immagini: testa input per immagini ed estrazione dei documenti sull’endpoint che prevedi di usare in produzione. Il modello supporta le immagini, ma i limiti sui file e i dettagli di fatturazione possono variare e vanno ancora verificati.
Team che lavorano su coding agent: consideralo un candidato, non un vincitore automatico. I benchmark disponibili restituiscono un quadro misto e l’affidabilità reale dipende da chiamate agli strumenti, retry e percentuale di completamento.
Team attenti alla privacy o interessati al self-hosting: aspetta pesi e licenza. Il dato di 49 miliardi di parametri attivi non significa che il checkpoint completo sia piccolo: il modello totale deve comunque essere archiviato e servito. Hardware, quantizzazione, throughput e diritti di redistribuzione restano da chiarire.
FAQ su Mistral Large 4 API
Mistral Large 4 è già open source?
No. Al momento del lancio non erano disponibili né una licenza definitiva né pesi scaricabili. Mistral prevedeva di pubblicare i pesi entro la fine di ottobre 2026, ma la dicitura “open weight” da sola non definisce i diritti commerciali o di redistribuzione.
Il prezzo di 0,68 $ è permanente?
Non è indicata una data di scadenza. Per i test considera le tariffe attuali di 0,68 $ per l’input e 2,09 $ per l’output, ma prepara anche uno scenario da 1,36 $ e 4,18 $.
La finestra di contesto è da 1 milione o da 524K token?
Mistral documenta un contesto del modello da 1 milione di token; Vercel indica un contesto condiviso di 524K per il proprio endpoint. Verifica il limite del provider e del formato API che utilizzerai.
È già disponibile su OpenRouter?
Sì, OpenRouter elenca attualmente mistralai/mistral-large-4-0. Controlla la pagina aggiornata prima del deployment, perché il routing di una preview può cambiare.
Gestisce immagini e strumenti?
La documentazione ufficiale e quella dei gateway descrivono il supporto per input visivi e tool calling. Testa il formato delle richieste, i limiti delle immagini, il conteggio dei token e il comportamento in caso di chiamate agli strumenti malformate sull’endpoint scelto.
Conviene fare self-hosting quando arriveranno i pesi?
Non automaticamente. Attendi di conoscere licenza, formati dei checkpoint, opzioni di quantizzazione, requisiti di memoria, dati sul throughput e una configurazione di serving di riferimento.
Il prossimo test da eseguire
Prepara una valutazione da 20 task prima di instradare traffico reale: cinque task di retrieval su contesti lunghi, cinque modifiche di codice, cinque domande su immagini e documenti e cinque task di tool calling. Registra tasso di successo, retry, time to first token, latenza complessiva, token di input, cache e output, oltre al costo effettivo per task completato.
Fonti: documentazione del modello Mistral, annuncio di Mistral, Vercel AI Gateway, pagina del modello su OpenRouter, TechsCurrent, CellCog.