 AIREITER
Liquid AI LFM3 porta testo, visione, audio e interazione multimodale in sei modelli da circa 2 miliardi di parametri. Peccato che, al 27 ottobre 2026, la pagina prezzi ufficiale di Liquid non riporti ancora una tariffa per LFM3. È un dettaglio tutt'altro che secondario: per ora bisogna capire se siamo davanti a una famiglia economica per l'edge o, più semplicemente, a modelli da scaricare e gestire in proprio.
LFM3 in breve: sei specialisti da 2B, ma il prezzo API non c'è ancora
LFM3 è la famiglia di foundation model di terza generazione di Liquid AI pensata per l'intelligenza specializzata on-device, non un singolo checkpoint. Tutti i modelli condividono il backbone LFM3-1.7B-Base, pre-addestrato su 22 trilioni di token, ma la famiglia comprende sei varianti: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B e d1-Omni-2B (annuncio).
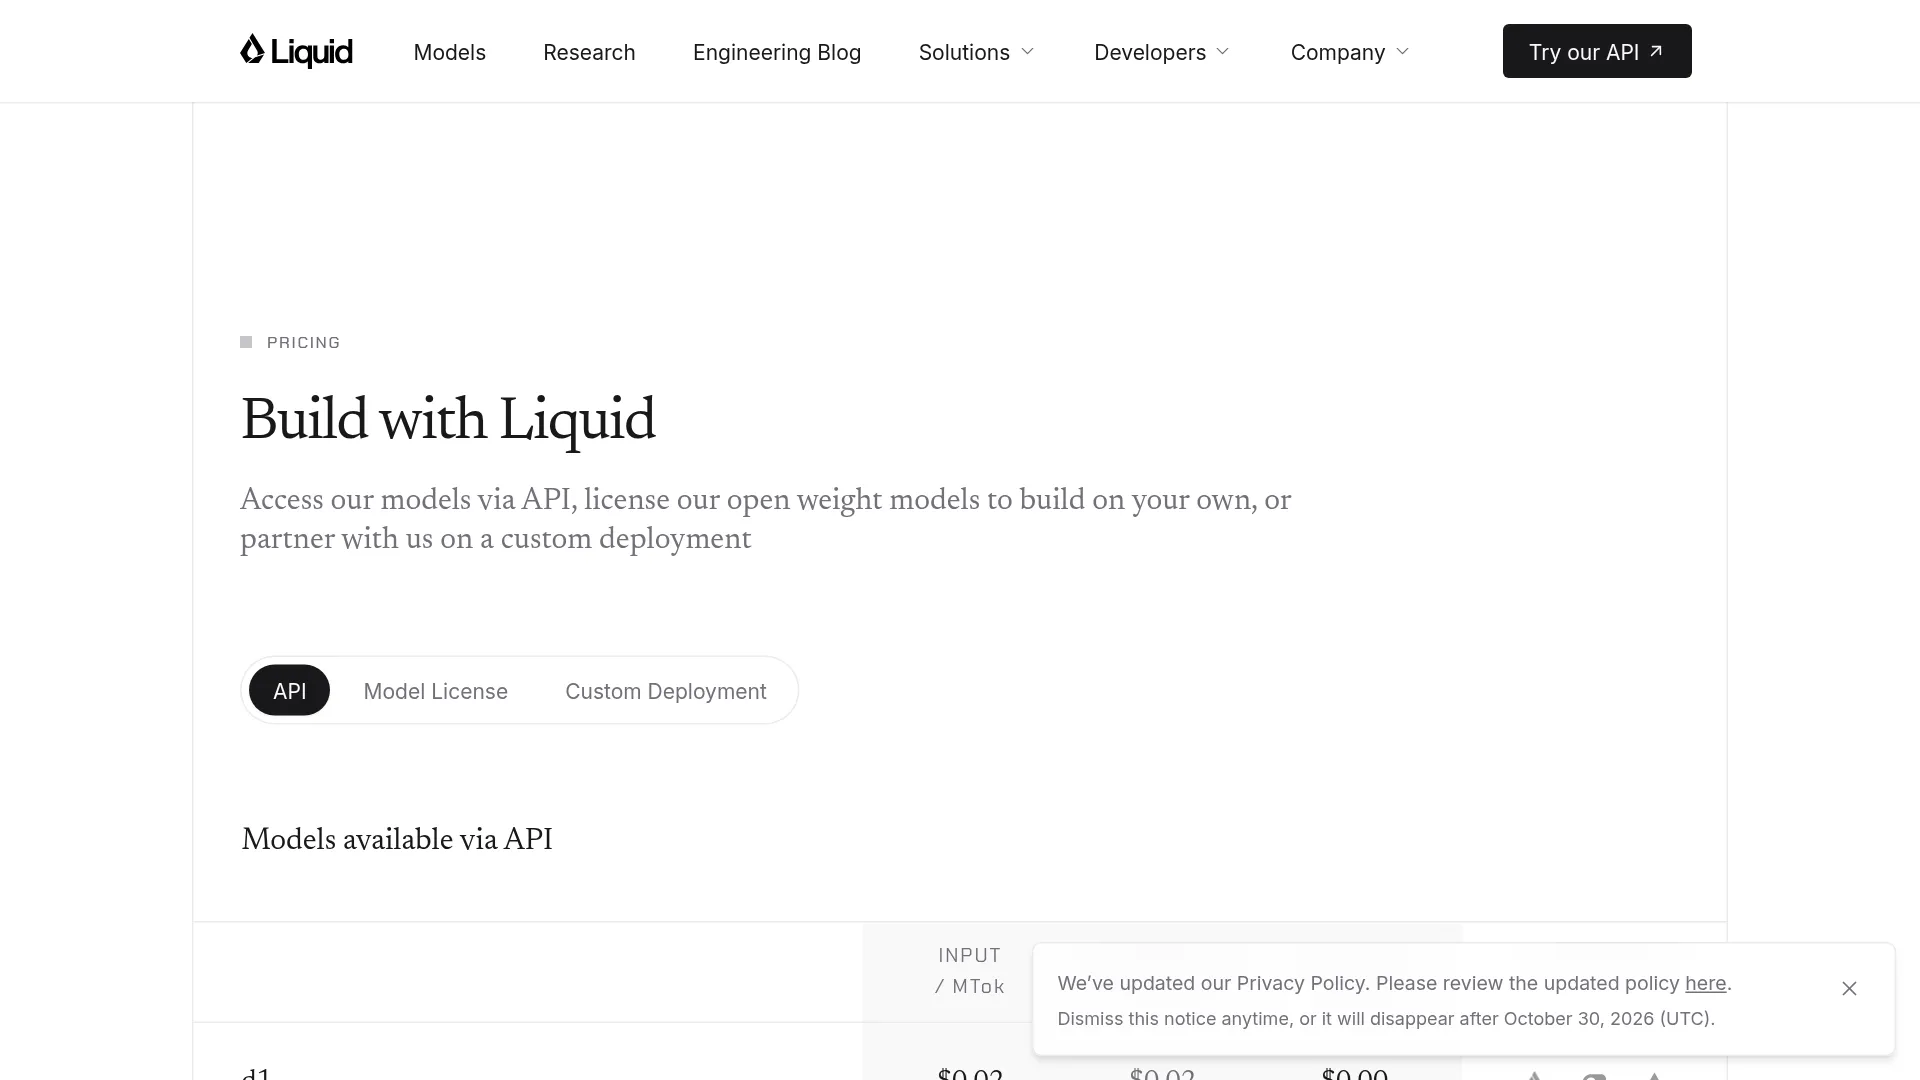
Ho controllato la pagina prezzi di Liquid AI il 27 ottobre: LFM3 non compare. Sono invece presenti le tariffe di d1, d1-ultra e LFM2.5 riportate più avanti. L'annuncio di LFM3 indica che i pesi sono disponibili tramite Hugging Face, Liquid Playground e Liquid API, ma al momento solo le prime due opzioni sono verificabili direttamente. Le nuove organizzazioni ricevono comunque 2 dollari di credito gratuito su Liquid Console (prezzi).
I sei modelli LFM3: quale scegliere in base al lavoro
I sei checkpoint LFM3 condividono lo stesso backbone, ma cambiano per input accettati e output restituiti.
| Modello | Dimensioni approssimative | Input | Output | Ideale per |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Testo | Testo | Agenti locali, chiamate a strumenti, output strutturato |
| LFM3-VL-2B | 1.9B | Testo, immagini, video | Testo | Comprensione di immagini e video, agenti visivi |
| LFM3-Audio-2B | 2B | Testo, audio | Testo, parlato | Conversazioni vocali, riconoscimento, sintesi e traduzione in 18 lingue |
| LFM3-Omni-2B | 2B | Testo, immagini, video, audio | Testo, parlato | Assistente multimodale unificato |
| d1-2B | 2B | Testo, immagini, video | Risposte calibrate | Classificazione, estrazione, decisioni in un solo passaggio |
| d1-Omni-2B | 2B | Testo, immagini, video, audio | Risposte calibrate | Analisi multimodale con punteggi di confidenza |
LFM3-1.7B offre una finestra di contesto da 256K token e una struttura tri-ibrida di 24 layer: 13 layer a convoluzione breve con gating, 5 layer di attenzione a finestra scorrevole con finestra da 256 token e 6 layer di attenzione globale (annuncio). Gli ultimi 3,5 trilioni di token della fase di mid-training hanno aggiunto traiettorie di agenti e chiamate a strumenti: ecco perché Liquid propone il modello testuale per harness come Hermes Agent, Pi e OpenClaw (annuncio). LFM3-VL-2B è il primo modello di visione di Liquid a supportare input video, mentre LFM3-Omni-2B è il primo modello omni-modale dell'azienda, capace di elaborare insieme traccia audio e fotogrammi (annuncio).
I modelli decisionali adottano un approccio diverso. d1-2B e d1-Omni-2B saltano la generazione autoregressiva e restituiscono risposte calibrate con le relative probabilità in un singolo forward pass (annuncio). Secondo Liquid, d1-2B raggiunge una latenza decisionale di 5,7 ms su NVIDIA H100 e 3,8 ms su AMD MI325X; con d1-Omni-2B i valori salgono rispettivamente a 12,4 ms e 8,2 ms usando una clip audio di 10 secondi (annuncio).
Le promesse di Liquid e ciò che si può verificare davvero
I benchmark di Liquid AI sono dati dichiarati dal produttore: vanno quindi considerati come tali finché non arriveranno test indipendenti. Tutti i numeri qui sotto provengono da l'annuncio di Liquid.
| Modello | Metrica dichiarata dal produttore | Risultato LFM3 | Risultato precedente / concorrente |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Dimensioni / velocità | 35% di parametri in meno, circa 25% più veloce per parametro a 8K rispetto a LFM2-1.2B | — |
| LFM3-VL-2B | Media visiva 62 / encoder | 71.4 di media; encoder da 164M con 2,2 volte meno FLOP | 57.6 di media; Liquid dichiara la parità dell'encoder con Qwen3.5-2B |
| LFM3-Audio-2B | UTMOSv2 / latenza | 3.83; 50 ms minimi per il primo token; 87 volte il tempo reale su CPU M4 Max | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
Le verifiche dirette che ho potuto fare sono queste: la raccolta LiquidAI LFM3 su Hugging Face include tutti e sei i modelli, con varianti quantizzate, MLX e ONNX, mentre il catalogo di LM Studio mostra già varianti LFM3 per desktop. I punteggi indicano una direzione, non una garanzia. Le medie aggregate nascondono le differenze tra OCR, grounding e video, mentre il dato di 1 GB in 4 bit non comprende KV cache e overhead dell'applicazione.
"È incredibile quanto velocemente si possano creare cose al giorno d'oggi." — @Nklockiewicz, con LFM3 in esecuzione su iPhone in modalità aereo tramite MLX/ExecuTorch a 40 tok/s (fonte)
"In genere superano le aspettative considerando velocità e intelligenza, ma nella mia esperienza non sono ancora abbastanza intelligenti per il 'lavoro vero'." — u/spaceman_, r/LocalLLaMA (fonte)
La soglia dei 10 milioni di dollari nella licenza va letta bene
La licenza open-weight di Liquid AI è gratuita finché il fatturato annuale dell'azienda non supera i 10 milioni di dollari (prezzi). Sviluppatori, ricercatori, organizzazioni non profit e aziende con ricavi annuali inferiori a 10 milioni di dollari possono scaricare, eseguire, perfezionare e distribuire in produzione tutti gli LFM open, mantenere privati i fine-tuning e implementare i modelli su dispositivi mobili, edge o infrastrutture on-premise senza obblighi di copyleft (prezzi).
Le aziende sopra i 10 milioni di dollari devono invece acquistare una licenza enterprise, con prezzi determinati dalla scala della distribuzione e definiti tramite il team commerciale. L'uso per ricerca, istruzione e organizzazioni non profit resta gratuito e senza limite di fatturato (prezzi). La LFM Open License interrompe quindi la concessione commerciale gratuita oltre quella soglia: prima di integrare i pesi in un'app commerciale, conviene verificare con un legale gli obblighi relativi ad attribuzione, redistribuzione ed esportazione.
Uso in locale: cosa comporta davvero quel valore di 1 GB
LFM3-1.7B occupa circa 1 GB in formato 4 bit, ma il dato si riferisce soltanto ai pesi (annuncio). Il processo deve inoltre caricare il runtime, la KV cache necessaria per i contesti lunghi e gli eventuali encoder per visione o audio. Serve quindi RAM aggiuntiva, soprattutto con le varianti VL e Omni quando si elaborano fotogrammi video o clip audio.
Il punto di partenza più sensato è LFM3-1.7B. Si possono aggiungere VL, Audio o Omni solo quando servono davvero, controllando prima le dipendenze extra indicate nella model card di ciascun modello. Per LFM3 sono disponibili percorsi basati su Ollama, LM Studio, llama.cpp, MLX e ONNX, indicati nella raccolta Hugging Face e nel catalogo di LM Studio.
Quando un esempio nella model card richiede trust_remote_code=True, meglio fissare un commit tramite hash, esaminare il codice del repository oppure partire da un ambiente isolato: quel flag esegue infatti il codice incluso nel repository. Liquid parla di 18 lingue audio ne suo annuncio, ma senza pubblicare una tabella della qualità per lingua; per le lingue diverse dall'inglese è quindi opportuno verificare il comportamento sui propri dati.
Accesso API: dove usarlo oggi e cosa viene fatturato
L'accesso API a LFM3 è stato annunciato, ma sulla pagina pubblica di Liquid non ha ancora un prezzo separato. Le chiamate passano da Liquid Console, OpenRouter e Vercel AI Gateway (prezzi).
| Modello API elencato il 27 ottobre | Input / MTok | Input memorizzato nella cache / MTok | Output / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| Tariffe testuali LFM3-1.7B / VL / Audio / Omni | Non indicate | Non indicate | Non indicate |
Per ora, questa assenza è già una risposta sul piano dei costi: bisogna considerare LFM3 come calcolo self-hosted più tempo di sviluppo, non come una voce tariffaria per token. Se oggi un provider propone token LFM3, va confrontato con i riferimenti pubblicati per d1 e LFM2.5, verificando anche se si tratta di un proxy verso Liquid Console o di pesi gestiti direttamente dal provider. Il costo indicato di 0,00 dollari per milione di token in output per d1 può rendere il modello interessante per pipeline di ispezione ad alto volume.
FAQ su LFM3
Quanto costa l'API di LFM3?
Al 27 ottobre 2026 Liquid AI non indica un prezzo separato per token per LFM3; la pagina pubblica mostra soltanto le tariffe di d1, d1-ultra e LFM2.5-24B-A2B.
LFM3 è gratuito per uso commerciale?
La produzione commerciale è gratuita per le aziende con meno di 10 milioni di dollari di fatturato annuale, secondo la LFM Open License; le aziende più grandi devono acquistare una licenza enterprise.
LFM3 può funzionare su smartphone o laptop?
Sì, per la variante testuale servono circa 1 GB in 4 bit oltre all'overhead del runtime. Sono disponibili percorsi con Ollama, LM Studio, llama.cpp, MLX e ONNX; le varianti VL, Audio e Omni richiedono più memoria per encoder e contenuti multimediali.
LFM3 è migliore di Qwen o Gemma per gli agenti edge?
Nei risultati del giorno del lancio che ho analizzato non ho trovato confronti indipendenti. I vantaggi dichiarati da Liquid rispetto a Qwen3.5-2B e Qwen2.5-Omni-7B provengono dal produttore (annuncio), quindi prima di cambiare modello conviene testare LFM3, Gemma e Qwen sul proprio harness.
Posso fare il fine-tuning di LFM3 su una sola GPU?
Liquid mette a disposizione notebook per SFT, DPO, GRPO e pre-training continuo e afferma che ogni modello può essere sottoposto a fine-tuning su una singola GPU (annuncio), ma non pubblica requisiti relativi a VRAM o dimensioni del dataset.
Uno specialista privato ed economico o un generalista piccolo che ha bisogno del tuo harness?
LFM3 ha senso quando i dati devono restare sul dispositivo, i contenuti multimediali non possono lasciare l'ambiente locale oppure il volume delle decisioni rende pesanti i costi cloud per token. Convince meno per conoscenza generale, ragionamento creativo prolungato o qualità pronta all'uso senza ottimizzare l'harness. Scarica una variante, misurala sui tuoi prompt e sul tuo hardware: a decidere dovrebbe essere quel risultato, non il grafico del lancio.