 AIREITER
Il 19 agosto 2026 Liquid AI ha aggiunto un secondo file Q4_0 da 1,59 GB accanto a quello già presente nel repository LFM2.5-2.6B: stessa dimensione, nome quasi identico, modello molto diverso. QAD, acronimo di quantization-aware distillation, recupera gran parte della qualità persa dalla quantizzazione a 4 bit e i risultati dichiarati sono notevoli. Ma se scaricate il file sbagliato, state usando la versione non corretta.
Cosa cambia davvero con QAD
QAD significa quantizzazione con distillazione consapevole dell'errore. Liquid AI ha addestrato questi quattro modelli — LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct e LFM2.5-2.6B — tenendo conto fin dall'addestramento degli arrotondamenti di Q4_0. Un modello teacher ad alta precisione trasferisce le proprie conoscenze allo student quantizzato, che impara così ad aggirare parte dell'errore introdotto dalla quantizzazione.
I vecchi file Q4_0 presenti negli stessi repository sono invece quantizzazioni post-addestramento, o PTQ: un modello BF16 già completato viene arrotondato successivamente, senza alcun addestramento per compensare la perdita. Secondo il post di presentazione di Liquid AI, tutti e quattro i checkpoint QAD raggiungono «circa il 97% della media BF16» in una batteria di test che comprende ragionamento, rispetto delle istruzioni, uso degli strumenti e comportamento agentico, calcolata come media di cinque esecuzioni. QAD interviene quindi durante il training, non introduce un nuovo formato: l'output resta un normale GGUF Q4_0, già gestito da llama.cpp.
La trappola dei nomi: quale file scaricare
Nel repository LFM2.5-2.6B convivono LFM2.5-2.6B-Q4_0.gguf e LFM2.5-2.6B-QAD-Q4_0.gguf, entrambi indicati con una dimensione di 1,59 GB. Gli snippet predefiniti del repository puntano però a Q4_K_M, non a QAD. Un'installazione copiata e incollata non scaricherà quindi nessuno dei due file QAD: il nome va specificato manualmente.
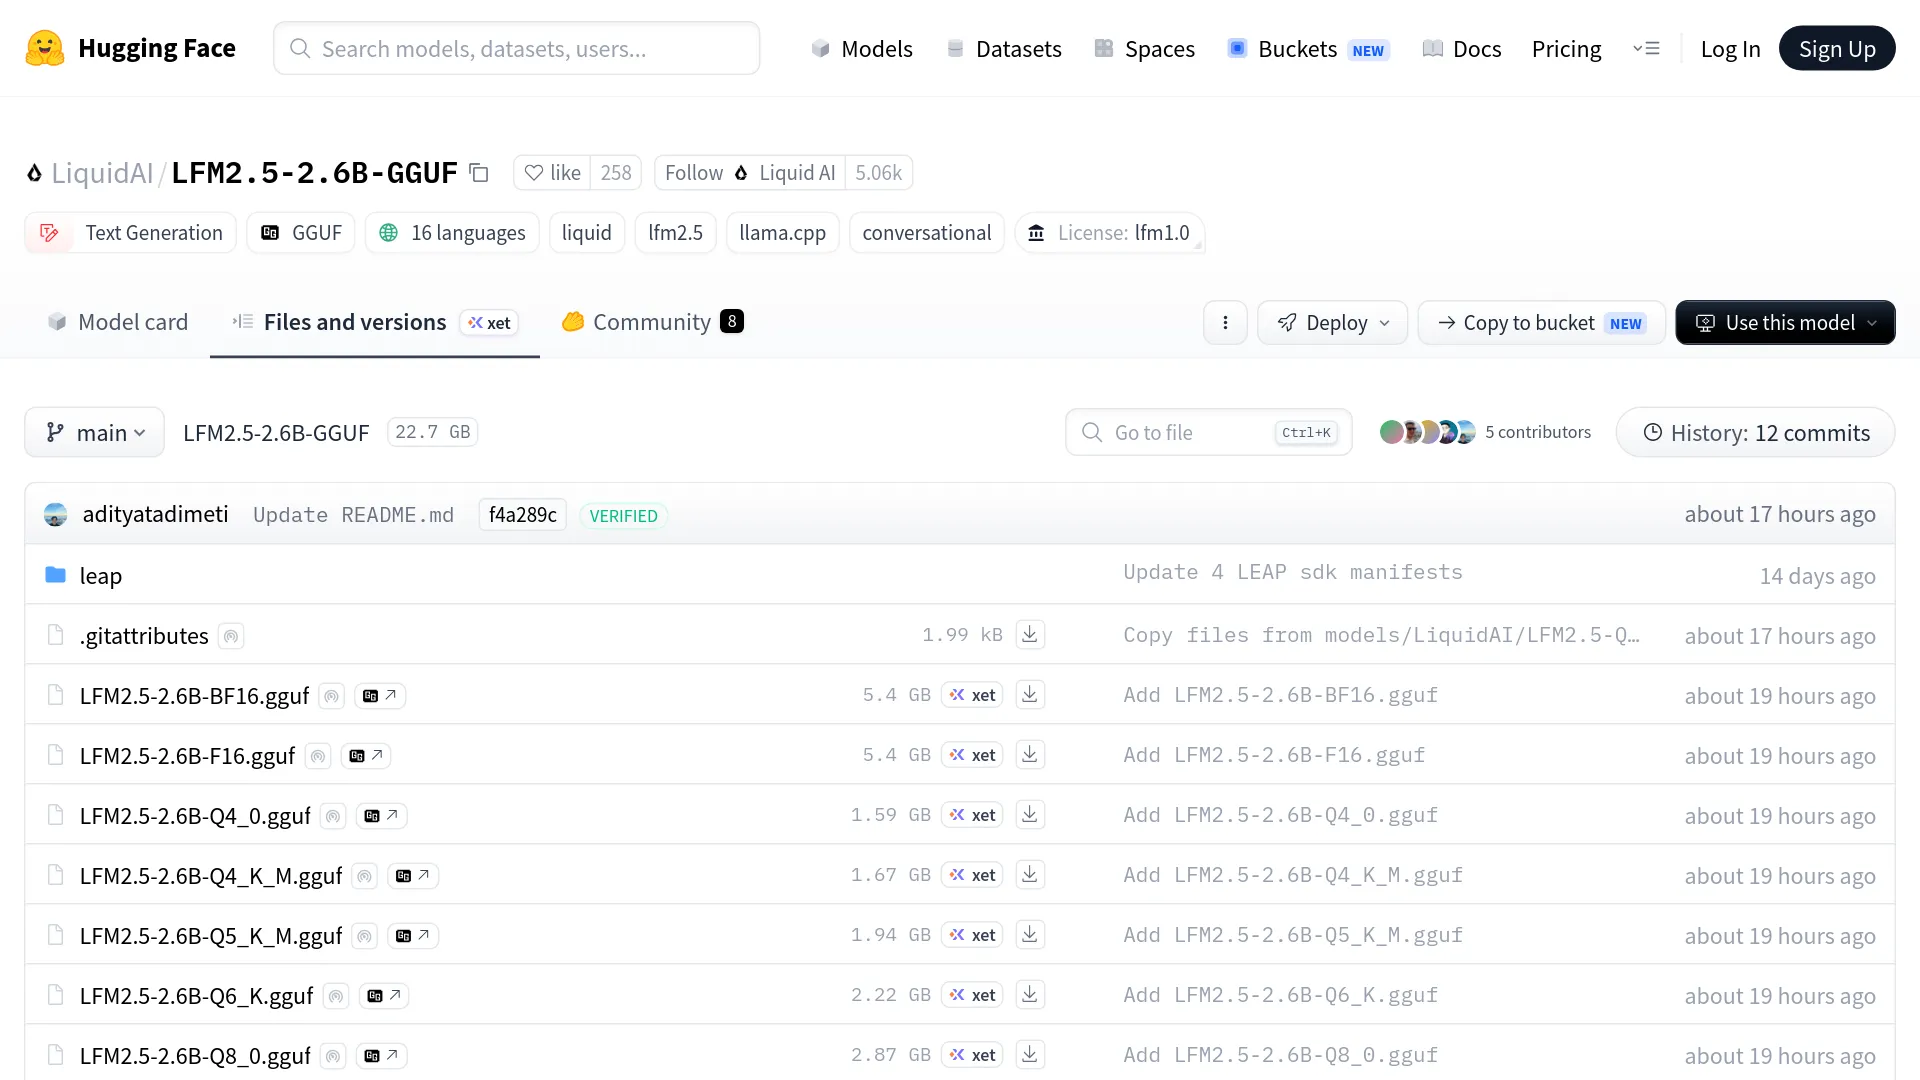
La confusione è emersa poche ore dopo il rilascio:
«Dove si può scaricare? Lo vedo su Hugging Face, ma non capisco se sia la versione normale o QAD. Potete indicarmi come fare?» — @Chitacc72 su X
Un primo utente, @MarMarLabs, ha confrontato i file del repository e ha rilevato una differenza di circa 4 KB tra la vecchia e la nuova build Q4_0: impossibile distinguerle in un file browser. La soluzione è passare a --hf-file il nome preciso del file QAD:
# official example from Liquid AI's release post
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, with the sampling flags from the official model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
Lo stesso schema con --hf-file vale per i repository dei modelli 230M e 1.2B-Instruct. Per l'uso in modalità server, @nicolasembleton ha pubblicato la forma abbreviata funzionante dopo aver notato che i comandi generati da Hugging Face erano incompleti: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. È il qualificatore dopo i due punti a selezionare la build QAD.
I numeri ufficiali, e ciò che non rivelano
La tabella dei benchmark di Liquid AI indica per ogni checkpoint QAD una qualità compresa tra il 96,5% e il 97,4% del riferimento BF16. La suite comprende GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF e BFCLv4, oltre a GSM8K per i due modelli più piccoli e AIME25 per i due più grandi. I risultati sono medie su cinque esecuzioni.
| Checkpoint | Qualità BF16 conservata | Posizionamento dichiarato | Throughput in decodifica |
|---|---|---|---|
| LFM2.5-230M | 97,1% | alla pari con Q5_K_M entro la variabilità | +4–33% rispetto a Q5_K_M |
| LFM2.5-350M | 96,5% | alla pari con Q5_K_M entro la variabilità | +4–33% rispetto a Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4% | alla pari con Q4_K_M | +3–14% rispetto a Q4_K_M |
| LFM2.5-2.6B | 96,6% | alla pari con Q4_K_M | +3–14% rispetto a Q4_K_M |
Il throughput è stato misurato su quattro piattaforme: MacBook Pro e NucBox EVO-X2 con GPU, Samsung Galaxy S26 Ultra e Raspberry Pi 5 con CPU Arm. Per i modelli 230M e 1.2B, Liquid AI dichiara inoltre che QAD Q4_0 raggiunge le prestazioni di Unsloth UD-Q4_K_XL, definito nel post come un solido checkpoint PTQ esterno.
Nel post non compaiono i punteggi dei singoli benchmark, i token al secondo grezzi per dispositivo, le dimensioni dei file, i dati sulla RAM o le barre della variabilità. Restano percentuali, intervalli e dichiarazioni di parità. La community ha quindi fatto subito i propri calcoli:
«Quindi posso passare il mio LFM2.5-2.6B locale da F16 a QAD Q4_0 e scendere da: 5,4 GB → 1,6 GB, salendo da 21 → 64 tok/s … mantenendo circa il 97% delle prestazioni BF16?» — @firedUp_Neyu, leggendo i grafici del lancio di Liquid
La parte relativa alle dimensioni torna: nel repository ufficiale F16 occupa 5,4 GB e QAD Q4_0 1,59 GB. I valori in tok/s sono invece una lettura personale dei grafici, non numeri riportati da Liquid AI nel testo.
Le informazioni che mancano nel post di lancio
Se state valutando una migrazione, ci sono tre aspetti da tenere presenti.
La copertura si ferma a quattro checkpoint. Al momento del rilascio non esistono build QAD per LFM2.5-VL-450M o LFM2.5-8B-A1B, e nella discussione su X diversi utenti chiedono a Liquid AI una versione 8B. Se il vostro dispositivo usa uno di questi modelli, oggi QAD non cambia nulla.
La questione imatrix resta aperta. I file QAD sono stati addestrati per Q4_0, ma creati senza una importance matrix. Gli esperti di quantizzazione lo hanno segnalato subito:
«Il GGUF QAD Q4_0 è stato creato senza imatrix, che avrebbe contribuito ulteriormente alla qualità dei modelli addestrati con QAD.» — u/Chromix_, r/LocalLLaMA
Un modello sotto i 3B resta comunque un modello sotto i 3B. Recuperare qualità con la quantizzazione non alza il limite delle capacità del modello, come mostrano i risultati raccolti nel thread di LocalLLaMA. Un utente NPU racconta:
«Ho appena implementato LFM2.5 2.6B sulla mia NPU per i riassunti delle riunioni e, per quanto sia impressionante viste le dimensioni, i riassunti sono molto peggiori di quelli prodotti dai modelli più grandi.» — u/DerDave
Il limite è del modello, non della quantizzazione: il report sulla quantizzazione di KikoCis registra 0 istanze SWE-bench Verified risolte su 6 con Q8_0. Gli utenti del modello 1.2B riportano inoltre risultati molto variabili a seconda del runtime: in una configurazione Ollama il modello ha prodotto testo senza senso in 9 prompt su 10, mentre in un altro caso ha funzionato in modo produttivo sotto i 5 W su un single-board computer. Se per il vostro compito serve una qualità da modello frontier, potete confrontare l'output locale con quello di un modello grande tramite una API LLM economica: un intero set di test costa pochi centesimi.
QAD Q4_0 o Q4_K_M: quale scegliere
Per i deployment llama.cpp con poca RAM e basati su questi quattro checkpoint, QAD Q4_0 è la versione a 4 bit supportata dal produttore da provare per prima. Occupa gli stessi 1,59 GB del normale Q4_0, ma è stata addestrata per raggiungere la qualità di Q4_K_M sui modelli 1.2B e 2.6B, oppure di Q5_K_M sui modelli 230M e 350M, con una decodifica rispettivamente più veloce del 3–14% o del 4–33%. Se state già usando Q4_K_M e avete RAM sufficiente, non c'è un motivo urgente per cambiare: 80 MB non sono il problema che state cercando di risolvere.
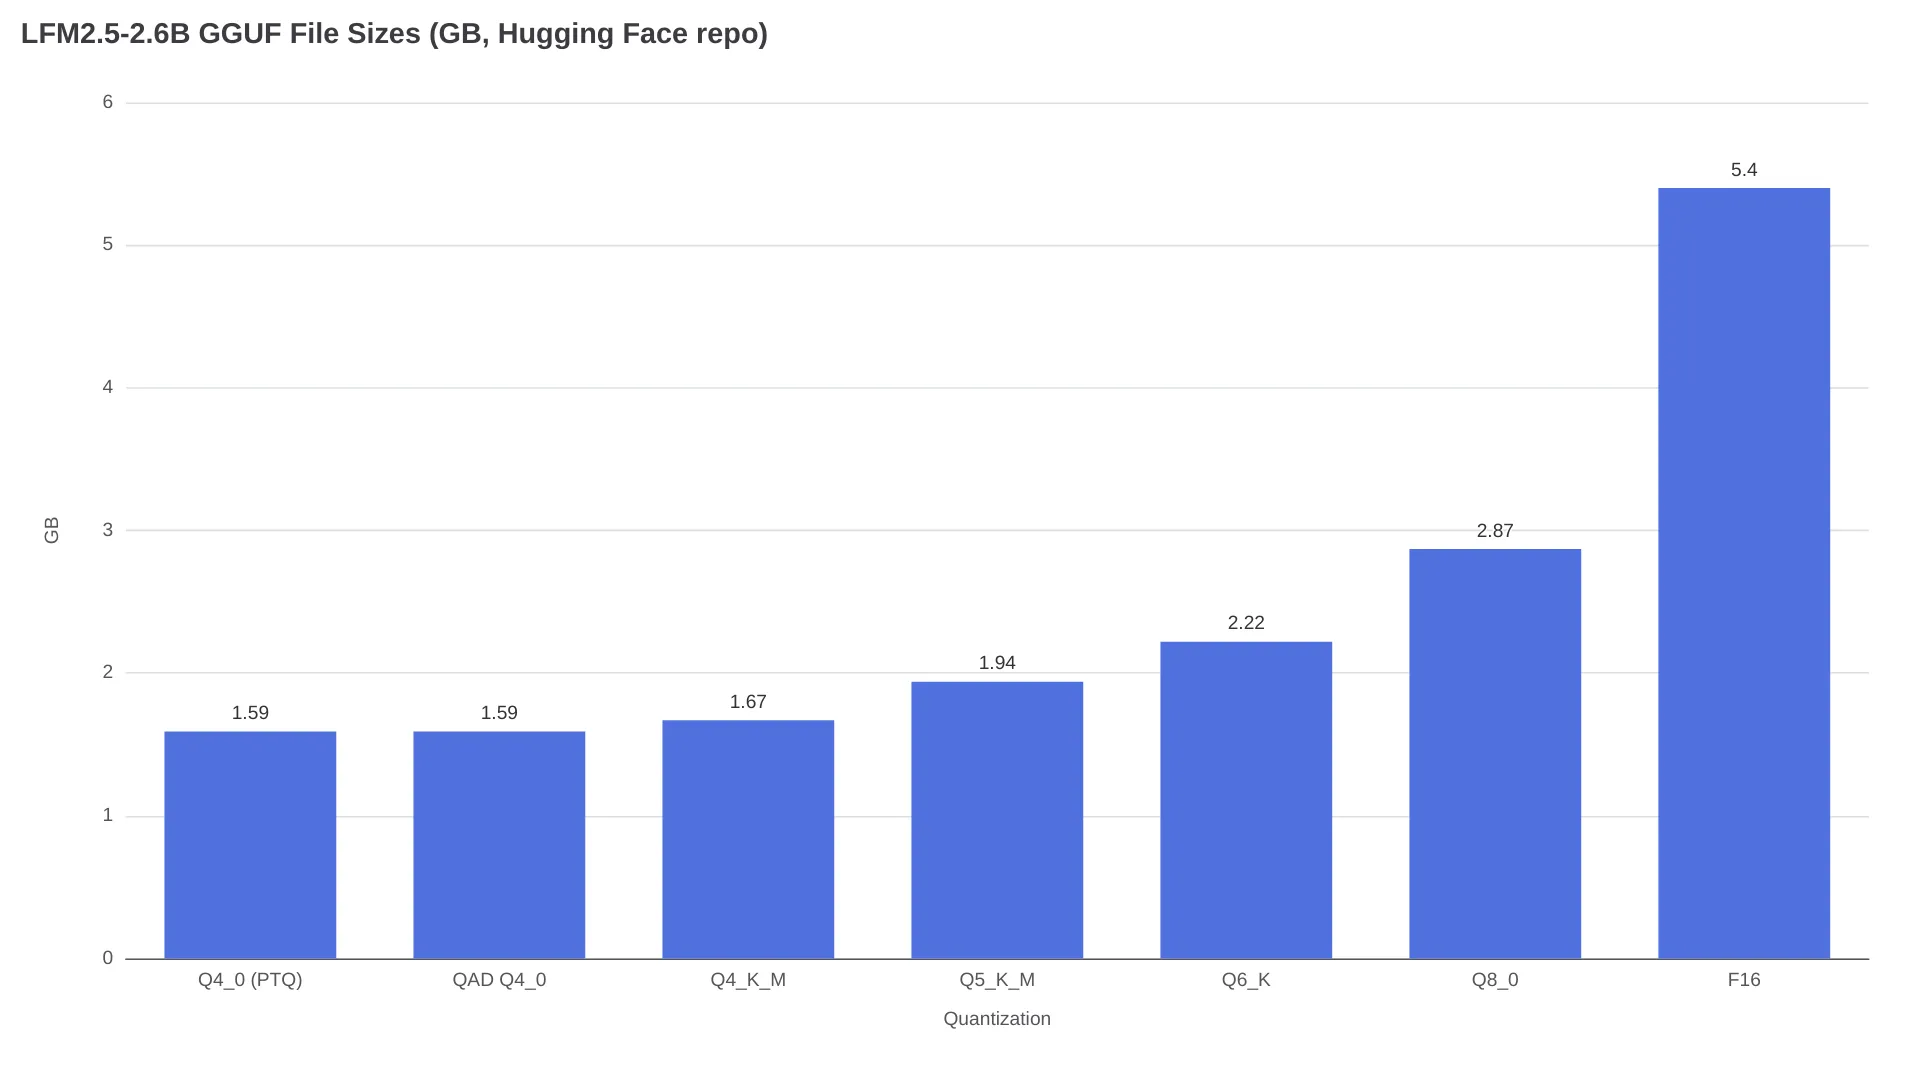
| File (2.6B) | Dimensione | Posizionamento | Sceglilo quando |
|---|---|---|---|
| Q4_0 (vecchio PTQ) | 1,59 GB | baseline non ottimizzata | da evitare: ora esiste QAD |
| QAD Q4_0 | 1,59 GB | 96,6% di BF16, alla pari con Q4_K_M | budget di 3–4 GB di RAM, decodifica su CPU, smartphone, Pi |
| Q4_K_M | 1,67 GB | scelta predefinita nella documentazione Liquid | il vostro runtime non sa selezionare il file QAD |
| Q5_K_M | 1,94 GB | 91,4% di top-1 rispetto a F16, secondo KikoCis | 6 GB o più di RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | quasi senza perdite | 8 GB o più, qualità prioritaria |
Per interpretare correttamente queste dichiarazioni di parità: la scala PTQ di KikoCis ha misurato su questo modello un accordo top-1 dei token dell'84,36% per Q4_K_M rispetto a F16, contro il 95,07% di Q6_K e il 98,23% di Q8_0. La tesi di Liquid è che QAD colmi il divario di fedeltà dei 4 bit a parità di spazio occupato: sono i loro numeri, ottenuti su cinque esecuzioni, e non esistono ancora repliche indipendenti. Una precisazione emersa nella discussione del giorno del lancio:
«Non significa che “Q4_0 batta le K-quant”. Significa che questi quattro checkpoint sono stati addestrati per Q4_0.» — @MarMarLabs
Non generalizzate il risultato: i file Q4_0 degli altri modelli restano normali quantizzazioni PTQ.
Per la memoria, il post di lancio non fornisce valori relativi alla RAM. Conviene quindi usare i calcoli del repository KikoCis: per il modello 2.6B, la KV cache in f16 richiede circa 16 KB per token, cioè all'incirca 0,54 GB con un contesto di 32K e 2,15 GB alla finestra nativa di 128K. Con --cache-type-k q8_0 --cache-type-v q8_0 il consumo si dimezza. I pesi QAD Q4_0 da 1,59 GB più una finestra da 32K portano a circa 2,13 GB prima dell'overhead del runtime; a 128K si superano i 3,7 GB. Considerate quindi 4 GB una configurazione al limite e verificate l'allocazione sul runtime che usate.
FAQ
QAD Q4_0 è migliore di Q4_K_M?
Per questi quattro checkpoint, i numeri di Liquid AI indicano che QAD Q4_0 raggiunge la qualità di Q4_K_M — o quella di Q5_K_M per i due modelli più piccoli — con una decodifica più veloce e un file più compatto. Se il vincolo è la RAM, quindi, sì. Sono però risultati del produttore, ottenuti su cinque ripetizioni e non ancora replicati in modo indipendente.
Ollama o LM Studio rilevano automaticamente il file QAD?
No. Il percorso documentato da Ollama è ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M, come indicato nella pagina ufficiale del repository; anche gli snippet predefiniti di Hugging Face puntano a Q4_K_M. Qualsiasi runtime compatibile con GGUF può caricare il file QAD, ma dovete selezionarlo indicando esplicitamente il nome del file oppure il qualificatore :QAD-Q4_0.
Quanta RAM richiede LFM2.5-2.6B QAD Q4_0?
I pesi occupano 1,59 GB; secondo i calcoli di KikoCis, la KV cache f16 richiede circa 0,54 GB con un contesto di 32K e circa 2,15 GB a 128K. La somma di pesi e cache arriva quindi a circa 2,13 GB a 32K e 3,74 GB a 128K, prima dell'overhead del runtime. La quantizzazione della KV cache in Q8_0 dimezza il costo della cache.
Quali modelli LFM2.5 hanno checkpoint QAD?
Al 19 agosto 2026, soltanto LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct e LFM2.5-2.6B. Le varianti VL-450M e 8B-A1B non ne hanno, anche se nella discussione del rilascio gli utenti hanno chiesto a Liquid AI una build QAD 8B.
Posso usare commercialmente i checkpoint QAD di LFM2.5?
I repository sono contrassegnati con LFM Open License v1.0. I repository della community riassumono i termini indicando che l'uso commerciale è consentito alle entità con un fatturato annuo inferiore a 10 milioni di dollari, mentre oltre quella soglia serve una licenza commerciale separata di Liquid AI (il riepilogo di KikoCis). Prima di distribuire il modello, leggete comunque il testo integrale della licenza.
La dichiarazione del 97% è stata verificata in modo indipendente?
Non ancora. I valori di conservazione compresi tra il 96,5% e il 97,4% sono medie su cinque esecuzioni calcolate da Liquid AI e pubblicate insieme al rilascio. Al momento della stesura non era comparso alcun benchmark di terze parti sui file QAD, e la questione dell'imatrix resta aperta su r/LocalLLaMA.
Fate un test A/B già stasera
Il dato che conta è il tasso di errore sul vostro compito, non la media di un benchmark. Prendete dieci prompt reali — JSON per le chiamate agli strumenti, schema di estrazione, lingua — e lanciate entrambi i file con impostazioni identiche:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Contate gli errori di parsing e la scelta errata degli strumenti per ciascun file, non affidatevi alle impressioni. Il compromesso ancora da chiarire è concreto: sulla carta, la qualità per gigabyte favorisce QAD Q4_0, ma i problemi del vostro deployment — risposte vuote quando il ragionamento consuma il budget di token, variazioni nel formato al cambiare della temperatura — dipendono dal runtime e dal compito. Solo i vostri dieci prompt possono dirvi quanto pesa davvero la differenza.