 AIREITER
Su r/codex torna spesso la stessa domanda: «Usavo GPT-5.5 extra-high: l’equivalente è Sol o Terra?» La risposta breve è che GPT-5.6 Sol ha esattamente lo stesso prezzo API di listino di GPT-5.5 e lo supera nei benchmark agentici. Per agenti a lunga esecuzione e attività di browsing, quindi, l’upgrade è quasi a costo zero.
Quel «quasi», però, conta. Sol addebita le scritture della cache, che con GPT-5.5 non si pagavano, e ragiona più a lungo: anche con un listino invariato, la spesa per singolo task può moltiplicarsi.
Listino identico, costo finale no
GPT-5.6 Sol e GPT-5.5 condividono le stesse tariffe API standard: $5.00 per milione di token in input, $30.00 per milione di token in output e $0.50 per l’input servito dalla cache. Ho verificato entrambe le righe sulla pagina prezzi di OpenAI il 29 luglio 2026:
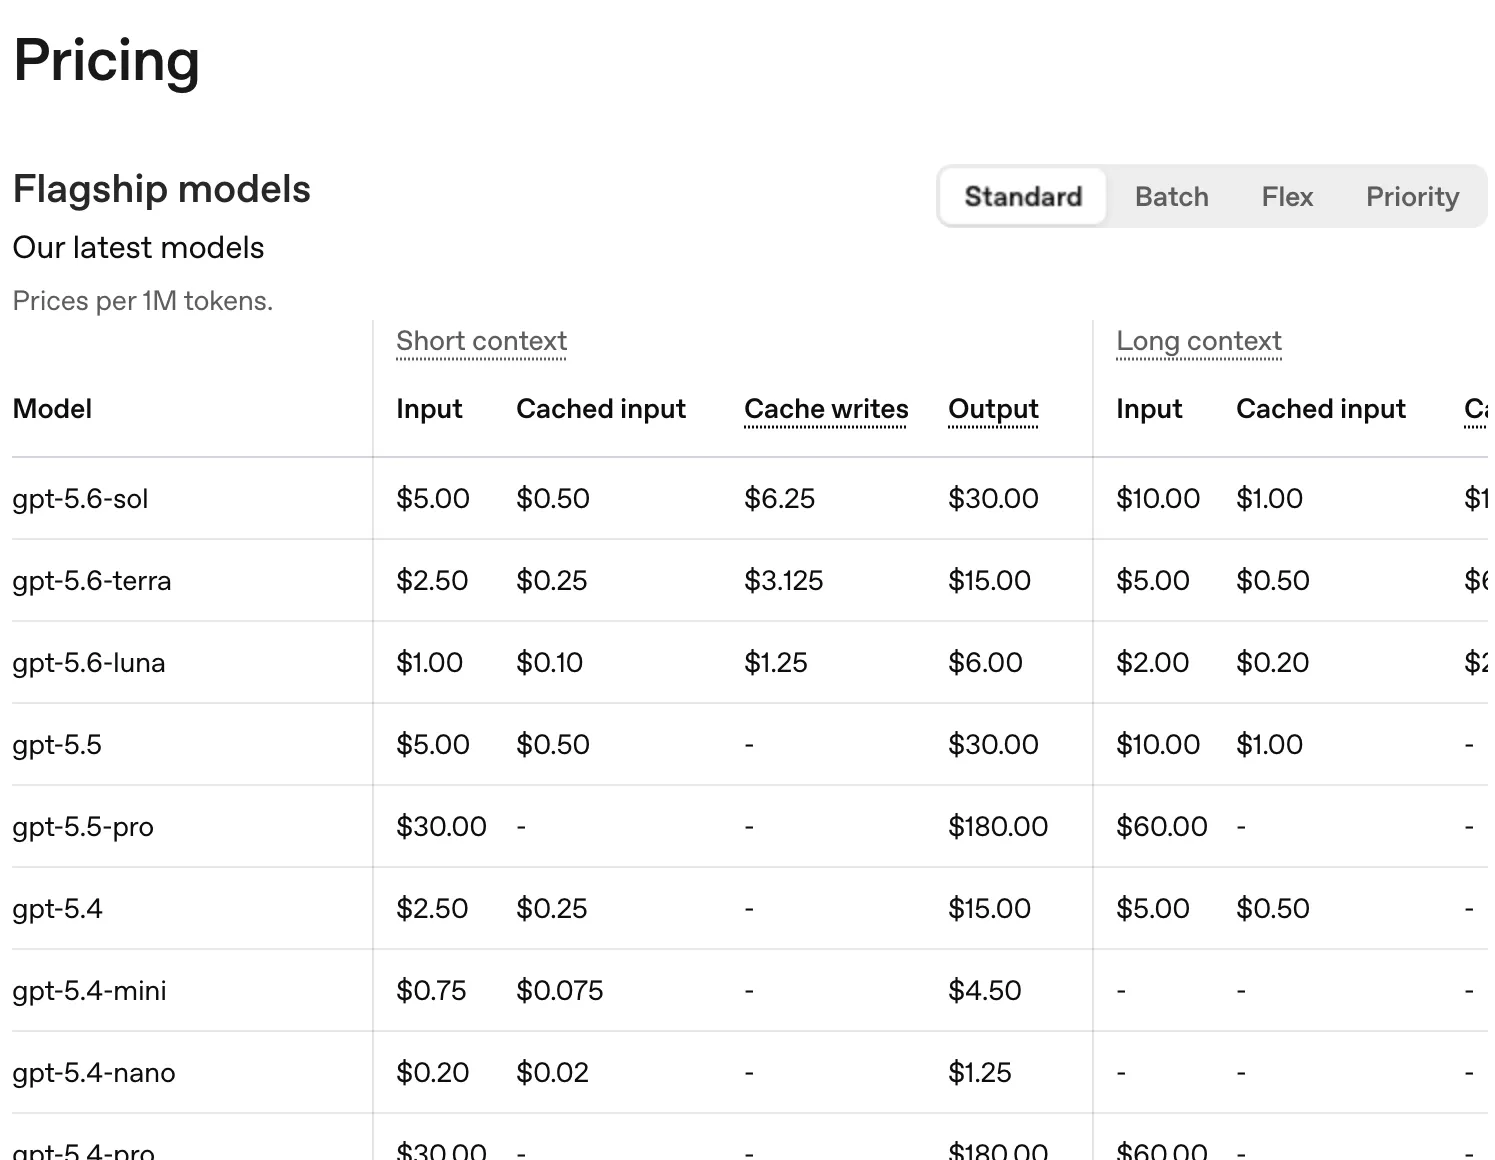
Ci sono però tre voci che distinguono i due modelli:
| Voce | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Input / Output (per 1M token) | $5.00 / $30.00 | $5.00 / $30.00 |
| Input in cache | $0.50 | $0.50 |
| Scritture cache | $6.25 | non addebitate |
| Contesto lungo (>272K) input / output | $10.00 / $45.00 | $10.00 / $45.00 |
Per chi migra, la riga più insidiosa è quella delle scritture cache. GPT-5.6 introduce breakpoint espliciti della cache con una durata minima di 30 minuti (l’analisi di Vellum ne spiega il funzionamento): la scrittura costa 1,25 volte l’input non cachato, mentre le letture mantengono uno sconto del 90%. I conti della tabella sono semplici: un segmento in cache costa $6.25 per essere scritto, poi $0.50 a ogni lettura, contro $5.00 per reinviare input non cachato. La cache si ripaga dal secondo riutilizzo; una pipeline che scrive più di quanto legge si ritrova invece un costo che GPT-5.5 non applicava.
Il secondo costo dipende dal tempo di ragionamento. Sol elabora più a lungo prima di rispondere, e i reasoning token vengono fatturati come output. Chi è passato a Codex lo segnala in modo diretto:
«5.6 sol médium è tre volte più costoso di 5.5-xhigh, pur offrendo la stessa qualità del codice (almeno al lancio di 5.5).» — r/codex, «GPT 5.5 and 5.6 conversion table»
Stesse tariffe, costo per task triplo: il modello usa tre volte i token per arrivare alla risposta. L’annuncio di GPT-5.6 di OpenAI riporta invece il dato opposto: il 22% di token input e il 23% di token output in meno rispetto a GPT-5.5 nei confronti interni. Le due affermazioni possono convivere: l’efficienza per unità di ragionamento è migliorata, ma le impostazioni di effort più elevate ragionano molto più a lungo. Nella pratica, tutto dipende dal livello di effort scelto.
Cosa migliora davvero, secondo i dati
Nelle valutazioni indipendenti, GPT-5.6 Sol e GPT-5.5 sono quasi appaiati sul piano dell’intelligenza pura: Artificial Analysis assegna a Sol (medium) 54 punti nel suo Intelligence Index v4.1, contro i 53 di GPT-5.5 (high), con identico costo combinato di $4.35 per milione di token. I miglioramenti più evidenti sono altrove:
- Latenza al primo token: 4.13 secondi per Sol contro 16.67 secondi per GPT-5.5 (high), una differenza di 4x. Negli strumenti interattivi e nei loop agentici con decine di chiamate sequenziali, è il miglioramento più percepibile nell’uso quotidiano.
- Benchmark agentici: Sol raggiunge l’88.8% su Terminal-Bench 2.1 e il 92.2% su BrowseComp. I guadagni più marcati di questa release sono concentrati nell’uso degli strumenti su orizzonti lunghi.
- Contesto: 1M token per Sol contro 922K per GPT-5.5, con in più un ragionamento che persiste tra i turni della conversazione, come documentato nella stessa analisi di Vellum linkata sopra.
- Velocità di output: qui c’è l’unico passo indietro. Sol genera in streaming a 65 token al secondo, contro i 77.3 di GPT-5.5. I job di generazione in massa diventano più lenti, non più rapidi.
La suite di coding a lungo orizzonte di CodeRabbit, con oltre 100 task in cinque linguaggi, attribuisce a Sol un pass rate del 63.7%. Nel benchmark di code review, Sol aggiunge 7.4 punti percentuali rispetto a un’integrazione di riferimento, con un’importante riserva: la precisione delle review di Sol è stata misurata al 31.6%. Individua quindi più problemi reali, ma li accompagna a più rumore. Gli stessi tester hanno osservato Sol consumare 8 round su una modifica semplice dopo aver imboccato una strada sbagliata. Essere più forte nelle maratone non significa essere immune ai vicoli ciechi.
Stessi tre prompt, entrambi i modelli
I benchmark premiano il lavoro su orizzonti lunghi, ma la maggior parte delle chiamate API è breve. Per questo il 29 luglio 2026 ho inviato gli stessi tre prompt a gpt-5.6-sol e gpt-5.5: una correzione di un bug Python nella gestione delle date, un puzzle di logica con vincoli e esattamente due risposte valide, e un’estrazione JSON rigorosa con una trappola, cioè una data senza anno che le regole imponevano di convertire in null anziché indovinarla. Una chiamata API per task, effort di reasoning predefinito, nessuno strumento e nessun retry. È un campione ridotto, non un benchmark.
Entrambi hanno risolto tutti e tre i task. GPT-5.5 ha corretto il bug che causava il crash a dicembre usando calendar.monthrange; Sol ha costruito manualmente una tabella corretta per gli anni bisestili. Tutti e due hanno trovato esattamente i due ordini di deployment validi, restituito JSON identico byte per byte nell’estrazione e rifiutato di inventare un anno per «il 14 luglio».
Token consumati e velocità hanno raccontato una storia meno lineare:
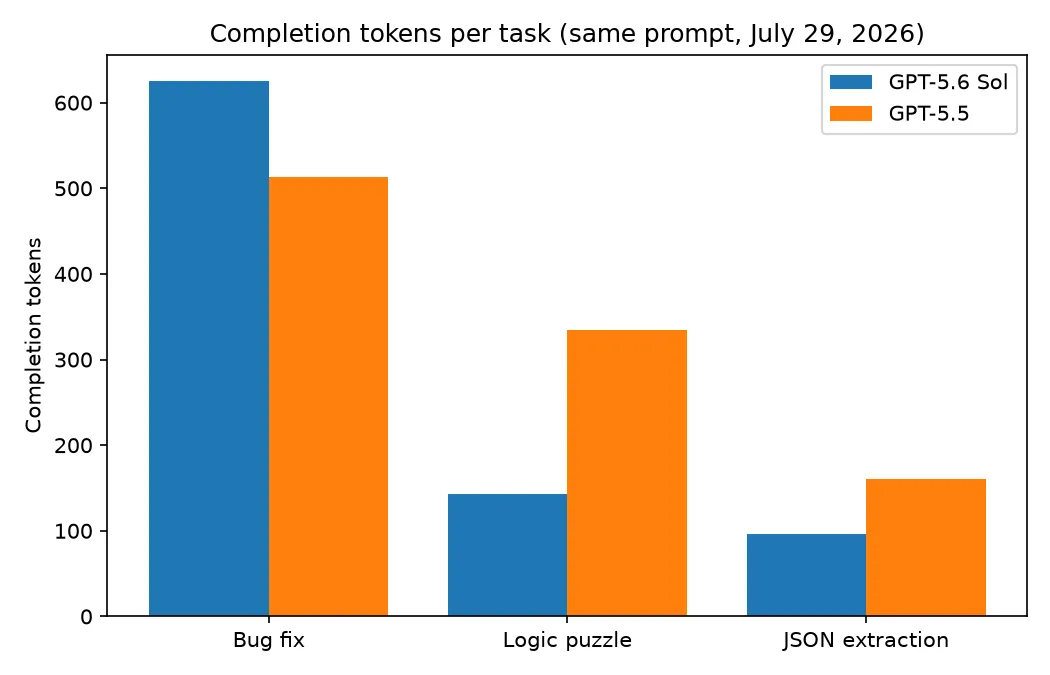
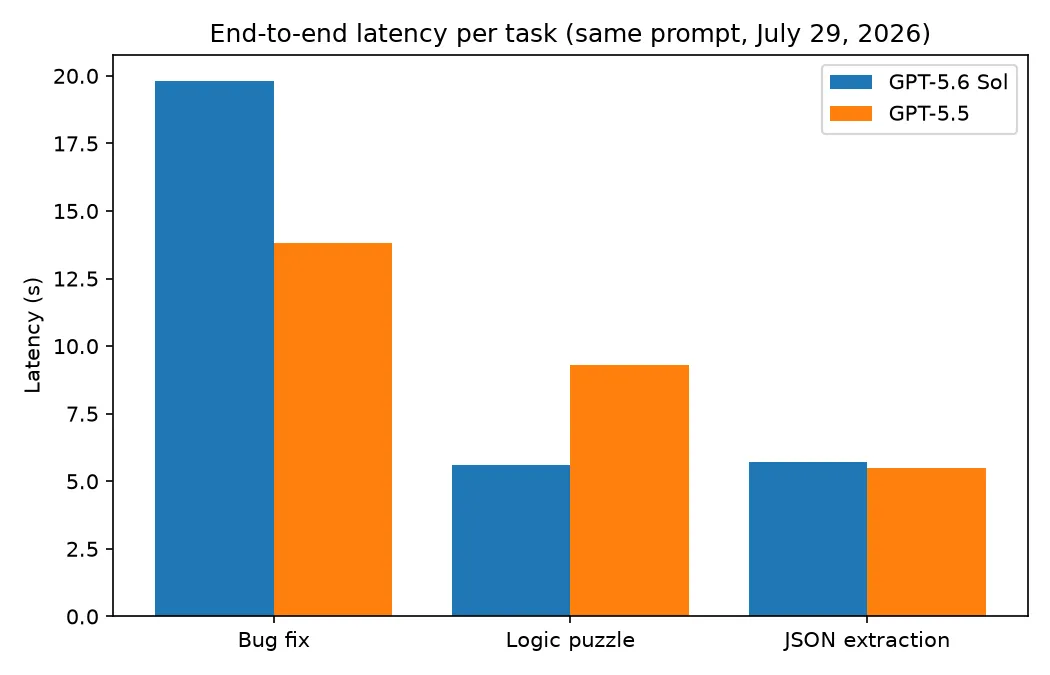
Nel complesso Sol ha usato meno completion token, 864 contro 1,007, ma è stato più lento e verboso nel task di codice: 19.8 secondi e 625 token, contro 13.8 secondi e 513. Nel puzzle logico i ruoli si sono invertiti: Sol ha risposto in 5.6 secondi con 143 token, mentre GPT-5.5 ha impiegato 9.3 secondi e 334 token. Dopo aver osservato entrambi, la mia conclusione è questa: sui task brevi e ben specificati i modelli sono intercambiabili, e questo test da solo non giustificherebbe una migrazione. Il vero argomento a favore dell’upgrade resta il lavoro agentico e con contesti lunghi visto nei benchmark sopra.
Come passare dai livelli di effort di GPT-5.5 a 5.6
Secondo l’analisi di Vellum già citata, l’ID modello senza suffisso gpt-5.6 instrada di default a gpt-5.6-sol. Chi aggiorna semplicemente sostituendo l’alias si ritrova quindi sul tier di punta, e con il relativo conto, senza averlo scelto. Per una migrazione consapevole, ci sono tre punti di riferimento:
- GPT-5.5 xhigh → Sol medium è l’equivalenza operativa emersa nella community: il report di r/codex citato sopra parla di parità qualitativa con 5.5 e di un costo per task circa 3x superiore attorno al lancio. Consideratela un’ipotesi iniziale da verificare sui vostri prompt, non una garanzia. I workload sensibili al budget che usavano 5.5 high sono più vicini a GPT-5.6 Terra, a $2.50/$15, cioè metà del listino di Sol.
- Ai livelli massimi, il tempo di ragionamento lievita. Gli utenti ChatGPT Pro riportano che GPT-5.6 impiega 20–50 minuti su task per cui 5.5 Pro ne usava 5–10. È un’osservazione su ChatGPT, ma lo stesso stack di ragionamento viene fatturato come token di output nell’API. L’impostazione
reasoning.mode: "pro"è disponibile su tutti e tre i tier 5.6, quindi il limite superiore è opzionale. - I vecchi prompt possono penalizzare il nuovo modello. Il team di test di Every.to ha rilevato un netto miglioramento dell’output di Sol solo dopo aver eliminato istruzioni difensive scritte per modelli più vecchi, ad esempio regole come «controlla sempre due volte X», che spingevano Sol a verificare e costruire troppo. Dopo la migrazione del modello, va riesaminato anche il system prompt: l’impalcatura prudenziale necessaria a GPT-5.5 ora è una tassa.
Chi dovrebbe passare a Sol e chi no
Passate a GPT-5.6 Sol se il vostro workload è agentico: uso di strumenti in più passaggi, ricerca via browsing o sessioni di coding su scala repository. È qui che si vedono l’88.8% di Terminal-Bench, il 92.2% di BrowseComp e il taglio di 4x della latenza al primo token, che si accumula a ogni iterazione del loop. Con lo stesso listino $5/$30, il salto di capacità non costa nulla in più, a patto che token di ragionamento aggiuntivi e scritture cache non si mangino il vantaggio. Il contesto da 1M e la persistenza del ragionamento tra turni eliminano inoltre due workaround che le pipeline 5.5 dovevano costruirsi da sole.
Restate su GPT-5.5, per ora, se il traffico è composto da chiamate brevi e ben definite: estrazione, classificazione, correzioni di codice one-shot, generazione ad alto volume. Il mio test sui tre prompt ha mostrato parità proprio su questo tipo di lavoro, mentre lo streaming più lento di Sol, 65 contro 77.3 token al secondo, peggiora oggettivamente i job bulk. Le pipeline che scrivono molto nella prompt cache dovrebbero calcolare prima la voce da $6.25. E se cercate un upgrade che riduca il conto mantenendo una qualità simile, la risposta è Terra, non Sol.
Ho eseguito il confronto diretto tramite AIReiter, che mette a disposizione gpt-5.6-sol e gpt-5.5 dietro un’unica API key: per un test A/B basta cambiare la stringa del modello e confrontare tasso di successo, latenza end-to-end e completion token per task sul vostro traffico reale.
FAQ
GPT-5.6 Sol è migliore di GPT-5.5?
Sui task agentici, sì: 88.8% su Terminal-Bench 2.1, 92.2% su BrowseComp e latenza al primo token 4x più bassa. Nei task brevi one-shot, le valutazioni indipendenti li separano di un solo punto, 54 contro 53 su Artificial Analysis, e i miei test con gli stessi prompt non hanno rilevato differenze di correttezza.
GPT-5.6 Sol costa più di GPT-5.5?
Il prezzo di listino è identico: $5 per l’input e $30 per l’output per milione di token. Sol aggiunge una tariffa di $6.25 per le scritture cache, mai applicata da GPT-5.5, e con effort più elevati usa più reasoning token per task. Gli utenti di r/codex hanno misurato un costo per task di circa 3x a parità di qualità con 5.5 xhigh.
Qual è l’equivalente GPT-5.5 xhigh in GPT-5.6?
Sol con effort medium offre una qualità del codice comparabile a circa tre volte il costo per task. Se conta più la parità di costo che il tetto massimo di capacità, Terra è il corrispettivo economico più vicino.
Posso continuare a usare GPT-5.5 dopo l’upgrade?
Sì. GPT-5.5 è ancora presente nella pagina prezzi di OpenAI alle stesse tariffe, verificate il 29 luglio 2026 come mostra lo screenshot sopra, quindi per ora non c’è alcun obbligo di migrazione.
La scelta, in una tabella
| Il tuo workload | Scegli | Dato decisivo |
|---|---|---|
| Agenti multi-step, browsing, coding su scala repository | GPT-5.6 Sol | 88.8% su Terminal-Bench, latenza al primo token 4x più bassa, stesso listino |
| Estrazione / classificazione / correzioni one-shot brevi | GPT-5.5 (per ora) | Parità nei test con gli stessi prompt; 5.5 genera in streaming il 19% più velocemente |
| Molte scritture nella prompt cache | GPT-5.5, oppure prima riprogettare l’architettura | La nuova tariffa di Sol per le scritture cache è $6.25/1M |
| Stessa qualità, conto più basso | GPT-5.6 Terra | $2.50/$15, metà del prezzo di Sol; vedi sopra il confronto Terra vs 5.5 |
| Massima profondità di ragionamento | Sol con reasoning.mode: "pro" | Deliberazione di 20–50 min dove 5.5 impiegava 5–10 |