 AIREITER
Su 1.715 sessioni Codex, GPT-5.6 Sol ha consumato in media 16,45 milioni di token per sessione: 2,25 volte i 7,30 milioni di token di media di GPT-5.5 in una finestra comparabile di 1.667 sessioni. Il prezzo per token è lo stesso, ma i token utilizzati sono più del doppio. A peggiorare il quadro, un difetto documentato nella Responses API sembra gonfiare di 6 volte o più gli output_tokens fatturati per Sol. Se la fattura di GPT-5.6 vi sembra sbagliata, probabilmente lo è.
Quanti token consuma davvero GPT-5.6 Sol
Lo sviluppatore Vincent Schmalbach ha monitorato il consumo di token in due finestre di 14 giorni di utilizzo di Codex. Il confronto mette GPT-5.5 xhigh accanto a GPT-5.6 Sol xhigh, con un numero di sessioni quasi identico:
| Metrica | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Sessioni | 1,667 | 1,715 |
| Token totali | 12.17B | 28.22B |
| Token per sessione | 7.30M | 16.45M |
Il numero di sessioni è aumentato del 2,9%, mentre i token per sessione sono saliti del 125%. A parità approssimativa di carico di lavoro, il consumo totale è passato da 12,17 miliardi a 28,22 miliardi di token: un incremento di 2,32 volte.
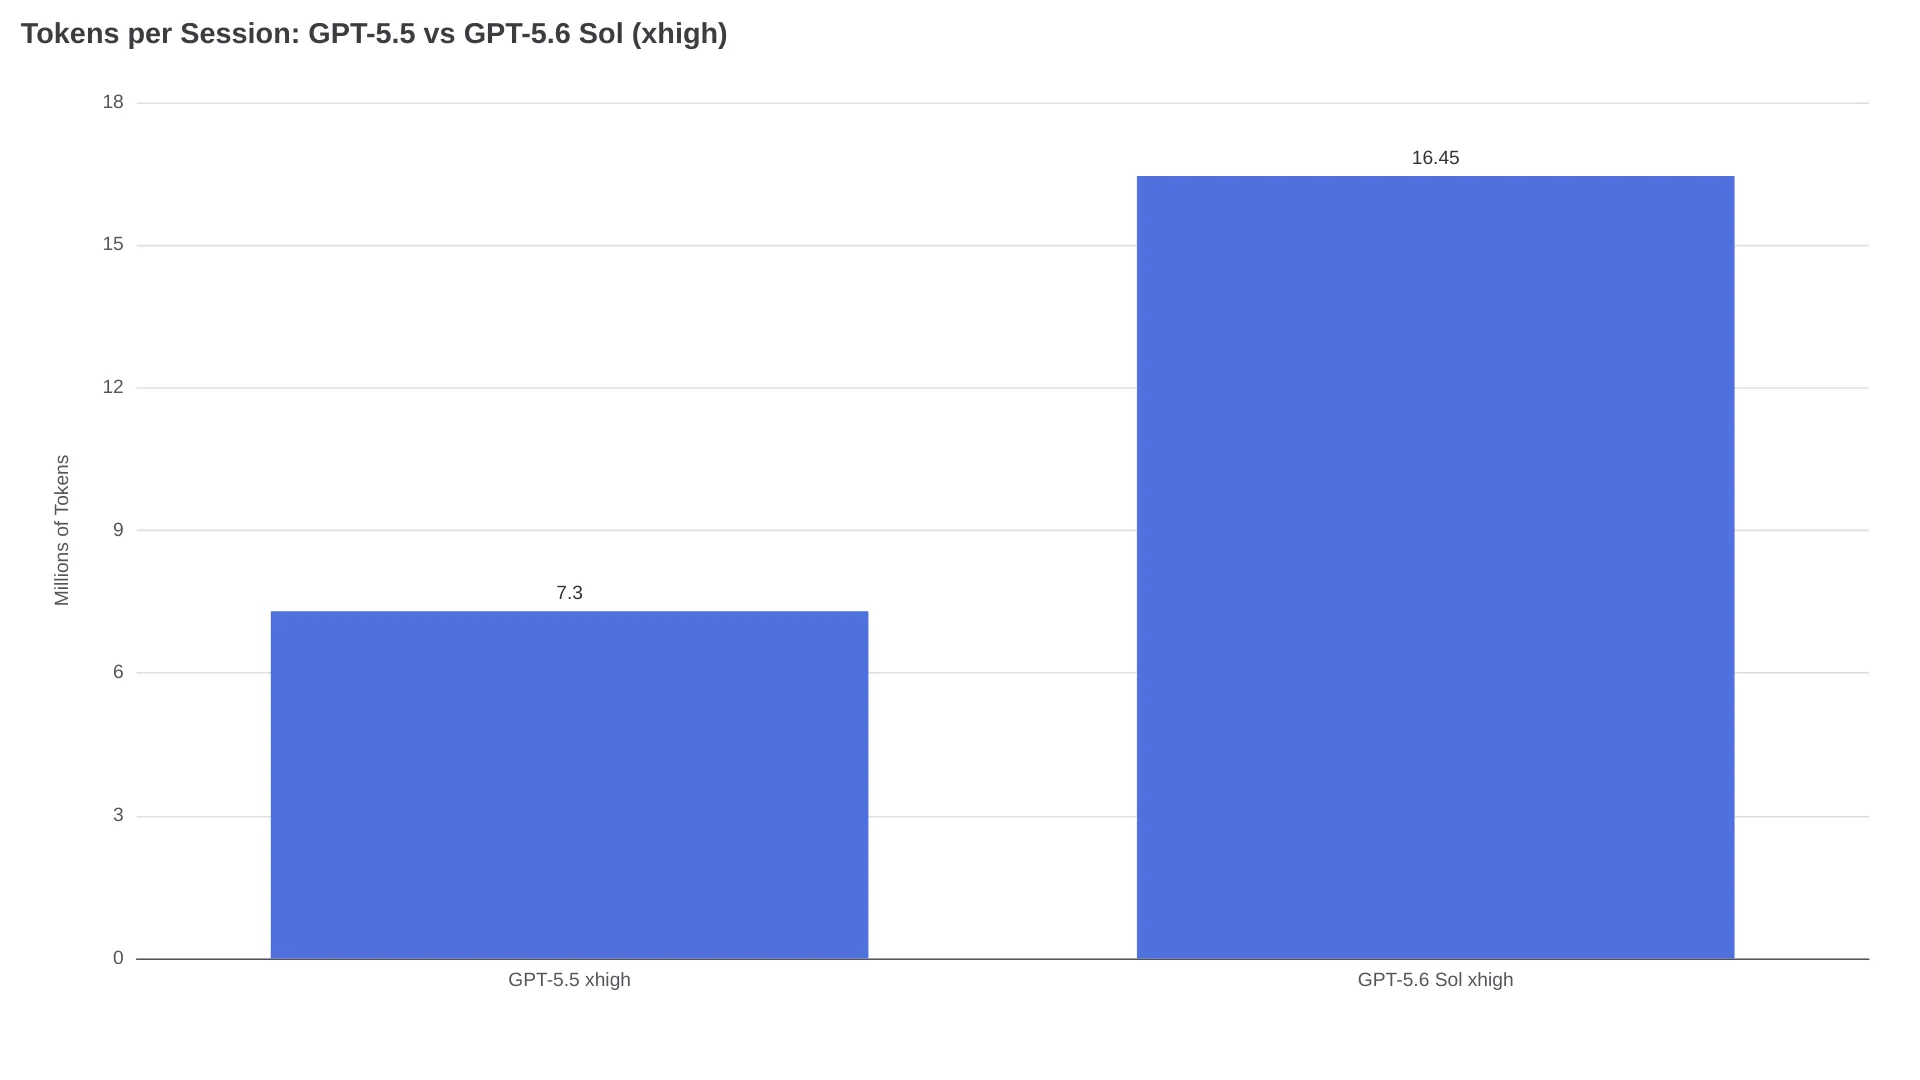
La pagina dei prezzi di OpenAI indica per GPT-5.6 Sol $5/1M in input e $30/1M in output, esattamente come GPT-5.5. A tariffa invariata, 2,25 volte i token significa un costo per attività di circa 2,25 volte superiore. GPT-5.6 Sol ha inoltre introdotto un sovrapprezzo per la scrittura della cache, pari a 1,25 volte la tariffa di input, che GPT-5.5 non prevedeva.
"GPT 5.6 Sol è una fornace di token. Anche Sol su medium o high sembra divorarli. Userò 5.6 solo per pianificazione complessa o bug difficili." — utente di r/codex
I tre abbonamenti di Schmalbach, che prima coprivano una settimana di lavoro intenso, ora si esauriscono in circa un giorno di utilizzo medio.
Perché Sol usa più token
Sol è più efficiente dei concorrenti in termini di token per punto ottenuto nei benchmark. Nell'Artificial Analysis Coding Agent Index, per risultati equivalenti usa meno token di output rispetto a Claude Fable 5. Nelle sessioni reali, però, Sol ragiona in modo più aggressivo: pianifica, torna sui propri passi, verifica ed esplora alternative. Il compromesso è un consumo superiore per attività, anche se ogni token svolge un lavoro più utile.
Il difetto di fatturazione che gonfia i token in output
Al maggiore consumo effettivo si aggiunge un difetto documentato di contabilizzazione nella Responses API, che sembra gonfiare il campo output_tokens, su cui viene calcolata la fatturazione. OpenAI sta indagando, ma non ha confermato pubblicamente la causa alla radice.
Uno sviluppatore ha documentato il problema su 710 chiamate GPT-5.6 e 22.922 chiamate di reasoning complessive. GPT-5.6 è la prima famiglia di modelli a produrre più elementi reasoning per risposta, con mediana k=9 per Sol e k=4 per Terra. Durante la generazione, un accumulatore nell'API aggiunge il totale progressivo del reasoning una volta per ogni elemento di reasoning, oltre al conteggio finale corretto.
La formula è:
output_tokens ≈ R × (k + 3) / 2Dove R rappresenta i token di reasoning effettivi e k il numero di elementi di reasoning. Per Sol, con k mediano pari a 9, il conteggio fatturato risulta gonfiato di circa 6 volte. Per Terra, con k=4, di circa 3,6 volte.
Come appare il problema in una fattura reale
L'esempio documentato più estremo riguarda una singola chiamata GPT-5.6 Terra che ha restituito una risposta di quattro caratteri, d1d4, ma è stata fatturata per 466.818 token di output, a fronte di appena 21.064 token di reasoning effettivi.
| Dato riportato dall'API | Valore |
|---|---|
output_tokens (fatturati) | 466,818 |
reasoning_tokens (effettivi) | 21,064 |
| Output visibile | d1d4 (4 caratteri) |
| Elementi di reasoning (k) | 41 |
Con k=41, la formula prevede R × (41+3)/2 = 21,064 × 22 = 463,408, entro lo 0,7% dell'importo fatturato. L'autore della segnalazione ha verificato il dato nella propria dashboard di fatturazione: sommando gli output_tokens dell'API e applicando le tariffe pubblicate, ha riprodotto gli addebiti della dashboard fino al decimo di centesimo. Considerando tutte le sue chiamate GPT-5.6, circa $284 dei circa $320 fatturati erano sovraccosti.
Il bug esisteva già prima di GPT-5.6
Con k=1, cioè un solo elemento di reasoning come nei modelli precedenti a 5.6, la formula diventa R × 4/2 = 2R: un sovraccarico fisso di 2 volte. L'autore della segnalazione lo ha confermato confrontandolo con l'export di utilizzo di OpenAI per maggio 2026:
| Modello | Token di output fatturati | Conteggio reale | Rapporto |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini (controllo) | 12,054,680 | 9,160,567 | 1.01x |
GPT-5.6 non ha introdotto il difetto: è il primo modello a suddividere il reasoning in molti elementi, trasformando un silenzioso raddoppio in un moltiplicatore ben più pesante. Il motivo è che il reasoning viene emesso in blocchi di circa 512 token, quindi k ≈ ceil(R/512). Sostituendo questo valore nella formula si ottiene output_tokens ≈ R²/1024 + 3R/2: il sovraccarico cresce quadraticamente con la lunghezza del reasoning. Raddoppiare il ragionamento significa, approssimativamente, quadruplicare la fattura.
Al momento della stesura, nell'agosto 2026, il personale OpenAI ha risposto alla segnalazione del bug chiedendo dati aggiuntivi, ma non sono state confermate pubblicamente né una correzione né una rettifica della fatturazione.
Prezzi attuali di GPT-5.6 dopo il taglio del 30 luglio
Il 30 luglio 2026, OpenAI ha ridotto il prezzo di Luna dell'80% e quello di Terra del 20%. I prezzi di Sol sono rimasti invariati. Ecco le tariffe attuali riportate nella pagina dei prezzi di OpenAI:
| Modello | Input (breve) | Input in cache | Scritture cache | Output (breve) | Output (lungo) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
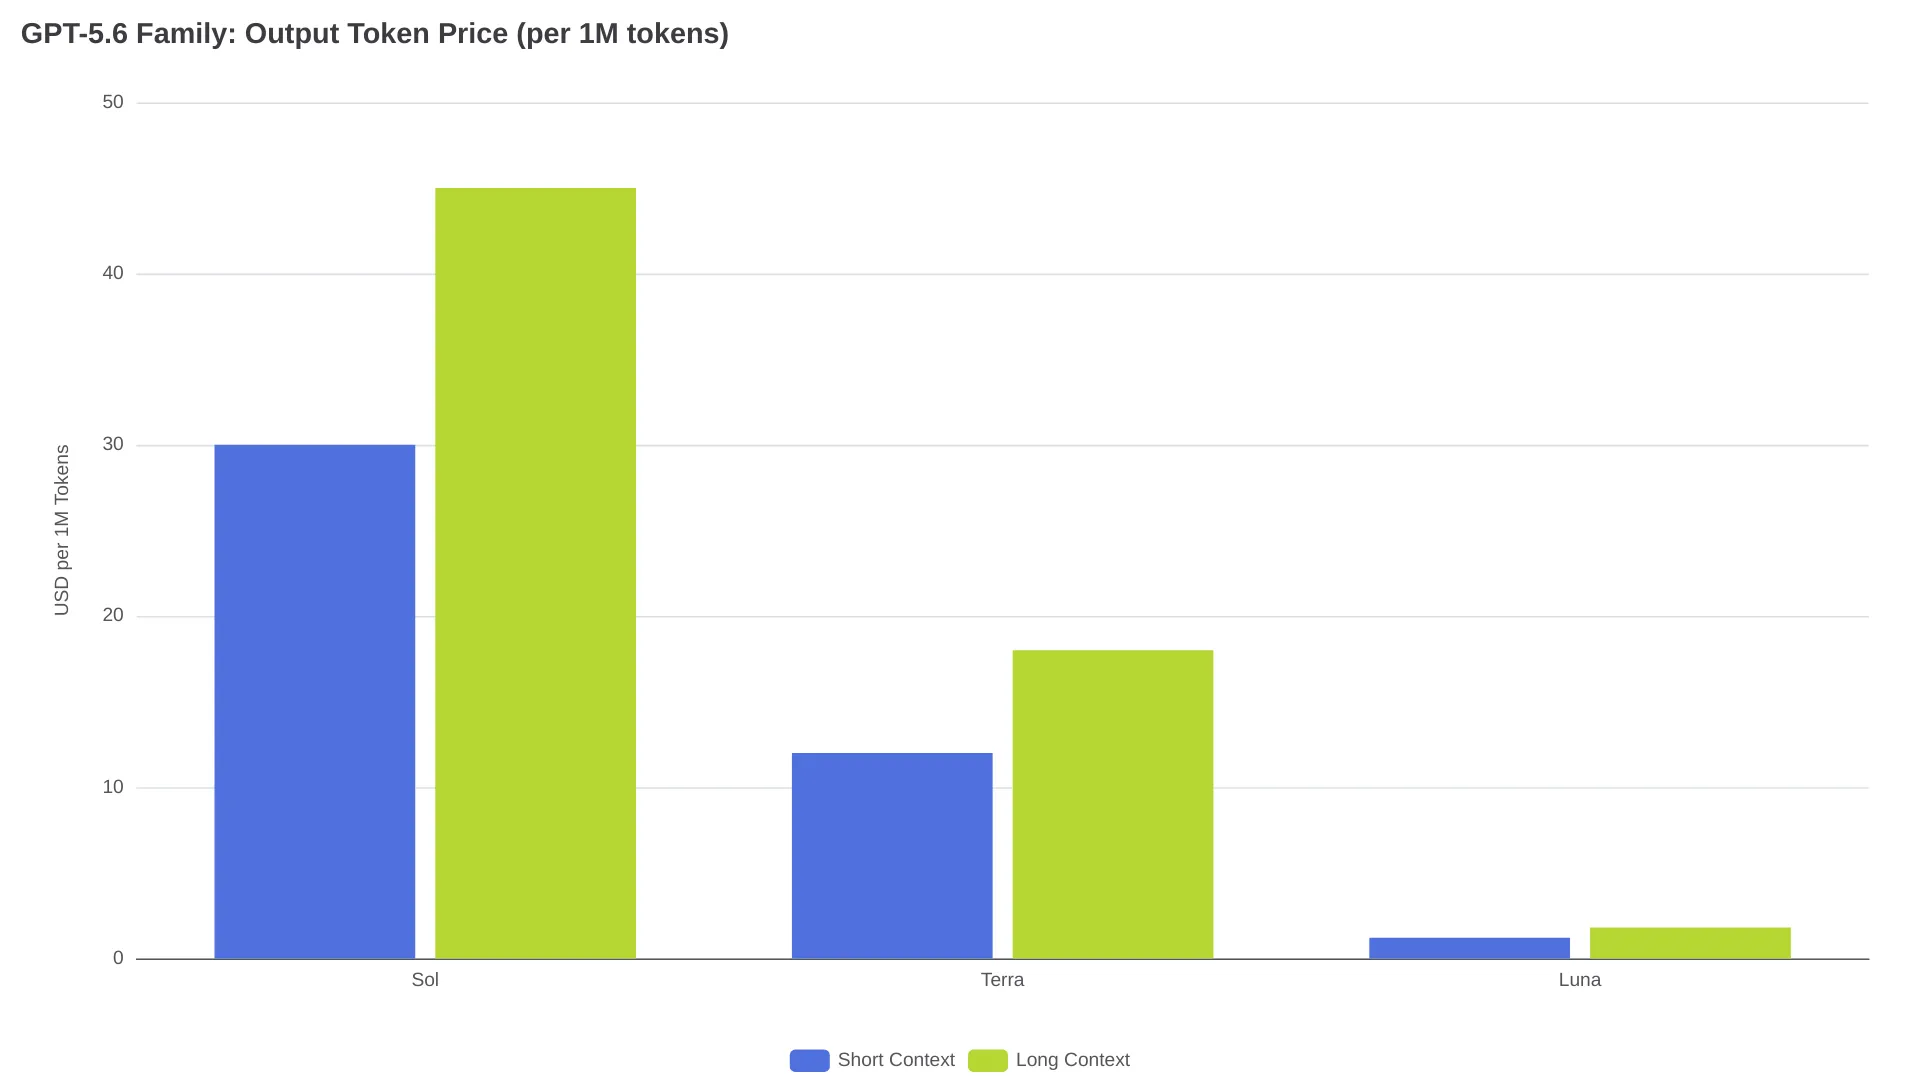
Sol costa quanto GPT-5.5 per token, ma usa 2,25 volte i token per attività: il costo effettivo per attività raddoppia quindi all'incirca.
Le scritture nella cache sono una nuova voce di costo. GPT-5.6 applica per queste operazioni 1,25 volte la tariffa di input, ovvero $6.25/1M per Sol. GPT-5.5 non aveva alcun costo di cache-write. Se il carico di lavoro ha una bassa percentuale di cache hit, si aggiunge un sovrapprezzo del 25% ai costi di input, che prima non esisteva.
Luna ora costa meno di GPT-5.4 nano. Con $0.20/$1.20 contro i $0.20/$1.25 di nano, Luna è diventato il modello più economico dell'offerta OpenAI dopo il taglio.
Tre modi per abbassare la spesa in token con GPT-5.6
Passare a Terra per le attività di routine
La tariffa di output di Terra è $12/1M, il 60% in meno rispetto ai $30/1M di Sol. Nell'Artificial Analysis Coding Agent Index, Terra ottiene un punteggio appena superiore a Claude Fable 5. Dopo il taglio di prezzo del 20% di luglio, Terra a $2.00/$12.00 costa anche meno della vecchia tariffa di GPT-5.5.
Quando ha ancora senso scegliere Sol? Nelle sessioni di debug in più passaggi, nella pianificazione architetturale su grandi codebase e nell'analisi di sicurezza. Sono attività che traggono vantaggio da catene di ragionamento estese. Per coding standard, analisi e generazione di contenuti, Terra offre risultati paragonabili con una frazione del consumo di token.
Ridurre il livello di effort
Il parametro reasoning.effort controlla quanti token di reasoning genera il modello, e il difetto di fatturazione segnalato scala direttamente con il numero di elementi di reasoning (k). Con medium, Sol emette meno elementi di reasoning che con xhigh, quindi il gonfiaggio della fatturazione si riduce in proporzione.
"Uso Terra Ultra e il consumo di token mi sembra effettivamente molto più efficiente rispetto a GPT 5.5." — utente di r/codex
Il comportamento da fornace di token si concentra su Sol ai livelli di effort più alti. Impostare reasoning.effort su medium o high anziché su xhigh o max è il singolo cambiamento con l'impatto maggiore.
Massimizzare i cache hit
GPT-5.6 ha introdotto breakpoint espliciti per la cache e una durata minima della cache di 30 minuti. Le letture dalla cache ricevono uno sconto del 90%, facendo scendere il costo di input di Sol da $5.00 a $0.50 per 1M. Le scritture nella cache, però, costano 1,25 volte la tariffa di input: $6.25/1M per Sol.
Strutturate i prompt in modo che il messaggio di sistema e il contesto statico si trovino prima di un breakpoint della cache. Il punto di pareggio dipende dal carico di lavoro specifico: il sovrapprezzo di scrittura equivale al 25% della tariffa di input, mentre il risparmio sulle letture è del 90%; servono quindi cache hit sufficienti affinché i risparmi in lettura superino il costo extra di scrittura. Nei carichi in cui la maggior parte delle richieste condivide un lungo prompt di sistema, il vantaggio arriva rapidamente.
FAQ
OpenAI ha riconosciuto il difetto di fatturazione?
Un membro del personale OpenAI, Mark G., ha risposto alla segnalazione sul forum della community il 12 luglio 2026, chiedendo request ID e timestamp per l'indagine. Ad agosto 2026 non sono state confermate pubblicamente né una correzione né rettifiche retroattive della fatturazione.
Come verificare se il difetto di fatturazione interessa il mio account?
Per ogni risposta con più elementi di reasoning, sommate usage.output_tokens_details.reasoning_tokens e i token della completion visibile. Se usage.output_tokens supera questa somma di oltre pochi punti percentuali, è probabile che il comportamento di ri-somma cumulativa documentato nella segnalazione sul forum stia incidendo sulla fattura. Scaricate il CSV di utilizzo dalla dashboard di OpenAI e controllate i dati per modello.
Conviene passare da Sol a Terra?
Per la maggior parte dei carichi di lavoro API, Terra costa meno e ottiene risultati competitivi nei benchmark di coding. Il vantaggio di Sol emerge nelle attività più difficili: i benchmark di OpenAI mostrano che Sol supera Terra soprattutto nel reasoning multi-step e nella ricerca sulla sicurezza, dove un tempo di ragionamento più lungo offre il massimo ritorno.