 AIREITER
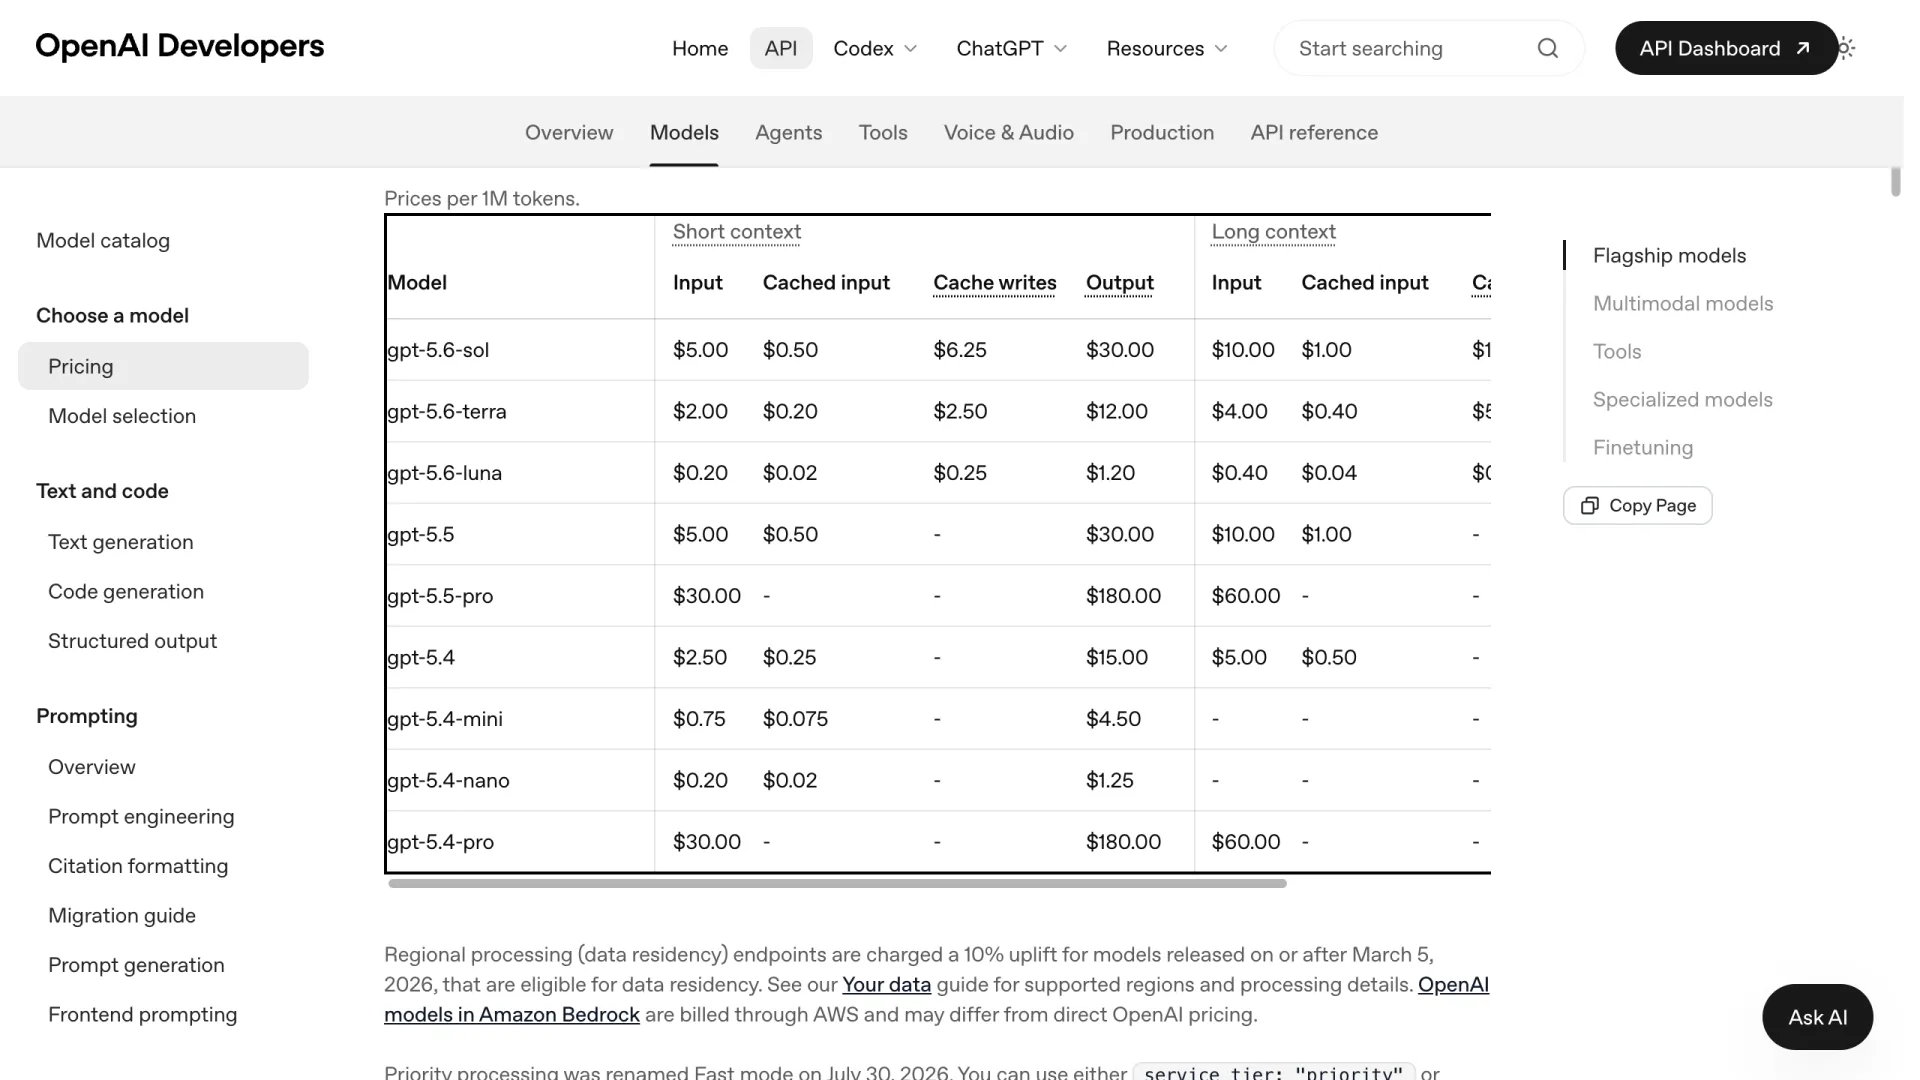
Il 30 luglio 2026 OpenAI ha ridotto di circa l'80% il prezzo API di GPT-5.6 Luna: dal listino di lancio di $1/$6 è passato a $0.20 in input / $1.20 in output per milione di token. Oggi Luna costa circa il 73% in meno di GPT-5.4 mini ($0.75/$4.50), ma nei nostri prompt di coding e ragionamento ha fornito risposte equivalenti a quelle di mini. C'è però un ambito in cui il piccolo modello precedente resta preferibile: la velocità. Mini ha risposto all'incirca il doppio più rapidamente, quindi è ancora la scelta giusta per i carichi di lavoro dove la latenza è il vincolo principale.
Il taglio del 30 luglio cambia completamente il confronto
GPT-5.6 Luna è diventato generalmente disponibile il 9 luglio 2026 a $1/$6 per milione di token. Era stato collocato come fascia conveniente della famiglia GPT-5.6, ma costava comunque sensibilmente più di gpt-5.4-mini ($0.75/$4.50), il modello economico di OpenAI. Circa tre settimane più tardi, il 30 luglio, OpenAI ha abbassato Luna di circa l'80%, a $0.20/$1.20, e GPT-5.6 Terra di circa il 20%, a $2/$12. Luna ora occupa la stessa fascia di prezzo di gpt-5.4-nano ($0.20/$1.25): prezzo da nano, cervello di generazione attuale.
Se avete visto Luna quotato a $1/$6, quel prezzo di lancio non è più in vigore dal 30 luglio 2026. Il prezzo attuale del tier Standard è $0.20/$1.20, verificato il 31 luglio 2026.
Prezzi di listino: Luna contro mini
Ai prezzi attuali del tier Standard, Luna costa meno di mini sia in input sia in output, e il vantaggio resta valido con prompt brevi o lunghi. Inoltre, Luna offre una finestra di contesto da 1,050K token, contro i 400K di mini.
| Modello (Standard, per 1M token) | Input | Input in cache | Output | Contesto |
|---|---|---|---|---|
| gpt-5.6-luna (contesto breve) | $0.20 | $0.02 | $1.20 | 1,050K |
| gpt-5.6-luna (contesto lungo, >200K) | $0.40 | $0.04 | $1.80 | 1,050K |
| gpt-5.4-mini | $0.75 | $0.075 | $4.50 | 400K |
Fonte: developers.openai.com/api/docs/pricing, verificata il 2026-07-31. Per riferimento, gpt-5.4-nano è a listino a $0.20/$1.25: la fascia di prezzo che Luna ora condivide.
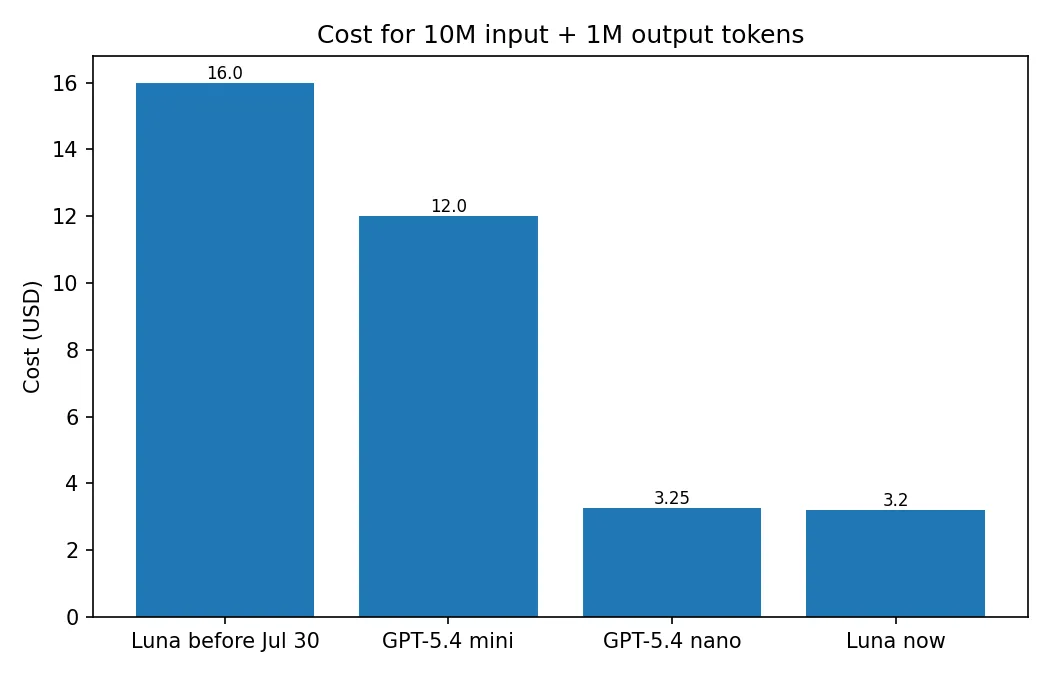
Facendo i conti su un carico moderato di 10M token in input più 1M in output, Luna costa $3.20, contro i $12.00 di mini; nano costa $3.25. Con 1M più 1M, il costo è $1.40 contro $5.25. Oltre 200K token in input, Luna raddoppia le tariffe, a $0.40/$1.80 per il contesto lungo, ma resta comunque sotto il prezzo fisso di mini, $0.75/$4.50. Mini non prevede affatto un tier per il contesto lungo: la sua finestra da 400K usa un'unica fascia di prezzo per contesto breve. Per un'analisi più approfondita dei prezzi dell'intera famiglia, consultate la guida ai prezzi di GPT-5.6.
Stessi prompt, due modelli: qualità, token e velocità
Abbiamo inviato prompt identici a entrambi i modelli tramite lo stesso endpoint API: un esercizio di coding, che chiedeva la lunghezza della sottostringa più lunga di parentesi valide, e un problema di ragionamento, quello della lumaca nel pozzo, eseguito tre volte. Entrambi hanno risolto correttamente tutte le richieste: per le parentesi hanno prodotto lo stesso algoritmo basato su stack, mentre per la lumaca hanno risposto "28 days" in ciascuna delle tre esecuzioni. La differenza non è stata nella correttezza, ma nella velocità e nella prolissità.
Qualità e correttezza delle risposte
Sul prompt di coding, Luna e mini hanno restituito soluzioni O(n) funzionalmente identiche, basate su stack e con indice base sentinella; nessuno dei due ha commesso errori. Nel problema di ragionamento, entrambi sono arrivati alla risposta corretta di 28 giorni e hanno rilevato correttamente che la lumaca esce il giorno 28 prima di poter scivolare indietro. Su questi due compiti semplici i modelli sono sostanzialmente alla pari; non abbiamo sottoposto il ragionamento a test più impegnativi.
Velocità e latenza
Mini è stato circa due volte più rapido end-to-end. Nelle tre esecuzioni del problema di ragionamento ha registrato una media di ~2.8s, contro ~5.5s di Luna; nell'unica esecuzione di coding, mini ha impiegato 4.0s contro 4.6s di Luna. Il tempo aggiuntivo di Luna segue la sua risposta più verbosa: 168 token contro i 76 di mini nel compito di ragionamento. Privilegia una risposta completa rispetto all'immediatezza.
"It's basically as fast as 5.4 mini if you use medium thinking and reasons really well, like above 5.4 level." — r/codex, discussione "GPT-5.6 Luna is really underrated"
Con le impostazioni predefinite, mini è il modello più veloce.
Costo per singolo task
La maggiore verbosità di Luna è più che compensata dal suo prezzo unitario inferiore. Sul prompt di ragionamento, Luna ha generato in media 168 token in output contro i 76 di mini, eppure ai prezzi attuali quella risposta è costata circa $0.001 con Luna contro $0.004 con mini. Si tratta di cifre inferiori a un centesimo, ricavate da un campione a una sola cifra di test (eseguiti il 2026-07-31 tramite AIReiter API su gpt-5.6-luna e gpt-5.4-mini, effort predefinito, endpoint USA; i tempi sono wall-clock dell'intera risposta, i token sono i completion token riportati dall'API), quindi vanno letti come indicativi e non come benchmark. La direzione, però, è chiara: a parità di risposta corretta, Luna costa meno.
Il dibattito su quale sia più intelligente nasce soprattutto da impostazioni diverse
Nei punteggi delle scorecard, Luna supera mini sia nel coding sia nel ragionamento: SWE-Bench Pro 62.7 contro 54.4, GPQA Diamond 92.3 contro 88.0, Toolathlon 53.4 contro 42.9; i dati provengono dalle model scorecard di OpenAI. Il risultato più citato che ribalta il verdetto arriva dall'Intelligence Index di Artificial Analysis, dove GPT-5.4 ottiene 51 contro il 46 di Luna. Ma quell'indice confronta Luna eseguito con effort high e GPT-5.4 con effort xhigh. I budget di ragionamento sono diversi: non è un confronto alla pari.
| Benchmark | GPT-5.6 Luna | GPT-5.4 mini | Nota |
|---|---|---|---|
| SWE-Bench Pro | 62.7 | 54.4 | Luna superiore |
| GPQA Diamond | 92.3 | 88.0 | Luna superiore |
| MMMU Pro | 78.4 | 76.6 | Vicini |
| Toolathlon | 53.4 | 42.9 | Luna superiore |
| Terminal-Bench | 84.7 (v2.1) | 60.0 (v2.0) | Versioni diverse |
| OSWorld | 45.6 (v2.0) | 72.1 (Verified) | Protocolli diversi |
Punteggi raccolti dalle model scorecard pubblicate da OpenAI e verificati incrociando i dati con docsbot.ai.
Ci sono due avvertenze importanti nella lettura di questi dati. La prima riguarda il tier di effort: mini espone un controllo dettagliato None / Low / Medium / High / XHigh, mentre Luna usa per impostazione predefinita un tier di ragionamento alto. Portare mini a xhigh e confrontarlo con Luna alle impostazioni predefinite gonfia quindi il valore di mini. La seconda è che le righe non sono perfettamente comparabili. docsbot.ai segnala che i dati di Terminal-Bench e OSWorld mescolano versioni e protocolli dei benchmark: è così che il 72.1 di mini su OSWorld può sembrare superiore al 45.6 di Luna, pur misurando qualcosa di leggermente diverso.
Al di là dei punteggi, Luna ha un cutoff della conoscenza a febbraio 2026, contro agosto 2025 per mini, e una finestra di contesto da 1.05M token contro 400K.
Il thread secondo cui Luna costa il 96% in più è ormai superato
Un test molto condiviso nella community di OpenAI aveva rilevato che Luna costava il 96% in più di mini per una conversazione di sei turni. Il dato è reale, ma precedente al taglio dei prezzi: è stato misurato l'11 luglio, quando Luna costava ancora $1/$6 al lancio. Inoltre, la maggior parte del divario derivava da un bug di invalidazione della cache nell'app di test, non dal modello. Quando l'autore ha smesso di modificare le istruzioni di primo livello a ogni turno, il sovrapprezzo di Luna è sceso al 16.7%; Luna è risultata anche il 9.9% più veloce e ha ricevuto un punteggio di qualità più alto in una valutazione alla cieca, 4.80 contro 4.28.
Al prezzo attuale di $0.20/$1.20, Luna costa meno di mini prima ancora di considerare la cache, quindi questo argomento non cambia più la scelta tra Luna e mini. Il meccanismo resta comunque utile per ottimizzare i costi: OpenAI fattura le scritture in cache a 1.25× la tariffa input, oggi $0.25/M per Luna, e le letture in cache con uno sconto del 90%, con una durata minima della cache di 30 minuti. Se l'app riscrive il system prompt a ogni turno, il prefisso in cache viene invalidato e si paga la tariffa di scrittura anziché quella di lettura. È questo il problema che ha prodotto il dato del 96%.
Quale modello scegliere
Per la maggior parte dei carichi di lavoro, la risposta ora è Luna: costa meno in entrambe le fasce di contesto, eguaglia o supera mini in qualità, ha un cutoff della conoscenza più recente e una finestra 2.6× più ampia. Scegliete mini quando la latenza è un vincolo rigido oppure quando serve il controllo dell'effort, che Luna non espone.
| Se vi serve… | Scegliete | Motivo |
|---|---|---|
| Il costo più basso per risposta corretta | Luna | $0.20/$1.20, circa il 73% sotto mini |
| La latenza più bassa | mini | ~2× più veloce end-to-end (~2.8s contro ~5.5s nel ragionamento) |
| Controllo dettagliato dell'effort None/XHigh | mini | Luna offre solo il tier high |
| Prompt oltre 400K token | Luna | Finestra da 1.05M; mini si ferma a 400K |
| L'output più sintetico | mini | Ha generato circa metà dei token a parità di task |
Una strategia di routing pratica: mini come scelta predefinita dove il vantaggio di latenza conta, Luna per escalation e contesti lunghi dove contano qualità e dimensione della finestra. Entrambi sono richiamabili tramite un'API unificata come gpt-5.6-luna e gpt-5.4-mini, per esempio sull'endpoint AIReiter GPT-5.6 Luna. Attenzione a un dettaglio nel routing: il flagship Sol costa $5/$30, circa 25× Luna. Se il vostro endpoint associa un ID generico gpt-5.6 a Sol, specificate l'ID completo gpt-5.6-luna.
FAQ
GPT-5.6 Luna costa meno di GPT-5.4 mini?
Sì, circa il 73% in meno ai prezzi attuali. Dopo il taglio del 30 luglio 2026, Luna costa $0.20 in input / $1.20 in output per milione di token, contro i $0.75 / $4.50 di mini, sia in input sia in output.
GPT-5.6 Luna è più veloce o più lento di 5.4 mini?
Più lento, di circa 2× nel nostro test con gli stessi prompt: mini ha registrato una media di ~2.8s contro ~5.5s per Luna sul ragionamento. Luna scambia velocità con un ragionamento più completo; abbassando il suo effort il divario si riduce.
GPT-5.6 Luna sostituisce il tier mini?
No. Luna è il tier conveniente della generazione GPT-5.6; gpt-5.4-mini è un modello piccolo separato e precedente, tuttora venduto e supportato.
GPT-5.4 nano vs Luna: quale costa meno?
Di fatto sono alla pari. Luna costa $0.20/$1.20 contro i $0.20/$1.25 di nano. Luna è marginalmente più economico in output e appartiene a una generazione più recente, con un cutoff della conoscenza successivo.
Quando sono usciti Luna e mini?
Luna è stato lanciato il 9 luglio 2026 e il suo prezzo è stato ridotto a quello attuale il 30 luglio 2026. GPT-5.4 mini è stato lanciato il 17 marzo 2026.
Fonti
- Prezzi attuali, verificati il 2026-07-31: developers.openai.com/api/docs/pricing
- Lancio di GPT-5.6, tier della famiglia e policy sulle scritture in cache: openai.com/index/gpt-5-6/
- Test controllato dei costi multi-turno, precedente al taglio: community.openai.com
- Aggregati su benchmark e capacità: artificialanalysis.ai, docsbot.ai