 AIREITER
Nei nostri test API, GPT-5.6 Luna e DeepSeek V4 Pro hanno risolto tutti e tre i prompt identici. La capacità pura, quindi, difficilmente sarà il fattore decisivo: contano di più struttura dei prezzi e latenza. C'è inoltre un elemento da non trascurare: la pagina prezzi di DeepSeek avverte ufficialmente di un prossimo aumento significativo. Ecco cosa abbiamo misurato il 10 agosto 2026 e come orientare la scelta.
Test API con gli stessi prompt: risultati e tempi
Il 10 agosto 2026 abbiamo sottoposto tre compiti identici a GPT-5.6 Luna e DeepSeek V4 Pro, usando la medesima pipeline API e le impostazioni predefinite di ciascun modello: la correzione di un bug Python con istruzioni volutamente sintetiche ("reply with the corrected function only"), un problema di pianificazione dei camion su tre baie con un'unica risposta corretta (10:10) e un'estrazione JSON rigorosa con un campo nullable. Entrambi hanno risolto correttamente tutti e tre i casi.
| Attività | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Correzione bug Python merge_intervals | Corretta (correzione max()), 10.7s | Corretta (correzione max()), 16.1s |
| Ragionamento sulla pianificazione delle baie | Corretto (10:10), 8.0s | Corretto (10:10), 27.2s |
| Estrazione JSON rigorosa | Valido, conforme esattamente allo schema, 3.0s | Valido, conforme esattamente allo schema, 7.6s |
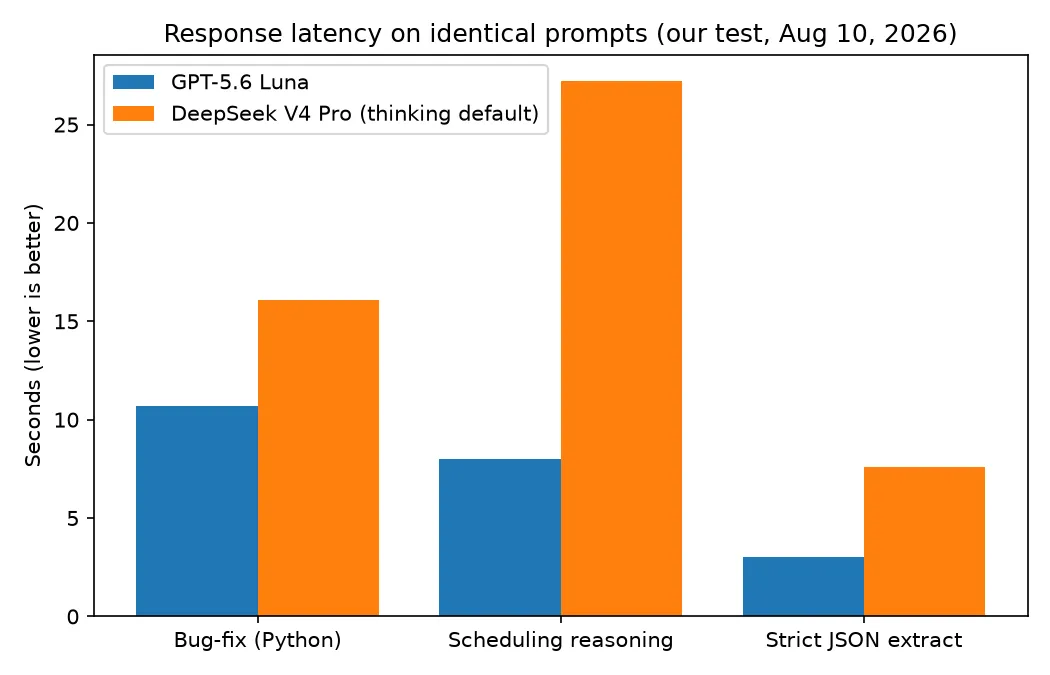
Servono però due precisazioni, oltre a due dettagli pratici. Si tratta di una verifica puntuale su tre attività, non di un benchmark. V4 Pro usa per impostazione predefinita la modalità thinking, che spiega gran parte del divario di latenza di 2–3x osservato qui; può essere disattivata per singola richiesta, rinunciando però a qualcosa nel ragionamento più complesso. Quanto al rispetto delle istruzioni, Luna ha restituito soltanto la funzione come richiesto, mentre V4 Pro l'ha inclusa in un blocco di codice Markdown. In chat è irrilevante; in una pipeline aggiunge un passaggio di parsing. Abbiamo ripetuto una volta il test di pianificazione per verificarne la stabilità: entrambi hanno risposto di nuovo 10:10.
Prezzi ufficiali verificati e l'aumento annunciato da DeepSeek
Abbiamo verificato i listini sulle pagine ufficiali dei due fornitori il 10 agosto 2026: GPT-5.6 Luna costa $0.20 per milione di token in input, $0.02 per token in cache e $1.20 in output (pagina del modello OpenAI); DeepSeek V4 Pro costa $0.435 per milione di token in input in caso di cache miss, $0.003625 con cache hit e $0.87 in output (pagina prezzi DeepSeek).
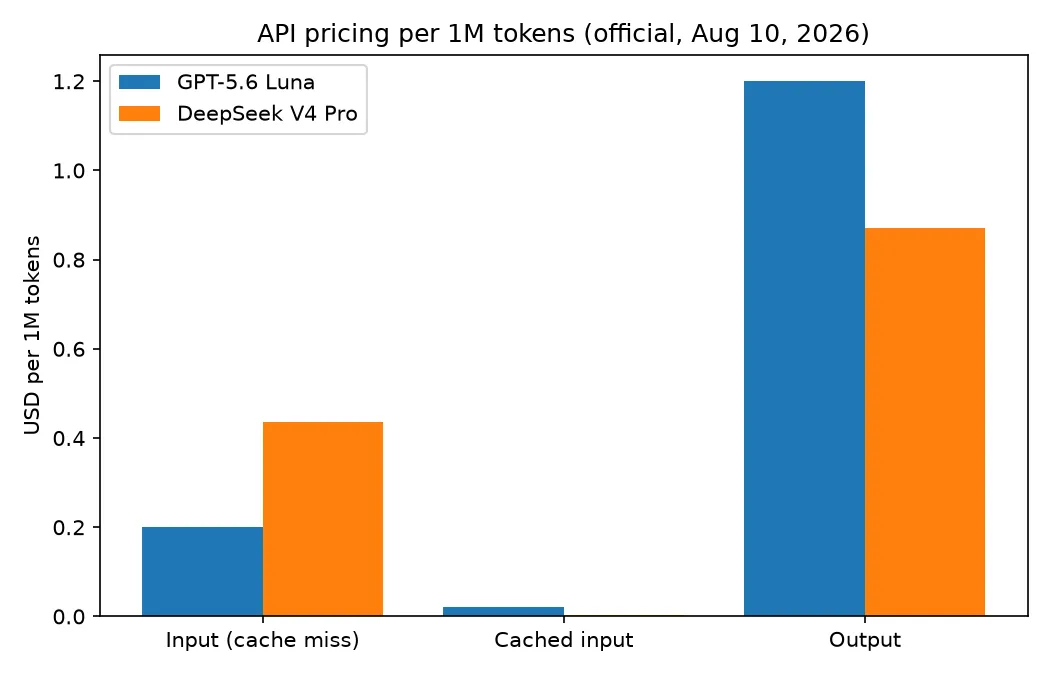
Nessuno dei due, dunque, è semplicemente "più economico" in ogni scenario: l'input non in cache di Luna costa il 54% in meno; l'output di V4 Pro il 27% in meno; i cache hit di V4 Pro costano 5.5x meno di quelli di Luna. Il risultato dipende dalla composizione dei token:
- Chat interattiva (1K input + 500 output per chiamata): Luna $0.0008 contro V4 Pro $0.00087, di fatto un pareggio.
- Revisione di repository (50K di input nuovo + 3K di output): Luna $0.0136 contro V4 Pro $0.0244, con Luna più economico del 44%.
- Ciclo agentico (200K in cache + 20K di input nuovo + 10K di output per iterazione): Luna $0.020 contro V4 Pro $0.018. Qui V4 Pro passa in vantaggio, e il divario cresce a ogni ulteriore iterazione in cache.
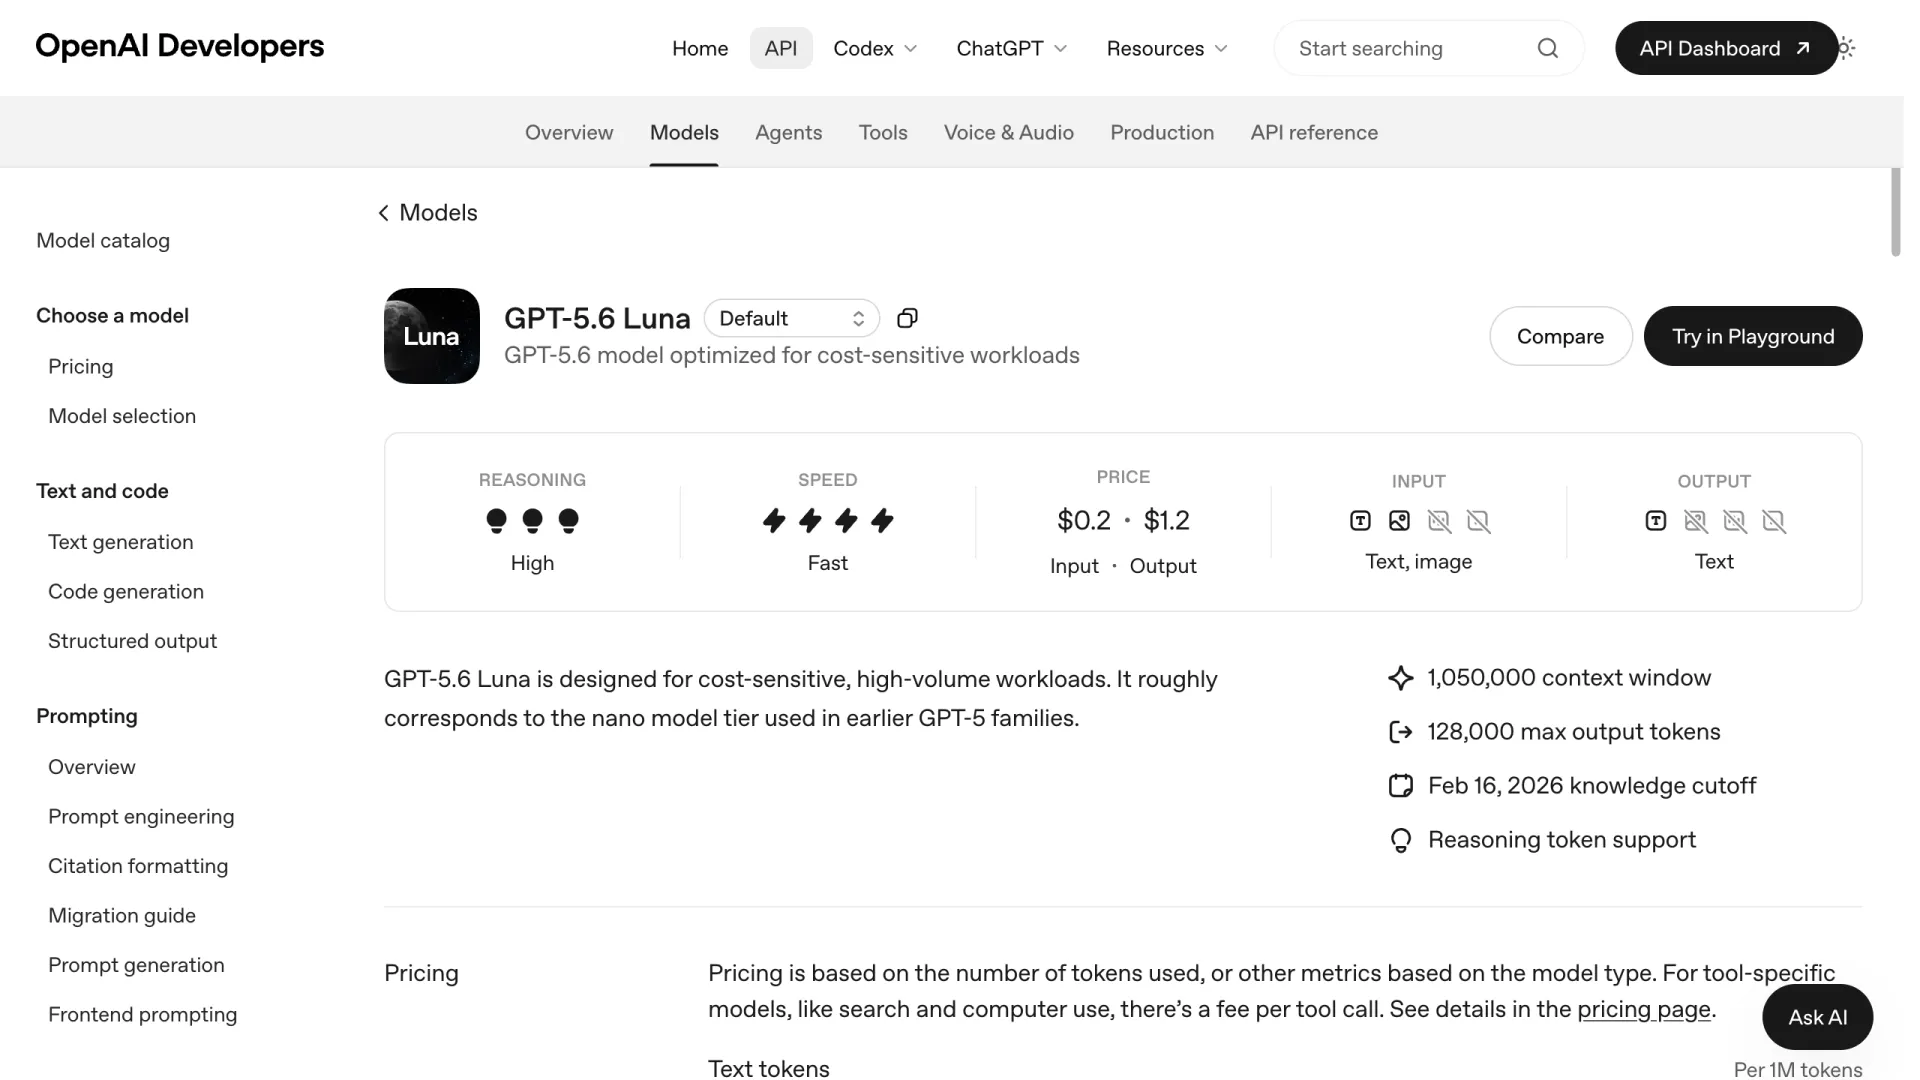
C'è un altro dato che limita la durata di questi calcoli. La nota 2 della pagina prezzi di DeepSeek afferma: "We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected." Non indica né una data né cifre precise. Ma se il vantaggio di V4 Pro nel vostro caso dipende dal prezzo, quell'argomento ha già una scadenza ufficialmente segnalata. I prezzi di Luna, invece, sono andati nella direzione opposta: il modello è arrivato insieme al taglio dei prezzi GPT-5.6 di OpenAI ad agosto.
Cache: il vantaggio concreto di V4 Pro
DeepSeek V4 Pro addebita $0.003625 per milione di token di input in cache, contro i $0.02 di Luna: uno scarto di 5.5x che domina i costi nei workload agentici, dove ogni iterazione rilegge un lungo prefisso invariato. Chi sviluppa agent lo ha notato:
DeepSeek v4 Pro & MiMo v2.5 Pro ... sono incredibilmente economici per il lavoro guidato da agent grazie ai prezzi bassissimi dell'input in cache ($0.0036/mtok). Per Luna, il prezzo dell'input in cache ... la pagina prezzi lo indica a $0.02/mtok, & costa 5x di più. — commentatore di Hacker News, nella discussione sul lancio di GPT-5.6
Va considerato anche il sovrapprezzo di Luna per la scrittura in cache: le cache write vengono fatturate a 1.25x la tariffa dell'input non in cache (pagina del modello OpenAI), mentre i prompt oltre 272K token di input vengono fatturati a 2x sull'input e 1.5x sull'output per l'intera richiesta. Se il contesto del vostro agent supera regolarmente 272K token, il prezzo effettivo di Luna raddoppia circa proprio nel punto in cui il caching di V4 Pro diventa più vantaggioso.
Prima di stimare i costi, controllate la documentazione ufficiale
Durante la ricerca per questo confronto abbiamo trovato cifre pubblicate da terze parti che per V4 Pro andavano da $0.435 a $1.74 per milione di token di input, oltre a finestre di contesto di Luna riportate tra 400K e 1.05M. Bastano meno di un minuto per tre controlli: leggete i prezzi soltanto nelle due pagine ufficiali linkate sopra, confermate la stringa della versione del modello (l'API attuale serve DeepSeek-V4-Pro; Flash è fissato a -0731) e verificate se un presunto "prezzo input" sia la tariffa cache hit o cache miss; per V4 Pro le due cifre differiscono di 120x.
Specifiche che incidono davvero sulla scelta
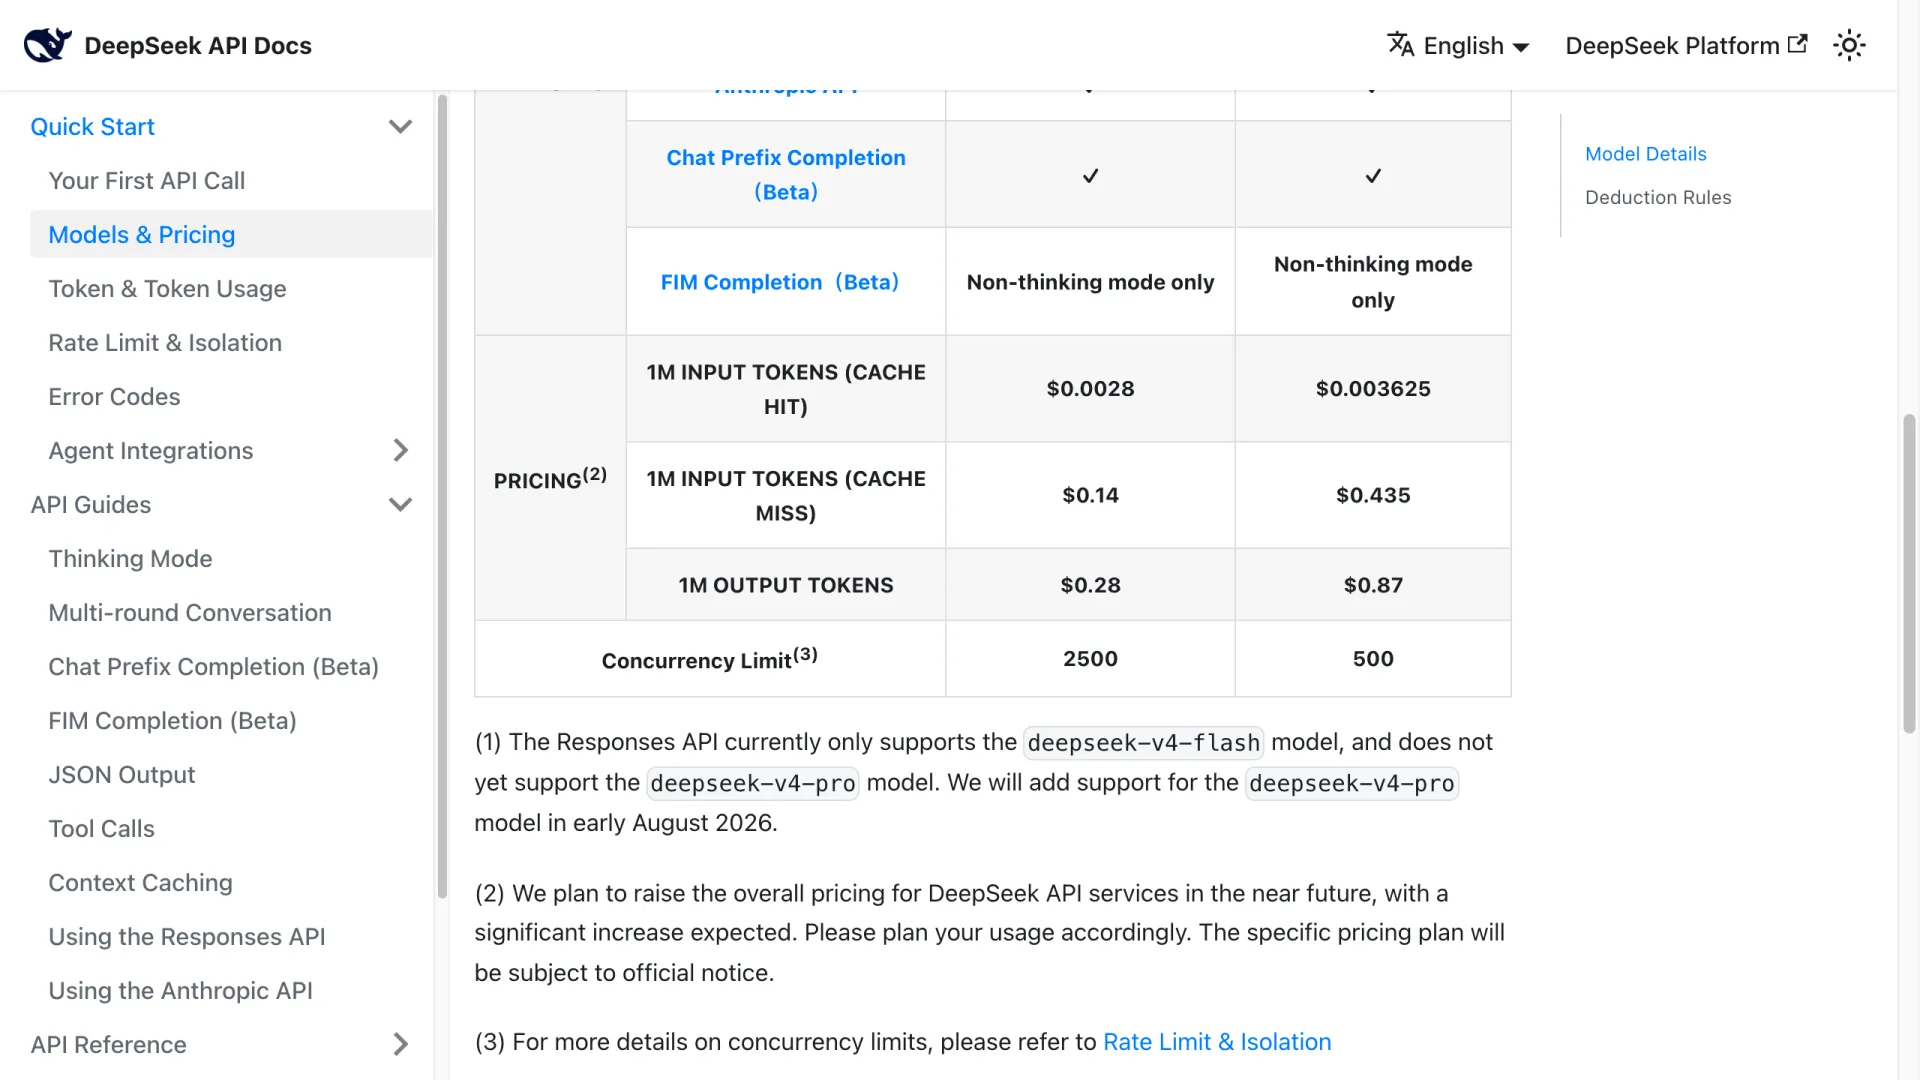
Oltre al prezzo, sono quattro le differenze tecniche che determinano l'adattamento al workload: limite di output, modalità supportate, apertura dei pesi e superficie API. Entrambi dichiarano una finestra di contesto attorno a 1M token (Luna: 1,050,000 token; V4 Pro: 1M), quindi il solo contesto non basta a separarli.
| Specifica (verificata il 10 ago 2026) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Finestra di contesto | 1,050,000 | 1M |
| Token massimi in output | 128K | 384K |
| Modalità di input | Testo + immagini | Solo testo |
| Controllo del ragionamento | Livelli di effort (low→max) | Thinking attivo (predefinito) / disattivo |
| Pesi aperti | No | Sì (self-hostable) |
| Responses API | Sì | Non ancora (ufficiale: inizio agosto 2026) |
| Limite di concorrenza | In base al livello di utilizzo | 500 |
| Knowledge cutoff | 16 feb 2026 | Non indicato nella pagina prezzi |
Il limite di 384K token in output di V4 Pro è 3x quello dei 128K di Luna. Fa la differenza nella generazione monolitica di una codebase, nelle traduzioni lunghe o nell'estrazione strutturata in massa, dove dividere il lavoro in chunk introduce ulteriori possibilità di errore. L'input visivo di Luna conta per una ragione diversa, e gli utenti DeepSeek lo citano spontaneamente:
La mia unica vera lamentela è che non gestiscono le immagini, e questo limita la loro capacità di fare debugging autonomo su alcuni tipi di problemi. — commentatore di Hacker News, sull'uso di DeepSeek per progetti personali
I pesi aperti spostano l'ago della bilancia dall'altra parte: V4 Pro è scaricabile e utilizzabile in self-hosting, perciò è l'unica opzione tra queste due per requisiti di data residency. Con una riserva importante: servire un modello di queste dimensioni richiede hardware multi-GPU serio, non è un progetto da weekend.
I benchmark dipendono più dall'effort mode che dal modello
I punteggi pubblicati per GPT-5.6 Luna e DeepSeek V4 Pro possono ribaltare il vincitore in base alla modalità di effort con cui sono stati testati. Gli stessi due modelli segnano 33.3 contro 44.3, con vittoria di V4 Pro, su un tracker che esegue Luna a effort low e V4 Pro a max; su Artificial Analysis, che li esegue entrambi a max, il risultato è 52 contro 45, con Luna davanti. Nessuno dei due dati è errato: misurano configurazioni differenti.
Lo stesso problema si ritrova nei numeri sulla latenza. Artificial Analysis riporta 132 secondi come tempo di Luna per il primo token della risposta a effort max: a quel livello, Luna ragiona per circa due minuti prima di iniziare a rispondere. Nel nostro test con le impostazioni predefinite, Luna ha risposto in 3–10.7 secondi. Entrambi i valori sono reali, ma soltanto uno assomiglia alla vostra configurazione di produzione. Una volta avviata la generazione, il throughput favorisce nettamente Luna: 202 token/s contro 78 (Artificial Analysis).
Le modalità di effort influenzano enormemente anche i punteggi di un singolo modello: V4 Pro ottiene 90.1% su GPQA Diamond con thinking max, ma 72.9% con thinking disattivato. Nei benchmark condivisi a effort max, Luna guida SWE-Bench Pro 62.7% a 55.4%, mentre i due modelli pareggiano su BrowseComp (83.3 contro 83.4). Prima di fidarsi di una scorecard, ponetevi tre domande: quale modalità di effort è stata usata, la latenza include il tempo di thinking e le versioni del benchmark sono identiche? Il divario 84.7 contro 67.9 su Terminal-Bench riportato da un tracker, per esempio, confronta v2.1 con v2.0.
Quale modello scegliere?
Scegliete GPT-5.6 Luna per i prodotti rivolti agli utenti: nel nostro test con impostazioni predefinite è stato 2–3x più veloce in tutte e tre le attività, l'input non in cache costa la metà di V4 Pro e accetta immagini. Scegliete DeepSeek V4 Pro per cicli agentici ad alta intensità di cache, output oltre 128K token o carichi che devono girare sul vostro hardware, includendo però l'avviso ufficiale di aumento dei prezzi in ogni impegno di lungo periodo. Su GPT-5.6 Luna e DeepSeek V4 Pro basta cambiare endpoint, quindi potete ripetere i nostri tre prompt sul vostro workload prima di decidere.
| Il vostro workload | Scegliete | Dato decisivo |
|---|---|---|
| Chatbot, app rivolte agli utenti | Luna | Latenza di 3.0–10.7s contro 7.6–27.2s nel nostro test; 202 contro 78 tok/s |
| Elaborazione ad alto volume di input nuovo | Luna | $0.20 contro $0.435 per 1M di input non in cache |
| Cicli agentici su contesto stabile | V4 Pro | $0.003625 contro $0.02 per 1M di input in cache |
| Output lunghi in una singola generazione | V4 Pro | 384K contro 128K di output massimo |
| Visione (screenshot, PDF come immagini) | Luna | V4 Pro supporta solo testo |
| Self-hosting / data residency | V4 Pro | Pesi aperti; Luna è solo API |
| Certezza del budget fino al 2027 | Luna | Avviso ufficiale DeepSeek sull'aumento dei prezzi |
FAQ
Quale costa meno tra GPT-5.6 Luna e DeepSeek V4 Pro?
Nessuno dei due in assoluto. L'input non in cache di Luna costa il 54% in meno ($0.20 contro $0.435 per 1M token); l'input in cache di V4 Pro costa 5.5x meno ($0.003625 contro $0.02) e il suo output il 27% in meno ($0.87 contro $1.20). Gli agent che sfruttano molto la cache costano meno con V4 Pro; i workload con input nuovo costano meno con Luna.
Entrambi supportano una finestra di contesto da 1M token?
Sì: Luna offre 1,050,000 token, V4 Pro 1M. Tenete presente che le richieste Luna oltre 272K token di input vengono fatturate a 2x sull'input e 1.5x sull'output per l'intera richiesta.
DeepSeek V4 Pro è open source e posso usarlo in self-hosting?
Sì. V4 Pro viene distribuito con pesi aperti e può essere usato in self-hosting, a differenza di Luna che è disponibile solo via API; pianificate però hardware di serving multi-GPU, non una singola workstation.
GPT-5.6 Luna supporta l'input di immagini?
Sì, Luna accetta input testuali e immagini. DeepSeek V4 Pro supporta solo testo. I suoi stessi utenti indicano l'assenza della visione come principale limite nei workflow di debugging autonomo.
Qual è l'output massimo per ciascun modello?
DeepSeek V4 Pro può generare fino a 384K token per risposta; GPT-5.6 Luna si ferma a 128K. Per generare in un unico passaggio documenti lunghi o grandi file di codice, il limite di V4 Pro è 3x più alto.
Approfondimenti correlati
- DeepSeek V4 Pro vs GPT-5.6 Sol: lo stesso modello di punta DeepSeek contro la fascia media di OpenAI
- Recensione di GPT-5.6 Luna: Luna valutato autonomamente, oltre questo confronto
- DeepSeek V4 Flash vs V4 Pro: se il rischio sui prezzi di V4 Pro vi spinge verso una fascia inferiore