 AIREITER
Il prezzo di $0.15 per l'input è solo il punto di partenza per GLM-5.3-Flash. Cache hit, token in output, ragionamento obbligatorio e un checkpoint di circa 320B parametri stabiliscono se, in un'implementazione reale, convenga l'API o la strada degli open weights.
I prezzi effettivamente in vigore
La pagina ufficiale dei prezzi di Z.AI indica per GLM-5.3-Flash $0.15 per 1 milione di token input, $0.03 per 1 milione di token input in cache e $0.50 per 1 milione di token output. È inoltre prevista una promozione temporanea del 50%, con scadenza alle 24:00 del 9 settembre 2026 nel fuso UTC+8, ossia l'ora di Singapore.
| Voce di addebito GLM-5.3-Flash | Prezzo di listino / 1M token | Promozione / 1M token |
|---|---|---|
| Nuovo input | $0.15 | $0.075 |
| Input in cache | $0.03 | $0.015 |
| Output | $0.50 | $0.25 |
| Archiviazione dell'input in cache | Gratuita per un periodo limitato | Gratuita per un periodo limitato |
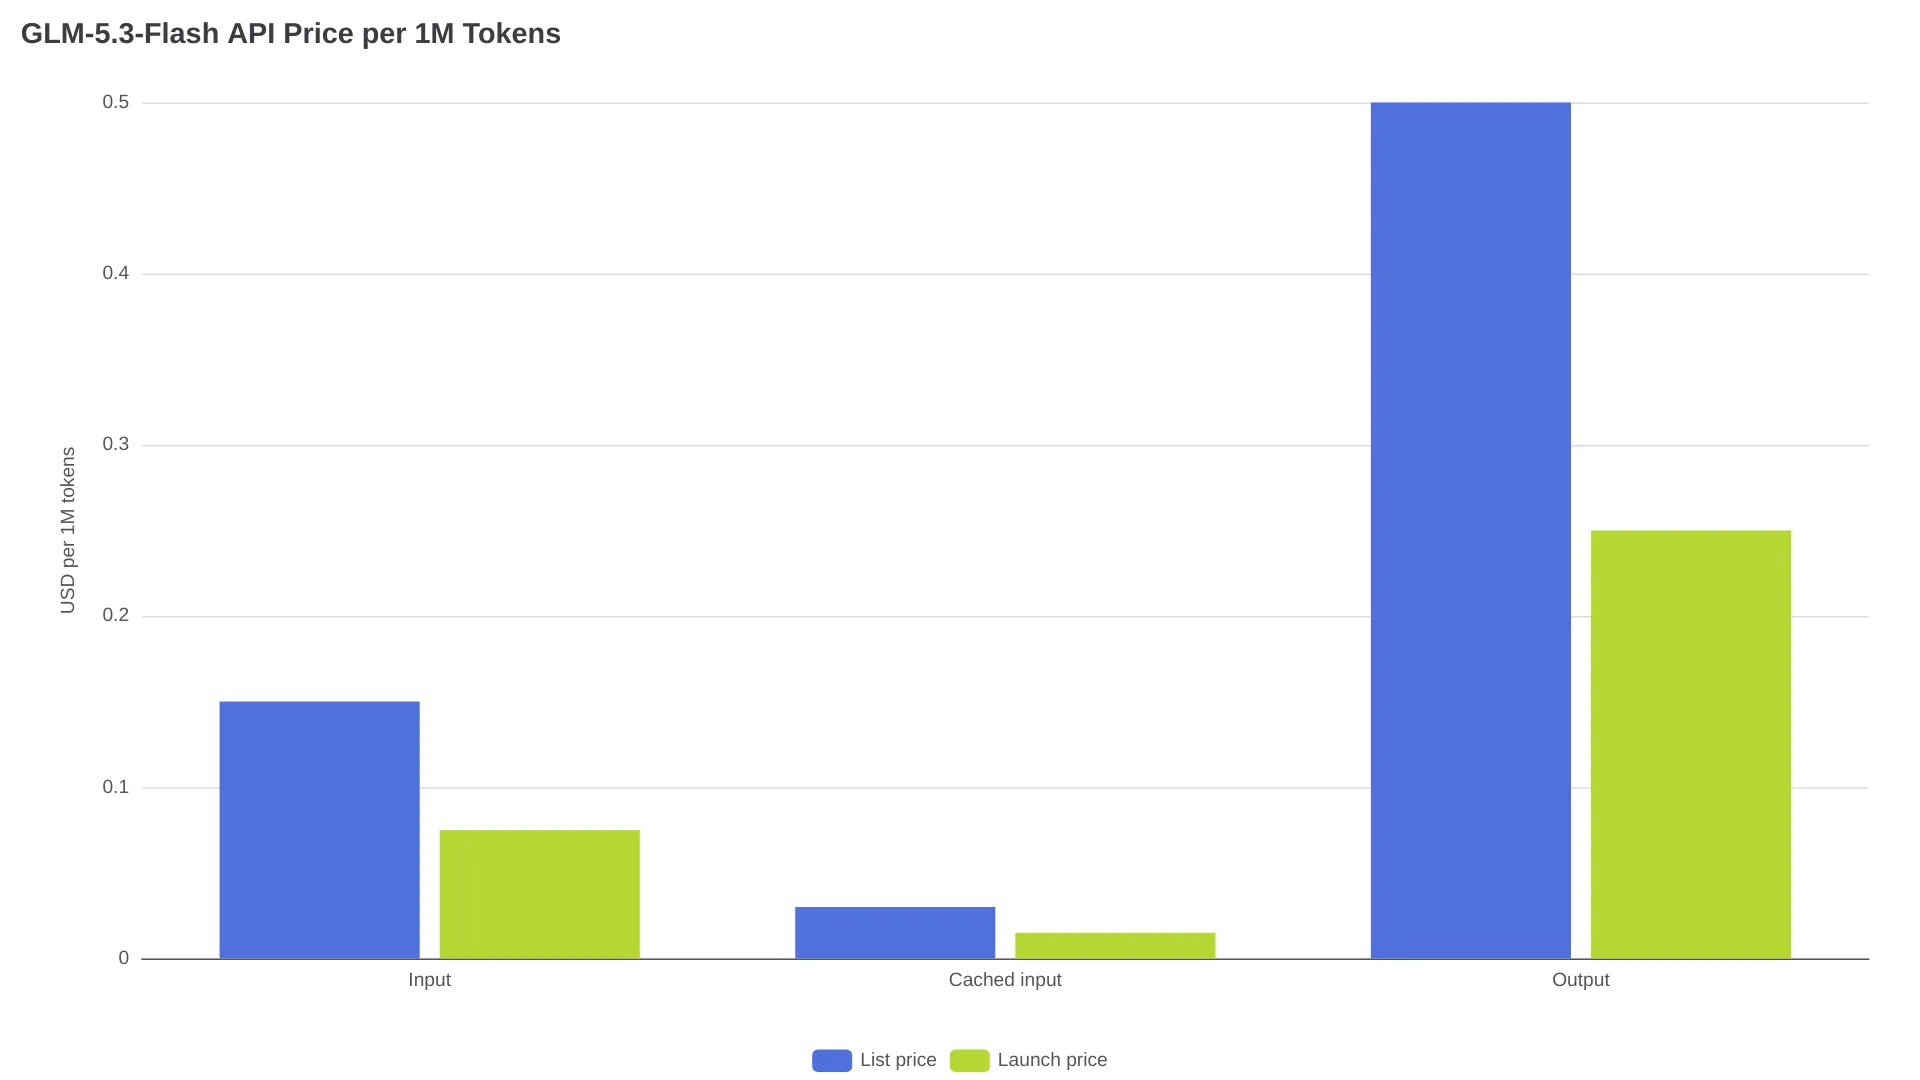
Lo sconto del 50% va considerato una promozione temporanea, non la base per un budget di produzione. Nell'annuncio di lancio, Z.AI identifica ox-alpha come precedente identità preview.
La stessa tabella ufficiale riporta per GLM-5.3 standard $1.40 per l'input, $0.26 per l'input in cache e $4.40 per l'output, sempre ogni 1 milione di token. Ai prezzi di listino, Flash costa circa l'89% in meno sia per input sia per output. È un confronto di prezzo, non un'affermazione di equivalenza tra i due modelli in qualità, latenza o comportamento operativo.
API, non un piccolo modello da eseguire in locale
GLM-5.3-Flash è un modello multimodale open-weight con licenza MIT, dotato di 320B parametri totali e 18B parametri attivi per token. La model card ufficiale su Hugging Face documenta il checkpoint pubblico zai-org/GLM-5.3-Flash e le opzioni di serving locale; nei materiali di rilascio, Z.AI descrive una finestra di contesto da 1 milione di token e input testuali, immagini e video.
I 18B parametri “attivi” indicano il calcolo degli esperti selezionati, non la memoria totale richiesta. Pesi completi, KV cache, overhead del runtime, elaborazione multimodale e lunghezza del contesto continuano a determinare la fattibilità dell'esecuzione locale.
| Modalità di accesso | Cosa offre | Vincolo principale |
|---|---|---|
| API Z.AI | Inferenza gestita, fatturata in base a token input, input in cache e output | Limiti dell'account e latenza del ragionamento |
| Checkpoint ufficiale | Pesi con licenza MIT per self-hosting o adattamento | Infrastruttura ad alta memoria, in base a precisione e quantizzazione |
| Build quantizzata della community | File più piccoli per alcuni runtime locali | Qualità della build, supporto delle modalità, velocità e compatibilità variabili |
Prezzo basso per token e costo ridotto di hosting non sono la stessa cosa: con carichi intermittenti si paga l'API quando arriva il traffico, mentre il self-hosting richiede capacità di serving riservata anche nei periodi di inattività.
Come si calcola il costo nei carichi reali
Il costo di GLM-5.3-Flash dipende dalla combinazione tra nuovo input, input effettivamente riconosciuto come in cache e output generato:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
Ai prezzi di listino, 10 milioni di nuovi token input più 2 milioni di token output costano $2.50: $1.50 per l'input e $1.00 per l'output. Durante la promozione, lo stesso volume costa $1.25.
| Carico di lavoro | Calcolo a prezzo di listino | Totale di listino | Totale promozionale |
|---|---|---|---|
| 10M nuovo input + 2M output | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M nuovo input + 8M input in cache + 2M output | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K nuovo input + 10K output | $0.015 + $0.005 | $0.020 | $0.010 |
Il valore combinato di $0.10 per milione mostrato da Artificial Analysis si basa su una ripartizione definita 7:2:1 fra cache hit, input e output. È utile per confrontare carichi equivalenti, non rappresenta una tariffa universale di GLM-5.3-Flash.
Il risparmio della cache esiste solo in presenza di un cache hit effettivo. Lo schema di risposta Chat Completion di Z.AI espone usage.prompt_tokens_details.cached_tokens: nella contabilità di produzione conviene quindi registrare questo campo, anziché presumere che prompt apparentemente ripetuti ricevano lo sconto. Un utente di r/opencodeCLI ha riassunto così l'economia al lancio:
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, discussione su Reddit
La data di scadenza dello sconto è confermata dal listino Z.AI; il confronto e l'esperienza d'uso sono invece opinioni dell'autore del commento. Un contesto ripetuto e stabile può aumentare il riuso della cache, ma non elimina i costi di output, retry, tool o limiti dell'account.
Un foglio di calcolo essenziale per il budget
Nel forecast, separa quattro righe: nuovo input, input in cache, output e tool a pagamento. Z.AI indica Web Search a $0.01 per utilizzo, quindi le ricerche ripetute di un agente possono superare una stima basata sui soli token.
| Ipotesi di utilizzo mensile | Formula a prezzo di listino | Costo mensile |
|---|---|---|
| 100M nuovo input + 20M output | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M nuovo input + 80M input in cache + 20M output | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 chiamate Web Search | 100 × $0.01 | $1.00 |
Sono esempi aritmetici, non una quota di utilizzo. Aggiungi separatamente retry e run dell'agente abbandonate. Se il volume di output è alto, impostare un valore realistico di max_tokens e usare un reasoning_effort inferiore quando appropriato può incidere più dell'ottimizzazione di un piccolo prefisso del prompt.
Vincoli dell'API Z.AI da verificare prima della migrazione
L'API ufficiale di Z.AI usa https://api.z.ai/api/paas/v4/ come base URL generale e https://api.z.ai/api/paas/v4/chat/completions per le chat completion. L'autenticazione richiede una chiave API Bearer. Nella sua introduzione all'API, Z.AI documenta pattern client Python, Node.js e Java compatibili con OpenAI tramite una base URL personalizzata.
L'attuale riferimento Chat Completion cita GLM-5.3-FLASH nelle descrizioni relative a thinking e reasoning, ma l'enum dei modelli visualizzato non mostra glm-5.3-flash; la pagina dei prezzi e i materiali di lancio ufficiali riportano comunque lo SKU Flash. Prima di deviare il traffico di produzione, prova l'esatto model ID ospitato con una piccola richiesta.
| Dettaglio di integrazione | Vincolo verificato |
|---|---|
| Model ID ospitato da testare | glm-5.3-flash; conferma che sia accettato dallo schema dell'account attivo |
| Endpoint ospitato | https://api.z.ai/api/paas/v4/chat/completions |
| Autenticazione | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH utilizza thinking abilitato; la profondità è controllata tramite reasoning_effort |
| Reasoning effort | low, high o max |
Massimo max_tokens | 131,072 nell'attuale riferimento dei parametri |
| Coding Plan | Chiave, endpoint e sistema di crediti separati; non è un saldo API generico. Vedi la guida rapida al Coding Plan di Z.AI |
Z.AI imposta max come livello predefinito di reasoning effort. La tariffa per token non cambia in base al livello scelto, ma il ragionamento può modificare il consumo di output e il tempo di attesa. Per i limiti dell'account, Z.AI rimanda a una dashboard dei rate limit specifica per l'account; la documentazione pubblica non fornisce un unico tetto numerico valido per ogni account API.
Open weights o API gestita: cosa cambia nel deployment
La model card ufficiale include ricette di serving locale per Transformers, vLLM, SGLang, TokenSpeed e KTransformers, ma queste procedure non dimostrano che il deployment sia pratico su una GPU consumer.
L'API gestita è la scelta più adatta per traffico intermittente o quando non è disponibile hardware per l'inferenza ad alta memoria. Valuta il serving distribuito o locale se l'utilizzo è costante, oppure se il controllo sulla gestione dei dati giustifica il costo operativo. Una build testuale a precisione ridotta potrebbe non riprodurre la configurazione multimodale ufficiale.
Quando il self-hosting può convenire
Una stima di GetDeploying colloca un deployment a 4 bit intorno a 192 GB di memoria GPU, a circa 384 GB per 8 bit e a 768 GB per BF16. Secondo la stima, una configurazione MI300X da $2.90 l'ora costa approssimativamente $2,088 al mese se mantenuta attiva senza interruzioni, con una parità fra API e self-hosting intorno a 14 milioni di token l'ora usando un rapporto input-output di 5:1.
Si tratta di stime di terze parti, non di garanzie hardware di Z.AI. La configurazione a 4 bit da 192 GB è classificata come al limite; KV cache, overhead del runtime, elaborazione multimodale, batching e tempi di inattività possono spostare il punto di pareggio. Prima di scegliere l'inferenza locale, confronta costo orario dell'infrastruttura, utilizzo, token effettivi l'ora, tasso di cache hit e costo per task completato.
GLM-5.3-Flash e GLM-5.3: dove passa la scelta
Flash e GLM-5.3 standard hanno listini e posizionamenti di deployment differenti.
| Domanda | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Prezzo di listino input | $0.15 / 1M | $1.40 / 1M |
| Input in cache di listino | $0.03 / 1M | $0.26 / 1M |
| Prezzo di listino output | $0.50 / 1M | $4.40 / 1M |
| Promozione temporanea | 50% di sconto fino al 9 settembre 2026 UTC+8 | Non è indicata una promozione equivalente a quella Flash |
| Checkpoint open-weight | È elencato un checkpoint MIT ufficiale | Listing del modello separato; non dedurre che i pesi siano identici |
| Posizionamento multimodale | Multimodale nativo; Z.AI descrive input di immagini e video | Valuta separatamente la copertura di GLM-5.3 standard |
| Deployment locale | Richiede un checkpoint grande e serving ad alta memoria | Usa la documentazione specifica del modello e del suo deployment |
Scegli prima Flash quando contano il costo per token, gli input multimodali o una strada open-weight e l'applicazione può tollerare il ragionamento obbligatorio e i vincoli del provider. Scegli GLM-5.3 standard solo dopo aver misurato se la tariffa più elevata porta una differenza di capacità o affidabilità rilevante per l'applicazione.
FAQ
Qual è il prezzo attuale dell'API GLM-5.3-Flash?
Le tariffe ufficiali di listino sono $0.15 per l'input, $0.03 per l'input in cache e $0.50 per l'output ogni 1M token; la tabella precedente mostra i prezzi temporanei scontati del 50%.
L'input in cache viene fatturato a $0.03?
Sì, quando Z.AI riconosce i token come memorizzati nella cache. L'archiviazione dell'input in cache è indicata separatamente come gratuita per un periodo limitato: stato dell'archiviazione e fatturazione dei cache hit non vanno quindi confusi.
GLM-5.3-Flash è open source?
La definizione precisa è checkpoint open-weight con licenza MIT. La licenza consente un uso ampio, ma il modello da 320B parametri totali richiede comunque molta memoria, software compatibile e capacità di serving.
Posso eseguire GLM-5.3-Flash su un normale laptop?
Non come deployment pratico a piena precisione. Anche le stime di terze parti a 4 bit parlano di circa 192 GB di memoria GPU, e i 18B parametri attivi non eliminano il costo di storage e runtime dell'intero checkpoint.
GLM-5.3-Flash è più veloce di GLM-5.3?
“Flash” è supportato come posizionamento in termini di costo e calcolo attivo, non come garanzia universale sulla latenza. Artificial Analysis riporta 48.7 token output al secondo tramite Z.AI e 42.57 secondi fino al primo token di risposta nella propria configurazione misurata; il tempo di ragionamento e la forma del carico possono dominare il tempo di risposta percepito.
Il Coding Plan offre lo stesso saldo dell'API?
No. La guida rapida al Coding Plan di Z.AI documenta una chiave Coding Plan separata, endpoint distinti e accesso limitato a tool e prodotti ufficialmente supportati. Un abbonamento Coding Plan non va convertito direttamente in un budget API pubblico espresso in dollari per token.
L'API è la soluzione meno rischiosa quando il traffico è intermittente e l'hardware non è già stato pagato; il serving locale è una scelta economica diversa, dipendente da utilizzo costante, memoria e requisiti di controllo sui dati.