 AIREITER
Con Gemini 3.7 Flash, rilasciato da Google il 13 agosto 2026, la fascia Flash alza l'asticella per agenti di coding e flussi con più chiamate agli strumenti. Il dato più rilevante è il 65.3% su DeepSWE v1.1, contro il 49.0% di 3.6 Flash, con un listino introduttivo di $0.75/M token in input e $3.75/M in output: esattamente la metà delle tariffe standard di 3.6 Flash. C'è però un aspetto da pianificare: secondo le segnalazioni, da gennaio 2027 il prezzo salirà a $1.50/$7.50. Restano quindi circa quattro mesi per valutarlo alla tariffa ridotta.
Prezzi API: tariffa iniziale di $0.75/$3.75 fino a dicembre 2026
Gemini 3.7 Flash debutta a $0.75 per milione di token in input e $3.75 per milione di token in output, secondo l'annuncio di lancio di Google DeepMind, confermato da segnalazioni della community e risultati di ricerca indicizzati. Per confronto, Gemini 3.6 Flash costa normalmente $1.50/M in input e $7.50/M in output (AgentPedia). La tariffa introduttiva di 3.7 Flash coincide con il livello Batch/Flex di 3.6 Flash, ma è applicata al throughput standard.
Le segnalazioni della community evidenziano un dettaglio importante nelle note: il prezzo introduttivo resta valido fino al 31 dicembre 2026, poi tornerebbe a $1.50/M in input e $7.50/M in output. Un utente Reddit ha osservato che "the displayed pricing fine print causes the price to double after four months" (r/GeminiAI).
| Fascia di prezzo | Input ($/M token) | Output ($/M token) | Note |
|---|---|---|---|
| 3.7 Flash introduttivo (ago–dic 2026) | $0.75 | $3.75 | Segnalato dalla community; raddoppia a gen 2027 |
| 3.7 Flash standard (da gen 2027) | $1.50 | $7.50 | Uguale a 3.6 Flash standard |
| 3.6 Flash standard | $1.50 | $7.50 | Prezzo GA attuale |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | Fascia a throughput ridotto |
| 3.5 Flash-Lite standard | $0.30 | $2.50 | La fascia Gemini Flash più economica |
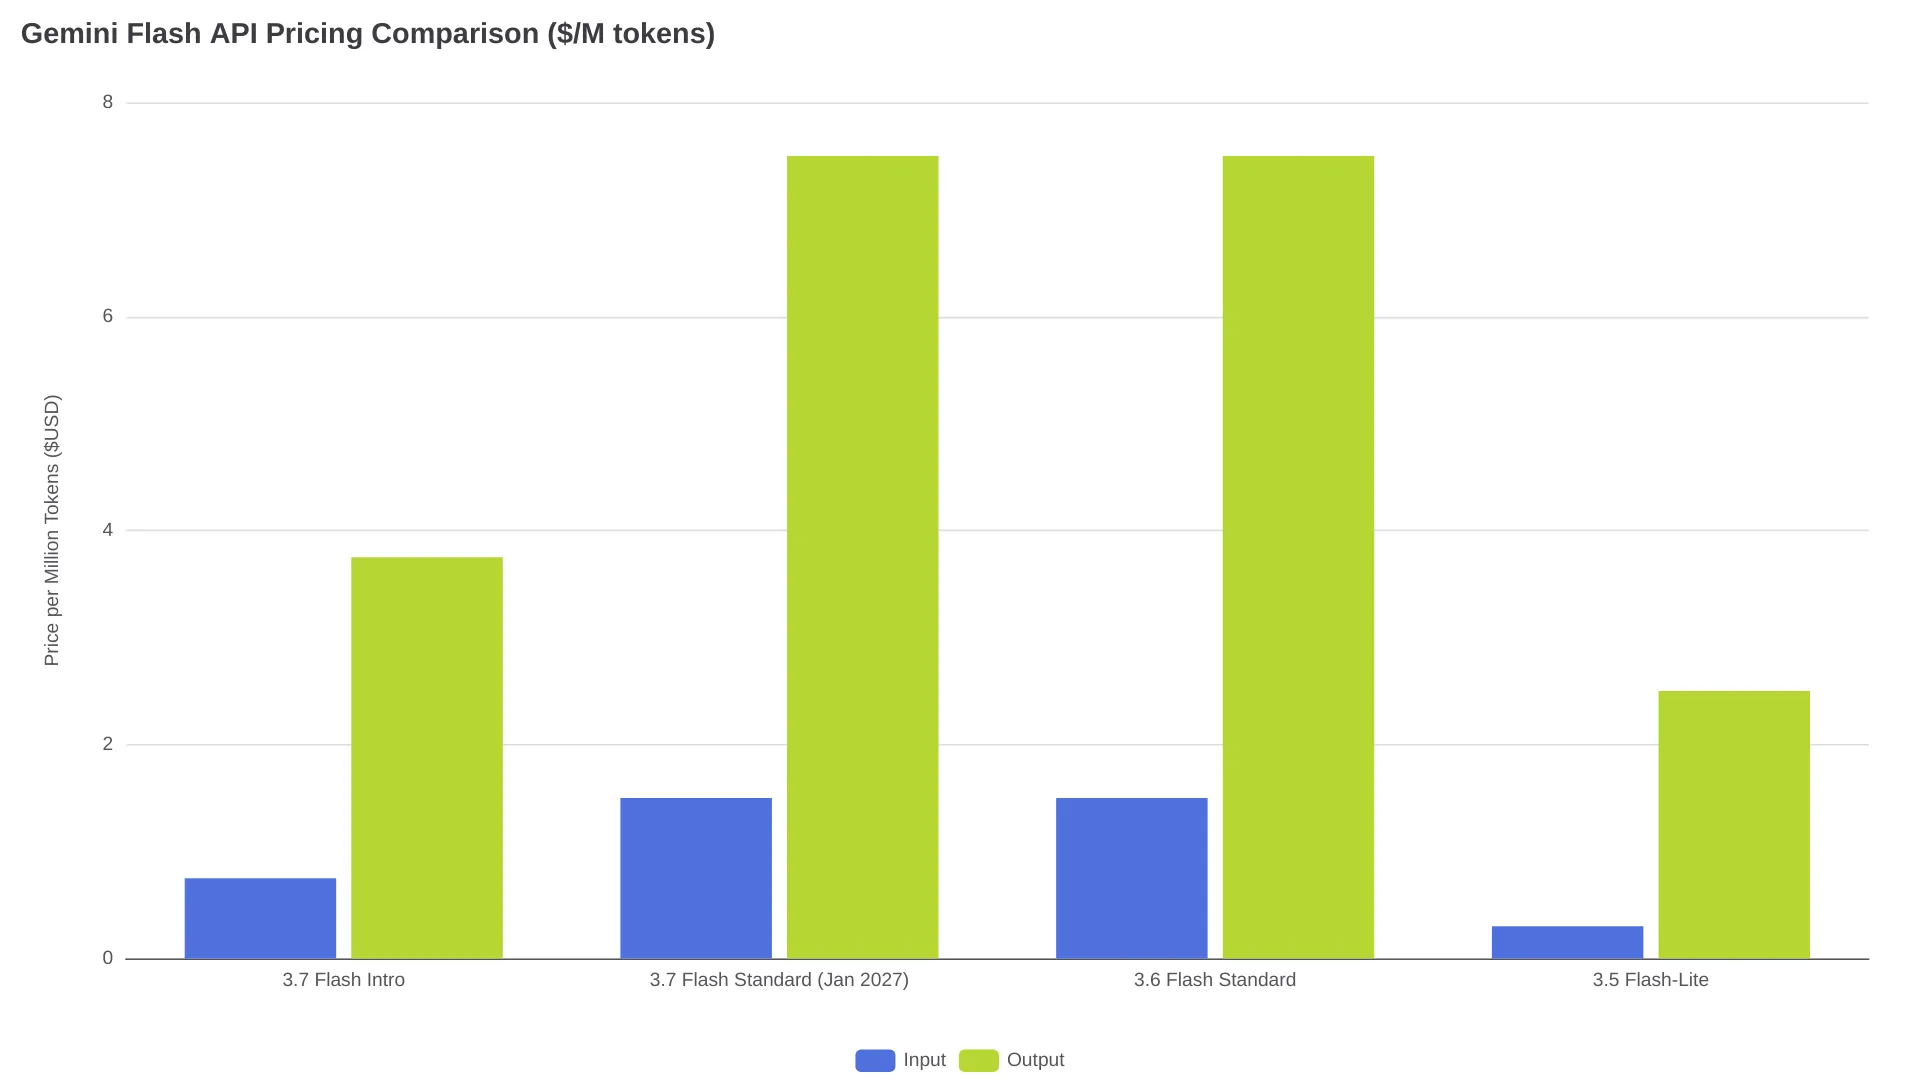
Il prezzo dell'output include i thinking token. Il context caching aggiunge $0.15/M token nella fascia standard, in base alle tariffe pubblicate per 3.6 Flash tramite AgentPedia. Google Search grounding e Maps grounding prevedono costi separati. Il modello mantiene la finestra di contesto da 1M token e l'output massimo da 64K di 3.6 Flash: non cambiano quindi i limiti di contesto che potrebbero rendere incompatibili le chiamate API esistenti.
Benchmark: dove migliora davvero
I benchmark comunicati da Google indicano progressi soprattutto nell'ingegneria del software, nel coding e nell'elaborazione di documenti. I valori seguenti arrivano dall'annuncio di lancio di Google, ripreso dai post della community il 13 agosto 2026.
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Delta |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 punti |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 punti |
| WebDev Arena (Elo) | 1,588 | 1,538 | +50 Elo |
| GDP.pdf Document Processing | 34.0% | 22.0% | +12.0 punti |
| AutomationBench | 30.4% | ~17% | +13 punti |
| Long-Context Retrieval | 97% | — | — |
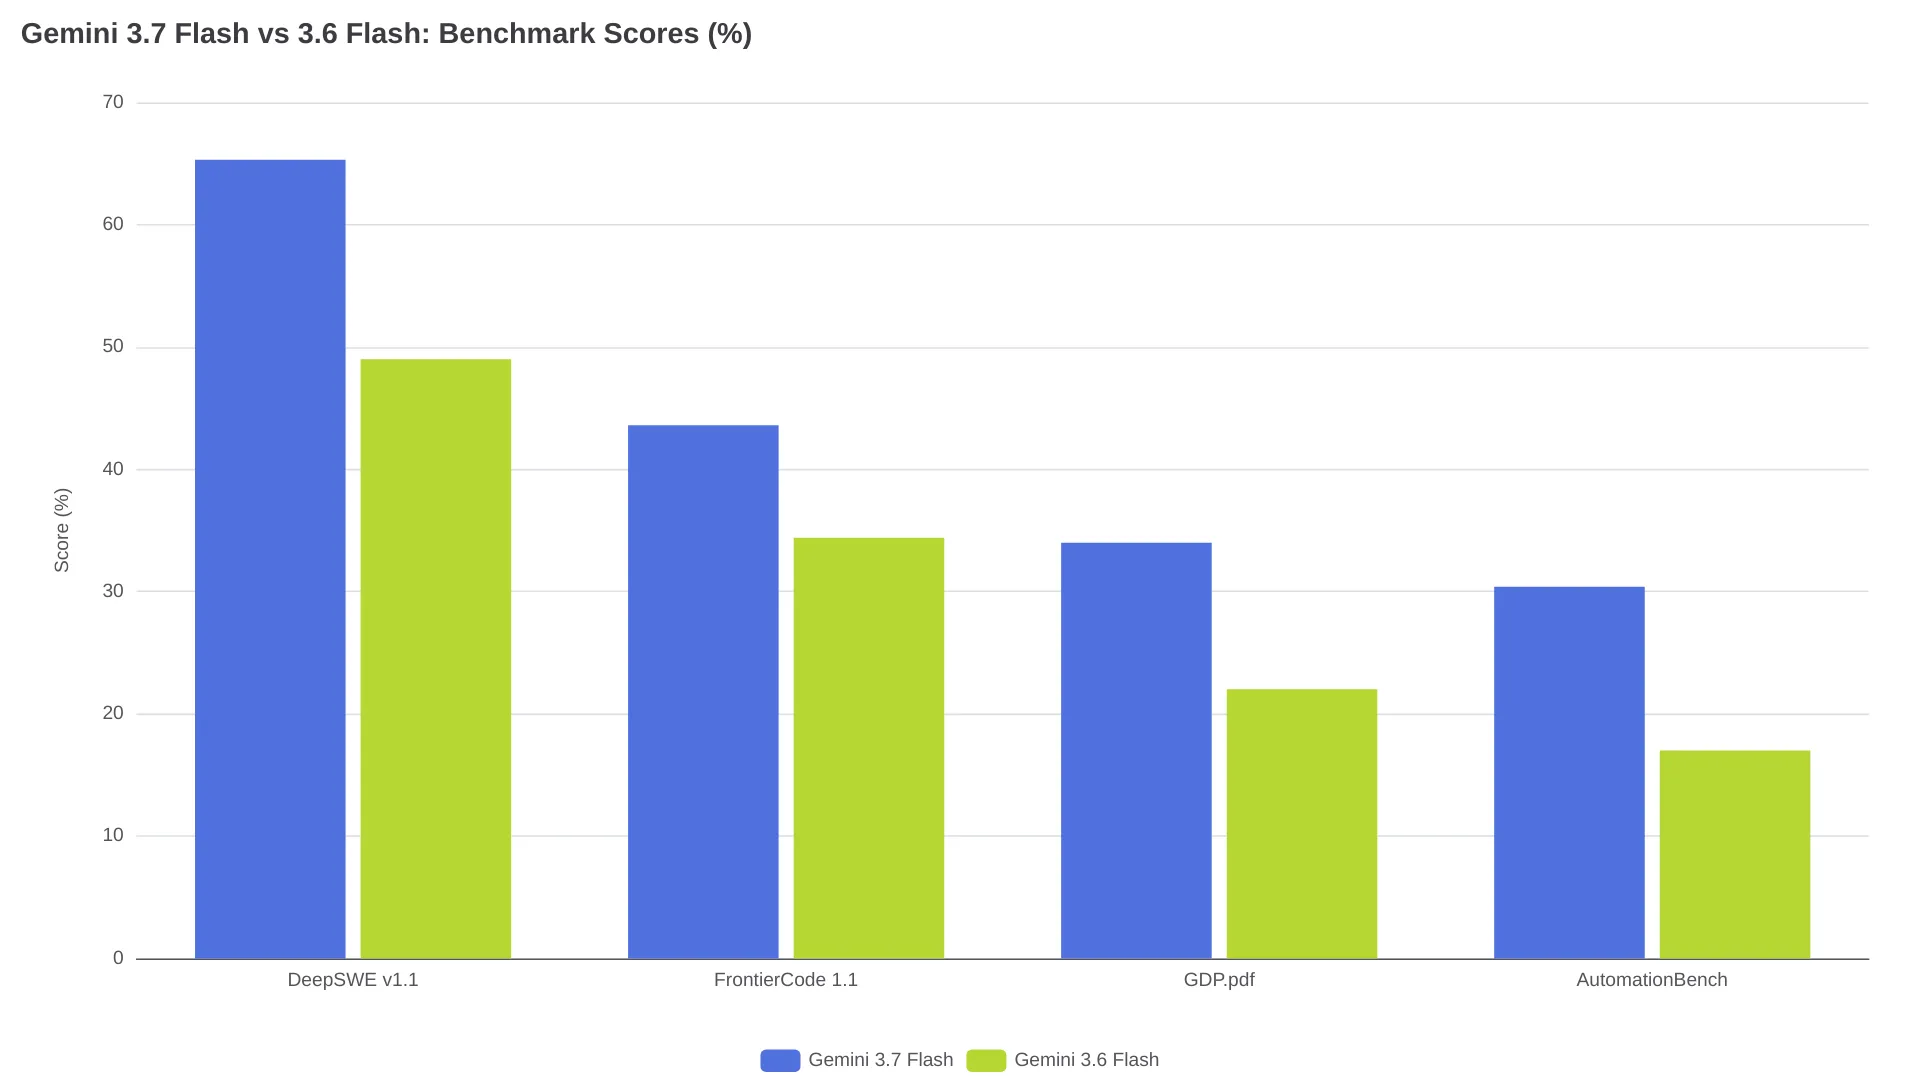
Il passaggio dal 49% al 65.3% su DeepSWE, pari a +33% in termini relativi, è il risultato che spicca di più. DeepSWE misura l'ingegneria del software a livello di repository: modifiche su più file, esecuzione dei test e navigazione nel codebase. La community Reddit resta però divisa sulla tenuta di questi dati in produzione. Un utente ha scritto: "Assume benchmaxxed until proven otherwise" (r/GeminiAI). Altri hanno fatto notare che nel confronto 3.6 Flash usava thinking high, mentre alcuni modelli concorrenti usavano medium, una differenza che gonfia i punteggi. Il 97% nel recupero da contesti lunghi ha invece suscitato interesse concreto per i flussi di coding, dove serve individuare codice pertinente in un codebase esteso.
Costi rispetto ai modelli concorrenti per il coding
I primi utenti su Reddit hanno confrontato subito il rapporto prezzo-prestazioni di 3.7 Flash con le alternative meno costose. Il quadro è misto: 3.7 Flash ottiene buoni risultati, ma il costo per task è sensibilmente più alto rispetto ai modelli economici dedicati al coding.
Un commentatore nel thread sui benchmark stima che Gemini 3.7 Flash costi circa 8x più di GPT-5.6 Luna sulla base del costo per task di Artificial Analysis, pur avendo benchmark quasi identici a Luna. Un altro utente ha affermato che Gemini 3.7 Flash in precedenza era circa 13x più costoso di DeepSeek V4 Flash, anche se da allora il prezzo di DeepSeek è aumentato. Lo stesso commentatore l'ha sintetizzato così: Gemini 3.7 Flash costa "more than 300% extra" rispetto a Luna per risultati "nearly the same" (r/GeminiAI).
L'obiezione è che Luna, secondo le segnalazioni, allucina più spesso e che il ragionamento di DeepSeek V4 Flash "makes many mistakes", anche se si tratta di evidenze aneddotiche.
Il punto su cui 3.7 Flash raccoglie più consensi è la velocità. Gli utenti riportano la maggior parte delle risposte in 3-6 secondi; la risposta più lunga osservata, in un test di scrittura creativa, ha richiesto circa un minuto. Più commentatori lo hanno definito "blazingly fast".
Specifiche, disponibilità e accesso API
In base alle specifiche riportate nelle discussioni della community e alla documentazione di 3.6 Flash, Gemini 3.7 Flash conserva gli stessi limiti di contesto e lo stesso set di funzionalità di 3.6 Flash.
| Specifica | Valore |
|---|---|
| Finestra di contesto | 1,048,576 token (1M) |
| Output massimo | 65,536 token (64K) |
| Livelli di thinking | Low, Medium, High |
| Modalità | Testo, immagini, video, audio, PDF (input); testo (output) |
| Knowledge cutoff | Marzo 2026 (3.6 Flash; cutoff di 3.7 Flash non confermato) |
| Prezzo input in cache | $0.15/M token (standard, dedotto da 3.6 Flash) |
Dove accedere:
- Gemini API / Google AI Studio — accesso per sviluppatori
- Gemini app — rilascio per il pubblico consumer
- Gemini Spark — disponibile per gli abbonati Google AI Pro e Google AI Ultra
- Vertex AI — atteso secondo il modello di disponibilità di 3.6 Flash
L'ID modello API atteso è gemini-3.7-flash, seguendo la convenzione di naming adottata da Google per 3.6 Flash. Prima del deployment, verificate la stringa esatta nella documentazione Google AI for Developers e fissatela esplicitamente, invece di affidarvi agli alias gemini-flash-latest.
Conviene migrare da 3.6 Flash?
La scelta dipende dal tipo di workload e dal peso che avrà l'aumento di prezzo di gennaio 2027.
Effettuate la migrazione se la vostra applicazione esegue agenti di coding, catene di tool use in più passaggi o processi intensivi sui documenti. Il salto su DeepSWE da 49% a 65.3% è abbastanza ampio da cambiare il numero di loop degli agenti che riescono al primo tentativo, mentre il prezzo introduttivo dimezzato consente di testarlo con una spesa inferiore. I team già su 3.6 Flash possono sostituire l'ID del modello dietro un feature flag senza riscrivere le assunzioni sulla finestra di contesto.
Aspettate se il workload consiste in classificazione, routing o estrazione ad alto volume, attività che Flash-Lite già gestisce a $0.30/$2.50. Il prezzo introduttivo di 3.7 Flash è comunque 2.5x la tariffa input di Flash-Lite e il raddoppio di gennaio amplia ulteriormente il divario.
Pianificate l'aumento di prezzo. Nel budget, considerate $1.50/$7.50 a partire da gennaio 2027, non l'attuale tariffa introduttiva. Se la vostra economia unitaria regge solo a $0.75/$3.75, il modello diventerà 2x più costoso in quattro mesi.
FAQ
Il prezzo di $0.75/$3.75 di Gemini 3.7 Flash è permanente?
No. Le segnalazioni della community indicano che si tratta di una tariffa introduttiva, valida fino al 31 dicembre 2026. Da gennaio 2027, i prezzi raddoppierebbero a $1.50/M in input e $7.50/M in output, allineandosi alle tariffe standard di 3.6 Flash.
Gemini 3.7 Flash è disponibile su Vertex AI?
Al lancio, la disponibilità su Vertex AI non è stata confermata in modo indipendente. Gemini 3.6 Flash era disponibile tramite Vertex AI al GA, quindi è previsto che 3.7 Flash segua lo stesso percorso. Consultate la console Google Cloud per l'elenco aggiornato dei modelli.
Come si confronta 3.7 Flash con Gemini 3.1 Pro?
Gli utenti Reddit riportano che 3.7 Flash è competitivo o superiore ai modelli di fascia Pro in specifici benchmark per agenti e coding, in particolare nell'analisi agentica dei documenti. Per loop di agenti di coding puri al prezzo introduttivo, 3.7 Flash offre un miglior rapporto prezzo-prestazioni; per ragionamento e pianificazione complessi, Pro resta la scelta più forte.
I thinking token vengono fatturati separatamente?
No. I thinking token vengono fatturati come token di output alla tariffa output standard ($3.75/M durante il periodo introduttivo). L'uso del thinking high aumenta i costi di output in proporzione: per workload ad alto volume in cui non serve un ragionamento aggiuntivo, preferite medium o low.